Co to jest funkcja przesunięcia?
Funkcja przesunięcia (ang. shift function) pokazuje, o ile trzeba przesunąć każdy kwantyl jednej grupy, żeby trafić w odpowiadający mu kwantyl drugiej. W praktyce porównuje się decyle: na osi poziomej leżą decyle grupy odniesienia, na pionowej – różnice decyli (grupa B minus grupa A) z przedziałami ufności. Doksum (1974) zdefiniował ją jako funkcję, która opisuje różnicę dwóch rozkładów także wtedy, gdy nie da się jej streścić jedną liczbą, i podał dla niej pasma ufności. To wykres kwantylowy Q-Q dwóch prób z odjętą przekątną.
Jak czytać wykres
- Pozioma linia nad zerem – wszystkie decyle przesunięte o tyle samo: klasyczny model przesunięcia, w którym różnica średnich i median mówi wszystko.
- Linia rosnąca przez zero – grupa B ma większy rozrzut: dolne decyle są niżej, górne wyżej.
- Płasko, a potem stromo w górę – grupy różnią się tylko w górnym ogonie.
Rousselet, Pernet i Wilcox (2017) proponują funkcję przesunięcia jako uzupełnienie wykresu słupkowego i testu na średnich: pokazuje, gdzie w rozkładzie grupy się różnią. Decyle zwykle liczy się estymatorem Harrella–Davisa – średnią ważoną wszystkich uporządkowanych obserwacji, w małych próbach efektywniejszą od zwykłego kwantyla z jednej lub dwóch obserwacji (Harrell i Davis, 1982).
Przykład
Symulowano czasy reakcji 100 osób z grupy kontrolnej i 100 z grupy po treningu. Oba rozkłady mają w populacji tę samą medianę (500 ms) i ten sam kształt dolnej połowy, ale w grupie z treningiem górna połowa jest rozciągnięta 1.8 raza na skali logarytmicznej (parametry ustawione ręcznie, żeby efekt był widoczny; ziarna 778, 7781 i 7782). Mediany z próby wyniosły 476.6 i 482.5 ms, średnie – 500.1 i 560.9 ms. Test t (Welcha) dał p = .020, a test Manna–Whitneya – p = .384. Żaden z testów nie mówi, na czym polega różnica.
Na rysunku
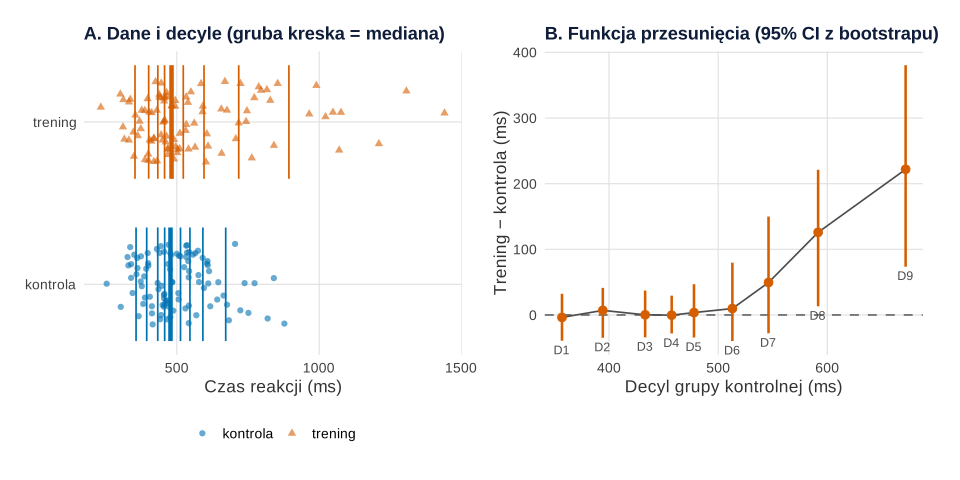
set.seed(778)).Co widać. Decyle D1–D6 obu grup prawie się pokrywają: różnice od −3.7 do 9.7 ms, a każdy przedział ufności obejmuje zero. Od D7 linia idzie stromo w górę: D7 = 49.5 ms [−27.9, 149.9], D8 = 125.9 ms [13.1, 221.2], D9 = 221.9 ms [73.6, 380.5]. Trening wydłużył tylko najwolniejsze reakcje – stąd podobne mediany i różne średnie.
Na co uważać. Przedziały są liczone osobno dla każdego decyla (bootstrap percentylowy, 2000 powtórzeń) i nie mają korekty na dziewięć porównań – pojedynczy przedział tuż nad zerem to słaby dowód. Wykres porównuje rozkłady, nie osoby: nie wiadomo, kto „przesunął się” najbardziej.
Podpis do pracy:
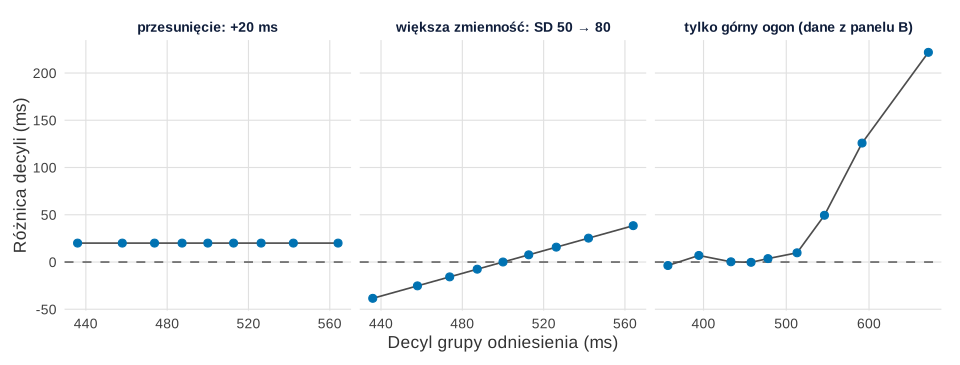
Co widać. Ten sam zapis odróżnia trzy historie, które test położenia zlewa w jedno. W drugim panelu średnie i mediany są równe, a rozkłady różne – oba testy położenia mogą tu nic nie wykryć.
Na co uważać. W próbach linia jest poszarpana – zawsze pokazuj przedziały.
Podpis do pracy:
Jak opisać w pracy
Opisz estymator kwantyli, sposób liczenia przedziałów i decyle, w których różnica jest wyraźna.
Na co uważać
- Za mała próba. Skrajne decyle (D1, D9) opierają się na kilku obserwacjach.
- Mylenie z regresją kwantylową. Regresja kwantylowa z jednym predyktorem grupującym daje podobne różnice kwantyli, ale pozwala dodać kowariaty.
- Brak obrazu surowych danych. Pokaż obok punkty albo dystrybuanty empiryczne – funkcja przesunięcia to streszczenie, nie zastępstwo.
Funkcja przesunięcia w R
Estymator Harrella–Davisa to kilka linijek z pbeta(), a przedziały – zwykły bootstrap percentylowy, w którym każdą grupę losuje się ze zwracaniem osobno. Rysunki na stronie powstały z obiektów p1 i p2 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Decyle, różnice decyli i bootstrapowe przedziały ufności
R
# Funkcja przesunięcia (shift function): różnice decyli dwóch grup z bootstrapowymi 95% CI
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(kontrola = "#0072B2", trening = "#D55E00")   # Okabe–Ito; grupy różnią się też kształtem punktów
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
# Estymator decyli Harrella–Davisa: średnia ważona statystyk porządkowych (wagi z rozkładu beta)
hd <- function(x, q) {
  n <- length(x); i <- seq_len(n); x <- sort(x)
  sapply(q, function(p) sum((pbeta(i / n, (n + 1) * p, (n + 1) * (1 - p)) -
                             pbeta((i - 1) / n, (n + 1) * p, (n + 1) * (1 - p))) * x))
}
# Czas reakcji (ms): ta sama mediana 500 ms, w grupie "trening" rozciągnięta tylko górna połowa rozkładu
set.seed(778)
n <- 100
kontrola <- 500 * exp(0.25 * rnorm(n))
z <- rnorm(n)
trening <- 500 * exp(0.25 * ifelse(z > 0, 1.8 * z, z))
decyle <- 1:9 / 10
dk <- hd(kontrola, decyle); dt <- hd(trening, decyle)
# Bootstrap percentylowy: każda grupa losowana ze zwracaniem osobno, B = 2000
set.seed(7781)
B <- 2000
boot <- replicate(B, hd(sample(trening, replace = TRUE), decyle) - hd(sample(kontrola, replace = TRUE), decyle))
sf <- data.frame(decyl = decyle, kontrola = dk, trening = dt, roznica = dt - dk,
                 dolna = apply(boot, 1, quantile, 0.025), gorna = apply(boot, 1, quantile, 0.975))
# A. Surowe dane z decylami obu grup
dane <- data.frame(grupa = factor(rep(c("kontrola", "trening"), each = n), levels = c("kontrola", "trening")),
                   czas = c(kontrola, trening))
set.seed(7782)
dane$y <- as.numeric(dane$grupa) + runif(2 * n, -0.25, 0.25)
dec <- data.frame(grupa = factor(rep(c("kontrola", "trening"), each = 9), levels = levels(dane$grupa)),
                  czas = c(dk, dt), y = rep(1:2, each = 9), mediana = rep(decyle == 0.5, 2))
pA <- ggplot(dane, aes(czas, y, colour = grupa, shape = grupa)) +
  geom_point(alpha = 0.6, size = 1.8) +
  geom_segment(data = dec, aes(x = czas, xend = czas, y = y - 0.35, yend = y + 0.35, linewidth = mediana),
               show.legend = FALSE) +
  scale_linewidth_manual(values = c(0.6, 1.6)) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_y_continuous(breaks = 1:2, labels = levels(dane$grupa)) +
  labs(title = "A. Dane i decyle (gruba kreska = mediana)", x = "Czas reakcji (ms)", y = NULL)
# B. Funkcja przesunięcia: różnica decyli (trening − kontrola) wobec decyli grupy kontrolnej
pB <- ggplot(sf, aes(kontrola, roznica)) +
  geom_hline(yintercept = 0, linetype = "dashed", colour = "grey40") +
  geom_linerange(aes(ymin = dolna, ymax = gorna), colour = kol[["trening"]], linewidth = 0.9) +
  geom_line(colour = "grey30") + geom_point(size = 2.6, colour = kol[["trening"]]) +
  geom_text(aes(y = dolna, label = paste0("D", decyl * 10)), vjust = 1.5, size = 3.3, colour = "grey30") +
  labs(title = "B. Funkcja przesunięcia (95% CI z bootstrapu)",
       x = "Decyl grupy kontrolnej (ms)", y = "Trening − kontrola (ms)")
p1 <- (pA + pB) & motyw
# Trzy wzorce teoretyczne (kwantyle z rozkładów normalnych, bez losowania)
p_siatka <- seq(0.1, 0.9, by = 0.1)
wzorce <- rbind(
  data.frame(wzorzec = "przesunięcie: +20 ms", x = qnorm(p_siatka, 500, 50), d = qnorm(p_siatka, 520, 50) - qnorm(p_siatka, 500, 50)),
  data.frame(wzorzec = "większa zmienność: SD 50 → 80", x = qnorm(p_siatka, 500, 50), d = qnorm(p_siatka, 500, 80) - qnorm(p_siatka, 500, 50)),
  data.frame(wzorzec = "tylko górny ogon (dane z panelu B)", x = dk, d = sf$roznica))
wzorce$wzorzec <- factor(wzorce$wzorzec, levels = unique(wzorce$wzorzec))
p2 <- ggplot(wzorce, aes(x, d)) + geom_hline(yintercept = 0, linetype = "dashed", colour = "grey40") +
  geom_line(colour = "grey30") + geom_point(size = 2.4, colour = kol[["kontrola"]]) +
  facet_wrap(~ wzorzec, scales = "free_x") +
  labs(x = "Decyl grupy odniesienia (ms)", y = "Różnica decyli (ms)") + motyw
# Wyniki
round(c(mediana_kontrola = median(kontrola), mediana_trening = median(trening),
        srednia_kontrola = mean(kontrola), srednia_trening = mean(trening)), 1)
round(c(t_p = t.test(trening, kontrola)$p.value,
        mann_whitney_p = wilcox.test(trening, kontrola, exact = FALSE)$p.value), 3)
print(round(sf, 1), row.names = FALSE)
p1
Wynik w R
mediana_kontrola  mediana_trening srednia_kontrola  srednia_trening
           476.6            482.5            500.1            560.9
           t_p mann_whitney_p
         0.020          0.384
 decyl kontrola trening roznica dolna gorna
   0.1    356.9   353.2    -3.7 -39.3  32.3
   0.2    394.3   401.3     6.9 -34.8  41.2
   0.3    433.1   433.3     0.2 -34.2  37.1
   0.4    457.4   457.1    -0.3 -28.2  29.3
   0.5    477.9   481.5     3.6 -34.4  46.9
   0.6    513.0   522.8     9.7 -39.8  79.7
   0.7    546.1   595.6    49.5 -27.9 149.9
   0.8    591.6   717.5   125.9  13.1 221.2
   0.9    671.8   893.6   221.9  73.6 380.5
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe pbeta(), sample(), t.test(), wilcox.test(); rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym funkcja przesunięcia różni się od testu t?
Test t porównuje jedną liczbę – średnie. Funkcja przesunięcia porównuje dziewięć decyli i pokazuje, czy różnica dotyczy całego rozkładu, tylko jego rozrzutu czy jednego ogona. Ta sama różnica średnich może wynikać z każdej z tych sytuacji.
Jak wygląda funkcja przesunięcia, gdy grupy różnią się tylko przesunięciem?
Jak pozioma linia: każdy decyl drugiej grupy leży o tyle samo wyżej (lub niżej). Wtedy różnica średnich, różnica median i estymator Hodgesa–Lehmanna szacują to samo i wystarczy jedna liczba.
Ile osób potrzeba do funkcji przesunięcia?
Nie ma sztywnego progu, ale skrajne decyle opierają się na nielicznych obserwacjach. Przy kilkudziesięciu osobach w grupie przedziały dla D1 i D9 są szerokie; przy 100 i więcej kształt funkcji jest zwykle czytelny.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Doksum, K. (1974). Empirical probability plots and statistical inference for nonlinear models in the two-sample case. The Annals of Statistics, 2(2), 267–277. https://doi.org/10.1214/aos/1176342662 ● Otwarty dostęp
- Harrell, F. E., & Davis, C. E. (1982). A new distribution-free quantile estimator. Biometrika, 69(3), 635–640. https://doi.org/10.1093/biomet/69.3.635
- Rousselet, G. A., Pernet, C. R., & Wilcox, R. R. (2017). Beyond differences in means: Robust graphical methods to compare two groups in neuroscience. European Journal of Neuroscience, 46(2), 1738–1748. https://doi.org/10.1111/ejn.13610 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{doksum1974empirical, author={Doksum, Kjell}, title={{Empirical probability plots and statistical inference for nonlinear models in the two-sample case}}, journal={The Annals of Statistics}, year={1974}, volume={2}, number={2}, pages={267--277}, doi={10.1214/aos/1176342662}}@article{harrell1982new, author={Harrell, Frank E. and Davis, C. E.}, title={{A new distribution-free quantile estimator}}, journal={Biometrika}, year={1982}, volume={69}, number={3}, pages={635--640}, doi={10.1093/biomet/69.3.635}}@article{rousselet2017beyond, author={Rousselet, Guillaume A. and Pernet, Cyril R. and Wilcox, Rand R.}, title={{Beyond differences in means: Robust graphical methods to compare two groups in neuroscience}}, journal={European Journal of Neuroscience}, year={2017}, volume={46}, number={2}, pages={1738--1748}, doi={10.1111/ejn.13610}}