Co to jest test Cramera–von Misesa?
Test Cramera–von Misesa (ang. Cramér–von Mises test) to test zgodności oparty na dystrybuancie empirycznej. Sprawdza, czy próba pochodzi z określonego rozkładu ciągłego. Test Kołmogorowa–Smirnowa bierze pod uwagę tylko największą pionową odległość między dystrybuantą empiryczną a teoretyczną. Test Cramera–von Misesa sumuje kwadraty tych odległości na całym zakresie wartości: ω² = ∫ [Fn(x) − F(x)]² dF(x) (Anderson, 1962). Stephens (1974) omówił go w przewodniku po statystykach EDF (D, W², V, U², A²) i pokazał, że testy te mają konkurencyjną moc.
Wzór i warianty
W praktyce liczy się W² = n·ω² = 1/(12n) + Σ [F(x(i)) − (2i − 1)/(2n)]², gdzie F(x(i)) to dystrybuanta hipotetyczna w uporządkowanych obserwacjach. Im większe W², tym gorsza zgodność.
- Rozkład w pełni określony (znane parametry): rozkład W² nie zależy od F. Csörgő i Faraway (1996) pokazali, że jednowyrazowa poprawka rozkładu asymptotycznego daje praktycznie dokładne p już przy n około 7.
- Parametry szacowane z próby (np. normalność): potrzebne są inne wartości krytyczne, podobnie jak w teście Lillieforsa.
- Dwie próby: porównuje się dystrybuanty empiryczne dwóch grup (Anderson, 1962).
Pokrewny test Andersona–Darlinga waży odległości tak, że mocniej liczą się ogony rozkładu.
Przykład w R
50 symulowanych czasów wykonania zadania (rozkład skośny; średnia 56.8 s, SD 30.1). Hipoteza zerowa: rozkład normalny o średniej 60 i SD 20. W² = 0.586, p = .024 (100 000 symulacji); test Kołmogorowa–Smirnowa: D = 0.226, p = .010. Pytanie o samą normalność (parametry z próby) daje W = 0.082, p = .19, a test Shapiro-Wilka – W = 0.951, p = .037.
Na rysunku
Te same 50 czasów i ta sama hipoteza zerowa N(60, 20) co w przykładzie – i trzy sposoby streszczenia jednej rozbieżności.
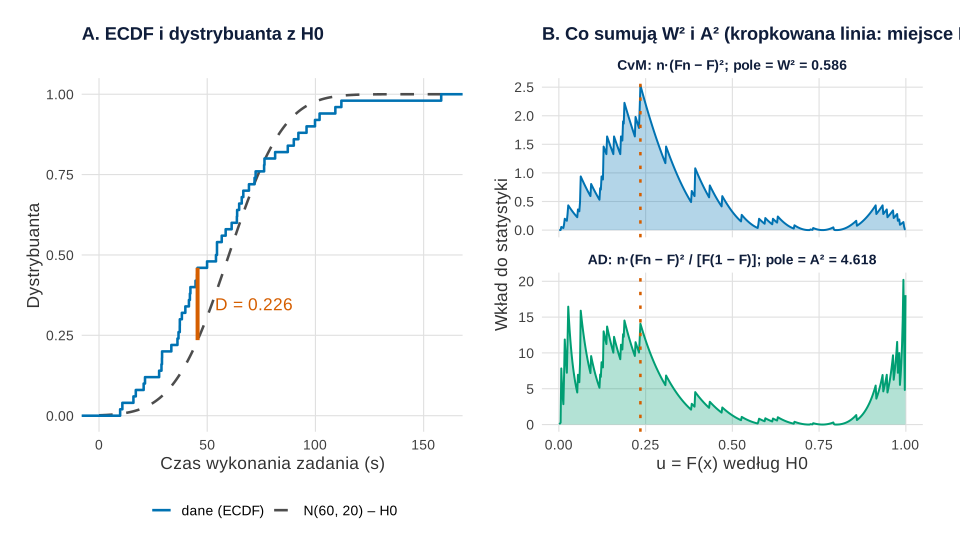
set.seed(625)).Co widać. W panelu A największa pionowa odległość, D = 0.226, przypada przy czasie około 46 s: do tego miejsca doszło już 46% obserwacji, a według hipotezy zerowej powinno 24%. Panel B pokazuje na osi u = F(x) funkcje, których pole wynosi W² = 0.586 i A² = 4.618. Krzywa W² ma szczyt w miejscu D, ale zbiera różnice z całego zakresu. A² dzieli te same kwadraty przez F(1 − F), więc różnice blisko 0 i 1 ważą więcej: obszary u < .1 i u > .9 dają 36.5% A² i tylko 12.0% W². W 100 000 próbach z hipotezy zerowej p wynosi .010 dla D, .0245 dla W² i .0045 dla A² (błąd Monte Carlo najwyżej 0.0005).
Na co uważać. Testu nie wybiera się po obejrzeniu trzech p. Oś w panelu B kończy się na u = 0.999, więc część wkładu najdłuższego czasu (158 s; według H0 1 − F(x) = 4.7 · 10⁻⁷) leży poza wykresem. Rysunek dotyczy rozkładu w pełni określonego; przy normalności z parametrami z próby obowiązują inne wartości krytyczne. Różnice na osi u to odchylenia od przekątnej na wykresie P-P, a samą dystrybuantę empiryczną jako wykres opisuje wpis Rozkład zmiennej na wykresie.
Podpis do pracy:
Kod odtwarza rysunek i liczby. Dane i ziarno 625 są te same co w przykładzie (ziarna nie dobierano), a symulacja losuje w tej samej kolejności, więc p dla W² się zgadza. Rysunek na stronie powstał z obiektu p1 z motywem serwisu; różni się tylko krojem czcionki i siatką.
Kod R rysunku 1
# Rysunek 1. Te same różnice dystrybuant w trzech statystykach: KS (D), Cramer–von Mises (W²) i Anderson–Darling (A²)
library(ggplot2)
library(patchwork)
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom", plot.title = element_text(face = "bold"))
kol <- c(KS = "#D55E00", CvM = "#0072B2", AD = "#009E73")             # Okabe–Ito

set.seed(625)                                                        # te same dane co w przykładzie hasła
czas <- round(rgamma(50, shape = 3, rate = 3 / 60), 3)
n <- length(czas)
u <- sort(pnorm(czas, mean = 60, sd = 20))                           # H0: N(60, 20); u = F(x)
i <- seq_len(n)
D  <- function(u) { u <- sort(u); k <- seq_along(u); max(k / length(u) - u, u - (k - 1) / length(u)) }
W2 <- function(u) { u <- sort(u); k <- seq_along(u); 1 / (12 * length(u)) + sum((u - (2 * k - 1) / (2 * length(u)))^2) }
A2 <- function(u) { u <- sort(u); k <- seq_along(u); m <- length(u)
  -m - mean((2 * k - 1) * (log(u) + log(1 - rev(u)))) }
obs <- c(D = D(u), W2 = W2(u), A2 = A2(u))
# rozkład trzech statystyk przy H0 (u ~ jednostajny); kolejność losowań jak w przykładzie hasła
sym <- replicate(100000, { v <- runif(n); c(D = D(v), W2 = W2(v), A2 = A2(v)) })
p <- rowMeans(sym >= obs)
round(rbind(statystyka = obs, p_symulacja = p, blad_MC = sqrt(p * (1 - p) / 100000)), 4)

# pola pod funkcjami podcałkowymi liczone na skali logitu u (gęsto także w skrajnych ogonach): du = u(1 − u) dt
t <- seq(-15, 15, by = 0.001); uu <- plogis(t)
d2 <- n * (ecdf(u)(uu) - uu)^2
cvm_dt <- d2 * uu * (1 - uu); ad_dt <- d2                            # n(Fn − F)² du  oraz  n(Fn − F)²/[F(1 − F)] du
ogon <- uu < 0.1 | uu > 0.9
round(c(pole_W2 = sum(cvm_dt) * 0.001, pole_A2 = sum(ad_dt) * 0.001,
        ogony_udzial_W2 = sum(cvm_dt[ogon]) / sum(cvm_dt), ogony_udzial_A2 = sum(ad_dt[ogon]) / sum(ad_dt)), 3)
cat("największy czas:", max(czas), "s; 1 − F(x) =", signif(1 - max(u), 2), "\n")
# do rysunku: siatka na osi u
siatka <- data.frame(u = seq(0.001, 0.999, by = 0.002))
siatka$roznica <- ecdf(u)(siatka$u) - siatka$u
gdzie <- siatka[which.max(abs(siatka$roznica)), ]
round(c(u_max = gdzie$u, roznica_max = gdzie$roznica, czas_przy_max = qnorm(gdzie$u, 60, 20)), 3)

# A: dystrybuanta empiryczna i hipotetyczna na osi czasu, z największą odległością D
xs <- seq(0, 160, by = 0.5)
pA <- ggplot() +
  geom_line(aes(xs, pnorm(xs, 60, 20), linetype = "N(60, 20) – H0"), colour = "grey30", linewidth = 0.9) +
  stat_ecdf(aes(czas, linetype = "dane (ECDF)"), colour = kol[["CvM"]], linewidth = 0.9, pad = TRUE) +
  geom_segment(aes(x = qnorm(gdzie$u, 60, 20), xend = qnorm(gdzie$u, 60, 20), y = gdzie$u, yend = gdzie$u + gdzie$roznica),
               colour = kol[["KS"]], linewidth = 1.4) +
  annotate("text", x = qnorm(gdzie$u, 60, 20) + 8, y = gdzie$u + gdzie$roznica / 2, hjust = 0, colour = kol[["KS"]],
           label = sprintf("D = %.3f", obs[["D"]])) +
  scale_linetype_manual(values = c("dane (ECDF)" = "solid", "N(60, 20) – H0" = "dashed"), name = NULL) +
  labs(title = "A. ECDF i dystrybuanta z H0", x = "Czas wykonania zadania (s)", y = "Dystrybuanta") +
  motyw

# B: co sumują W² i A² (na osi u = F(x)); pole pod krzywą to wartość statystyki
et <- c(sprintf("CvM: n·(Fn − F)²; pole = W² = %.3f", obs[["W2"]]),
        sprintf("AD: n·(Fn − F)² / [F(1 − F)]; pole = A² = %.3f", obs[["A2"]]))
dl <- rbind(data.frame(u = siatka$u, y = n * siatka$roznica^2, stat = et[1]),
            data.frame(u = siatka$u, y = n * siatka$roznica^2 / (siatka$u * (1 - siatka$u)), stat = et[2]))
dl$stat <- factor(dl$stat, levels = et)
pB <- ggplot(dl, aes(u, y)) +
  geom_area(aes(fill = stat), alpha = 0.3) +
  geom_line(aes(colour = stat), linewidth = 0.7) +
  geom_vline(xintercept = gdzie$u, colour = kol[["KS"]], linetype = "dotted", linewidth = 0.9) +
  facet_wrap(~ stat, ncol = 1, scales = "free_y") +
  scale_colour_manual(values = setNames(unname(kol[c("CvM", "AD")]), et), guide = "none") +
  scale_fill_manual(values = setNames(unname(kol[c("CvM", "AD")]), et), guide = "none") +
  labs(title = "B. Co sumują W² i A² (kropkowana linia: miejsce D)", x = "u = F(x) według H0", y = "Wkład do statystyki") +
  motyw + theme(strip.text = element_text(hjust = 0, size = 10.5))
p1 <- pA + pB
p1   # zapis: ggsave("test-cramera-von-misesa-trzy-statystyki.svg", p1, width = 10, height = 5.8)
Wynik w R
                 D     W2     A2
statystyka  0.2256 0.5859 4.6185
p_symulacja 0.0103 0.0245 0.0045
blad_MC     0.0003 0.0005 0.0002
        pole_W2         pole_A2 ogony_udzial_W2 ogony_udzial_A2
          0.586           4.617           0.120           0.365
największy czas: 158.11 s; 1 − F(x) = 4.7e-07
        u_max   roznica_max czas_przy_max
        0.235         0.225        45.550
Jak opisać w pracy
Na co uważać
- Parametry z próby. Wartości krytyczne dla rozkładu w pełni określonego nie pasują, gdy średnią i SD liczysz z tych samych danych.
- Jeden test to za mało. W przykładzie test Shapiro-Wilka wskazał odchylenie od normalności, którego test Cramera–von Misesa nie wykazał. Dodaj wykres kwantylowy.
- Wiązania. Test zakłada rozkład ciągły; przy skali 1–5 jego p jest nieprawidłowe.
Test Cramera–von Misesa w R
Kod liczy statystykę W² ręcznie dla rozkładu w pełni określonego, a p wyznacza z rozkładu W² w 100 000 próbach z rozkładu jednostajnego (przy prawdziwej hipotezie zerowej wartości F(x) mają rozkład jednostajny). Dla porównania pokazuje test Kołmogorowa–Smirnowa, cvm.test() z pakietu nortest (normalność z parametrami z próby) i test Shapiro-Wilka. Liczby w tekście pochodzą z tego kodu.
Statystyka W² i test normalności
R
# Test Cramera-von Misesa: statystyka W^2 ręcznie, p z symulacji, cvm.test dla normalności
library(nortest)
set.seed(625)
czas <- round(rgamma(50, shape = 3, rate = 3 / 60), 3)  # czasy wykonania zadania (s), rozkład skośny
# H0 w pełni określona: czas ~ N(60, 20)
W2 <- function(u) { n <- length(u); u <- sort(u)
  1 / (12 * n) + sum((u - (2 * seq_len(n) - 1) / (2 * n))^2) }
w_obs <- W2(pnorm(czas, mean = 60, sd = 20))
w_sym <- replicate(100000, W2(runif(length(czas))))   # rozkład W^2 przy H0 (nie zależy od F)
round(c(W2 = w_obs, p_symulacja = mean(w_sym >= w_obs)), 3)
ks.test(czas, "pnorm", mean = 60, sd = 20)            # dla porównania: test KS
# H0 złożona: normalność z parametrami szacowanymi z próby
cvm.test(czas)
shapiro.test(czas)
Wynik w R
         W2 p_symulacja
      0.586       0.024

	Exact one-sample Kolmogorov-Smirnov test

data:  czas
D = 0.22564, p-value = 0.01019
alternative hypothesis: two-sided


	Cramer-von Mises normality test

data:  czas
W = 0.082081, p-value = 0.19


	Shapiro-Wilk normality test

data:  czas
W = 0.95082, p-value = 0.03687
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet nortest 1.0.4). Rysunek 1 wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- nortest (wersja 1.0.4): Gross, J., & Ligges, U. (2015). nortest: Tests for normality [R package]. https://doi.org/10.32614/CRAN.package.nortest
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym test Cramera–von Misesa różni się od testu Kołmogorowa–Smirnowa?
Test Kołmogorowa–Smirnowa bierze tylko największą pionową odległość między dystrybuantą empiryczną a teoretyczną. Test Cramera–von Misesa sumuje kwadraty odległości we wszystkich punktach, więc uwzględnia rozbieżności na całym zakresie danych.
Jak sprawdzić normalność testem Cramera–von Misesa w R?
Użyj funkcji cvm.test() z pakietu nortest. Testuje ona normalność ze średnią i SD oszacowanymi z próby i wymaga więcej niż 7 obserwacji. Wynik uzupełnij wykresem kwantylowym.
Czy test Cramera–von Misesa ma wersję dla dwóch prób?
Tak. Porównuje dystrybuanty empiryczne dwóch grup bez założenia o kształcie rozkładu; Anderson (1962) podał tablice dla małych prób. W R oblicza ją m.in. funkcja cvm_test() z pakietu twosamples.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Anderson, T. W. (1962). On the distribution of the two-sample Cramér–von Mises criterion. The Annals of Mathematical Statistics, 33(3), 1148–1159. https://doi.org/10.1214/aoms/1177704477 ● Otwarty dostęp
- Csörgő, S., & Faraway, J. J. (1996). The exact and asymptotic distributions of Cramér–von Mises statistics. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 221–234. https://doi.org/10.1111/j.2517-6161.1996.tb02077.x ● Otwarty dostęp: pełny tekst
- Stephens, M. A. (1974). EDF statistics for goodness of fit and some comparisons. Journal of the American Statistical Association, 69(347), 730–737. https://doi.org/10.1080/01621459.1974.10480196
Cytowania BibTeX
@article{anderson1962distribution, author={Anderson, T. W.}, title={{On the distribution of the two-sample Cramér–von Mises criterion}}, journal={The Annals of Mathematical Statistics}, year={1962}, volume={33}, number={3}, pages={1148--1159}, doi={10.1214/aoms/1177704477}}@article{csorgo1996exact, author={Csörgő, Sándor and Faraway, Julian J.}, title={{The exact and asymptotic distributions of Cramér–von Mises statistics}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1996}, volume={58}, number={1}, pages={221--234}, doi={10.1111/j.2517-6161.1996.tb02077.x}}@article{stephens1974edf, author={Stephens, M. A.}, title={{EDF statistics for goodness of fit and some comparisons}}, journal={Journal of the American Statistical Association}, year={1974}, volume={69}, number={347}, pages={730--737}, doi={10.1080/01621459.1974.10480196}}