Kim był Andriej Kołmogorow?
Andriej Nikołajewicz Kołmogorow (1903–1987) był rosyjskim matematykiem, który dał teorii prawdopodobieństwa współczesne podstawy i wyprowadził graniczny rozkład statystyki, na której opiera się test Kołmogorowa–Smirnowa. Urodził się 25 kwietnia 1903 r. w Tambowie, w czasie podróży matki z Krymu do domu rodzinnego. Matka zmarła przy porodzie, a chłopca wychowała jej siostra we wsi Tunoszna koło Jarosławia nad Wołgą (Kendall i in., 1990).
W 1920 r. zaczął studiować matematykę na Uniwersytecie Moskiewskim. Dwa lata później, jako dziewiętnastolatek, skonstruował funkcję całkowalną, której szereg Fouriera jest rozbieżny prawie wszędzie – ten wynik od razu przyniósł mu międzynarodową sławę. W 1925 r. rozpoczął studia doktoranckie pod kierunkiem Nikołaja Łuzina i w tym samym roku opublikował z Aleksandrem Chinczynem swoją pierwszą pracę z rachunku prawdopodobieństwa. W 1931 r. został profesorem Uniwersytetu Moskiewskiego, a w 1939 r. – członkiem Akademii Nauk ZSRR, wkrótce po objęciu kierownictwa działu prawdopodobieństwa w Instytucie Matematycznym im. Stiekłowa (Kendall i in., 1990).
Pracował jednocześnie w wielu dziedzinach: od procesów stochastycznych i turbulencji (prace z lat 1940–1941), przez mechanikę klasyczną (teoria KAM, przedstawiona na kongresie matematyków w Amsterdamie w 1954 r.), po teorię informacji i złożoność obliczeniową. Pod koniec życia dużo czasu poświęcał szkole dla uzdolnionych dzieci przy Uniwersytecie Moskiewskim. Wypromował blisko 70 doktorów. Otrzymał m.in. Nagrodę Leninowską (1965), Nagrodę Balzana i Nagrodę Wolfa; w 1959 r. został honorowym członkiem Royal Statistical Society, a w 1964 r. członkiem zagranicznym Royal Society (Kendall i in., 1990).
Najważniejsze pomysły
- Aksjomaty prawdopodobieństwa (1933). W monografii Grundbegriffe der Wahrscheinlichkeitsrechnung, wydanej w Berlinie (Kolmogoroff, 1933), zdarzenia to zbiory z pewnej rodziny zbiorów, a prawdopodobieństwo – nieujemna liczba przypisana każdemu zdarzeniu, równa 1 dla zdarzenia pewnego i addytywna dla zdarzeń rozłącznych, z dodatkowym aksjomatem ciągłości. Shafer i Vovk (2006) podkreślają, że było to na 62 stronach podsumowanie, a nie nowe odkrycie: Kołmogorow zebrał pomysły Borela, Frécheta, Steinhausa i innych i powiedział, że nic więcej do zbudowania teorii nie potrzeba. Na tych aksjomatach stoją rozkłady, dystrybuanty (funkcja gęstości i dystrybuanta) i wartość p.
- Statystyka Kołmogorowa (1933). W pracy opublikowanej w tym samym roku we włoskim czasopiśmie aktuarialnym Kołmogorow zajął się największą odległością między dystrybuantą empiryczną a dystrybuantą teoretyczną. Pokazał, że po pomnożeniu przez √n jej rozkład jest taki sam dla każdego ciągłego rozkładu i ma znaną granicę. Dało to test nieparametryczny zgodności z dowolnym, z góry określonym rozkładem. Nikołaj Smirnow uprościł dowód w 1944 r., stąd nazwa „test Kołmogorowa–Smirnowa” (Kendall i in., 1990), a sam Smirnow ogłosił później tablicę do oceny zgodności rozkładów empirycznych (Smirnov, 1948).
- Procesy stochastyczne i twierdzenia graniczne. Praca z 1931 r. o procesach Markowa z czasem ciągłym dała równania Kołmogorowa i początek teorii dyfuzji; wcześniej powstały jego wersje mocnego prawa wielkich liczb i prawa iterowanego logarytmu, a w 1949 r. – książka z Borisem Gniedenką o granicznych rozkładach sum niezależnych zmiennych losowych (Kendall i in., 1990). Prostszą odmianę jego procesów, z czasem dyskretnym, znajdziesz w haśle łańcuch Markowa.
Przykład na historycznych danych
Zbiór randu z pakietu datasets zawiera, według pliku pomocy, 400 trójek kolejnych liczb pseudolosowych z funkcji RANDU języka VAX FORTRAN w systemie VMS 1.5. Każda liczba miała pochodzić z rozkładu jednostajnego U(0, 1). To rozkład w pełni określony z góry, a więc dokładnie sytuacja, dla której Kołmogorow wyprowadził swój test.
Test dla pierwszej liczby z trójki daje D = .056, p = .170; dla drugiej D = .036, p = .688; dla trzeciej D = .046, p = .378. Największa odległość dla x wypada przy wartości .283: według rozkładu jednostajnego niższa powinna być 28.3% liczb, a w danych jest ich 22.75%. Żadna kolumna nie odbiega istotnie od U(0, 1), a korelacje między kolumnami są bliskie zera (od −.063 do .058).
Mimo to liczby nie są niezależne. Kombinacja 9x − 6y + z jest w każdej z 400 trójek liczbą całkowitą (największe odchylenie, 0.000008, wynika z zaokrąglenia danych do sześciu miejsc) i przyjmuje tylko 15 wartości, od −5 do 9. Zgadza się to z plikiem pomocy: trójki leżą na 15 równoległych płaszczyznach. Test Kołmogorowa sprawdza rozkład jednej zmiennej – niezależności kolejnych liczb nie zbada.
Na rysunku
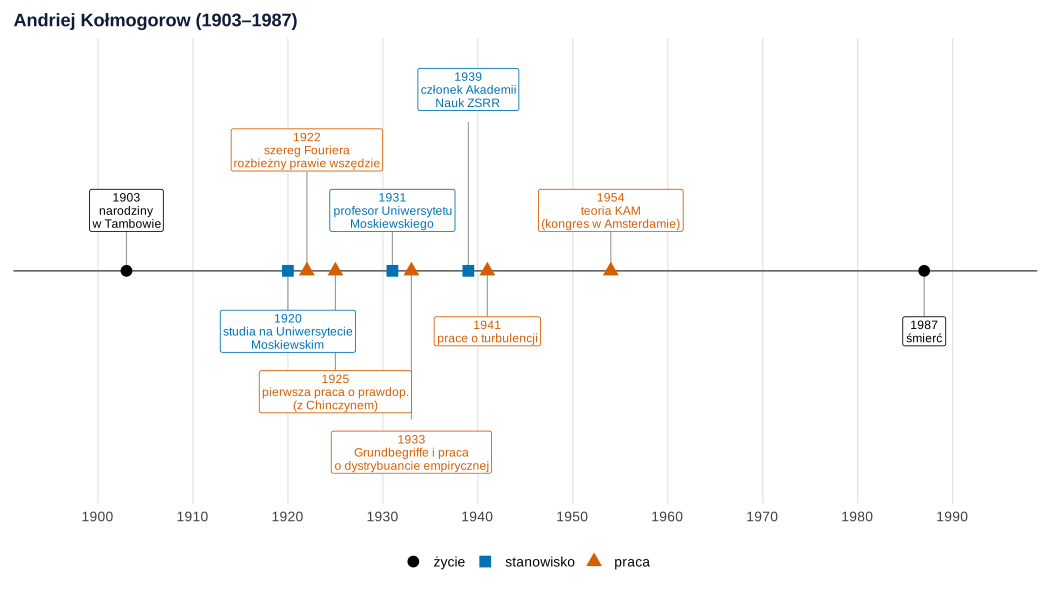
Co widać. Prawie wszystkie prace, którymi Kołmogorow wpłynął na statystykę – teoria prawdopodobieństwa, procesy Markowa, statystyka dystrybuanty empirycznej – powstały w ciągu kilkunastu lat, między 1925 a 1941 r. Kształt znacznika mówi, czy zdarzenie dotyczy życia, stanowiska czy publikacji.
Na co uważać. Oś pokazuje tylko wybór (pominięto m.in. logikę, topologię i złożoność). Przy pracach podano rok publikacji, nie powstania – artykuł o turbulencji z 1941 r. powstał w 1940 r.
Podpis do pracy:
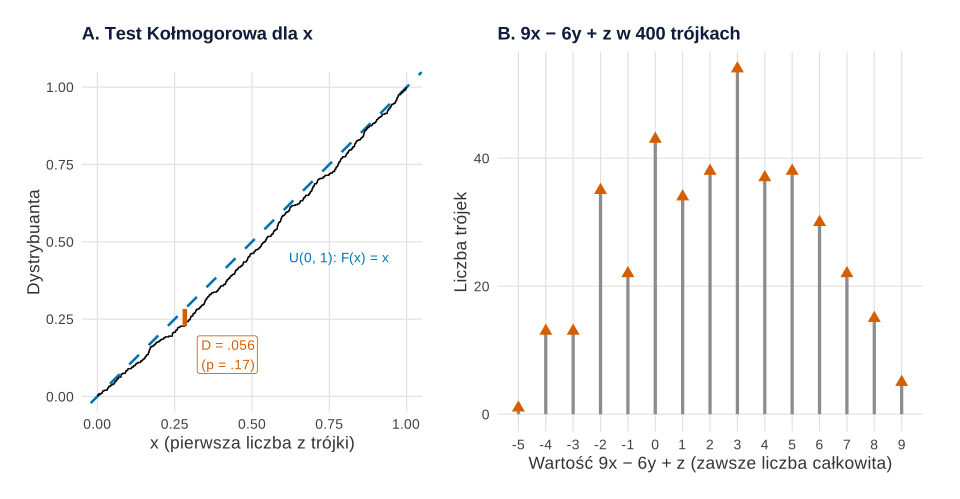
datasets::randu. Rysunek: R, pakiety ggplot2 i patchwork.Co widać. Na panelu A schodki dystrybuanty empirycznej trzymają się przekątnej, a statystyka D to krótki pomarańczowy odcinek – największa pionowa odległość między krzywymi. Na panelu B ta sama próba okazuje się silnie uporządkowana: kombinacja trzech kolejnych liczb przyjmuje tylko 15 wartości całkowitych.
Na co uważać. Brak istotnego wyniku testu zgodności nie dowodzi, że dane są „dobre” – test odpowiada tylko na pytanie o rozkład jednej zmiennej, a przy dużym n wykrywa nawet drobne odchylenia. Klasyczne wartości p są poprawne wyłącznie wtedy, gdy rozkład teoretyczny ustalono przed obejrzeniem danych.
Podpis do pracy:
Gdzie spotkasz Kołmogorowa w swojej pracy
- Test Kołmogorowa–Smirnowa. Programy statystyczne podają go przy sprawdzaniu rozkładu zmiennej; szczegóły, wersję dla dwóch prób i przykłady opisuje hasło test Kołmogorowa-Smirnowa. Gdy średnią i odchylenie standardowe szacujesz z tej samej próby, potrzebne są inne wartości krytyczne – tak powstał test Lillieforsa (Lilliefors, 1967).
- Ocena normalności. Do rozdziału o założeniach lepiej nadaje się test Shapiro-Wilka razem z wykresem kwantylowym; całą procedurę pokazuje wpis jak sprawdzić normalność rozkładu.
- Test chi-kwadrat czy test K–S? Massey (1951) podał tablice punktów procentowych testu Kołmogorowa i przesłanki, że w sprawdzaniu zgodności z rozkładem przewyższa on test chi-kwadrat zgodności.
- Podstawy każdego testu. Prawdopodobieństwo, dystrybuanta i zmienna losowa w podręcznikach statystyki to definicje oparte na aksjomatach z 1933 r.; w tym samym języku formułuje się prawo wielkich liczb i centralne twierdzenie graniczne.
Spory, mity i trudne strony
Spór z Łysenką (1940). Kołmogorow ponownie przeanalizował dane z doświadczenia N. I. Jermołajewej, która sugerowała rozbieżności z prawami Mendla. Porównał rozkład empiryczny odpowiednio unormowanych odchyleń z rozkładem normalnym, uzyskał dobrą zgodność i uznał wyniki za potwierdzenie praw Mendla. Trofim Łysenko odpowiedział publicznie, że rację ma Jermołajewa, a nie Kołmogorow; spór wkrótce wygasł (Kendall i in., 1990).
Mit „testu normalności”. Test Kołmogorowa nie powstał jako test normalności. Sprawdza zgodność z jednym, w pełni określonym rozkładem – normalnym, jednostajnym albo dowolnym innym ciągłym.
Test Kołmogorowa na danych RANDU w R
Kod rysuje oś czasu, liczy test Kołmogorowa dla trzech kolumn zbioru randu, szuka punktu największej odległości dystrybuant i sprawdza kombinację 9x − 6y + z. Niczego nie losuje. Rysunki na stronie powstały z tych samych obiektów p1 i p2 z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
Oś czasu i test Kołmogorowa dla liczb z RANDU
Kod R rysunków 1 i 2 i obliczeń
# Andriej Kołmogorow: oś czasu i test Kołmogorowa na liczbach z generatora RANDU
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(zycie = "#000000", stanowisko = "#0072B2", praca = "#D55E00", szary = "grey55")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

# Rysunek 1: oś czasu (daty: Kendall i in., 1990)
zd <- data.frame(
  rok = c(1903, 1920, 1922, 1925, 1931, 1933, 1939, 1941, 1954, 1987),
  etykieta = c("narodziny\nw Tambowie", "studia na Uniwersytecie\nMoskiewskim", "szereg Fouriera\nrozbieżny prawie wszędzie",
               "pierwsza praca o prawdop.\n(z Chinczynem)", "profesor Uniwersytetu\nMoskiewskiego",
               "Grundbegriffe i praca\no dystrybuancie empirycznej", "członek Akademii\nNauk ZSRR",
               "prace o turbulencji", "teoria KAM\n(kongres w Amsterdamie)", "śmierć"),
  rodzaj = c("życie", "stanowisko", "praca", "praca", "stanowisko", "praca", "stanowisko", "praca", "praca", "życie"),
  y = c(1.2, -1.2, 2.4, -2.4, 1.2, -3.6, 3.6, -1.2, 1.2, -1.2))
zd$rodzaj <- factor(zd$rodzaj, levels = c("życie", "stanowisko", "praca"))
p1 <- ggplot(zd, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey40", linewidth = 0.6) +
  geom_segment(aes(xend = rok, yend = y * 0.82), colour = "grey60", linewidth = 0.4) +
  geom_point(aes(colour = rodzaj, shape = rodzaj), size = 3.4, stroke = 1.1) +
  geom_label(aes(y = y, label = paste0(rok, "\n", etykieta), colour = rodzaj), size = 3.2, lineheight = 0.9,
             linewidth = 0.3, fill = "white", show.legend = FALSE) +
  scale_colour_manual(values = c("życie" = kol[["zycie"]], stanowisko = kol[["stanowisko"]], praca = kol[["praca"]]), name = NULL) +
  scale_shape_manual(values = c("życie" = 16, stanowisko = 15, praca = 17), name = NULL) +
  scale_x_continuous(breaks = seq(1900, 1990, 10), limits = c(1896, 1994)) +
  scale_y_continuous(limits = c(-4.2, 4.2)) +
  labs(title = "Andriej Kołmogorow (1903–1987)", x = NULL, y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())

# Przykład: 400 trójek liczb z generatora RANDU (datasets::randu) a rozkład jednostajny U(0, 1)
data(randu, package = "datasets")
ks <- t(sapply(randu, function(u) {
  w <- ks.test(u, "punif")
  c(n = length(u), D = unname(w$statistic), p = w$p.value)
}))
round(ks, 3)
# Gdzie dystrybuanta empiryczna x najbardziej odbiega od dystrybuanty U(0, 1)?
x <- sort(randu$x); n <- length(x)
gora <- (1:n) / n - x; dol <- x - (0:(n - 1)) / n
i <- which.max(pmax(gora, dol))
punkt <- c(x = x[i], F_teor = x[i], F_emp_przed = (i - 1) / n, F_emp_po = i / n, D = max(gora, dol))
round(punkt, 4)
# Zależność między kolejnymi liczbami: 9x − 6y + z jest zawsze (prawie) liczbą całkowitą
k <- with(randu, 9 * x - 6 * y + z)
max(abs(k - round(k)))   # odchylenie od liczby całkowitej (dane zaokrąglone do 6 miejsc)
table(round(k))
round(cor(randu), 3)

dane_a <- data.frame(x = x, F = (1:n) / n)
odc <- data.frame(x = punkt[["x"]], y0 = punkt[["F_teor"]],
                  y1 = if (gora[i] >= dol[i]) punkt[["F_emp_po"]] else punkt[["F_emp_przed"]])
pA <- ggplot(dane_a, aes(x, F)) +
  geom_abline(intercept = 0, slope = 1, colour = kol[["stanowisko"]], linewidth = 0.9, linetype = "dashed") +
  geom_step(colour = "black", linewidth = 0.5) +
  geom_segment(data = odc, aes(x = x, xend = x, y = y0, yend = y1), colour = kol[["praca"]], linewidth = 1.6,
               inherit.aes = FALSE) +
  annotate("label", x = odc$x + 0.04, y = (odc$y0 + odc$y1) / 2 - 0.12, hjust = 0, size = 3.6,
           label = sprintf("D = %s\n(p = %s)", sub("^0", "", sprintf("%.3f", punkt[["D"]])), sub("^0", "", sprintf("%.2f", ks["x", "p"]))),
           colour = kol[["praca"]], linewidth = 0.3) +
  annotate("text", x = 0.62, y = 0.45, label = "U(0, 1): F(x) = x", colour = kol[["stanowisko"]], hjust = 0, size = 3.6) +
  coord_equal() +
  labs(title = "A. Test Kołmogorowa dla x", x = "x (pierwsza liczba z trójki)", y = "Dystrybuanta") + motyw
dane_b <- as.data.frame(table(k = round(k)))
dane_b$k <- as.integer(as.character(dane_b$k))
pB <- ggplot(dane_b, aes(k, Freq)) +
  geom_col(width = 0.12, fill = kol[["szary"]]) +
  geom_point(colour = kol[["praca"]], shape = 17, size = 3) +
  scale_x_continuous(breaks = -5:9) +
  labs(title = "B. 9x − 6y + z w 400 trójkach", x = "Wartość 9x − 6y + z (zawsze liczba całkowita)",
       y = "Liczba trójek") + motyw
p2 <- pA + pB + plot_layout(widths = c(1, 1.25))
p1
p2
Wynik w R
    n     D     p
x 400 0.056 0.170
y 400 0.036 0.688
z 400 0.046 0.378
          x      F_teor F_emp_przed    F_emp_po           D
     0.2830      0.2830      0.2275      0.2300      0.0555
[1] 8e-06

-5 -4 -3 -2 -1  0  1  2  3  4  5  6  7  8  9
 1 13 13 35 22 43 34 38 54 37 38 30 22 15  5
       x      y      z
x  1.000 -0.048  0.058
y -0.048  1.000 -0.063
z  0.058 -0.063  1.000
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (test – funkcja ks.test() z pakietu stats; rysunki – pakiety ggplot2 i patchwork; dane z pakietu datasets dołączonego do R). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Andriej Kołmogorow?
Rosyjskim matematykiem (1903–1987), profesorem Uniwersytetu Moskiewskiego od 1931 r. i członkiem Akademii Nauk ZSRR od 1939 r. W 1933 r. ułożył aksjomaty prawdopodobieństwa i opisał statystykę największej odległości między dystrybuantą empiryczną a teoretyczną; zajmował się też procesami Markowa, turbulencją i złożonością.
Dlaczego test nazywa się testem Kołmogorowa-Smirnowa?
Kołmogorow w 1933 r. wyprowadził graniczny rozkład statystyki D dla jednej próby i rozkładu określonego z góry. Nikołaj Smirnow uprościł dowód w 1944 r. i opracował tablice, dlatego w nazwie testu są obaj.
Czym są aksjomaty Kołmogorowa?
To zasady, z których wynika cały rachunek prawdopodobieństwa: prawdopodobieństwo zdarzenia jest nieujemne, zdarzenie pewne ma prawdopodobieństwo 1, a prawdopodobieństwa zdarzeń rozłącznych się dodają (z dodatkowym aksjomatem ciągłości dla nieskończenie wielu zdarzeń). Kołmogorow opublikował je w 1933 r. w Grundbegriffe der Wahrscheinlichkeitsrechnung.
Czy test Kołmogorowa sprawdza niezależność obserwacji?
Nie. Sprawdza tylko, czy rozkład jednej zmiennej zgadza się z rozkładem teoretycznym. Liczby z generatora RANDU przechodzą ten test, choć trzy kolejne liczby są ze sobą ściśle powiązane – zależność trzeba badać innymi metodami.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikCentralne twierdzenie graniczne
Co mówi CTG, dlaczego dotyczy średnich, a nie danych, ile osób naprawdę potrzeba i kiedy twierdzenie zawodzi – z symulacjami w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Kendall, D. G., Batchelor, G. K., Bingham, N. H., Hayman, W. K., Hyland, J. M. E., Lorentz, G. G., Moffatt, H. K., Parry, W., Razborov, A. A., Robinson, C. A., & Whittle, P. (1990). Andrei Nikolaevich Kolmogorov (1903–1987). Bulletin of the London Mathematical Society, 22(1), 31–100. https://doi.org/10.1112/blms/22.1.31 ● Otwarty dostęp
- Kolmogoroff, A. (1933). Grundbegriffe der Wahrscheinlichkeitsrechnung. Springer. https://doi.org/10.1007/978-3-642-49888-6
- Lilliefors, H. W. (1967). On the Kolmogorov-Smirnov test for normality with mean and variance unknown. Journal of the American Statistical Association, 62(318), 399–402. https://doi.org/10.1080/01621459.1967.10482916
- Massey, F. J., Jr. (1951). The Kolmogorov-Smirnov test for goodness of fit. Journal of the American Statistical Association, 46(253), 68–78. https://doi.org/10.1080/01621459.1951.10500769
- Shafer, G., & Vovk, V. (2006). The sources of Kolmogorov’s Grundbegriffe. Statistical Science, 21(1), 70–98. https://doi.org/10.1214/088342305000000467 ● Otwarty dostęp
- Smirnov, N. (1948). Table for estimating the goodness of fit of empirical distributions. The Annals of Mathematical Statistics, 19(2), 279–281. https://doi.org/10.1214/aoms/1177730256 ● Otwarty dostęp
Cytowania BibTeX
@article{kendall1990kolmogorov, author={Kendall, D. G. and Batchelor, G. K. and Bingham, N. H. and Hayman, W. K. and Hyland, J. M. E. and Lorentz, G. G. and Moffatt, H. K. and Parry, W. and Razborov, A. A. and Robinson, C. A. and Whittle, P.}, title={{Andrei Nikolaevich Kolmogorov (1903–1987)}}, journal={Bulletin of the London Mathematical Society}, year={1990}, volume={22}, number={1}, pages={31--100}, doi={10.1112/blms/22.1.31}}@book{kolmogoroff1933grundbegriffe, author={Kolmogoroff, A.}, title={{Grundbegriffe der Wahrscheinlichkeitsrechnung}}, year={1933}, publisher={Springer}, doi={10.1007/978-3-642-49888-6}}@article{lilliefors1967kolmogorov, author={Lilliefors, Hubert W.}, title={{On the Kolmogorov-Smirnov test for normality with mean and variance unknown}}, journal={Journal of the American Statistical Association}, year={1967}, volume={62}, number={318}, pages={399--402}, doi={10.1080/01621459.1967.10482916}}@article{massey1951kolmogorov, author={Massey, Jr., Frank J.}, title={{The Kolmogorov-Smirnov test for goodness of fit}}, journal={Journal of the American Statistical Association}, year={1951}, volume={46}, number={253}, pages={68--78}, doi={10.1080/01621459.1951.10500769}}@article{shafer2006sources, author={Shafer, Glenn and Vovk, Vladimir}, title={{The sources of Kolmogorov’s Grundbegriffe}}, journal={Statistical Science}, year={2006}, volume={21}, number={1}, pages={70--98}, doi={10.1214/088342305000000467}}@article{smirnov1948table, author={Smirnov, N.}, title={{Table for estimating the goodness of fit of empirical distributions}}, journal={The Annals of Mathematical Statistics}, year={1948}, volume={19}, number={2}, pages={279--281}, doi={10.1214/aoms/1177730256}}