Co to jest równoliczność grup?
Równoliczność grup (plan zrównoważony, ang. balanced design, equal sample sizes) oznacza, że porównywane grupy lub komórki planu czynnikowego mają tę samą liczbę obserwacji. W eksperymencie z dwiema grupami po 60 osób plan jest równoliczny. W badaniu, w którym 100 osób trafiło do warunku A, a 20 do B – nie. W analizie wariancji dwuczynnikowej równoliczność oznacza tyle samo osób w każdej kombinacji poziomów czynników.
Równoliczność nie jest założeniem testów statystycznych. Test t czy ANOVA działają także przy nierównych grupach. Wpływa jednak na trzy praktyczne sprawy: moc testu przy danej łącznej liczbie osób, odporność testów klasycznych na nierówne wariancje i jednoznaczność wyników w planach czynnikowych.
Dlaczego równe grupy są korzystne
1. Moc. Precyzja porównania dwóch średnich zależy od wyrażenia 1/n1 + 1/n2, a więc od średniej harmonicznej liczebności grup:
Przy stałej łącznej liczebności N średnia harmoniczna jest największa, gdy n1 = n2. Każde odejście od równowagi obniża moc, choć niewielkie różnice kosztują mało, a duże – bardzo dużo.
2. Odporność na nierówne wariancje. Przy równych grupach klasyczny test t Studenta i F są dość odporne na heterogeniczność wariancji. Przy nierównych grupach problem narasta. Gdy większa wariancja występuje w mniejszej grupie, test odrzuca prawdziwą hipotezę zerową za często. Gdy w większej – za rzadko i traci moc. Delacre i in. (2017) wskazują, że założenie równych wariancji rzadko jest spełnione w psychologii, a test Welcha lepiej kontroluje błąd I rodzaju i niewiele traci, gdy założenia są spełnione. Zimmerman (2004) dodaje, że procedura dwuetapowa (najpierw test Levene’a, potem wybór testu) nie chroni poziomu istotności. Przy nierównych grupach najlepszą ochronę daje bezwarunkowe stosowanie testu Welcha.
3. Jednoznaczność w planach czynnikowych. W zrównoważonej ANOVA dwuczynnikowej efekty główne i interakcja są od siebie niezależne, a różne typy sum kwadratów dają ten sam wynik. W planie niezrównoważonym wyniki zależą od wybranego typu sum kwadratów. Langsrud (2003) zauważa, że programy domyślnie stosują typ III, który opiera się na nierealistycznych modelach, i uznaje typ II za lepszy wybór. Smith i Cribbie (2014) również zalecają typ II do testowania efektów głównych, bo przy braku interakcji ma największą moc.
Przy więcej niż dwóch grupach te same zasady przenoszą się na jednoczynnikową ANOVA i porównania parami. Gdy grupy są nierówne, a wariancje różne, zamiast klasycznego F użyj wersji Welcha. Zamiast testu Tukeya wybierz test Gamesa-Howella, który nie zakłada równych wariancji i radzi sobie z różnymi liczebnościami. Moc każdego porównania parami zależy od liczebności tej konkretnej pary grup. Najmniejsza grupa wyznacza więc, jak małe różnice da się w ogóle wykryć.
Przykład: ten sam budżet, różny podział
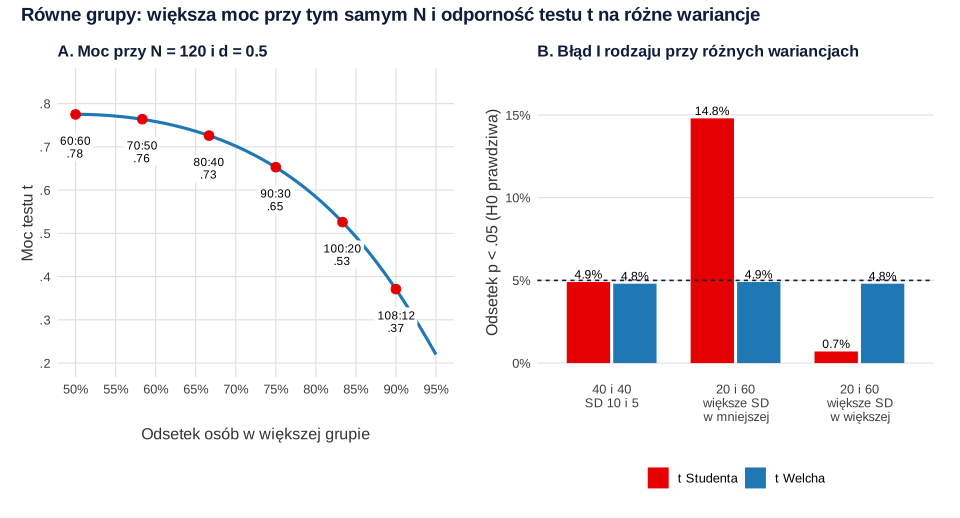
Załóżmy, że możesz zbadać 120 osób, a spodziewany efekt różnicy dwóch grup to d = 0.5 (α = .05, test dwustronny). Moc testu t zależnie od podziału wynosi:
| Podział | Średnia harmoniczna | Moc |
|---|---|---|
| 60 : 60 | 60.0 | .775 |
| 70 : 50 | 58.3 | .764 |
| 80 : 40 | 53.3 | .726 |
| 90 : 30 | 45.0 | .653 |
| 100 : 20 | 33.3 | .526 |
| 108 : 12 | 21.6 | .371 |
Podział 70 : 50 prawie nic nie kosztuje, ale przy 100 : 20 moc spada do .526. Odwrotnie: do mocy 80% przy podziale 1 : 1 potrzeba 64 osób w grupie (128 łącznie), a przy podziale 2 : 1 – 144 osób (48 i 96), czyli o 16 więcej. Moc wynosi wtedy .802. Szczegóły planowania liczebności opisuje hasło analiza mocy a priori.
Druga część symulacji (10 000 powtórzeń, hipoteza zerowa prawdziwa, odchylenia standardowe 10 i 5) pokazuje odporność testów. Przy grupach 40 i 40 test Studenta odrzucał H0 w 4.9% prób, a Welcha w 4.8%. Przy grupach 20 i 60 z większym rozrzutem w mniejszej grupie test Studenta odrzucał ją w 14.8% prób, czyli trzy razy częściej niż deklarowane 5%. Test Welcha – w 4.9%. Gdy większy rozrzut był w większej grupie, test Studenta stał się nadmiernie ostrożny (0.7%), a test Welcha nadal trzymał poziom (4.8%), jak na rysunku 1.
Kiedy nierówne grupy są w porządku
- Grupy naturalne (np. osoby z diagnozą i bez niej) mają nierówne liczebności z natury rzeczy; nie ma sensu ich sztucznie wyrównywać.
- Celowy przydział 2 : 1 bywa uzasadniony etycznie (więcej osób dostaje obiecującą interwencję) albo kosztowo (warunek kontrolny jest tani). Wymaga to zaplanowania nieco większej próby.
- Niewielka nierównowaga po wykluczeniach i rezygnacjach (np. 58 i 61) praktycznie nie zmienia mocy; ważniejsze jest pytanie, czy rezygnacje zależały od warunku.
Jeśli równoliczność ma znaczenie, zapewnij ją już w planie, np. randomizacją blokową, a nie przez usuwanie danych po badaniu.
Jak opisać liczebności grup w pracy
Podaj liczebność każdej grupy (lub komórki planu) i przyczyny ewentualnej nierównowagi. Przy nierównych grupach wybierz analizę odporną na różne wariancje i nazwij ją w tekście, np. „test t Welcha”. W planach czynnikowych podaj typ sum kwadratów. Wzory tabel znajdziesz w haśle tabela testu t w APA, a całą procedurę porównań grup – w poradniku ANOVA krok po kroku.
Przykład w R
Kod liczy moc testu t z niecentralnego rozkładu t dla różnych podziałów 120 osób, wyznacza liczebność potrzebną przy podziale 1 : 1 i 2 : 1, a następnie w 10 000 symulacji porównuje błąd I rodzaju testu Studenta i Welcha przy nierównych wariancjach. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Moc przy różnych podziałach i błąd I rodzaju testów Studenta i Welcha
R
# 1. Moc testu t przy stałej łącznej liczebności N = 120 i różnym podziale na grupy (d = 0.5, α = .05)
moc_t <- function(n1, n2, d, alfa = .05) {
  df <- n1 + n2 - 2; ncp <- d / sqrt(1 / n1 + 1 / n2); kryt <- qt(1 - alfa / 2, df)
  pt(kryt, df, ncp, lower.tail = FALSE) + pt(-kryt, df, ncp)
}
podzial <- data.frame(n1 = c(60, 70, 80, 90, 100, 108), n2 = 120 - c(60, 70, 80, 90, 100, 108))
podzial$n_harmoniczna <- round(2 / (1 / podzial$n1 + 1 / podzial$n2), 1)
podzial$moc <- round(moc_t(podzial$n1, podzial$n2, d = 0.5), 3)
podzial

# Ile osób potrzeba do mocy 80% przy podziale 1:1, a ile przy 2:1?
n_rowne <- ceiling(power.t.test(delta = 0.5, sd = 1, power = .80)$n)    # na grupę
c(rowne_na_grupe = n_rowne, rowne_lacznie = 2 * n_rowne)
k <- 2                                                                   # stosunek liczebności 2:1
N_21 <- ceiling(2 * n_rowne * (1 + k)^2 / (4 * k)); n_male <- ceiling(N_21 / (1 + k))
c(N_przy_2do1 = N_21, mniejsza = n_male, wieksza = N_21 - n_male, moc = round(moc_t(n_male, N_21 - n_male, 0.5), 3))

# 2. Błąd I rodzaju testu t Studenta i testu Welcha, gdy wariancje są różne (SD 2:1), a H0 jest prawdziwa
set.seed(199)
sym <- function(n1, n2, sd1, sd2, R = 10000) {
  p <- replicate(R, { x <- rnorm(n1, 50, sd1); y <- rnorm(n2, 50, sd2)
    c(student = t.test(x, y, var.equal = TRUE)$p.value, welch = t.test(x, y)$p.value) })
  round(rowMeans(p < .05), 3)
}
rbind(`40 i 40, SD 10 i 5`                 = sym(40, 40, 10, 5),
      `20 i 60, większe SD w mniejszej`    = sym(20, 60, 10, 5),
      `20 i 60, większe SD w większej`     = sym(20, 60, 5, 10))
Wynik w R
   n1 n2 n_harmoniczna   moc
1  60 60          60.0 0.775
2  70 50          58.3 0.764
3  80 40          53.3 0.726
4  90 30          45.0 0.653
5 100 20          33.3 0.526
6 108 12          21.6 0.371
rowne_na_grupe  rowne_lacznie
            64            128
N_przy_2do1    mniejsza     wieksza         moc
    144.000      48.000      96.000       0.802
                                student welch
40 i 40, SD 10 i 5                0.049 0.048
20 i 60, większe SD w mniejszej   0.148 0.049
20 i 60, większe SD w większej    0.007 0.048
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunek przygotowano w pakiecie ggplot2 (z patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Usuwanie losowych osób z większej grupy, żeby wyrównać liczebności. Zmniejsza to moc i nie poprawia niczego, czego nie załatwi test Welcha.
- Traktowanie równoliczności jak założenia testu, które trzeba „sprawdzić” testem chi-kwadrat. Nierówne grupy nie unieważniają analizy; zmieniają tylko wybór testu i moc.
- Test t Studenta przy wyraźnie nierównych grupach bez sprawdzenia, w której grupie rozrzut jest większy – w przykładzie dało to trzykrotnie zawyżony błąd I rodzaju.
- Domyślny typ III sum kwadratów w niezrównoważonej ANOVA bez zastanowienia nad hipotezą; przy braku interakcji typ II ma większą moc (Smith i Cribbie, 2014).
- Brak informacji o przyczynach nierównowagi. Jeśli z jednej grupy zrezygnowało znacznie więcej osób, problemem nie jest liczebność, lecz możliwe obciążenie wyników.
- Planowanie mocy dla równych grup, a realizacja 2 : 1. Przelicz moc dla faktycznego podziału albo zwiększ łączną liczebność.
Najczęstsze pytania
Czy grupy w teście t muszą być równoliczne?
Nie. Test t działa przy nierównych grupach, ale wtedy klasyczny test Studenta staje się wrażliwy na nierówne wariancje. Przy nierównych liczebnościach bezpieczniej od razu użyć testu Welcha, który nie zakłada równości wariancji.
Ile mocy traci się przy nierównych grupach?
Zależy od stopnia nierównowagi. Przy 120 osobach i d = 0.5 podział 60 : 60 daje moc .775, 80 : 40 – .726, a 100 : 20 – tylko .526. Moc wyznacza średnia harmoniczna liczebności, która przy stałym N jest największa dla równych grup.
Czy można usunąć osoby, żeby wyrównać liczebność grup?
Nie ma takiej potrzeby, a szkodzi: zmniejsza moc i może wprowadzić obciążenie, jeśli wybór usuwanych osób nie jest losowy. Zamiast tego zastosuj test odporny na nierówne wariancje, a w planach czynnikowych odpowiedni typ sum kwadratów.
Jak zapewnić równe liczebności grup w eksperymencie?
Stosuj randomizację blokową: w każdym bloku (np. 4 lub 6 osób) jest tyle samo miejsc dla każdego warunku, więc po każdym bloku grupy są równe. Prosta randomizacja rzutem monetą przy małych próbach często daje wyraźnie nierówne grupy.
Który typ sum kwadratów wybrać przy nierównych grupach w ANOVA?
Przy nierównych liczebnościach typy I, II i III dają różne wyniki dla efektów głównych. Gdy interakcja jest pomijalna, częściej zaleca się typ II, bo testuje sensowne hipotezy o efektach głównych i ma największą moc; typ III to domyślne ustawienie wielu programów.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Dobór liczebności próby: moc, precyzja i uzasadnienie badania
Jak dobrać liczebność próby? Moc testu, precyzja, symulacja, przewidywane braki danych i zasady rzetelnego uzasadnienia liczby uczestników.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikJak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Langsrud, Ø. (2003). ANOVA for unbalanced data: Use Type II instead of Type III sums of squares. Statistics and Computing, 13(2), 163–167. https://doi.org/10.1023/A:1023260610025
- Smith, C. E., & Cribbie, R. (2014). Factorial ANOVA with unbalanced data: A fresh look at the types of sums of squares. Journal of Data Science, 12(3), 385–404. https://doi.org/10.6339/JDS.201407_12(3).0001 ● Otwarty dostęp
- Zimmerman, D. W. (2004). A note on preliminary tests of equality of variances. British Journal of Mathematical and Statistical Psychology, 57(1), 173–181. https://doi.org/10.1348/000711004849222
Cytowania BibTeX
@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{langsrud2003anova, author={Langsrud, Øyvind}, title={{ANOVA for unbalanced data: Use Type II instead of Type III sums of squares}}, journal={Statistics and Computing}, year={2003}, volume={13}, number={2}, pages={163--167}, doi={10.1023/a:1023260610025}}@article{smith2014factorial, author={Smith, Carrie E. and Cribbie, Robert}, title={{Factorial ANOVA with unbalanced data: A fresh look at the types of sums of squares}}, journal={Journal of Data Science}, year={2014}, volume={12}, number={3}, pages={385--404}, doi={10.6339/jds.201407_12(3).0001}}@article{zimmerman2004note, author={Zimmerman, Donald W.}, title={{A note on preliminary tests of equality of variances}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2004}, volume={57}, number={1}, pages={173--181}, doi={10.1348/000711004849222}}