Kim są Rebecca DerSimonian i Nan Laird?
Nan McKenzie Laird (ur. 1943) to amerykańska biostatystyczka z Harvard T. H. Chan School of Public Health. Dyplom ze statystyki uzyskała w 1969 r. na University of Georgia, w 1971 r. rozpoczęła studia doktoranckie na wydziale statystyki Harvardu, a doktorat obroniła w 1975 r. pod kierunkiem Arthura Dempstera. Od razu przeszła na wydział biostatystyki Harvard School of Public Health, którym kierowała w latach 1990–1999; w 2015 r. przeszła na emeryturę. Jest autorką lub współautorką ponad 300 prac i trzech książek (Ryan, 2015). W 2021 r. otrzymała International Prize in Statistics za metody analizy badań podłużnych z 1982 r. (Royal Statistical Society, 2021).
Rebecca DerSimonian była doktorantką Laird na Harvardzie i zajmowała się modelami z efektami losowymi (Ryan, 2015). Później pracowała jako statystyczka w Biostatistics Research Branch National Institute of Allergy and Infectious Diseases (NIH); w 2017 r. została Fellow American Statistical Association (American Statistical Association, 2017; DerSimonian i Laird, 2015).
Najważniejsze pomysły
- Metaanaliza z efektami losowymi (1986). W „Controlled Clinical Trials” DerSimonian i Laird (1986) zaproponowały model, w którym prawdziwe efekty leczenia różnią się między badaniami, a wynik łączny jest średnią tych efektów. Wariancję między badaniami τ² szacuje się wprost ze statystyki Q, bez iteracji, i wystarczą do tego podsumowania z publikacji – według Laird to właśnie zamknięty wzór i praca na danych zbiorczych przyniosły metodzie popularność (Ryan, 2015). Po trzech dekadach autorki naliczyły ponad 12 000 cytowań; metodę nazywa się często „standardowym” podejściem w metaanalizie badań medycznych (DerSimonian i Laird, 2015).
- Algorytm EM (1977). Laird jest współautorką, z Dempsterem i Donaldem Rubinem, pracy o algorytmie EM. Pomysł wyrósł z jej doktoratu: szukała sposobu oszacowania składnika wariancji w modelu z efektami losowymi (Ryan, 2015).
- Modele dla danych podłużnych (1982). Z Jamesem Ware’em opisała modele z efektami losowymi dla pomiarów powtarzanych – jedną z podstaw modeli wielopoziomowych dla danych podłużnych. RSS przypomina, że to wciąż najczęściej używane podejście w badaniach obserwacyjnych i klinicznych (Royal Statistical Society, 2021).
Laird zajmowała się też brakami danych, genetyką statystyczną i epidemiologią psychiatryczną (Ryan, 2015).
Ciekawostka
Metoda DerSimonian i Laird powstała – jak mówi Laird – trochę przypadkiem i nie w medycynie, tylko przy egzaminie SAT. Frederick Mosteller poprosił ją o opinię o pracy, która łączyła 23 badania kursów przygotowujących do tego testu i wnioskowała, że kursy pomagają. Laird uderzyło, jak bardzo wyniki i schematy tych badań się różnią. Zleciła swojej doktorantce, Rebecce DerSimonian, zbudowanie modelu z losową zmiennością efektów między badaniami. Ponowna analiza (DerSimonian i Laird, 1983, w „Harvard Educational Review”) wykazała, że efekty kursów są zbyt małe, by miały praktyczne znaczenie; praca nie była często cytowana w nauce, ale zwróciła uwagę mediów. Dopiero zastosowanie tej samej metody do badań klinicznych w 1986 r. stało się – ku zaskoczeniu Laird – jedną z jej najczęściej cytowanych prac (Ryan, 2015).
Zanim trafiła na Harvard, Laird pracowała jako „inżynier” w Draper Laboratory w MIT, pisząc programy do testowania filtrów Kalmana w systemie nawigacji programu Apollo. Jak wspomina, nauczyła się tam przede wszystkim, że do twórczej pracy potrzebuje więcej wykształcenia (Ryan, 2015).
Przykład na danych z pakietu R
Zbiór dat.normand1999 z pakietu metadat zawiera według pliku pomocy wyniki 9 badań porównujących średnią długość pobytu w szpitalu (w dniach) chorych po udarze na oddziale specjalistycznym i przy zwykłej opiece. Efektem jest różnica średnich: od −71 dni (Orpington-Severe) do +11 dni (Newcastle).
Estymator DerSimoniana–Lairda liczymy ręcznie. Model efektu wspólnego daje −3.46 dnia, ale Q = 238.92 przy 8 stopniach swobody, więc badania wyraźnie się różnią (I² = 96.65%). Wzór τ² = (Q − (k − 1)) / C daje τ² = 205.41 (τ = 14.33 dnia), a efekt łączny −13.98 dnia, 95% CI [−24.03, −3.93] – dokładnie to samo co rma(method = "DL").
Inne estymatory dają jednak znacznie większą wariancję: REML 685, ML 595, Paule–Mandel 728, Hedges 772. Wartość DL leży nawet poniżej dolnej granicy przedziału Q-profile dla τ² z modelu REML (293–2890). Przy większym τ² efekt łączny to około −15 dni, a przedziały obejmują zero (REML: [−32.64, 2.43], p = .091). Podobnie działa poprawka Hartunga–Knappa–Sidika–Jonkmana: dla DL przedział rozszerza się do [−34.13, 6.17] (p = .148). Przedział predykcji z modelu DL sięga od −43.8 do 15.9 dnia.
Na rysunku
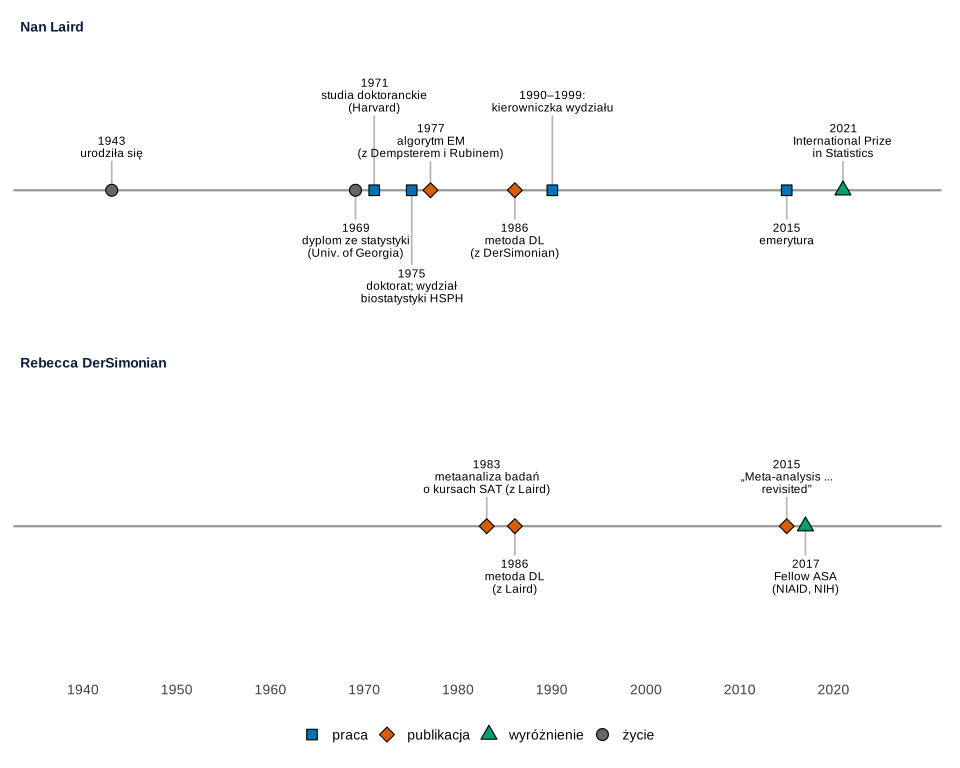
Co widać. Obie prace o metaanalizie powstają, gdy DerSimonian jest doktorantką Laird; do metody wracają razem po prawie 30 latach.
Na co uważać. Źródła, które czytaliśmy, nie podają roku urodzenia ani roku doktoratu Rebekki DerSimonian, więc ich nie zaznaczamy.
Podpis do pracy:
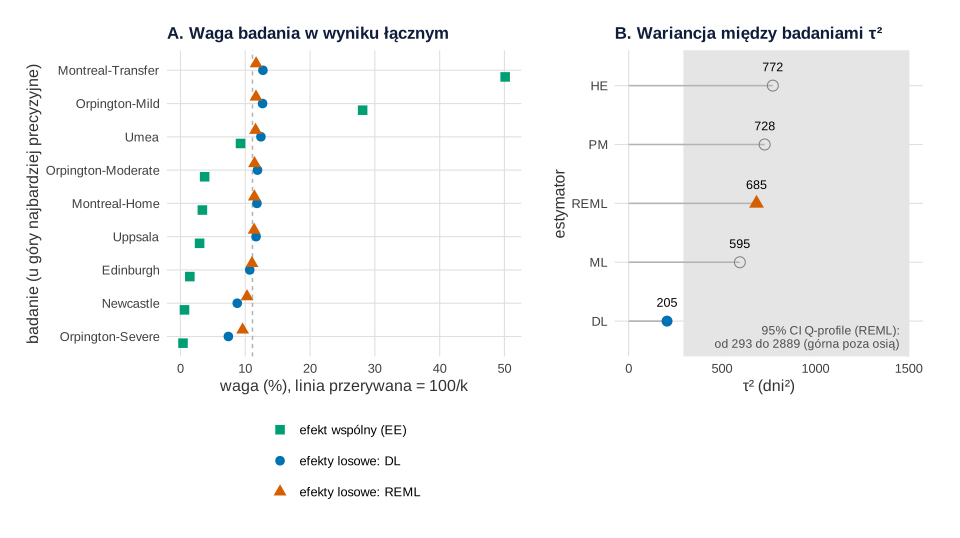
metadat::dat.normand1999 (różnica średnich długości pobytu w szpitalu po udarze). Obliczenia: R, pakiet metafor; rysunek: pakiety ggplot2 i patchwork (bez losowania).Co widać. W modelu efektu wspólnego dwa małe, ale bardzo precyzyjne badania mają razem prawie 80% wagi. Gdy dodamy τ², wagi się wyrównują – im większe τ², tym bardziej każde badanie liczy się „po równo” (panel A). Panel B pokazuje, że wybór estymatora zmienia τ² ponad trzykrotnie.
Na co uważać. Przy 9 badaniach każda ocena τ² jest bardzo niepewna – przedział Q-profile sięga od około 300 do prawie 2900 dni². Różnica między DL a REML to nie błąd programu, tylko różnica metod.
Podpis do pracy:
Gdzie spotkasz DerSimonian i Laird w swojej pracy
Zawsze, gdy w metaanalizie wybierasz model efektów losowych. Na co zwracać uwagę:
- sprawdź, który estymator τ² liczy Twój program – DL bywa domyślny (Veroniki i in., 2016), a
rma()w metafor domyślnie używa REML; w opisie metody podaj go wprost; - obok efektu łącznego raportuj τ² i I² oraz przedział predykcji, a przy małej liczbie badań rozważ poprawkę Hartunga–Knappa (więcej we wpisie Metaanaliza krok po kroku);
- wyniki pokaż na wykresie lasu, a przy danych binarnych porównaj model losowy z metodą efektu wspólnego Richarda Peto;
- w danych z pomiarami powtarzanymi spotkasz Laird ponownie – jako współautorkę modeli z efektami losowymi (REML a ML).
Spory, mity i trudne strony
- Czy DL zaniża τ²? Przegląd Veroniki i in. (2016) przypomina, że domyślny estymator DL od dawna budzi zastrzeżenia, a badania symulacyjne wskazują na lepsze właściwości estymatora Paule’a–Mandela i REML. Nasz przykład pokazuje to wyraźnie, choć na jednym zbiorze nie da się ocenić metody ogólnie.
- Testowanie efektu łącznego. Same autorki w 2015 r. zaleciły ulepszenie: odporny estymator wariancji przy testowaniu efektu łącznego (DerSimonian i Laird, 2015).
- „Efekty losowe rozwiązują heterogeniczność”. Nie rozwiązują – tylko ją uwzględniają. Laird podkreśla, że ważniejsze jest szukanie cech badań, które wyjaśniają różnice efektów; w pracy o kursach SAT wiele wyjaśniał schemat badań (Ryan, 2015). Do tego służy metaregresja.
Estymator DerSimoniana–Lairda w R
Kod wczytuje dane Normand (1999), liczy różnice średnich, wylicza τ² metodą DerSimoniana–Lairda ręcznie, porównuje go z wynikami rma() dla sześciu metod, liczy przedział Q-profile, wagi badań, poprawkę Hartunga–Knappa i przedział predykcji, a na końcu rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje.
1. τ² ręcznie i w metafor: rysunek 2
Kod R rysunku 2
# DerSimonian i Laird: τ² metodą momentów ręcznie vs rma(method = "DL") i REML (metadat::dat.normand1999)
suppressPackageStartupMessages({library(metafor); library(ggplot2); library(patchwork)})
kol <- c(EE = "#009E73", DL = "#0072B2", REML = "#D55E00", inne = "grey50")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(dat.normand1999, package = "metadat")
# 9 badań: średnia długość pobytu w szpitalu (dni) chorych po udarze na oddziale specjalistycznym (1) i zwykłym (2)
dat <- escalc(measure = "MD", m1i = m1i, sd1i = sd1i, n1i = n1i, m2i = m2i, sd2i = sd2i, n2i = n2i,
              data = dat.normand1999)
# yi < 0: krótszy pobyt przy opiece specjalistycznej; vi – wariancja różnicy średnich
data.frame(zrodlo = dat$source, roznica_dni = dat$yi, se = round(sqrt(dat$vi), 2))

# 1. Estymator DerSimoniana–Lairda ręcznie (metoda momentów oparta na statystyce Q)
k <- nrow(dat); w <- 1 / dat$vi
mu_EE <- sum(w * dat$yi) / sum(w)                          # efekt wspólny (wagi 1/vi)
Q <- sum(w * (dat$yi - mu_EE)^2)
C <- sum(w) - sum(w^2) / sum(w)
tau2_DL <- max(0, (Q - (k - 1)) / C)
w_DL <- 1 / (dat$vi + tau2_DL)
mu_DL <- sum(w_DL * dat$yi) / sum(w_DL); se_DL <- sqrt(1 / sum(w_DL))
round(c(Q = Q, df = k - 1, C = C, tau2_DL = tau2_DL, tau_DL = sqrt(tau2_DL), I2_proc = 100 * (Q - (k - 1)) / Q), 2)
round(c(mu_EE = mu_EE, mu_DL = mu_DL, dolna = mu_DL - 1.96 * se_DL, gorna = mu_DL + 1.96 * se_DL), 2)

# 2. To samo w metafor oraz inne estymatory τ²
dl <- rma(yi, vi, data = dat, method = "DL")
round(c(tau2_rma_DL = dl$tau2, mu_rma_DL = as.numeric(dl$beta)), 2)
metody <- c("EE", "DL", "HE", "ML", "REML", "PM")
por <- do.call(rbind, lapply(metody, function(m) {
  r <- rma(yi, vi, data = dat, method = m)
  data.frame(metoda = m, tau2 = r$tau2, mu = as.numeric(r$beta), dolna = r$ci.lb, gorna = r$ci.ub, p = r$pval)
}))
print(por, digits = 3, row.names = FALSE)

# 3. Niepewność τ²: przedział Q-profile (z modelu REML) – czy obejmuje wartość DL?
reml <- rma(yi, vi, data = dat, method = "REML")
ci_tau2 <- confint(reml)$random["tau^2", ]
round(ci_tau2, 1)
c(DL_ponizej_dolnej_granicy = tau2_DL < ci_tau2[["ci.lb"]])

# 4. Wagi badań (%): efekt wspólny vs DL vs REML
wagi <- data.frame(zrodlo = dat$source, EE = 100 * w / sum(w), DL = 100 * w_DL / sum(w_DL),
                   REML = 100 * weights(reml) / sum(weights(reml)))
print(wagi, digits = 2, row.names = FALSE)

# 5. Ostrożniejsze wnioskowanie o efekcie: Hartung–Knapp–Sidik–Jonkman i przedział predykcji
hk_dl <- rma(yi, vi, data = dat, method = "DL", test = "knha")
hk_reml <- rma(yi, vi, data = dat, method = "REML", test = "knha")
testy <- rbind(DL_z = c(dl$beta, dl$ci.lb, dl$ci.ub, dl$pval),
               DL_HKSJ = c(hk_dl$beta, hk_dl$ci.lb, hk_dl$ci.ub, hk_dl$pval),
               REML_HKSJ = c(hk_reml$beta, hk_reml$ci.lb, hk_reml$ci.ub, hk_reml$pval))
colnames(testy) <- c("mu", "dolna", "gorna", "p"); round(testy, 3)
pi_dl <- predict(dl); round(c(PI_dolna = pi_dl$pi.lb, PI_gorna = pi_dl$pi.ub), 1)

# Rysunek: A – wagi badań przy trzech modelach; B – τ² z sześciu estymatorów na tle przedziału Q-profile
wagi_dl <- reshape(wagi, direction = "long", varying = c("EE", "DL", "REML"), v.names = "waga",
                   timevar = "model", times = c("EE", "DL", "REML"), idvar = "zrodlo")
wagi_dl$model <- factor(wagi_dl$model, levels = c("EE", "DL", "REML"),
                        labels = c("efekt wspólny (EE)", "efekty losowe: DL", "efekty losowe: REML"))
wagi_dl$zrodlo <- factor(wagi_dl$zrodlo, levels = dat$source[order(dat$vi, decreasing = TRUE)])
pA <- ggplot(wagi_dl, aes(waga, zrodlo, colour = model, shape = model)) +
  geom_vline(xintercept = 100 / k, colour = "grey70", linetype = "22") +
  geom_point(size = 3, position = position_dodge(width = 0.6)) +
  scale_colour_manual(values = unname(kol[c("EE", "DL", "REML")]), name = NULL) +
  scale_shape_manual(values = c(15, 16, 17), name = NULL) +
  guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) +
  labs(title = "A. Waga badania w wyniku łącznym", x = "waga (%), linia przerywana = 100/k",
       y = "badanie (u góry najbardziej precyzyjne)") +
  motyw
por_tau <- subset(por, metoda != "EE")
por_tau$metoda <- factor(por_tau$metoda, levels = por_tau$metoda[order(por_tau$tau2)])
por_tau$grupa <- ifelse(por_tau$metoda %in% c("DL", "REML"), as.character(por_tau$metoda), "inne")
pB <- ggplot(por_tau, aes(tau2, metoda)) +
  geom_blank() +
  annotate("rect", xmin = ci_tau2[["ci.lb"]], xmax = 1500, ymin = -Inf, ymax = Inf, fill = "grey90") +
  annotate("text", x = 1450, y = 0.55, hjust = 1, vjust = 0, lineheight = 0.9, size = 3.2, colour = "grey30",
           label = sprintf("95%% CI Q-profile (REML):\nod %.0f do %.0f (górna poza osią)", ci_tau2[["ci.lb"]], ci_tau2[["ci.ub"]])) +
  geom_segment(aes(x = 0, xend = tau2, yend = metoda), colour = "grey70") +
  geom_point(aes(colour = grupa, shape = grupa), size = 3.5) +
  geom_text(aes(label = sprintf("%.0f", tau2)), nudge_y = 0.32, size = 3.3) +
  scale_colour_manual(values = kol[c("DL", "REML", "inne")], guide = "none") +
  scale_shape_manual(values = c(DL = 16, REML = 17, inne = 1), guide = "none") +
  coord_cartesian(xlim = c(0, 1500)) +
  labs(title = "B. Wariancja między badaniami τ²", x = "τ² (dni²)", y = "estymator") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.15, 1))
p2
Wynik w R
              zrodlo roznica_dni    se
1          Edinburgh         -20  6.36
2     Orpington-Mild          -2  1.44
3 Orpington-Moderate         -55  3.96
4   Orpington-Severe         -71 12.26
5      Montreal-Home          -4  4.16
6  Montreal-Transfer           1  1.08
7          Newcastle          11  9.73
8               Umea         -10  2.51
9            Uppsala           7  4.45
      Q      df       C tau2_DL  tau_DL I2_proc
 238.92    8.00    1.12  205.41   14.33   96.65
 mu_EE  mu_DL  dolna  gorna
 -3.46 -13.98 -24.03  -3.93
tau2_rma_DL   mu_rma_DL
     205.41      -13.98
 metoda tau2     mu  dolna gorna        p
     EE    0  -3.46  -4.96 -1.96 5.94e-06
     DL  205 -13.98 -24.03 -3.93 6.39e-03
     HE  772 -15.18 -33.75  3.39 1.09e-01
     ML  595 -15.01 -31.42  1.40 7.30e-02
   REML  685 -15.11 -32.64  2.43 9.13e-02
     PM  728 -15.15 -33.21  2.91 1.00e-01
estimate    ci.lb    ci.ub
   684.6    292.9   2889.5
DL_ponizej_dolnej_granicy
                     TRUE
             zrodlo    EE   DL REML
          Edinburgh  1.44 10.7 11.0
     Orpington-Mild 28.11 12.7 11.7
 Orpington-Moderate  3.73 11.9 11.4
   Orpington-Severe  0.39  7.4  9.6
      Montreal-Home  3.38 11.8 11.4
  Montreal-Transfer 50.11 12.7 11.7
          Newcastle  0.62  8.8 10.3
               Umea  9.27 12.4 11.6
            Uppsala  2.95 11.7 11.4
               mu   dolna  gorna     p
DL_z      -13.982 -24.030 -3.934 0.006
DL_HKSJ   -13.982 -34.129  6.165 0.148
REML_HKSJ -15.106 -36.319  6.107 0.139
PI_dolna PI_gorna
   -43.8     15.9
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Rebecca DerSimonian i Nan Laird (ur. 1943) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1943, 1969, 1971, 1975, 1977, 1986, 1990, 2015, 2021,
          1983, 1986, 2015, 2017),
  osoba = c(rep("Nan Laird", 9), rep("Rebecca DerSimonian", 4)),
  opis = c("urodziła się", "dyplom ze statystyki\n(Univ. of Georgia)", "studia doktoranckie\n(Harvard)",
           "doktorat; wydział\nbiostatystyki HSPH", "algorytm EM\n(z Dempsterem i Rubinem)", "metoda DL\n(z DerSimonian)",
           "1990–1999:\nkierowniczka wydziału", "emerytura", "International Prize\nin Statistics",
           "metaanaliza badań\no kursach SAT (z Laird)", "metoda DL\n(z Laird)", "„Meta-analysis ...\nrevisited”",
           "Fellow ASA\n(NIAID, NIH)"),
  rodzaj = c("życie", "życie", "praca", "praca", "publikacja", "publikacja", "praca", "praca", "wyróżnienie",
             "publikacja", "publikacja", "publikacja", "wyróżnienie"),
  poziom = c(0.45, -0.45, 1.15, -1.15, 0.45, -0.45, 1.15, -0.45, 0.45,
             0.45, -0.45, 0.45, -0.45),                       # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5,
                 0.5, 0.5, 0.5, 0.5))
zdarzenia$etykieta <- ifelse(zdarzenia$rok == 1990, zdarzenia$opis, paste0(zdarzenia$rok, "\n", zdarzenia$opis))
zdarzenia$osoba <- factor(zdarzenia$osoba, levels = c("Nan Laird", "Rebecca DerSimonian"))
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  facet_wrap(~ osoba, ncol = 1) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1937, 2027), breaks = seq(1940, 2020, by = 10)) +
  scale_y_continuous(limits = c(-2.1, 2.1)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        strip.text = element_text(face = "bold", hjust = 0), legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (metaanaliza – funkcje escalc(), rma(), confint() i predict() z pakietu metafor z danymi z pakietu metadat; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- metafor (wersja 5.2.1): Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03
- metadat (wersja 1.6.0): Viechtbauer, W., White, T., Noble, D., Senior, A., & Hamilton, W. (2026). metadat: Meta-analysis datasets [R package]. https://doi.org/10.32614/CRAN.package.metadat
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim są Rebecca DerSimonian i Nan Laird?
Amerykańskimi biostatystyczkami. Nan Laird (ur. 1943) obroniła doktorat na Harvardzie w 1975 r., kierowała wydziałem biostatystyki Harvard School of Public Health (1990–1999) i w 2021 r. dostała International Prize in Statistics. Rebecca DerSimonian była jej doktorantką, a później statystyczką w National Institute of Allergy and Infectious Diseases (NIH).
Jak policzyć τ² metodą DerSimoniana–Lairda?
Najpierw liczy się efekt wspólny z wagami 1/vᵢ i statystykę Q. Potem τ² = (Q − (k − 1)) / C, gdzie C = Σwᵢ − Σwᵢ²/Σwᵢ, a ujemny wynik zastępuje się zerem. W przykładzie z 9 badaniami długości pobytu po udarze Q = 238.92, C = 1.12 i τ² = 205.41 – tyle samo co w rma(method = "DL").
Czy lepiej używać DL czy REML?
Przegląd metod (Veroniki i in., 2016) wskazuje, że estymatory Paule’a–Mandela i REML zwykle mają lepsze właściwości niż DL. W przykładzie DL daje τ² = 205, a REML 685; przy REML przedział dla efektu łącznego obejmuje zero. Warto podać, który estymator zastosowano, i sprawdzić wrażliwość wniosków.
Skąd wzięła się metoda DerSimoniana–Lairda?
Z analizy badań o kursach przygotowujących do egzaminu SAT. Frederick Mosteller poprosił Laird o ocenę pracy łączącej 23 takie badania; ich zmienność skłoniła ją i DerSimonian do zbudowania modelu z efektami losowymi (1983). W 1986 r. zastosowały go do badań klinicznych.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Metaanaliza krok po kroku
Od pytania do PRISMA 2020: g Hedgesa, model efektów losowych, heterogeniczność i przedział predykcji, moderatory, wykres lejkowy – z kodem metafor.
Czytaj →PoradnikKalkulator metaanalizy z wykresem lasu
Model stały i losowy (REML, DL, Knapp–Hartung), Q, I², H², przedział predykcji i wykres lasu SVG z efektów i SE albo przedziałów ufności.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- American Statistical Association. (2017). 62 statisticians recognized as 2017 ASA Fellows. https://www.amstat.org/asa/files/pdfs/pressreleases/2017-ASA-Fellows.pdf ● Otwarty dostęp
- DerSimonian, R., & Laird, N. (1986). Meta-analysis in clinical trials. Controlled Clinical Trials, 7(3), 177–188. https://doi.org/10.1016/0197-2456(86)90046-2
- DerSimonian, R., & Laird, N. (2015). Meta-analysis in clinical trials revisited. Contemporary Clinical Trials, 45, 139–145. https://doi.org/10.1016/j.cct.2015.09.002 ● Otwarty dostęp: pełny tekst
- Royal Statistical Society. (2021). International Prize in Statistics awarded to Nan Laird. https://rss.org.uk/news-publication/news-publications/2021/general-news/international-prize-in-statistics-awarded-to-nan-l/ ● Otwarty dostęp
- Ryan, L. (2015). A conversation with Nan Laird. Statistical Science, 30(4), 582–596. https://doi.org/10.1214/15-sts528 ● Otwarty dostęp
- Veroniki, A. A., Jackson, D., Viechtbauer, W., Bender, R., Bowden, J., Knapp, G., Kuss, O., Higgins, J. P. T., Langan, D., & Salanti, G. (2016). Methods to estimate the between-study variance and its uncertainty in meta-analysis. Research Synthesis Methods, 7(1), 55–79. https://doi.org/10.1002/jrsm.1164 ● Otwarty dostęp
Cytowania BibTeX
@misc{asa2017fellows, author={{American Statistical Association}}, title={{62 statisticians recognized as 2017 ASA Fellows}}, year={2017}, publisher={American Statistical Association}, url={https://www.amstat.org/asa/files/pdfs/pressreleases/2017-ASA-Fellows.pdf}}@article{dersimonian1986meta, author={DerSimonian, Rebecca and Laird, Nan}, title={{Meta-analysis in clinical trials}}, journal={Controlled Clinical Trials}, year={1986}, volume={7}, number={3}, pages={177--188}, doi={10.1016/0197-2456(86)90046-2}}@article{dersimonian2015meta, author={DerSimonian, Rebecca and Laird, Nan}, title={{Meta-analysis in clinical trials revisited}}, journal={Contemporary Clinical Trials}, year={2015}, volume={45}, pages={139--145}, doi={10.1016/j.cct.2015.09.002}}@misc{rss2021laird, author={{Royal Statistical Society}}, title={{International Prize in Statistics awarded to Nan Laird}}, year={2021}, publisher={Royal Statistical Society}, url={https://rss.org.uk/news-publication/news-publications/2021/general-news/international-prize-in-statistics-awarded-to-nan-l/}}@article{ryan2015conversation, author={Ryan, Louise}, title={{A conversation with Nan Laird}}, journal={Statistical Science}, year={2015}, volume={30}, number={4}, pages={582--596}, doi={10.1214/15-sts528}}@article{veroniki2016methods, author={Veroniki, Areti Angeliki and Jackson, Dan and Viechtbauer, Wolfgang and Bender, Ralf and Bowden, Jack and Knapp, Guido and Kuss, Oliver and Higgins, Julian P. T. and Langan, Dean and Salanti, Georgia}, title={{Methods to estimate the between-study variance and its uncertainty in meta-analysis}}, journal={Research Synthesis Methods}, year={2016}, volume={7}, number={1}, pages={55--79}, doi={10.1002/jrsm.1164}}