Kim jest Paul R. Rosenbaum?
Paul R. Rosenbaum to amerykański statystyk, specjalista od planowania i analizy badań obserwacyjnych, profesor emerytowany statystyki i nauki o danych w Wharton School Uniwersytetu Pensylwanii. Licencjat zrobił w Hampshire College (1977), a magisterium (1978) i doktorat (1980) na Uniwersytecie Harvarda (University of Pennsylvania, b.d.). Promotorem był Donald B. Rubin, który poznał go w 1978 r. jako doktoranta pierwszego roku (Li i Mealli, 2014).
W latach 1980–1981 był statystykiem w amerykańskiej Agencji Ochrony Środowiska (EPA), potem pracował na University of Wisconsin w Madison, w latach 1983–1986 w Educational Testing Service, a od 1986 r. w Wharton School. Otrzymał m.in. Nagrodę Snedecora (2003) i Nagrodę oraz Wykład Fishera (2019) przyznawane przez komitet prezesów towarzystw statystycznych COPSS (University of Pennsylvania, b.d.).
Najważniejsze pomysły
- Propensity score (1983). Z Rubinem pokazał, że do usunięcia obciążenia wynikającego ze wszystkich zmierzonych cech wystarczy korekta o jedną liczbę – warunkowe prawdopodobieństwo przydziału do leczenia. Zaproponowali dopasowanie, podklasyfikację i graficzną kontrolę korekty (Rosenbaum i Rubin, 1983). Dziś to podstawa metod opisanych w hasłach propensity score i wagi IPW.
- Analiza wrażliwości (1987). Dopasowanie wyrównuje tylko to, co zmierzono. Rosenbaum (1987) zaproponował prosty sposób pokazania, jak wnioski z testów permutacyjnych – testu Wilcoxona dla par i testu McNemara–Coxa – zmieniają się przy różnych założeniach o niezmierzonych zmiennych. Tak powstała analiza wrażliwości z parametrem Γ.
- Projektowanie badań obserwacyjnych. Jego podręcznik z 2025 r. obejmuje propensity score, dopasowanie optymalne, analizę wrażliwości, wrażliwość planu badania i czynniki dowodowe, a przykłady dotyczą skutków zdrowotnych picia alkoholu (University of Pennsylvania, b.d.).
- Książki dla szerszego grona. „Observation and Experiment” (2017) wyjaśnia pojęcia wnioskowania przyczynowego na prawdziwych przykładach (Rosenbaum, 2017), a krótkie „Causal Inference” ukazało się w 2023 r.
Ciekawostka
Propensity score nie powstał przy biurku, tylko w pracy konsultingowej. Rubin opowiadał (Li i Mealli, 2014), że doradzał psycholożce June Reinisch, która badała skutki prenatalnej ekspozycji na hormony (w eksperymentach na zwierzętach podawano je ciężarnym samicom). W danych o ludziach trzeba było dopasować osoby narażone i nienarażone pod względem wielu cech – ciągłych, dyskretnych i rzadkich, jak poważne choroby przed ciążą lub na jej początku. Dopasowanie odległością Mahalanobisa zawodziło przy tak wielu zmiennych. Wtedy Rubin z Rosenbaumem zauważyli, że wystarczy dopasować prawdopodobieństwa przydziału. Według Rubina pierwszy szkic tej idei powstał przy danych z Duke o operacjach pomostowania aortalno-wieńcowego, a dopracowano ją na danych Reinisch – w ramach doktoratu Rosenbauma.
Według tej samej relacji Rosenbaum był prawdopodobnie pierwszym studentem Rubina na Harvardzie, który zajął się statystyką w prawie: w 1978 r. napisał pracę zaliczeniową lub kwalifikacyjną o skutkach kary śmierci.
Przykład na danych z pakietu R
Zbiór lalonde z pakietu MatchIt to według pliku pomocy podpróba uczestników programu szkoleń zawodowych National Supported Work (185 osób) i próba porównawcza 429 osób z badania PSID. Dehejia i Wahba (1999) pokazali na tych danych, że oszacowania z propensity score są znacznie bliższe wynikowi eksperymentu niż estymatory, które wcześniej ocenił LaLonde – pod warunkiem, że grupy nakładają się na siebie, a o udziale decydują zmierzone cechy.
Przed dopasowaniem grupy są skrajnie różne: mediana propensity score (PS) wynosi .654 u uczestników i .039 w PSID, a 7 z 8 cech ma |SMD| powyżej 0.1 (najwięcej odsetek osób czarnoskórych, SMD = 1.76). Surowa różnica zarobków w 1978 r. jest ujemna: −635 USD.
Dopasowanie 1:1 do najbliższego sąsiada bez zwracania zawodzi: osób z PSID podobnych do uczestników jest za mało, więc pary różnią się PS nawet o 0.449, a 4 cechy nadal mają |SMD| > 0.1. Gdy tę samą osobę z PSID wolno dobrać wielokrotnie (ze zwracaniem), pary tworzy 80 różnych osób, największa różnica PS spada do 0.064, a powyżej 0.1 zostają tylko wiek (0.24) i stan cywilny (0.15). Różnica zarobków w parach rośnie wtedy do 1968 USD (894 USD bez zwracania). Ręczne pary dają te same wartości PS dobranych kontroli co funkcja matchit().
Na rysunku
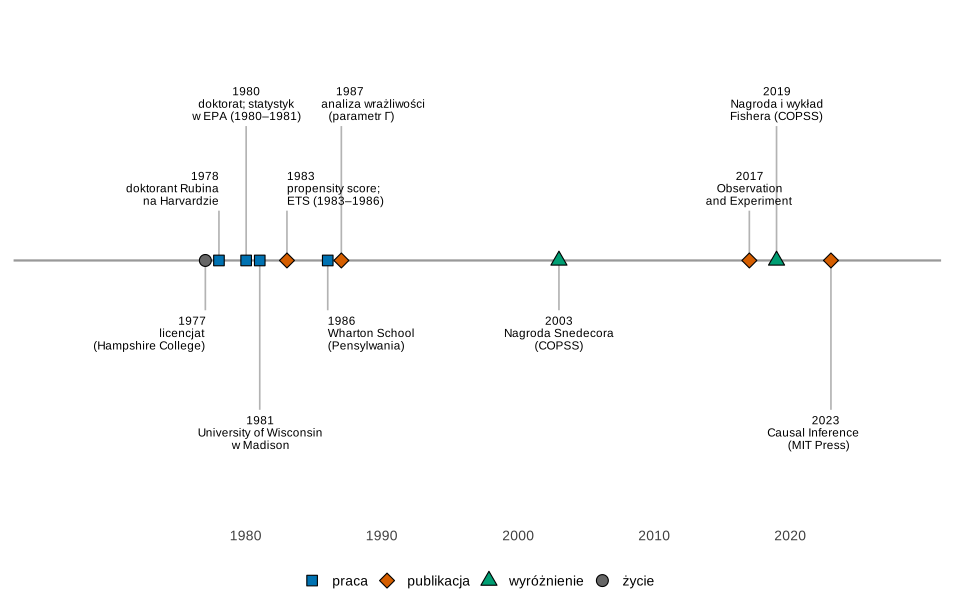
Co widać. Najważniejsze prace metodologiczne – propensity score i analiza wrażliwości – powstały w ciągu kilku lat po doktoracie; późniejsze dekady to książki o projektowaniu badań obserwacyjnych i nagrody.
Na co uważać. Strona Wharton School nie podaje lat pracy w Madison; rok 1981 przyjęliśmy za relacją Rubina, że Rosenbaum przeszedł tam po rozwiązaniu zespołu w EPA. Ta sama strona w jednym miejscu podaje dla Nagrody Fishera rok 1970 – to oczywista pomyłka, bo w innym miejscu i w dorobku widnieje 2019.
Podpis do pracy:
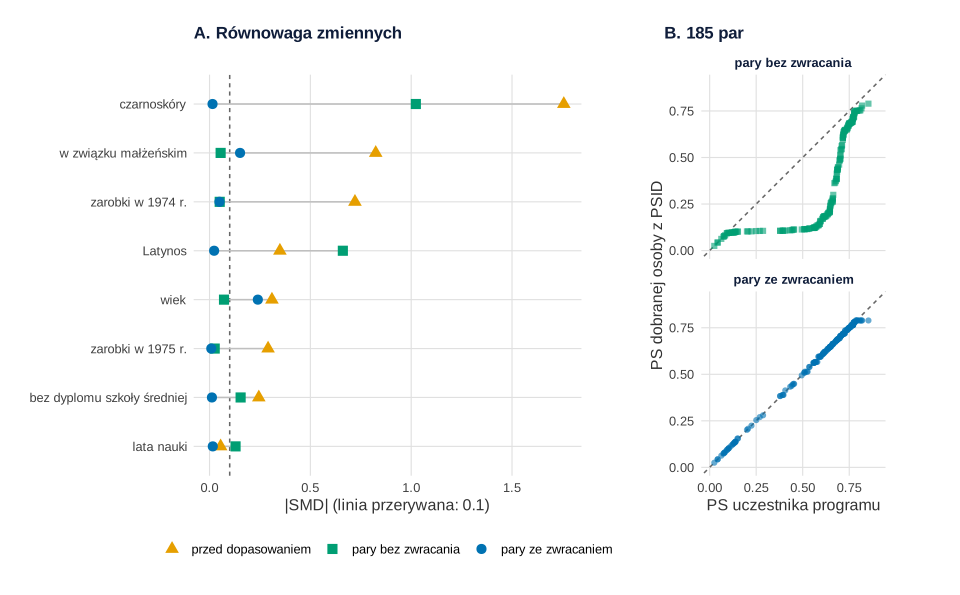
MatchIt::lalonde (185 uczestników NSW, 429 osób z PSID). Obliczenia i rysunek: R, pakiety ggplot2 i patchwork; kontrola – MatchIt.Co widać. W panelu A trójkąty (przed dopasowaniem) leżą daleko od zera; kwadraty (bez zwracania) poprawiają część cech, ale nie pochodzenie; koła (ze zwracaniem) zbliżają się do linii 0.1. Panel B pokazuje przyczynę: bez zwracania uczestnikom z wysokim PS zabrakło podobnych osób, więc dostali kontrole z PS około 0.1.
Na co uważać. Dopasowanie ze zwracaniem opiera porównanie na 80 osobach z PSID, z których część występuje w wielu parach – oszacowanie jest mniej precyzyjne, a błąd standardowy wymaga metod uwzględniających powtórzenia, dlatego go nie podajemy. Równowaga zmierzonych cech nie mówi nic o niezmierzonych.
Podpis do pracy:
Gdzie spotkasz Rosenbauma w swojej pracy
- Gdy porównujesz grupy, które same wybrały interwencję (schemat obserwacyjny), szacujesz propensity score regresją logistyczną z cech sprzed interwencji, zanim spojrzysz na wynik. Praktyczny przewodnik to wpis propensity score: dopasowanie i ważenie.
- Po dopasowaniu raportujesz standaryzowane różnice średnich, a nie wartości p, i sprawdzasz wspólne wsparcie – przykład wyżej pokazuje, co się dzieje, gdy go brakuje.
- W dyskusji opisujesz, jak silna musiałaby być zmienna zakłócająca, żeby zmienić wniosek – to analiza wrażliwości Rosenbauma.
Spory, mity i trudne strony
- Propensity score nie zastępuje losowania. Usuwa obciążenie tylko ze zmierzonych cech (Rosenbaum i Rubin, 1983). Dehejia i Wahba (1999) podkreślali, że ich wyniki są wrażliwe na założenie, że o udziale w programie decydowały zmierzone cechy.
- Wynik zależy od decyzji badacza. Te same dane i ten sam model PS dały różnicę 894 albo 1968 USD w zależności od jednego ustawienia. Dlatego sposób dopasowania ustala się i sprawdza równowagę, zanim spojrzy się na wynik.
- Kategorie pochodzenia. Zmienne „czarnoskóry” i „Latynos” pochodzą z oryginalnych danych i opisują pochodzenie tak, jak zapisano je w badaniu; w przykładzie służą tylko jako cechy do wyrównania grup.
Dopasowanie na propensity score w R
Kod wczytuje dane lalonde z pakietu MatchIt, szacuje propensity score regresją logistyczną, dobiera pary metodą najbliższego sąsiada bez zwracania i ze zwracaniem, porównuje standaryzowane różnice średnich i zarobki w 1978 r., sprawdza pary w MatchIt i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu. Kod nie losuje.
1. Propensity score, dopasowanie i równowaga: rysunek 2
Kod R rysunku 2
# Paul Rosenbaum: dopasowanie na propensity score „ręcznie” i równowaga zmiennych – dane MatchIt::lalonde
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(przed = "#E69F00", bez_zwracania = "#009E73", ze_zwracaniem = "#0072B2")   # Okabe–Ito
etyk <- c(przed = "przed dopasowaniem", bez_zwracania = "pary bez zwracania", ze_zwracaniem = "pary ze zwracaniem")
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(lalonde, package = "MatchIt")
# 185 uczestników programu szkoleń zawodowych NSW (treat = 1) i 429 osób z badania PSID (treat = 0);
# re74, re75 – zarobki przed programem, re78 – zarobki w 1978 r. (USD)
d <- lalonde
d$czarny <- as.numeric(d$race == "black"); d$latynos <- as.numeric(d$race == "hispan")
table(d$treat)

# 1. Propensity score: regresja logistyczna przydziału na cechy sprzed programu
ps_model <- glm(treat ~ age + educ + race + married + nodegree + re74 + re75, family = binomial, data = d)
d$ps <- fitted(ps_model)
round(do.call(rbind, tapply(d$ps, d$treat, summary)), 3)

# 2. Dopasowanie 1:1 do najbliższego sąsiada na PS (bez kalipra), uczestnicy od najwyższego PS
uczestnicy <- which(d$treat == 1)[order(-d$ps[d$treat == 1])]
kontrole <- which(d$treat == 0)
najblizszy <- function(i, pula) pula[which.min(abs(d$ps[pula] - d$ps[i]))]
# a) bez zwracania: każda osoba z PSID może trafić tylko do jednej pary
wolne <- kontrole; para_bez <- integer(0)
for (i in uczestnicy) { j <- najblizszy(i, wolne); para_bez <- c(para_bez, j); wolne <- setdiff(wolne, j) }
# b) ze zwracaniem: ta sama osoba z PSID może być kontrolą dla wielu uczestników
para_ze <- sapply(uczestnicy, najblizszy, pula = kontrole)
rbind(bez_zwracania = c(rozne_kontrole = length(unique(para_bez)),
                        roznica_ps_max = round(max(abs(d$ps[uczestnicy] - d$ps[para_bez])), 3)),
      ze_zwracaniem = c(rozne_kontrole = length(unique(para_ze)),
                        roznica_ps_max = round(max(abs(d$ps[uczestnicy] - d$ps[para_ze])), 3)))

# 3. Równowaga: standaryzowana różnica średnich (mianownik – SD w grupie uczestników, jak przy ATT)
zmienne <- c(age = "wiek", educ = "lata nauki", czarny = "czarnoskóry", latynos = "Latynos",
             married = "w związku małżeńskim", nodegree = "bez dyplomu szkoły średniej",
             re74 = "zarobki w 1974 r.", re75 = "zarobki w 1975 r.")
smd <- function(v, kontrola) (mean(d[[v]][uczestnicy]) - mean(d[[v]][kontrola])) / sd(d[[v]][uczestnicy])
rownowaga <- data.frame(zmienna = zmienne,
  przed = sapply(names(zmienne), smd, kontrola = kontrole),
  bez_zwracania = sapply(names(zmienne), smd, kontrola = para_bez),
  ze_zwracaniem = sapply(names(zmienne), smd, kontrola = para_ze))
round(rownowaga[, -1], 2)
colSums(abs(rownowaga[, -1]) > 0.1)          # ile zmiennych z |SMD| > 0.1

# 4. Efekt programu na zarobki w 1978 r. u uczestników (ATT): surowa różnica i średnia różnica w parach
round(c(surowa = mean(d$re78[uczestnicy]) - mean(d$re78[kontrole]),
        pary_bez_zwracania = mean(d$re78[uczestnicy] - d$re78[para_bez]),
        pary_ze_zwracaniem = mean(d$re78[uczestnicy] - d$re78[para_ze])))

# Sprawdzenie w MatchIt (najbliższy sąsiad na PS z regresji logistycznej, od największego PS): dobrane kontrole
# mają te same wartości PS; przy remisach (kilka osób z PSID o identycznym PS) MatchIt może wybrać inną z nich
suppressPackageStartupMessages(library(MatchIt))
f <- treat ~ age + educ + race + married + nodegree + re74 + re75
mi_bez <- matchit(f, data = d, method = "nearest", distance = "glm", m.order = "largest")
mi_ze  <- matchit(f, data = d, method = "nearest", distance = "glm", m.order = "largest", replace = TRUE)
ps_kontroli <- function(mi) d$ps[match(mi$match.matrix[rownames(d)[uczestnicy], 1], rownames(d))]
c(bez_zwracania = isTRUE(all.equal(ps_kontroli(mi_bez), d$ps[para_bez])),
  ze_zwracaniem = isTRUE(all.equal(ps_kontroli(mi_ze), d$ps[para_ze])))

# Rysunek: A – love plot (|SMD|), B – PS uczestnika vs PS dobranej osoby z PSID
dl <- data.frame(zmienna = factor(rep(rownowaga$zmienna, 3), levels = rownowaga$zmienna[order(abs(rownowaga$przed))]),
                 kiedy = factor(rep(names(kol), each = nrow(rownowaga)), levels = names(kol)),
                 smd = abs(c(rownowaga$przed, rownowaga$bez_zwracania, rownowaga$ze_zwracaniem)))
pA <- ggplot(dl, aes(smd, zmienna, shape = kiedy, colour = kiedy)) +
  geom_vline(xintercept = 0.1, linetype = "22", colour = "grey40") +
  geom_line(aes(group = zmienna), colour = "grey75") +
  geom_point(size = 3.2) +
  scale_colour_manual(values = kol, labels = etyk, name = NULL) +
  scale_shape_manual(values = c(przed = 17, bez_zwracania = 15, ze_zwracaniem = 16), labels = etyk, name = NULL) +
  labs(title = "A. Równowaga zmiennych", x = "|SMD| (linia przerywana: 0.1)", y = NULL) +
  motyw + theme(legend.direction = "vertical")
dp <- rbind(data.frame(rodzaj = etyk[["bez_zwracania"]], ps_u = d$ps[uczestnicy], ps_k = d$ps[para_bez]),
            data.frame(rodzaj = etyk[["ze_zwracaniem"]], ps_u = d$ps[uczestnicy], ps_k = d$ps[para_ze]))
pB <- ggplot(dp, aes(ps_u, ps_k, colour = rodzaj, shape = rodzaj)) +
  geom_abline(slope = 1, intercept = 0, linetype = "22", colour = "grey40") +
  geom_point(alpha = 0.6, size = 1.8) +
  facet_wrap(~ rodzaj, ncol = 1) +
  scale_colour_manual(values = setNames(kol[2:3], etyk[2:3]), guide = "none") +
  scale_shape_manual(values = setNames(c(15, 16), etyk[2:3]), guide = "none") +
  coord_equal(xlim = c(0, 0.9), ylim = c(0, 0.9)) +
  labs(title = "B. 185 par", x = "PS uczestnika programu", y = "PS dobranej osoby z PSID") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.5, 1))
p2
Wynik w R
  0   1
429 185
   Min. 1st Qu. Median  Mean 3rd Qu.  Max.
0 0.009   0.039  0.076 0.182   0.195 0.789
1 0.025   0.526  0.654 0.577   0.727 0.853
              rozne_kontrole roznica_ps_max
bez_zwracania            185          0.449
ze_zwracaniem             80          0.064
         przed bez_zwracania ze_zwracaniem
age      -0.31          0.07          0.24
educ      0.05         -0.13         -0.02
czarny    1.76          1.02          0.01
latynos  -0.35         -0.66         -0.02
married  -0.82         -0.06          0.15
nodegree  0.24          0.15          0.01
re74     -0.72         -0.05         -0.05
re75     -0.29         -0.03          0.01
        przed bez_zwracania ze_zwracaniem
            7             4             2
            surowa pary_bez_zwracania pary_ze_zwracaniem
              -635                894               1968
bez_zwracania ze_zwracaniem
         TRUE          TRUE
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Paul R. Rosenbaum – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1977, 1978, 1980, 1981, 1983, 1986, 1987, 2003, 2017, 2019, 2023),
  opis = c("licencjat\n(Hampshire College)", "doktorant Rubina\nna Harvardzie", "doktorat; statystyk\nw EPA (1980–1981)",
           "University of Wisconsin\nw Madison", "propensity score;\nETS (1983–1986)", "Wharton School\n(Pensylwania)",
           "analiza wrażliwości\n(parametr Γ)", "Nagroda Snedecora\n(COPSS)", "Observation\nand Experiment",
           "Nagroda i wykład\nFishera (COPSS)", "Causal Inference\n(MIT Press)"),
  rodzaj = c("życie", "praca", "praca", "praca", "publikacja", "praca", "publikacja", "wyróżnienie", "publikacja",
             "wyróżnienie", "publikacja"),
  poziom = c(-0.5, 0.5, 1.35, -1.5, 0.5, -0.5, 1.35, -0.5, 0.5, 1.35, -1.5),   # wysokość etykiety
  wyrownanie = c(1, 1, 0.5, 0.5, 0, 0, 0.2, 0.5, 0.5, 0.5, 0.7))   # rozsunięcie bliskich etykiet
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1966, 2028), breaks = seq(1980, 2020, by = 10)) +
  scale_y_continuous(limits = c(-2.4, 2.25)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (propensity score – funkcja glm() z pakietu stats; dopasowanie – kod własny, sprawdzony funkcją matchit() z pakietu MatchIt; dane – pakiet MatchIt; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MatchIt (wersja 4.8.2): Ho, D. E., Imai, K., King, G., & Stuart, E. A. (2011). MatchIt: Nonparametric preprocessing for parametric causal inference. Journal of Statistical Software, 42(8), 1–28. https://doi.org/10.18637/jss.v042.i08
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim jest Paul Rosenbaum?
Amerykańskim statystykiem, profesorem emerytowanym Wharton School Uniwersytetu Pensylwanii, gdzie pracował od 1986 r. Doktorat zrobił na Harvardzie w 1980 r. u Donalda Rubina; wcześniej pracował w EPA, na University of Wisconsin i w Educational Testing Service. Zajmuje się planowaniem i analizą badań obserwacyjnych.
Co wymyślili Rosenbaum i Rubin w 1983 roku?
Propensity score – prawdopodobieństwo otrzymania interwencji przy zmierzonych cechach. Pokazali, że korekta o tę jedną liczbę wystarcza, by usunąć obciążenie wynikające ze wszystkich zmierzonych cech, np. przez dopasowanie lub podklasyfikację (Rosenbaum i Rubin, 1983).
Jak sprawdzić, czy dopasowanie na propensity score się udało?
Porównaj standaryzowane różnice średnich cech przed dopasowaniem i po nim oraz podobieństwo PS w parach. W danych lalonde dopasowanie bez zwracania zostawiło 4 cechy z |SMD| powyżej 0.1, a ze zwracaniem – 2; o efekcie warto mówić dopiero po takiej kontroli.
Od której książki Rosenbauma zacząć?
Od „Observation and Experiment” (2017) – wprowadzenia do wnioskowania przyczynowego, które tłumaczy pojęcia na przykładach z rzeczywistych badań. Krótsze „Causal Inference” ukazało się w 2023 r., a podręcznik teorii badań obserwacyjnych dla osób po kursie statystyki matematycznej – w 2025 r.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Dehejia, R. H., & Wahba, S. (1999). Causal effects in nonexperimental studies: Reevaluating the evaluation of training programs. Journal of the American Statistical Association, 94(448), 1053–1062. https://doi.org/10.1080/01621459.1999.10473858
- Li, F., & Mealli, F. (2014). A conversation with Donald B. Rubin. Statistical Science, 29(3), 439–457. https://doi.org/10.1214/14-sts489 ● Otwarty dostęp
- Rosenbaum, P. R. (1987). Sensitivity analysis for certain permutation inferences in matched observational studies. Biometrika, 74(1), 13–26. https://doi.org/10.1093/biomet/74.1.13
- Rosenbaum, P. R. (2017). Observation and experiment: An introduction to causal inference. Harvard University Press. https://doi.org/10.4159/9780674982697
- Rosenbaum, P. R., & Rubin, D. B. (1983). The central role of the propensity score in observational studies for causal effects. Biometrika, 70(1), 41–55. https://doi.org/10.1093/biomet/70.1.41 ● Otwarty dostęp
- University of Pennsylvania. (b.d.). Paul R. Rosenbaum. The Wharton School – Faculty. https://faculty.wharton.upenn.edu/profile/rosenbap ● Otwarty dostęp
Cytowania BibTeX
@article{dehejia1999causal, author={Dehejia, Rajeev H. and Wahba, Sadek}, title={{Causal effects in nonexperimental studies: Reevaluating the evaluation of training programs}}, journal={Journal of the American Statistical Association}, year={1999}, volume={94}, number={448}, pages={1053--1062}, doi={10.1080/01621459.1999.10473858}}@article{li2014conversation, author={Li, Fan and Mealli, Fabrizia}, title={{A conversation with Donald B. Rubin}}, journal={Statistical Science}, year={2014}, volume={29}, number={3}, pages={439--457}, doi={10.1214/14-sts489}}@article{rosenbaum1987sensitivity, author={Rosenbaum, Paul R.}, title={{Sensitivity analysis for certain permutation inferences in matched observational studies}}, journal={Biometrika}, year={1987}, volume={74}, number={1}, pages={13--26}, doi={10.1093/biomet/74.1.13}}@book{rosenbaum2017observation, author={Rosenbaum, Paul R.}, title={{Observation and experiment: An introduction to causal inference}}, year={2017}, publisher={Harvard University Press}, doi={10.4159/9780674982697}}@article{rosenbaum1983central, author={Rosenbaum, Paul R. and Rubin, Donald B.}, title={{The central role of the propensity score in observational studies for causal effects}}, journal={Biometrika}, year={1983}, volume={70}, number={1}, pages={41--55}, doi={10.1093/biomet/70.1.41}}@misc{upenn2026rosenbaum, author={{University of Pennsylvania}}, title={{Paul R. Rosenbaum}}, howpublished={The Wharton School – Faculty}, year={b.d.}, publisher={The Wharton School, University of Pennsylvania}, url={https://faculty.wharton.upenn.edu/profile/rosenbap}}