Co to jest wspólne wsparcie i kaliper?
Wspólne wsparcie (ang. common support, overlap) to zakres propensity score (PS), w którym są zarówno osoby leczone, jak i nieleczone. Kaliper (ang. caliper) to największa dopuszczalna odległość między osobą leczoną a dopasowaną kontrolą; dalsza para nie powstaje. Oba narzędzia chronią przed porównywaniem osób, które nie mają odpowiedników w drugiej grupie. Stuart (2010) opisuje cel dopasowania jako uzyskanie grup o podobnych rozkładach zmiennych towarzyszących, jak w eksperymencie z losowaniem.
Wspólne wsparcie
Słabe nakładanie się rozkładów daje nieprecyzyjne oszacowania i silną zależność wyniku od specyfikacji modelu (Crump i in., 2009). Najprostsza reguła usuwa osoby z PS poniżej większego z minimów i powyżej mniejszego z maksimów obu grup. Crump i in. (2009) wyznaczają optymalne podpróby i jako przybliżenie podają regułę: pomiń osoby z PS spoza przedziału 0.1–0.9. Każde przycięcie zmienia populację, do której odnosi się wynik, czyli estymandę, więc trzeba to opisać. Słabe nakładanie się daje też skrajne wagi IPW.
Kaliper
Austin (2011) w symulacjach zalecił dopasowanie na logicie PS z kaliprem równym 0.2 odchylenia standardowego logitu. Taki kaliper usuwał co najmniej 98% obciążenia surowego oszacowania i dawał przedziały ufności o prawie nominalnym pokryciu. Węższy kaliper daje bardziej podobne pary, ale odrzuca więcej osób leczonych.
Przykład
W przykładzie z R na 1000 osób (384 leczone) 16 leży poza wspólnym wsparciem, a 92 poza przedziałem 0.1–0.9. Kaliper wynosi 0.230 na skali logitu. Powstało 317 par, a 67 leczonych zostało bez pary. Standaryzowana różnica średnich wieku (liczona z łącznego SD obu grup) spadła z 0.735 do 0.107, a ciężkości choroby z 0.608 do 0.022. MatchIt dzieli przez SD grupy leczonej i podaje 0.708 → 0.103 oraz 0.606 → 0.022. Wynik dotyczy więc leczonych, dla których znaleziono parę, a nie wszystkich leczonych. Pełny przebieg analizy opisuje wpis propensity score: dopasowanie i ważenie.
Na rysunku
Panel A pokazuje 1000 osób z przykładu (set.seed(58001)). Panele B i C to 1000 symulowanych badań z tym samym modelem przydziału (set.seed(5800)). Do danych dodano wynik z prawdziwym efektem leczenia równym 1; jego współczynniki i zestaw kaliprów ustawiono ręcznie, ziarna nie zmieniano.
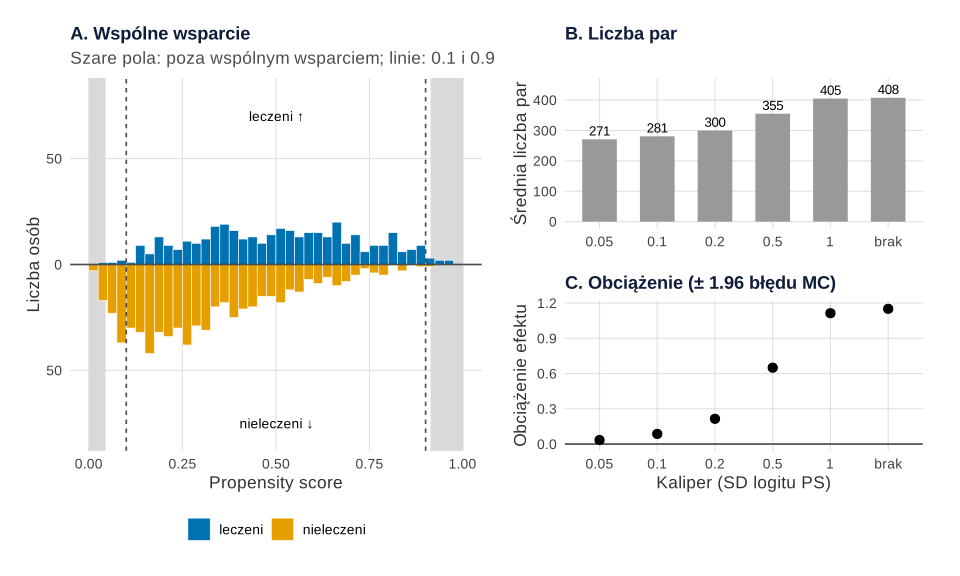
set.seed(58001) i set.seed(5800)).Co widać. W panelu A wspólne wsparcie zaczyna się przy PS = 0.045 i kończy przy 0.913: poniżej leży 12 osób, powyżej 4. Szare pola są wąskie, ale nieleczonych przy wysokim PS jest tak mało, że leczeni z tego obszaru mają odpowiedniki tylko formalnie. Panele B i C pokazują wymianę. Bez kalipra powstaje średnio 408 par, ale oszacowanie jest obciążone o 1.15 (surowa różnica: 2.00). Kaliper 0.2 SD logitu daje 300 par i obciążenie 0.21, a kaliper 0.05 – 271 par i 0.03. Błąd Monte Carlo obciążenia nie przekracza 0.007.
Na co uważać. Mniejsze obciążenie przy wąskim kaliprze ma swoją cenę: odrzuceni leczeni to głównie osoby z najwyższym PS, więc wynik opisuje inną populację niż wszyscy leczeni. Tu prawdziwy efekt jest u wszystkich taki sam, dlatego panel C mierzy tylko obciążenie przez zakłócanie; przy efekcie zależnym od cech do obciążenia dochodzi zmiana estymandy. Wykres nie pokazuje też wariancji: mniej par to szerszy przedział ufności. Kaliper 0.2 usuwa tu mniej obciążenia niż w symulacjach Austina (2011): selekcja jest silna, a dopasowanie zachłanne zaczyna od najwyższych PS, więc wynik jednej symulacji nie przenosi się wprost na inne dane. Lustrzane histogramy przed i po dopasowaniu bez kalipra pokazuje hasło propensity score.
Podpis do pracy:
Kod rysunku jest samowystarczalny. Rysunek na stronie powstał z tego samego kodu, w którym podmieniono tylko motyw (krój czcionki, siatka). Symulacja trwa około pół minuty.
Kod R rysunku 1
# Rysunek 1. Wspólne wsparcie (A) oraz liczba par i obciążenie przy różnych kaliprach (B, C)
library(ggplot2)
library(patchwork)

kol <- c("leczeni" = "#0072B2", "nieleczeni" = "#E69F00")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

# Dopasowanie 1:1 najbliższego sąsiada bez zwracania na logicie PS (jak w przykładzie w haśle);
# kaliper w jednostkach SD logitu, Inf = bez kalipra
dopasuj <- function(lps, leczenie, kaliper_sd) {
  kal <- kaliper_sd * sd(lps); wolny <- leczenie == 0; pary <- NULL
  for (i in which(leczenie == 1)[order(-lps[leczenie == 1])]) {
    kand <- which(wolny); odl <- abs(lps[kand] - lps[i])
    if (length(odl) && min(odl) <= kal) {
      j <- kand[which.min(odl)]; pary <- rbind(pary, c(i, j)); wolny[j] <- FALSE
    }
  }
  pary
}
generuj <- function(n = 1000) {                       # model danych z przykładu w haśle + wynik
  wiek <- rnorm(n, 50, 10); ciezkosc <- rnorm(n)
  leczenie <- rbinom(n, 1, plogis(-6 + 0.11 * wiek + 0.8 * ciezkosc))
  y <- 0.1 * wiek + 2 * ciezkosc + 1 * leczenie + rnorm(n, 0, 2)   # prawdziwy efekt = 1
  data.frame(wiek, ciezkosc, leczenie, y)
}

# A: jedna próba z przykładu – rozkłady PS i obszary bez wspólnego wsparcia
set.seed(58001)
d <- generuj()[, c("wiek", "ciezkosc", "leczenie")]    # te same 1000 osób co w przykładzie
d$ps <- fitted(glm(leczenie ~ wiek + ciezkosc, family = binomial, data = d))
zakres <- c(max(tapply(d$ps, d$leczenie, min)), min(tapply(d$ps, d$leczenie, max)))
round(zakres, 3)
c(ponizej = sum(d$ps < zakres[1]), powyzej = sum(d$ps > zakres[2]))
d$grupa <- factor(ifelse(d$leczenie == 1, "leczeni", "nieleczeni"), names(kol))
prz <- seq(0, 1, by = 0.025)
pA <- ggplot() +
  annotate("rect", xmin = c(0, zakres[2]), xmax = c(zakres[1], 1), ymin = -Inf, ymax = Inf,
           fill = "grey85") +
  geom_histogram(data = subset(d, leczenie == 1), aes(ps, after_stat(count), fill = grupa),
                 breaks = prz, colour = "white", linewidth = 0.2) +
  geom_histogram(data = subset(d, leczenie == 0), aes(ps, -after_stat(count), fill = grupa),
                 breaks = prz, colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = c(0.1, 0.9), linetype = "22", colour = "grey30") +
  geom_hline(yintercept = 0, colour = "grey30") +
  annotate("text", x = 0.5, y = 70, label = "leczeni ↑", size = 3.6) +
  annotate("text", x = 0.5, y = -75, label = "nieleczeni ↓", size = 3.6) +
  scale_fill_manual(NULL, values = kol) +
  scale_y_continuous("Liczba osób", limits = c(-80, 80), labels = abs) +
  scale_x_continuous("Propensity score", limits = c(0, 1)) +
  labs(title = "A. Wspólne wsparcie",
       subtitle = "Szare pola: poza wspólnym wsparciem; linie: 0.1 i 0.9") + motyw

# B, C: 1000 symulowanych badań – liczba par i obciążenie efektu przy różnych kaliprach
set.seed(5800)
kalipry <- c(0.05, 0.1, 0.2, 0.5, 1, Inf)
wyniki <- t(replicate(1000, {
  s <- generuj()
  lps <- qlogis(fitted(glm(leczenie ~ wiek + ciezkosc, family = binomial, data = s)))
  c(sapply(kalipry, function(k) {
    p <- dopasuj(lps, s$leczenie, k)
    c(pary = nrow(p), efekt = mean(s$y[p[, 1]] - s$y[p[, 2]]))
  }), surowa = mean(s$y[s$leczenie == 1]) - mean(s$y[s$leczenie == 0]))
}))                                       # kolumny: pary i efekt dla kolejnych kaliprów, różnica surowa
pary  <- wyniki[, seq(1, 11, 2)]; efekt <- wyniki[, seq(2, 12, 2)]
round(c(obciazenie_surowej = mean(wyniki[, 13]) - 1, bladMC = sd(wyniki[, 13]) / sqrt(1000)), 3)
tab <- data.frame(kaliper = factor(c("0.05", "0.1", "0.2", "0.5", "1", "brak"), c("0.05", "0.1", "0.2", "0.5", "1", "brak")),
                  pary = colMeans(pary), obciazenie = colMeans(efekt) - 1,
                  bladMC = apply(efekt, 2, sd) / sqrt(1000))
print(tab, digits = 3, row.names = FALSE)
pB <- ggplot(tab, aes(kaliper, pary)) +
  geom_col(fill = "grey60", width = 0.6) +
  geom_text(aes(label = round(pary)), vjust = -0.4, size = 3.5) +
  scale_y_continuous("Średnia liczba par", limits = c(0, 450)) + xlab(NULL) +
  labs(title = "B. Liczba par") + motyw
pC <- ggplot(tab, aes(kaliper, obciazenie)) +
  geom_hline(yintercept = 0, colour = "grey30") +
  geom_errorbar(aes(ymin = obciazenie - 1.96 * bladMC, ymax = obciazenie + 1.96 * bladMC), width = 0.15) +
  geom_point(size = 2.8) +
  scale_y_continuous("Obciążenie efektu") + xlab("Kaliper (SD logitu PS)") +
  labs(title = "C. Obciążenie (± 1.96 błędu MC)") + motyw
p1 <- (pA | (pB / pC)) + plot_layout(widths = c(1.15, 1))
p1
Wynik w R
[1] 0.045 0.913
ponizej powyzej
     12       4
obciazenie_surowej             bladMC
             2.003              0.006
 kaliper pary obciazenie  bladMC
    0.05  271     0.0338 0.00579
     0.1  281     0.0861 0.00564
     0.2  300     0.2146 0.00542
     0.5  355     0.6496 0.00519
       1  405     1.1132 0.00631
    brak  408     1.1507 0.00645
Jak opisać w pracy
Wspólne wsparcie i kaliper w R
Kod szacuje propensity score, liczy osoby poza wspólnym wsparciem i poza przedziałem 0.1–0.9, a następnie dopasowuje pary 1:1 z kaliprem w bazowym R. Funkcja MatchIt::matchit() z kaliprem 0.2 SD logitu daje te same 317 par i 67 leczonych bez pary.
Dopasowanie najbliższego sąsiada z kaliprem
R
# Wspólne wsparcie i dopasowanie 1:1 z kaliprem na logicie PS (dane symulowane)
set.seed(58001)
n <- 1000
wiek <- rnorm(n, 50, 10)
ciezkosc <- rnorm(n)
leczenie <- rbinom(n, 1, plogis(-6 + 0.11 * wiek + 0.8 * ciezkosc))
ps_model <- glm(leczenie ~ wiek + ciezkosc, family = binomial)
ps <- fitted(ps_model); lps <- qlogis(ps)
# 1. Wspólne wsparcie: zakres PS wspólny dla obu grup
zakres <- c(max(tapply(ps, leczenie, min)), min(tapply(ps, leczenie, max)))
poza <- ps < zakres[1] | ps > zakres[2]
# 2. Kaliper 0.2 SD logitu PS (Austin, 2011), najbliższy sąsiad bez zwracania
kaliper <- 0.2 * sd(lps)
leczeni <- which(leczenie == 1); wolni <- which(leczenie == 0); pary <- NULL
for (i in leczeni[order(-ps[leczeni])]) {
  odl <- abs(lps[wolni] - lps[i])
  if (length(odl) && min(odl) <= kaliper) {
    j <- wolni[which.min(odl)]; pary <- rbind(pary, c(i, j)); wolni <- setdiff(wolni, j)
  }
}
smd <- function(v, idx_t, idx_c) (mean(v[idx_t]) - mean(v[idx_c])) /
  sqrt((var(v[leczenie == 1]) + var(v[leczenie == 0])) / 2)
c(leczeni = length(leczeni), poza_wspolnym_wsparciem = sum(poza),
  poza_0.1_0.9 = sum(ps < 0.1 | ps > 0.9), pary = nrow(pary),
  leczeni_bez_pary = length(leczeni) - nrow(pary))
round(c(kaliper = kaliper, SMD_wiek_przed = smd(wiek, leczeni, which(leczenie == 0)),
        SMD_wiek_po = smd(wiek, pary[, 1], pary[, 2]),
        SMD_ciezkosc_przed = smd(ciezkosc, leczeni, which(leczenie == 0)),
        SMD_ciezkosc_po = smd(ciezkosc, pary[, 1], pary[, 2])), 3)
# To samo w pakiecie MatchIt (SMD liczone z SD grupy leczonej, estymanda ATT)
library(MatchIt)
dop <- matchit(leczenie ~ wiek + ciezkosc, distance = "glm", link = "linear.logit",
               caliper = 0.2, std.caliper = TRUE)
s <- summary(dop)
s$nn[c("Matched", "Unmatched"), "Treated"]
round(cbind(SMD_przed = s$sum.all[2:3, "Std. Mean Diff."],
            SMD_po = s$sum.matched[2:3, "Std. Mean Diff."]), 3)
Wynik w R
                leczeni poza_wspolnym_wsparciem            poza_0.1_0.9
                    384                      16                      92
                   pary        leczeni_bez_pary
                    317                      67
           kaliper     SMD_wiek_przed        SMD_wiek_po SMD_ciezkosc_przed
             0.230              0.735              0.107              0.608
   SMD_ciezkosc_po
             0.022
  Matched Unmatched
      317        67
         SMD_przed SMD_po
wiek         0.708  0.103
ciezkosc     0.606  0.022
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem MatchIt 4.8.2; rysunek 1 powstał w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MatchIt (wersja 4.8.2): Ho, D., Imai, K., King, G., Stuart, E., & Greifer, N. (2026). MatchIt: Nonparametric preprocessing for parametric causal inference (R package version 4.8.2) [Computer software]. https://doi.org/10.32614/CRAN.package.MatchIt
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Jak szeroki powinien być kaliper w dopasowaniu par?
Często stosuje się 0.2 odchylenia standardowego logitu PS, które w symulacjach Austina (2011) usuwało co najmniej 98% obciążenia. Przy innej szerokości podaj uzasadnienie i sprawdź równowagę grup po dopasowaniu.
Co zrobić z osobami spoza wspólnego wsparcia?
Zwykle się je pomija, ale trzeba podać ich liczbę i opisać, czym się różnią. Alternatywą jest reguła 0.1–0.9 (Crump i in., 2009) albo zmiana pytania, np. z efektu w całej populacji na efekt wśród leczonych.
Czy kaliper zmienia oszacowywany efekt?
Tak, jeśli część leczonych nie dostaje pary. Wynik dotyczy wtedy leczonych z dopasowaną kontrolą, a nie wszystkich leczonych. Gdy odrzuconych jest dużo, porównaj wynik z analizą ważoną lub bez kalipra.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Austin, P. C. (2011). Optimal caliper widths for propensity-score matching when estimating differences in means and differences in proportions in observational studies. Pharmaceutical Statistics, 10(2), 150–161. https://doi.org/10.1002/pst.433 ● Otwarty dostęp
- Crump, R. K., Hotz, V. J., Imbens, G. W., & Mitnik, O. A. (2009). Dealing with limited overlap in estimation of average treatment effects. Biometrika, 96(1), 187–199. https://doi.org/10.1093/biomet/asn055 ● Otwarty dostęp: pełny tekst
- Stuart, E. A. (2010). Matching methods for causal inference: A review and a look forward. Statistical Science, 25(1), 1–21. https://doi.org/10.1214/09-sts313 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{austin2011optimal, author={Austin, Peter C.}, title={{Optimal caliper widths for propensity-score matching when estimating differences in means and differences in proportions in observational studies}}, journal={Pharmaceutical Statistics}, year={2011}, volume={10}, number={2}, pages={150--161}, doi={10.1002/pst.433}}@article{crump2009dealing, author={Crump, Richard K. and Hotz, V. Joseph and Imbens, Guido W. and Mitnik, Oscar A.}, title={{Dealing with limited overlap in estimation of average treatment effects}}, journal={Biometrika}, year={2009}, volume={96}, number={1}, pages={187--199}, doi={10.1093/biomet/asn055}}@article{stuart2010matching, author={Stuart, Elizabeth A.}, title={{Matching methods for causal inference: A review and a look forward}}, journal={Statistical Science}, year={2010}, volume={25}, number={1}, pages={1--21}, doi={10.1214/09-sts313}}