Co to są wagi nakładania i równoważenie entropii?
Wagi nakładania (overlap weights) i równoważenie entropii (entropy balancing) to alternatywy dla wag IPW. Obie wyrównują zmierzone cechy grup, ale inaczej traktują osoby ze skrajnym propensity score (e), które w IPW dostają ogromne wagi.
Wagi nakładania i ATO
Li, Morgan i Zaslavsky (2018) opisali klasę wag równoważących, w której IPW jest przypadkiem szczególnym. W wagach nakładania osoba leczona dostaje wagę 1 − e, a kontrolna – e, czyli proporcjonalną do prawdopodobieństwa trafienia do przeciwnej grupy. Wagi nie przekraczają 1 i w tej klasie minimalizują asymptotyczną wariancję. Przy PS z regresji logistycznej średnie zmiennych z modelu są po ważeniu dokładnie równe. Ceną jest inna estymanda: ATO, efekt w populacji nakładania, gdzie najwięcej ważą osoby z e bliskim 0.5. To nie jest ani ATE, ani ATT.
Równoważenie entropii
Hainmueller (2012) zaproponował wagi możliwie bliskie jednakowym (maksymalna entropia), przy których średnie, wariancje i ewentualnie wyższe momenty zmiennych są równe momentom grupy docelowej. Równowaga jest dokładna z konstrukcji, bez poprawiania modelu PS. Zhao i Percival (2017) wykazali, że metoda jest podwójnie odporna względem liniowego modelu wyniku i logistycznego modelu PS. Wagi nie są jednak ograniczone.
Przykład
W symulowanej próbie 1000 osób udział w programie silnie zależał od wieku i stresu (SMD 0.75 i 0.95), a efekt programu malał ze stresem. Największa waga względna: 42.3 (IPW), 31.0 (ebal), 3.6 (wagi nakładania); efektywna liczebność grupy programu: 73, 91 i 227. Po ATO i ebal różnice średnich wynosiły 0. ATE z IPW: 3.97, 95% CI [2.96, 4.97]; z ebal: 4.04 [3.43, 4.64]; ATO: 3.46 [2.90, 4.03]. Prawdziwe wartości: ATE = 4.03, ATO = 3.46 – ATO to efekt w innej populacji, nie „lepsze ATE”.
Na rysunku
Rysunek pokazuje dane z przykładu (1000 osób, 301 w programie, set.seed(7120)).
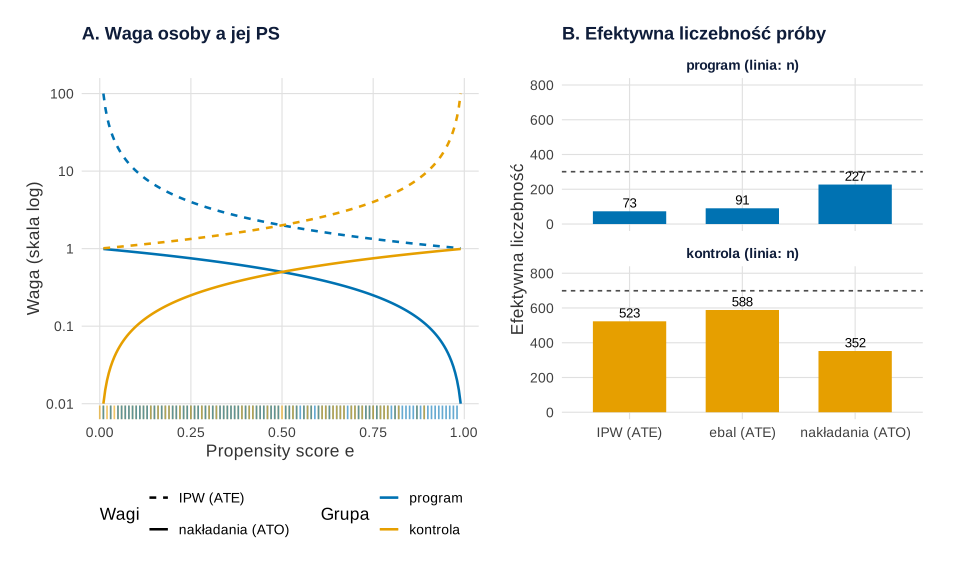
set.seed(7120)).Co widać. Panel A to same wzory. Waga IPW osoby z programu rośnie jak 1/e: przy PS = 0.01 wynosi 100. Waga nakładania tej samej osoby to 1 − e, więc nigdy nie przekracza 1. Krzywe nakładania przecinają się przy PS = 0.5, gdzie obie grupy ważą tyle samo, i spadają do zera na krańcach. Kreski pod osią pokazują, że w próbie są osoby z całego zakresu PS: 194 ma PS poniżej 0.05, a 9 powyżej 0.95. Dlatego największa waga IPW sięga 82.9, a waga nakładania – 0.99. Panel B przekłada to na efektywną liczebność: w grupie programu IPW zostawia 73 „efektywne” osoby z 301 (24.4%), równoważenie entropii 91 (30.1%), a wagi nakładania 227 (75.5%).
Na co uważać. Wagi nakładania nie są „lepszą wersją IPW”. W grupie kontrolnej ich efektywna liczebność spada do 352 z 699 (50.4%), bo kontrole z PS bliskim 0 dostają wagę prawie zerową. Taka osoba praktycznie znika z analizy, a wynik dotyczy innej populacji – ATO zamiast ATE. Wykres nie pokazuje też, czy w obszarze nakładania efekt jest taki sam jak w całej próbie; w przykładzie nie jest (ATO = 3.46, ATE = 4.03). Kiedy problem tkwi w braku odpowiedników, a nie w samych wagach, zajrzyj do hasła wspólne wsparcie i kaliper, a rozkład wag IPW i wykres równowagi pokazuje hasło wagi IPW.
Podpis do pracy:
Kod rysunku jest samowystarczalny. Rysunek na stronie powstał z tego samego kodu, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. Wagi IPW i wagi nakładania w funkcji propensity score (A) oraz efektywna liczebność próby (B)
suppressPackageStartupMessages({library(WeightIt); library(ggplot2); library(patchwork)})

kol <- c("program" = "#0072B2", "kontrola" = "#E69F00")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

set.seed(7120)                                        # ziarno i dane z przykładu w haśle
n <- 1000
d <- data.frame(wiek = rnorm(n, 40, 10), stres = rnorm(n), kobieta = rbinom(n, 1, .5))
e_true <- plogis(-1.5 + 0.12 * (d$wiek - 40) + 1.2 * d$stres + 0.4 * d$kobieta)
d$program <- rbinom(n, 1, e_true)
f <- program ~ wiek + stres + kobieta
w_ate <- weightit(f, data = d, method = "glm", estimand = "ATE")
w_ato <- weightit(f, data = d, method = "glm", estimand = "ATO")
w_eb  <- weightit(f, data = d, method = "ebal", estimand = "ATE")

# A: wagi jako funkcja PS (krzywe) i oszacowane PS osób z próby (kreski pod osią, PS zaokrąglone do 0.01)
e <- seq(0.01, 0.99, by = 0.005)
krzywe <- data.frame(e = rep(e, 4),
  waga = c(1 / e, 1 / (1 - e), 1 - e, e),
  grupa = factor(rep(c("program", "kontrola", "program", "kontrola"), each = length(e)), names(kol)),
  metoda = rep(c("IPW (ATE)", "IPW (ATE)", "nakładania (ATO)", "nakładania (ATO)"), each = length(e)))
ps <- data.frame(e = w_ato$ps, grupa = factor(ifelse(d$program == 1, "program", "kontrola"), names(kol)))
round(c(PS_ponizej_0.05 = sum(ps$e < 0.05), PS_powyzej_0.95 = sum(ps$e > 0.95),
        max_waga_IPW = max(w_ate$weights), max_waga_ATO = max(w_ato$weights)), 2)
pA <- ggplot(krzywe, aes(e, waga, colour = grupa, linetype = metoda)) +
  geom_line(linewidth = 0.9) +
  geom_rug(data = unique(transform(ps, e = round(e, 2))), aes(e, colour = grupa), inherit.aes = FALSE, sides = "b", alpha = 0.6,
           length = unit(0.04, "npc")) +
  scale_colour_manual("Grupa", values = kol) +
  scale_linetype_manual("Wagi", values = c("IPW (ATE)" = "22", "nakładania (ATO)" = "solid")) +
  scale_y_log10("Waga (skala log)", breaks = c(0.01, 0.1, 1, 10, 100), labels = c("0.01", "0.1", "1", "10", "100")) +
  scale_x_continuous("Propensity score e", breaks = seq(0, 1, 0.25)) +
  labs(title = "A. Waga osoby a jej PS") + motyw +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2))

# B: efektywna liczebność próby (ESS) w każdej grupie przy trzech metodach
ess <- function(w) sum(w)^2 / sum(w^2)
tab <- expand.grid(metoda = c("IPW (ATE)", "ebal (ATE)", "nakładania (ATO)"), grupa = names(kol))
tab$ESS <- mapply(function(m, g) {
  w <- list("IPW (ATE)" = w_ate, "ebal (ATE)" = w_eb, "nakładania (ATO)" = w_ato)[[m]]$weights
  ess(w[d$program == (g == "program")])
}, as.character(tab$metoda), as.character(tab$grupa))
tab$n <- ifelse(tab$grupa == "program", sum(d$program), sum(1 - d$program))
tab$grupa <- factor(tab$grupa, names(kol))
print(transform(tab, ESS = round(ESS, 1), procent = round(100 * ESS / n, 1)), row.names = FALSE)
pB <- ggplot(tab, aes(metoda, ESS, fill = grupa)) +
  geom_col(width = 0.65) +
  geom_hline(aes(yintercept = n), linetype = "22", colour = "grey30") +
  geom_text(aes(label = round(ESS)), vjust = -0.4, size = 3.5) +
  facet_wrap(~ grupa, ncol = 1, labeller = labeller(grupa = function(g) paste0(g, " (linia: n)"))) +
  scale_fill_manual(NULL, values = kol, guide = "none") +
  scale_y_continuous("Efektywna liczebność", limits = c(0, 800)) + xlab(NULL) +
  labs(title = "B. Efektywna liczebność próby") + motyw
p1 <- (pA | pB) + plot_layout(widths = c(1.1, 1))
p1
Wynik w R
PS_ponizej_0.05 PS_powyzej_0.95    max_waga_IPW    max_waga_ATO
         194.00            9.00           82.90            0.99
           metoda    grupa   ESS   n procent
        IPW (ATE)  program  73.3 301    24.4
       ebal (ATE)  program  90.5 301    30.1
 nakładania (ATO)  program 227.2 301    75.5
        IPW (ATE) kontrola 523.3 699    74.9
       ebal (ATE) kontrola 588.4 699    84.2
 nakładania (ATO) kontrola 352.3 699    50.4
Jak opisać w pracy
Na co uważać
- Zmiana estymandy. Nazwij populację docelową i nie podawaj ATO jako ATE.
- Słabe nakładanie. Ebal daje wtedy skrajne wagi; sprawdź wspólne wsparcie.
- Niezmierzone zakłócenia. Równowaga dotyczy tylko wskazanych zmiennych.
- Błędy standardowe. Uwzględnij estymację wag (
lm_weightit()) albo użyj bootstrapu.
Dopasowanie i klasyczne ważenie krok po kroku pokazuje wpis Propensity score: dopasowanie i ważenie.
Wagi nakładania i ebal w R
Kod symuluje dane obserwacyjne z silną selekcją, wyznacza wagi IPW (ATE), wagi nakładania (ATO) i wagi równoważenia entropii (ATE), porównuje skrajne wagi, efektywną liczebność i równowagę w cobalt::bal.tab(), a potem szacuje efekty z błędami standardowymi uwzględniającymi estymację wag. Liczby w tekście pochodzą z tego kodu.
IPW, ATO i entropy balancing w WeightIt
R
set.seed(7120)
suppressPackageStartupMessages({library(WeightIt); library(cobalt)})
n <- 1000                                                # dane symulowane: program wsparcia a wynik testu
d <- data.frame(wiek = rnorm(n, 40, 10), stres = rnorm(n), kobieta = rbinom(n, 1, .5))
e_true <- plogis(-1.5 + 0.12 * (d$wiek - 40) + 1.2 * d$stres + 0.4 * d$kobieta)
d$program <- rbinom(n, 1, e_true)                        # silna selekcja: słabe nakładanie na krańcach PS
d$wynik <- 50 + 0.3 * (d$wiek - 40) - 3 * d$stres + 2 * d$kobieta +
  (4 - 2 * d$stres) * d$program + rnorm(n, 0, 3)         # efekt zależy od stresu
f <- program ~ wiek + stres + kobieta
w_ate <- weightit(f, data = d, method = "glm", estimand = "ATE")
w_ato <- weightit(f, data = d, method = "glm", estimand = "ATO")
w_eb  <- weightit(f, data = d, method = "ebal", estimand = "ATE")
diag_w <- function(w) c(max_w = max(w$weights / mean(w$weights)),
  ESS_kontrola = ESS(w$weights[d$program == 0]), ESS_program = ESS(w$weights[d$program == 1]))
round(rbind(ATE_IPW = diag_w(w_ate), ATO = diag_w(w_ato), ATE_ebal = diag_w(w_eb)), 1)
b <- bal.tab(f, data = d, weights = list(IPW = w_ate$weights, ATO = w_ato$weights, ebal = w_eb$weights),
             estimand = "ATE", s.d.denom = "pooled", un = TRUE)   # SMD przed i po ważeniu
round(b$Balance[, grep("^Diff", names(b$Balance))], 3)
efekt <- function(w) { m <- lm_weightit(wynik ~ program, data = d, weightit = w)
  ci <- confint(m)["program", ]; c(efekt = unname(coef(m)["program"]), dolna = ci[[1]], gorna = ci[[2]]) }
round(rbind(ATE_IPW = efekt(w_ate), ATO = efekt(w_ato), ATE_ebal = efekt(w_eb)), 2)
o <- e_true * (1 - e_true)                               # prawdziwe estymandy (znane tylko w symulacji)
round(c(ATE_prawdziwy = mean(4 - 2 * d$stres), ATO_prawdziwy = sum(o * (4 - 2 * d$stres)) / sum(o)), 2)
Wynik w R
         max_w ESS_kontrola ESS_program
ATE_IPW   42.3        523.3        73.3
ATO        3.6        352.3       227.2
ATE_ebal  31.0        588.4        90.5
        Diff.Un Diff.IPW Diff.ATO Diff.ebal
wiek      0.752    0.097        0         0
stres     0.946    0.067        0         0
kobieta   0.154    0.001        0         0
         efekt dolna gorna
ATE_IPW   3.97  2.96  4.97
ATO       3.46  2.90  4.03
ATE_ebal  4.04  3.43  4.64
ATE_prawdziwy ATO_prawdziwy
         4.03          3.46
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety WeightIt i cobalt; rysunek 1: WeightIt, ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- WeightIt (wersja 2.1.0): Greifer, N. (2026). WeightIt: Weighting for covariate balance in observational studies (R package version 2.1.0) [Computer software]. https://doi.org/10.32614/CRAN.package.WeightIt
- cobalt (wersja 5.0.0): Greifer, N. (2026). cobalt: Covariate balance tables and plots (R package version 5.0.0) [Computer software]. https://doi.org/10.32614/CRAN.package.cobalt
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym różni się ATO od ATE?
ATE to efekt w całej populacji, a ATO – efekt w populacji nakładania, w której największą wagę mają osoby z propensity score bliskim 0.5, czyli podobnie prawdopodobne w obu grupach. Przy jednakowym efekcie obie liczby są równe; gdy efekt jest różny u różnych osób, mogą się wyraźnie różnić.
Kiedy wybrać wagi nakładania zamiast IPW?
Gdy propensity score bywa bliski 0 lub 1, a wagi IPW są skrajne i efektywna liczebność mała. Wagi nakładania nie przekraczają 1, więc wynik jest stabilniejszy. Wybierz je jednak tylko wtedy, gdy efekt w populacji nakładania odpowiada na Twoje pytanie badawcze.
Czy równoważenie entropii wymaga modelu propensity score?
Nie. Podajesz zmienne i momenty (np. średnie i wariancje), które mają być równe, a algorytm sam wyznacza wagi. Nie trzeba więc poprawiać modelu PS, ale równowaga dotyczy tylko wskazanych momentów, a niezmierzone zmienne zakłócające nadal mogą zniekształcać wynik.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hainmueller, J. (2012). Entropy balancing for causal effects: A multivariate reweighting method to produce balanced samples in observational studies. Political Analysis, 20(1), 25–46. https://doi.org/10.1093/pan/mpr025 ● Otwarty dostęp: pełny tekst
- Li, F., Morgan, K. L., & Zaslavsky, A. M. (2018). Balancing covariates via propensity score weighting. Journal of the American Statistical Association, 113(521), 390–400. https://doi.org/10.1080/01621459.2016.1260466 ● Otwarty dostęp: pełny tekst
- Zhao, Q., & Percival, D. (2017). Entropy balancing is doubly robust. Journal of Causal Inference, 5(1), Article 20160010. https://doi.org/10.1515/jci-2016-0010 ● Otwarty dostęp
Cytowania BibTeX
@article{hainmueller2012entropy, author={Hainmueller, Jens}, title={{Entropy balancing for causal effects: A multivariate reweighting method to produce balanced samples in observational studies}}, journal={Political Analysis}, year={2012}, volume={20}, number={1}, pages={25--46}, doi={10.1093/pan/mpr025}}@article{li2018balancing, author={Li, Fan and Morgan, Kari Lock and Zaslavsky, Alan M.}, title={{Balancing covariates via propensity score weighting}}, journal={Journal of the American Statistical Association}, year={2018}, volume={113}, number={521}, pages={390--400}, doi={10.1080/01621459.2016.1260466}}@article{zhao2017entropy, author={Zhao, Qingyuan and Percival, Daniel}, title={{Entropy balancing is doubly robust}}, journal={Journal of Causal Inference}, year={2017}, volume={5}, number={1}, eid={20160010}, doi={10.1515/jci-2016-0010}}