Co to jest analiza wrażliwości Rosenbauma?
Analiza wrażliwości Rosenbauma (ang. Rosenbaum bounds) sprawdza, jak silne musiałoby być niezmierzone zakłócenie, żeby zmienić wniosek z dopasowanego badania obserwacyjnego. Po dopasowaniu na obserwowane cechy, np. na propensity score, dwie osoby w parze mogą nadal różnić się cechą, której nie zmierzono (zmienną zakłócającą).
Parametr Γ (gamma, Γ ≥ 1) mówi, ile razy mogą się różnić szanse otrzymania interwencji u dwóch osób o tych samych obserwowanych cechach. Γ = 1 oznacza brak ukrytego obciążenia, jak przy losowaniu. Γ = 2 oznacza, że jedna osoba z pary mogła mieć nawet dwukrotnie większe szanse. Rosenbaum (1987) zaproponował prosty sposób pokazania, jak wyniki testów permutacyjnych – testu rang znakowanych Wilcoxona i testu McNemara–Coxa – zmieniają się przy różnych założeniach o niezmierzonych zmiennych. Dla każdego Γ liczy się zakres możliwych wartości p; raportuje się górną granicę. Rosenbaum (2007) rozszerzył metodę na M-estymatory Hubera, przedziały ufności i zbiory z kilkoma kontrolami.
Przykład
W symulowanych 80 dopasowanych parach (prawdziwy efekt 6 pkt) test Wilcoxona daje p = .0006 przy Γ = 1. Górna granica p rośnie do .0084 przy Γ = 1.25 i .043 przy Γ = 1.5, a przy Γ = 1.75 wynosi już .123. Wynik przestaje być istotny przy Γ ≈ 1.53. Wystarczyłaby więc nieobserwowana cecha, która w parze zwiększa szanse interwencji o około 53% i silnie wiąże się z wynikiem. M-test Hubera daje podobny obraz (.031 przy Γ = 1.5, .175 przy Γ = 2).
Na rysunku
Tabelę Γ z przykładu łatwiej czytać jako krzywą. Rysunek pokazuje górną granicę p dla tych samych 80 par przy Γ od 1 do 2.5, dla testu rang znakowanych Wilcoxona i M-testu Hubera.
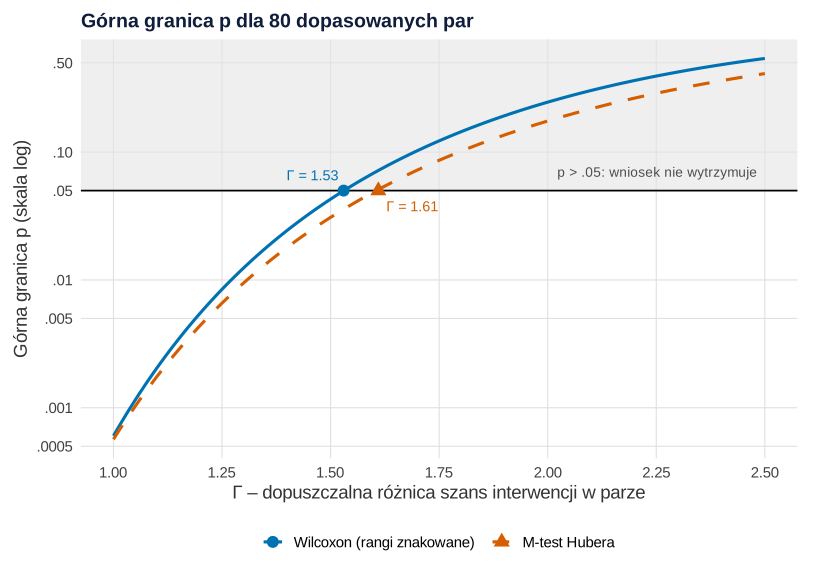
set.seed(694)).Co widać. Przy Γ = 1 (brak ukrytego obciążenia) oba testy dają p = .0006. Każde dopuszczenie większej różnicy szans w parze podnosi najgorszą możliwą wartość p. Krzywa Wilcoxona przecina .05 przy Γ = 1.53, krzywa Hubera przy Γ = 1.61 – M-test jest tu nieco mniej wrażliwy. Przy Γ = 2 górne granice wynoszą już .246 i .175. Liczba, którą raportuje się w pracy, to punkt przecięcia: im dalej w prawo, tym silniejszego ukrytego zakłócenia trzeba, by podważyć wynik.
Na co uważać. Krzywa to najgorszy scenariusz dla każdego Γ, a nie oszacowanie prawdziwego p. Nie mówi, jak duże Γ jest realistyczne w Twojej dziedzinie – to trzeba uzasadnić wiedzą merytoryczną, np. porównując z siłą zmierzonych zakłócaczy. Γ = 1.53 nie oznacza „słabego badania”; to tylko próg, który czytelnik ocenia sam. Wykres zależy też od wyboru testu, więc podaj, którego użyto. Pokrewną miarę w skali ryzyka względnego daje E-wartość.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tych samych danych co przykład (set.seed(694); ziarna nie zmieniano). Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Kod R rysunku 1
# Rysunek 1. Górna granica p w funkcji Γ: test Wilcoxona i M-test Hubera
library(ggplot2)
library(sensitivitymw)

# Paleta Okabe–Ito; testy odróżnia też typ linii i kształt punktu
kol <- c("Wilcoxon (rangi znakowane)" = "#0072B2", "M-test Hubera" = "#D55E00")
lin <- c("Wilcoxon (rangi znakowane)" = "solid", "M-test Hubera" = "dashed")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))

# Te same dane co w przykładzie hasła: 80 par, prawdziwy efekt 6 pkt
set.seed(694)
n <- 80
kontrola <- rnorm(n, mean = 50, sd = 10)
leczeni  <- kontrola + rnorm(n, mean = 6, sd = 10)
roznica  <- leczeni - kontrola
d <- roznica[roznica != 0]; m <- length(d)
T <- sum(rank(abs(d))[d > 0])
p_wilcoxon <- function(G) {                       # górna granica p (przybliżenie normalne)
  pp <- G / (1 + G)
  E <- pp * m * (m + 1) / 2
  V <- pp * (1 - pp) * m * (m + 1) * (2 * m + 1) / 6
  1 - pnorm((T - E) / sqrt(V))
}
y <- cbind(leczeni, kontrola)
p_huber <- function(G) senmw(y, gamma = G, method = "h")$pval

siatka <- seq(1, 2.5, by = 0.01)
krzywe <- data.frame(Gamma = rep(siatka, 2),
                     p = c(sapply(siatka, p_wilcoxon), sapply(siatka, p_huber)),
                     test = factor(rep(names(kol), each = length(siatka)), levels = names(kol)))
# Γ, przy którym górna granica p osiąga .05
prog <- data.frame(test = factor(names(kol), levels = names(kol)),
                   Gamma = c(uniroot(function(g) p_wilcoxon(g) - 0.05, c(1, 3))$root,
                             uniroot(function(g) p_huber(g) - 0.05, c(1, 3))$root), p = 0.05)
prog$Gamma <- round(prog$Gamma, 2)
prog
G4 <- c(1, 1.5, 2, 2.5)
data.frame(Gamma = G4, Wilcoxon = round(sapply(G4, p_wilcoxon), 4), Huber = round(sapply(G4, p_huber), 4))

p1 <- ggplot(krzywe, aes(Gamma, p, colour = test, linetype = test)) +
  annotate("rect", xmin = -Inf, xmax = Inf, ymin = 0.05, ymax = Inf, fill = "grey90", alpha = 0.6) +
  geom_hline(yintercept = 0.05, linewidth = 0.6) +
  geom_line(linewidth = 1.1) +
  geom_point(data = prog, aes(shape = test), size = 3.4, stroke = 1.2) +
  geom_text(data = prog, aes(label = sprintf("Γ = %.2f", Gamma)), vjust = c(-1, 2),
            hjust = c(1.1, -0.15), size = 3.8, show.legend = FALSE) +
  annotate("text", x = 2.48, y = 0.07, label = "p > .05: wniosek nie wytrzymuje", hjust = 1,
           size = 3.6, colour = "grey30") +
  scale_y_log10(breaks = c(0.0005, 0.001, 0.005, 0.01, 0.05, 0.1, 0.5),
                labels = c(".0005", ".001", ".005", ".01", ".05", ".10", ".50")) +
  scale_x_continuous(breaks = seq(1, 2.5, 0.25)) +
  scale_colour_manual(values = kol, name = NULL) + scale_linetype_manual(values = lin, name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  labs(title = "Górna granica p dla 80 dopasowanych par",
       x = "Γ – dopuszczalna różnica szans interwencji w parze", y = "Górna granica p (skala log)") + motyw
p1   # zapis: ggsave("analiza-wrazliwosci-rosenbauma-gamma.svg", p1, width = 8.5, height = 6)
Wynik w R
                        test Gamma    p
1 Wilcoxon (rangi znakowane)  1.53 0.05
2              M-test Hubera  1.61 0.05
  Gamma Wilcoxon  Huber
1   1.0   0.0006 0.0006
2   1.5   0.0429 0.0309
3   2.0   0.2461 0.1752
4   2.5   0.5408 0.4117
Jak opisać w pracy
Na co uważać
- Γ nie mówi, czy zakłócenie istnieje. Pokazuje tylko, jak silne musiałoby być, by zmienić wniosek.
- Granica zakłada najgorszy przypadek – ukryta cecha niemal doskonale wiąże się z wynikiem. Słabszy związek wymagałby większego Γ.
- Γ to nie E-wartość. Obie metody opisują wrażliwość w innych skalach; zob. też wpis o E-wartości i niezmierzonym zakłóceniu.
- Najpierw jakość dopasowania. Sprawdź wspólne wsparcie i balans; analiza Γ nie naprawi złych par.
Analiza Rosenbauma w R
Kod liczy górną granicę p dla testu Wilcoxona ręcznie (przybliżenie normalne), szuka Γ, przy którym p = .05, i sprawdza wynik funkcjami rbounds::psens() oraz sensitivitymw::senmw(). Liczby w tekście pochodzą z tego kodu.
Górna granica p dla kolejnych wartości Γ
R
set.seed(694)                                       # dane symulowane: 80 dopasowanych par
n <- 80
kontrola <- rnorm(n, mean = 50, sd = 10)
leczeni  <- kontrola + rnorm(n, mean = 6, sd = 10)  # prawdziwy efekt = 6 pkt
roznica  <- leczeni - kontrola
wilcox.test(leczeni, kontrola, paired = TRUE, alternative = "greater")$p.value  # Gamma = 1
# Górna granica p dla statystyki rang znakowanych Wilcoxona (przybliżenie normalne)
d <- roznica[roznica != 0]; m <- length(d)
T <- sum(rank(abs(d))[d > 0])
p_gorne <- function(G) {
  pp <- G / (1 + G)
  E <- pp * m * (m + 1) / 2
  V <- pp * (1 - pp) * m * (m + 1) * (2 * m + 1) / 6
  1 - pnorm((T - E) / sqrt(V))
}
G <- c(1, 1.25, 1.5, 1.75, 2)
round(data.frame(Gamma = G, p_gorne = sapply(G, p_gorne)), 4)
round(uniroot(function(g) p_gorne(g) - 0.05, c(1, 5))$root, 2)   # Gamma, przy którym p = .05
suppressPackageStartupMessages(library(rbounds))
psens(leczeni, kontrola, Gamma = 2, GammaInc = 0.25)             # to samo w rbounds
suppressPackageStartupMessages(library(sensitivitymw))
y <- cbind(leczeni, kontrola)
sapply(c(1, 1.5, 2), function(g) round(senmw(y, gamma = g, method = "h")$pval, 4))  # m-test Hubera
Wynik w R
[1] 0.0006080098
  Gamma p_gorne
1  1.00  0.0006
2  1.25  0.0084
3  1.50  0.0429
4  1.75  0.1225
5  2.00  0.2461
[1] 1.53

 Rosenbaum Sensitivity Test for Wilcoxon Signed Rank P-Value

Unconfounded estimate ....  6e-04

 Gamma Lower bound Upper bound
  1.00       6e-04      0.0006
  1.25       0e+00      0.0084
  1.50       0e+00      0.0429
  1.75       0e+00      0.1225
  2.00       0e+00      0.2461

 Note: Gamma is Odds of Differential Assignment To
 Treatment Due to Unobserved Factors

[1] 0.0006 0.0309 0.1752
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami rbounds 2.2 i sensitivitymw 2.1. Rysunek 1 wykonano w pakiecie ggplot2 i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- rbounds (wersja 2.2): Keele, L. J. (2022). rbounds: Perform Rosenbaum bounds sensitivity tests for matched and unmatched data (R package version 2.2) [Computer software]. https://doi.org/10.32614/CRAN.package.rbounds
- sensitivitymw (wersja 2.1): Rosenbaum, P. R. (2022). sensitivitymw: Sensitivity analysis for observational studies using weighted M-statistics (R package version 2.1) [Computer software]. https://doi.org/10.32614/CRAN.package.sensitivitymw
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jakie Γ oznacza odporny wynik?
Nie ma uniwersalnego progu. Porównaj Γ z wiedzą o dziedzinie: czy znane czynniki mogłyby tak silnie różnicować przydział w parze? Wynik, który traci istotność już przy Γ bliskim 1, jest kruchy.
Czym Γ różni się od E-wartości?
Γ ogranicza różnicę szans przydziału w dopasowanej parze i dotyczy testu. E-wartość mówi, jak silny związek zakłócenia z ekspozycją i wynikiem (w skali ryzyka względnego) wyjaśniłby oszacowanie. Liczb nie porównuje się wprost.
Czy metodę można stosować po ważeniu IPW?
W klasycznej postaci dotyczy dopasowanych par lub zbiorów, bo opiera się na testach permutacyjnych w parach. Po ważeniu częściej raportuje się E-wartość albo inne metody analizy wrażliwości.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Propensity score: dopasowanie i ważenie
Badanie obserwacyjne krok po kroku w R: ATE czy ATT, dopasowanie 1:1 z kaliprem, wagi IPTW, równowaga SMD, bootstrap, E-value i opis do artykułu.
Czytaj →PoradnikE-wartość i niezmierzone zakłócenie
Wzór dla RR i granicy CI, przeliczenia z OR i HR, współczynnik ograniczający, porównanie ze zmierzonymi zmiennymi i krytyka E-wartości.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Rosenbaum, P. R. (1987). Sensitivity analysis for certain permutation inferences in matched observational studies. Biometrika, 74(1), 13–26. https://doi.org/10.1093/biomet/74.1.13
- Rosenbaum, P. R. (2002). Observational studies (2nd ed.). Springer. https://doi.org/10.1007/978-1-4757-3692-2
- Rosenbaum, P. R. (2007). Sensitivity analysis for m-estimates, tests, and confidence intervals in matched observational studies. Biometrics, 63(2), 456–464. https://doi.org/10.1111/j.1541-0420.2006.00717.x
Cytowania BibTeX
@article{rosenbaum1987sensitivity, author={Rosenbaum, Paul R.}, title={{Sensitivity analysis for certain permutation inferences in matched observational studies}}, journal={Biometrika}, year={1987}, volume={74}, number={1}, pages={13--26}, doi={10.1093/biomet/74.1.13}}@book{rosenbaum2002observational, author={Rosenbaum, Paul R.}, title={{Observational studies}}, year={2002}, edition={2}, publisher={Springer}, doi={10.1007/978-1-4757-3692-2}}@article{rosenbaum2007sensitivity, author={Rosenbaum, Paul R.}, title={{Sensitivity analysis for m-estimates, tests, and confidence intervals in matched observational studies}}, journal={Biometrics}, year={2007}, volume={63}, number={2}, pages={456--464}, doi={10.1111/j.1541-0420.2006.00717.x}}