Ankieta jest za długa. Co wyciąć?
Planujesz badanie z czterema skalami po 8 pozycji. Pilotaż pokazał, że ankieta zajmuje za dużo czasu, a długość ma swoją cenę. Galesic i Bosnjak (2009) pokazali, że im dłuższy zapowiadany czas ankiety internetowej, tym mniej osób ją zaczyna i kończy, a odpowiedzi na późniejsze pytania są szybsze, krótsze i bardziej jednolite. To typowe skutki obciążenia respondenta i zmęczenia.
Zwykle masz trzy wyjścia: usunąć całą skalę, skrócić kwestionariusz albo zgodzić się na gorsze dane. Jest też czwarte. Każda osoba odpowiada tylko na część pozycji, ale to, której części nie dostanie, losujesz. Braki powstają wtedy z planu, a nie z decyzji respondenta. Takie plany nazywa się schematami planowanych braków danych (planned missing data designs). Najbardziej znany z nich to schemat trzech formularzy (three-form design).
Jak działa schemat trzech formularzy
Pozycje dzielisz na cztery bloki: X oraz A, B i C. Blok X dostają wszyscy. Z bloków A, B i C każda osoba dostaje dwa, więc powstają trzy formularze: X+A+B, X+A+C i X+B+C. Formularz przydzielasz losowo, najlepiej po równo. Graham i in. (2006) opisują ten schemat jako odmianę próbkowania macierzowego. Przy czterech blokach równej wielkości zbierasz dane o 33% większej liczbie pytań, niż wypełnia jedna osoba. W naszym przykładzie to 32 pozycje w ankiecie, z których każda osoba widzi 24.
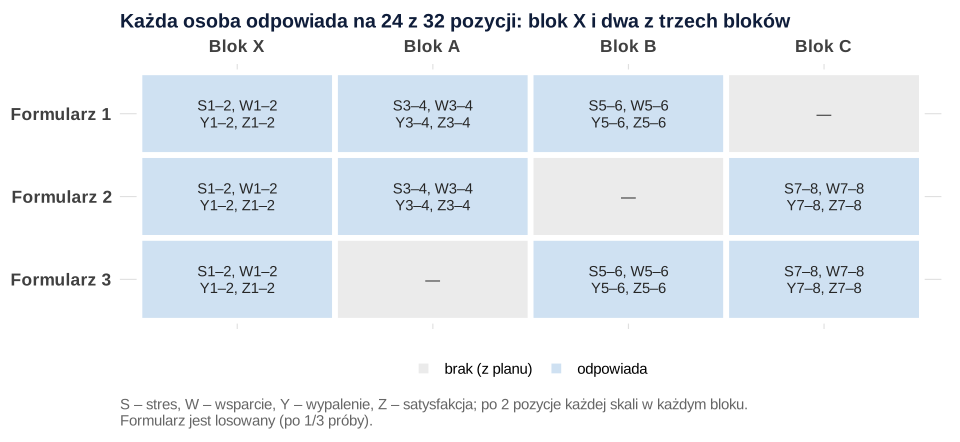
Ceną jest to, że nie każda para pozycji występuje razem u wszystkich. Pozycje z bloku X widzą wszyscy. Parę X–A albo dwie pozycje z bloku A widzi 66.7% osób. Parę A–B, czyli pozycje z dwóch różnych bloków rotowanych, widzi tylko 33.3% osób. Korelację takiej pary szacujesz więc na jednej trzeciej próby. Od tego, które pozycje trafią do których bloków, zależy więc, które wyniki będą precyzyjne.
Little i Rhemtulla (2013) opisują trzy rodziny takich planów. Pierwsza to plany wieloformularzowe, takie jak ten. Druga to plany z brakiem całych pomiarów w badaniu podłużnym. Trzecia to plan dwóch metod, w którym drogi i dokładny pomiar wykonuje się tylko w losowej podpróbie. Ten wpis dotyczy dwóch pierwszych.
Dlaczego te braki są nieszkodliwe
Gdy formularz jest losowany, to, czego brakuje, nie zależy od niczego w danych: ani od cech osoby, ani od jej odpowiedzi. Takie braki są z definicji MCAR (mechanizmy braków danych), więc nie musisz ich testować ani zgadywać. Musisz je za to właściwie przeanalizować. Schafer i Graham (2002) zalecają dwa podejścia: metodę największej wiarygodności z pełną informacją (FIML) i imputację wielokrotną. Usunięcie niepełnych przypadków nie wchodzi w grę, bo pełnych przypadków nie ma.
W praktyce do planowanych braków zawsze dochodzą nieplanowane: ktoś przerwie ankietę albo pominie pytanie. Little i Rhemtulla (2013) zwracają uwagę, że krótsza ankieta może zmniejszyć liczbę takich braków i poprawić trafność odpowiedzi. Braki nieplanowane musisz jednak opisać osobno i ocenić ich mechanizm, tak jak w każdym badaniu (zob. braki danych w ankiecie).
Jak przydzielić pozycje do bloków
To najważniejsza decyzja w całym planie. Rhemtulla i in. (2016) porównali analitycznie schematy planowanych braków z planami bez braków o tej samej liczbie odpowiedzi. Gdy analizujesz zmienne latentne, efektywność oszacowań jest największa, gdy pozycje każdego czynnika rozłożysz na różne bloki. Blok X poprawia wtedy precyzję większości parametrów. Z tego wynikają cztery zasady:
- Rozłóż każdą skalę na wszystkie bloki. W przykładzie każda skala ma po dwie pozycje w X, A, B i C. Każda osoba odpowiada więc na 6 z 8 pozycji każdej skali, a każdą korelację czynników szacujesz na całej próbie.
- Do bloku X daj to, co musi być pełne. Zmienne do doboru próby i opisu grup, zmienną zależną analizy głównej i zmienne do interakcji. Dodaj tu też zmienne pomocnicze, które mogą wiązać się z brakami nieplanowanymi, na przykład pytanie o zmęczenie albo czas wypełniania.
- Nie dziel na bloki rotowane par pozycji, których związek jest głównym pytaniem. Ich korelację policzysz tylko na jednej trzeciej próby.
- Kontroluj kolejność. Przy stałej kolejności bloków formularze kończą się różnymi blokami. Gdy kolejność ma znaczenie, losuj ją albo zapisz, który blok był ostatni.
Przykład: 32 pozycje, 300 osób, trzy analizy
Symulowane badanie obejmuje 300 osób i cztery skale po 8 pozycji: stres, wsparcie, wypalenie i satysfakcję. Najpierw losujemy pełne dane, a potem nakładamy na nie schemat trzech formularzy (po 100 osób na formularz). Brakuje 25% odpowiedzi, a w danych są tylko trzy wzorce braków. Do pełnych danych i do danych z brakami dopasowujemy tę samą konfirmacyjną analizę czynnikową z czterema czynnikami w lavaan (Rosseel, 2012). Dane z brakami analizujemy dwa razy: FIML (missing = "fiml") i imputacją wielokrotną w pakiecie mice (van Buuren i Groothuis-Oudshoorn, 2011). Imputacja dała 20 zbiorów, a wyniki połączyliśmy regułami Rubina.
| Korelacja | Prawdziwa | Pełne dane: r (SE) | Trzy formularze, FIML: r (SE) | Trzy formularze, imputacja: r (SE) | FMI |
|---|---|---|---|---|---|
| stres – wsparcie | −.30 | −.261 (0.062) | −.237 (0.065) | −.229 (0.066) | .084 |
| stres – wypalenie | .50 | .541 (0.049) | .559 (0.051) | .566 (0.051) | .114 |
| stres – satysfakcja | −.35 | −.323 (0.060) | −.328 (0.062) | −.326 (0.062) | .062 |
| wsparcie – wypalenie | −.30 | −.250 (0.063) | −.240 (0.066) | −.248 (0.067) | .100 |
| wsparcie – satysfakcja | .35 | .295 (0.062) | .300 (0.064) | .311 (0.063) | .066 |
| wypalenie – satysfakcja | −.45 | −.445 (0.055) | −.460 (0.058) | −.465 (0.061) | .193 |
Wszystkie trzy analizy dają podobne korelacje, a różnice wobec wartości prawdziwych wynikają głównie z losowości tej jednej próby. Ta sama losowość działa też w pełnych danych. Błędy standardowe w danych z brakami są średnio tylko 1.041 raza większe przy FIML i 1.058 raza większe przy imputacji. Tak mała strata przy 25% brakujących odpowiedzi wynika stąd, że czynnik mierzony sześcioma pozycjami u każdej osoby jest nadal dobrze określony. Frakcja brakującej informacji wyniosła od .062 do .193, czyli znacznie mniej niż odsetek braków. Model z FIML pasował dobrze: χ²(458) = 489.28, CFI = .987, RMSEA = .015, SRMR = .056.
FIML czy imputacja wielokrotna?
Przy planowanych brakach oba podejścia korzystają z tej samej informacji i przy poprawnym modelu dają zbliżone wyniki. Szerzej opisuje je podręcznik Endersa (2022). FIML jest prostszy: jedna opcja w lavaan, bez osobnego modelu imputacji. Imputacja przydaje się, gdy na tych samych danych zrobisz wiele różnych analiz albo gdy potrzebujesz metody, która nie obsługuje FIML. Imputuj wtedy pozycje, a nie wyniki skal, i włącz do modelu imputacji wszystkie pozycje. Dodatkowo włącz zmienne, których użyjesz w analizie. Jak połączyć wyniki SEM, χ² i R² z wielu zbiorów, pokazuje wpis o regułach Rubina w praktyce. Diagnozę i model imputacji opisuje wpis braki danych i imputacja wielokrotna w R.
Nie licz wyniku skali jako średniej z pozycji, na które dana osoba odpowiedziała. Osoby z różnych formularzy mają wtedy wyniki z innych zestawów pozycji. Lepiej modeluj skale jako czynniki latentne albo imputuj pozycje i licz wyniki w każdym zbiorze osobno (zob. wynik skali: średnia czy suma).
Ile precyzji tracisz? Symulacja
Jedno badanie to za mało, żeby ocenić plan, więc porównaliśmy sześć planów w 200 symulowanych badaniach na plan (logikę takich porównań opisuje wpis o planowaniu badań symulacyjnych). Miarą jest średni błąd standardowy sześciu korelacji czynników. Względna efektywność to kwadrat stosunku błędu standardowego w pełnych danych N = 300 do błędu standardowego w danym planie.
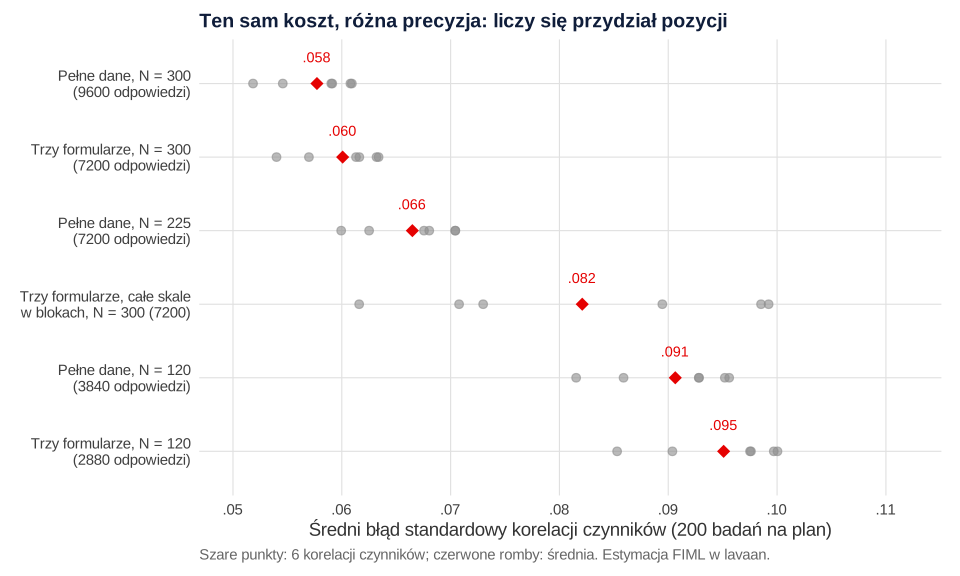
Trzy wnioski:
- Trzy formularze kosztują mało. Przy 300 osobach średni błąd standardowy wzrósł z 0.058 do 0.060. Względna efektywność wyniosła .923, choć zebraliśmy o jedną czwartą mniej odpowiedzi.
- Są lepsze niż mniejsza próba z pełną ankietą. Pełna ankieta dla 225 osób daje tyle samo odpowiedzi (7200), ale błąd standardowy 0.066 i względną efektywność .754. Zgadza się to z wnioskiem Rhemtulli i in. (2016), że planowane braki opłacają się zwłaszcza w modelach ze zmiennymi latentnymi.
- Zły przydział niszczy zysk. Gdy każda skala trafiła w całości do jednego bloku (stres do X, pozostałe do A, B i C), średni błąd standardowy wyniósł 0.082, a względna efektywność .494. Korelacje ze stresem miały średni błąd 0.068, a korelacje między skalami z bloków rotowanych – 0.096, bo opierały się na jednej trzeciej próby.
We wszystkich planach obciążenie korelacji wynosiło najwyżej 0.013, a pokrycie 95% przedziałów mieściło się między .915 a .975. Przy 200 powtórzeniach to wahania w granicach błędu Monte Carlo. Wszystkie modele się zbiegły i żaden nie dał rozwiązania niewłaściwego.
Na co uważać przy małej próbie
Przy 120 osobach średni błąd standardowy wyniósł 0.091 w pełnych danych i 0.095 w schemacie trzech formularzy. Względny koszt jest podobny jak przy 300 osobach, ale wychodzi od słabszego punktu. W naszym modelu (ładunki .55–.75, 8 pozycji na skalę) wszystkie modele się zbiegły. Przy słabszych ładunkach, krótszych skalach i bardziej złożonych modelach ostrożnie zakładaj, że tak będzie. Każdy formularz ma tu tylko 40 osób, a korelacje par A–B opierają się właśnie na nich. Przed badaniem sprawdź więc plan własną symulacją dla swojego modelu (zob. liczebność próby do SEM).
Bardziej uważaj w analizach na poziomie zmiennych obserwowalnych. Rhemtulla i in. (2016) pokazali, że w regresji na zmiennych obserwowalnych współczynniki mają w planach z brakami znacznie niższą efektywność niż w planach z mniejszą próbą bez braków. Blok X pomaga tylko parametrom, w których te zmienne występują. Jeśli główny wynik to regresja na pojedynczych pozycjach albo interakcja dwóch zmiennych, umieść te zmienne w bloku X. Zaplanuj też moc dla tej analizy, a nie dla całego modelu.
Wariant podłużny: planowany brak pomiarów
W badaniu podłużnym możesz losowo pominąć całe pomiary, a nie pozycje. Każda osoba ma wtedy na przykład 4 z 5 pomiarów. Rhemtulla i Little (2012) zwracają uwagę, że planowane braki mogą zmniejszać zmęczenie i efekt wprawy. Rhemtulla i in. (2014) porównali jednak plany dla krzywych wzrostu. Schemat trzech formularzy w każdym pomiarze dawał wysoką efektywność. Brak całych pomiarów silnie obniżał efektywność i obciążał oszacowania wariancji i kowariancji nachyleń. Autorzy odradzają brak pomiarów, z wyjątkiem dużych efektów i bardzo dużych prób.
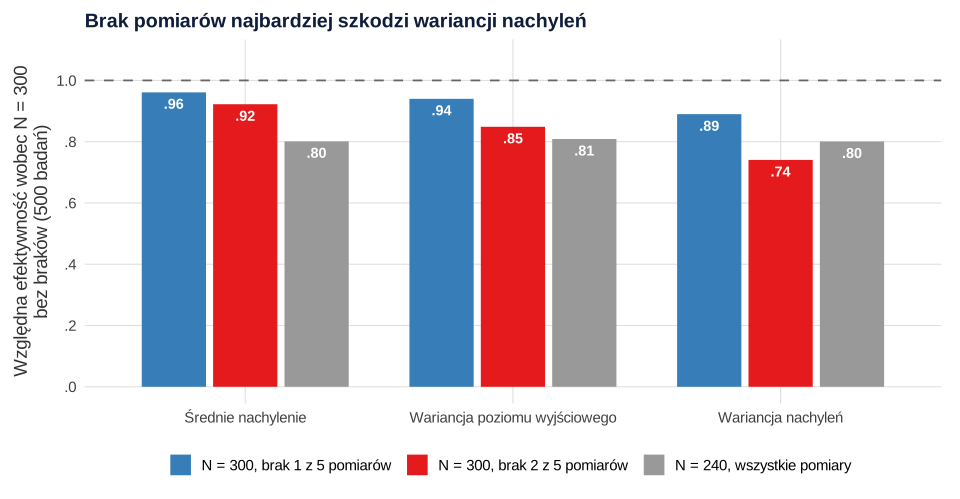
W naszej symulacji (5 pomiarów, 300 osób, 500 badań) wariant był łagodniejszy: pierwszy i ostatni pomiar mieli wszyscy, a losowo brakowało pomiaru 2, 3 lub 4. Przy jednym brakującym pomiarze średnie nachylenie zachowało względną efektywność .961, a wariancja nachyleń – .890. Przy dwóch brakujących pomiarach było to .922 i .741. Średnie trajektorie znosiły braki dobrze, a różnice między osobami w tempie zmian – gorzej. Jeśli pytanie badawcze dotyczy właśnie tych różnic, nie oszczędzaj na pomiarach. Brak planowany różni się też od utraty uczestników, która rzadko jest MCAR.
Jak opisać schemat w artykule
Opisz przydział pozycji do bloków (najlepiej w tabeli w suplemencie), sposób losowania formularzy, odsetek braków planowanych i nieplanowanych oraz metodę analizy. Zapisz te decyzje w planie analizy przed zebraniem danych.
Jeśli chcesz, żeby ktoś sprawdził przydział pozycji albo przygotował symulację dla Twojego modelu, zajrzyj do oferty analiz statystycznych dla badaczy.
Przykład w R
Trzy przepisy uruchamiasz po kolei w jednej sesji R. Pierwszy zapisuje dane z brakami do pliku trzy-formularze-ankieta.csv (możesz go pobrać tutaj). Symulacje liczą się równolegle na czterech rdzeniach i trwają łącznie kilka minut. Potrzebne pakiety: lavaan, mice i parallel (część R).
1. Schemat trzech formularzy, CFA z FIML i imputacja wielokrotna
R
# Krok 1. Schemat trzech formularzy, jedno badanie i analiza: FIML (lavaan) i imputacja wielokrotna (mice)
# Ankieta: 4 skale po 8 pozycji (stres, wsparcie, wypalenie, satysfakcja) = 32 pozycje (dane symulowane).
suppressPackageStartupMessages({library(lavaan); library(mice)})

skale <- c(S = "stres", W = "wsparcie", Y = "wypalenie", Z = "satysfakcja")
pozycje <- paste0(rep(names(skale), each = 8), 1:8)          # S1–S8, W1–W8, Y1–Y8, Z1–Z8

# Model populacyjny: korelacje czynników i ładunki standaryzowane .55–.75
Phi <- matrix(c( 1.00, -.30,  .50, -.35,
                 -.30, 1.00, -.30,  .35,
                  .50, -.30, 1.00, -.45,
                 -.35,  .35, -.45, 1.00), 4, dimnames = list(names(skale), names(skale)))
ladunki <- rep(c(.75, .70, .65, .60, .75, .70, .65, .55), 4)
generuj <- function(N) {
  eta <- matrix(rnorm(N * 4), N) %*% chol(Phi)
  x <- eta[, rep(1:4, each = 8)] * rep(ladunki, each = N) +
       matrix(rnorm(N * 32), N) * rep(sqrt(1 - ladunki^2), each = N)
  x <- 3 + 0.8 * x                                       # skala odpowiedzi ok. 1–5
  colnames(x) <- pozycje
  as.data.frame(x)
}

# Przydział pozycji do bloków: z każdej skali po 2 pozycje do X, A, B i C (8 pozycji w bloku)
blok <- setNames(rep(rep(c("X", "A", "B", "C"), each = 2), 4), pozycje)
formularze <- list(F1 = c("X", "A", "B"), F2 = c("X", "A", "C"), F3 = c("X", "B", "C"))
naloz_schemat <- function(d, blok) {
  f <- sample(rep(1:3, length.out = nrow(d)))               # losowy, zrównoważony przydział formularzy
  for (i in 1:3) d[f == i, blok[names(d)] %in% setdiff(c("A", "B", "C"), formularze[[i]])] <- NA
  attr(d, "formularz") <- f
  d
}

set.seed(3420)
pelne <- generuj(300)
trzy <- naloz_schemat(pelne, blok)
table(formularz = attr(trzy, "formularz"))
c(pozycji_w_ankiecie = length(pozycje), pozycji_na_osobe = mean(rowSums(!is.na(trzy))),
  odsetek_brakow = round(mean(is.na(trzy)), 3))

# Pokrycie kowariancji: odsetek osób, które odpowiedziały na obie pozycje z pary (według bloków)
pokrycie <- crossprod(!is.na(trzy)) / nrow(trzy)
pary <- c("X–X" = pokrycie["S1", "W1"], "X–A" = pokrycie["S1", "S3"],
          "A–A" = pokrycie["S3", "W3"], "A–B" = pokrycie["S3", "W5"])
round(pary, 3)

# CFA z czterema czynnikami (std.lv = TRUE: korelacje czynników są parametrami modelu)
model <- paste(sapply(names(skale), function(s) paste(s, "=~", paste0(s, 1:8, collapse = " + "))), collapse = "\n")
korelacje <- function(fit) {
  pe <- parameterEstimates(fit)
  pe <- pe[pe$op == "~~" & pe$lhs != pe$rhs & pe$lhs %in% names(skale), ]
  setNames(pe[, c("est", "se")], c("r", "SE")) |> `rownames<-`(paste(pe$lhs, pe$rhs, sep = "–"))
}
fit_pelne <- cfa(model, data = pelne, std.lv = TRUE)
fit_fiml <- cfa(model, data = trzy, std.lv = TRUE, missing = "fiml")
cat("Liczba wzorców braków:", nrow(unique(is.na(trzy))), "\n")

# Imputacja wielokrotna: 20 zbiorów (pmm), CFA w każdym, łączenie regułami Rubina
imp <- mice(trzy, m = 20, method = "pmm", maxit = 10, printFlag = FALSE, seed = 3421)
oceny <- lapply(1:20, function(i) korelacje(cfa(model, data = complete(imp, i), std.lv = TRUE)))
Q <- sapply(oceny, `[[`, "r"); U <- sapply(oceny, `[[`, "SE")^2
m <- ncol(Q); Qbar <- rowMeans(Q); W <- rowMeans(U); B <- apply(Q, 1, var)
T_rubin <- W + (1 + 1 / m) * B
mi <- data.frame(r = Qbar, SE = sqrt(T_rubin), FMI = (1 + 1 / m) * B / T_rubin)

wyniki <- cbind(prawda = Phi[lower.tri(Phi)], korelacje(fit_pelne), korelacje(fit_fiml), mi)
names(wyniki) <- c("prawda", "r_pelne", "SE_pelne", "r_FIML", "SE_FIML", "r_MI", "SE_MI", "FMI_MI")
round(wyniki, 3)
# Ile razy większy błąd standardowy niż w pełnych danych (średnio dla 6 korelacji)
round(c(FIML = mean(wyniki$SE_FIML / wyniki$SE_pelne), MI = mean(wyniki$SE_MI / wyniki$SE_pelne)), 3)
round(fitMeasures(fit_fiml, c("chisq", "df", "cfi", "rmsea", "srmr")), 3)
write.csv(round(trzy, 2), "trzy-formularze-ankieta.csv", row.names = FALSE, na = "")
Wynik w R
formularz
  1   2   3
100 100 100
pozycji_w_ankiecie   pozycji_na_osobe     odsetek_brakow
             32.00              24.00               0.25
  X–X   X–A   A–A   A–B
1.000 0.667 0.667 0.333
Liczba wzorców braków: 3
    prawda r_pelne SE_pelne r_FIML SE_FIML   r_MI SE_MI FMI_MI
S–W  -0.30  -0.261    0.062 -0.237   0.065 -0.229 0.066  0.084
S–Y   0.50   0.541    0.049  0.559   0.051  0.566 0.051  0.114
S–Z  -0.35  -0.323    0.060 -0.328   0.062 -0.326 0.062  0.062
W–Y  -0.30  -0.250    0.063 -0.240   0.066 -0.248 0.067  0.100
W–Z   0.35   0.295    0.062  0.300   0.064  0.311 0.063  0.066
Y–Z  -0.45  -0.445    0.055 -0.460   0.058 -0.465 0.061  0.193
 FIML    MI
1.041 1.058
  chisq      df     cfi   rmsea    srmr
489.275 458.000   0.987   0.015   0.056
2. Symulacja: koszt schematu i przydział pozycji
R
# Krok 2. Symulacja: ile kosztuje schemat trzech formularzy i jak ważny jest przydział pozycji
# (wymaga obiektów z kroku 1: generuj, naloz_schemat, blok, model, korelacje, Phi, pozycje)
library(parallel)

# Zły przydział: każda skala w całości w jednym bloku (stres w X, wsparcie w A, wypalenie w B, satysfakcja w C)
blok_skale <- setNames(rep(c("X", "A", "B", "C"), each = 8), pozycje)
plany <- data.frame(
  plan = c("pelne_300", "trzy_300", "trzy_skale_300", "pelne_225", "pelne_120", "trzy_120"),
  N = c(300, 300, 300, 225, 120, 120),
  schemat = c("brak", "pozycje", "skale", "brak", "brak", "pozycje"))
prawda <- Phi[lower.tri(Phi)]

jedno_badanie <- function(N, schemat) {
  d <- generuj(N)
  if (schemat == "pozycje") d <- naloz_schemat(d, blok)
  if (schemat == "skale") d <- naloz_schemat(d, blok_skale)
  fit <- tryCatch(suppressWarnings(cfa(model, data = d, std.lv = TRUE, missing = "fiml")), error = function(e) NULL)
  if (is.null(fit) || !lavInspect(fit, "converged")) return(rep(NA, 13))
  k <- korelacje(fit)
  c(k$r, k$SE, poprawne = suppressWarnings(lavInspect(fit, "post.check")))
}

R_sym <- 200
czas_start <- Sys.time()
wyniki <- mclapply(seq_len(nrow(plany)), function(i) {
  set.seed(34200 + i)
  t(replicate(R_sym, jedno_badanie(plany$N[i], plany$schemat[i])))
}, mc.cores = 4)

nazwy_r <- c("S–W", "S–Y", "S–Z", "W–Y", "W–Z", "Y–Z")
podsumowanie <- do.call(rbind, lapply(seq_len(nrow(plany)), function(i) {
  w <- wyniki[[i]]; ok <- !is.na(w[, 1])
  est <- w[ok, 1:6, drop = FALSE]; se <- w[ok, 7:12, drop = FALSE]
  pokrycie <- colMeans(abs(sweep(est, 2, prawda)) <= 1.96 * se)
  data.frame(plan = plany$plan[i], korelacja = nazwy_r, prawda = prawda,
             obciazenie = colMeans(est) - prawda, SD_emp = apply(est, 2, sd), SE_sr = colMeans(se),
             pokrycie = pokrycie, zbiezne = mean(ok), niewlasciwe = mean(w[ok, 13] == 0))
}))
write.csv(podsumowanie, "symulacja-trzy-formularze.csv", row.names = FALSE)
print(within(podsumowanie, {obciazenie <- round(obciazenie, 3); SD_emp <- round(SD_emp, 3)
  SE_sr <- round(SE_sr, 3); pokrycie <- round(pokrycie, 3)})[, c("plan", "korelacja", "obciazenie", "SD_emp", "SE_sr", "pokrycie")],
  row.names = FALSE)

# Średni błąd standardowy korelacji czynników i względna efektywność wobec pełnych danych N = 300
sr <- aggregate(cbind(SE_sr, obciazenie, pokrycie, zbiezne, niewlasciwe) ~ plan, podsumowanie, mean)
sr$wzgledna_efektywnosc <- (sr$SE_sr[sr$plan == "pelne_300"] / sr$SE_sr)^2
sr$punkty_danych <- plany$N[match(sr$plan, plany$plan)] * ifelse(grepl("trzy", sr$plan), 24, 32)
print(cbind(sr[1], round(sr[-1], 3))[match(plany$plan, sr$plan), ], row.names = FALSE)

# Zły przydział: korelacje ze stresem (blok X, pokrycie 2/3) a korelacje między A, B i C (pokrycie 1/3)
zle <- subset(podsumowanie, plan == "trzy_skale_300")
round(c(SE_ze_stresem = mean(zle$SE_sr[1:3]), SE_miedzy_blokami = mean(zle$SE_sr[4:6])), 3)
cat("Czas obliczeń (min):", round(as.numeric(difftime(Sys.time(), czas_start, units = "mins")), 1), "\n")
Wynik w R
           plan korelacja obciazenie SD_emp SE_sr pokrycie
      pelne_300       S–W      0.005  0.067 0.061    0.915
      pelne_300       S–Y     -0.002  0.053 0.052    0.945
      pelne_300       S–Z      0.004  0.064 0.059    0.935
      pelne_300       W–Y      0.001  0.065 0.061    0.955
      pelne_300       W–Z     -0.002  0.061 0.059    0.940
      pelne_300       Y–Z      0.003  0.054 0.055    0.950
       trzy_300       S–W      0.001  0.066 0.063    0.935
       trzy_300       S–Y      0.004  0.054 0.054    0.950
       trzy_300       S–Z     -0.001  0.062 0.061    0.950
       trzy_300       W–Y      0.005  0.066 0.063    0.955
       trzy_300       W–Z     -0.005  0.061 0.062    0.955
       trzy_300       Y–Z      0.002  0.060 0.057    0.925
 trzy_skale_300       S–W     -0.010  0.073 0.073    0.940
 trzy_skale_300       S–Y      0.005  0.061 0.062    0.935
 trzy_skale_300       S–Z      0.001  0.073 0.071    0.925
 trzy_skale_300       W–Y     -0.002  0.101 0.099    0.950
 trzy_skale_300       W–Z      0.004  0.108 0.099    0.915
 trzy_skale_300       Y–Z     -0.001  0.086 0.089    0.960
      pelne_225       S–W      0.007  0.067 0.070    0.945
      pelne_225       S–Y     -0.004  0.060 0.060    0.955
      pelne_225       S–Z     -0.007  0.067 0.068    0.955
      pelne_225       W–Y      0.006  0.062 0.070    0.975
      pelne_225       W–Z     -0.003  0.065 0.068    0.940
      pelne_225       Y–Z     -0.003  0.060 0.063    0.955
      pelne_120       S–W     -0.012  0.090 0.095    0.940
      pelne_120       S–Y      0.000  0.078 0.082    0.940
      pelne_120       S–Z      0.003  0.098 0.093    0.910
      pelne_120       W–Y     -0.005  0.091 0.096    0.945
      pelne_120       W–Z      0.001  0.088 0.093    0.955
      pelne_120       Y–Z      0.002  0.081 0.086    0.955
       trzy_120       S–W      0.007  0.099 0.100    0.930
       trzy_120       S–Y      0.002  0.092 0.085    0.930
       trzy_120       S–Z      0.010  0.095 0.098    0.950
       trzy_120       W–Y      0.003  0.102 0.100    0.935
       trzy_120       W–Z     -0.013  0.104 0.098    0.935
       trzy_120       Y–Z      0.006  0.092 0.090    0.935
           plan SE_sr obciazenie pokrycie zbiezne niewlasciwe
      pelne_300 0.058      0.001    0.940       1           0
       trzy_300 0.060      0.001    0.945       1           0
 trzy_skale_300 0.082     -0.001    0.938       1           0
      pelne_225 0.066     -0.001    0.954       1           0
      pelne_120 0.091     -0.002    0.941       1           0
       trzy_120 0.095      0.003    0.936       1           0
 wzgledna_efektywnosc punkty_danych
                1.000          9600
                0.923          7200
                0.494          7200
                0.754          7200
                0.405          3840
                0.368          2880
    SE_ze_stresem SE_miedzy_blokami
            0.068             0.096
Czas obliczeń (min): 1.7
3. Wariant podłużny: brak jednego lub dwóch pomiarów
R
# Krok 3. Wariant podłużny: planowany brak jednego pomiaru (wave missing) w krzywej wzrostu
# Pięć pomiarów (t = 0–4), model liniowej krzywej wzrostu w lavaan, estymacja FIML (dane symulowane)
library(lavaan); library(parallel)

par_lgm <- c(sr_i = 3.0, sr_s = -0.10, war_i = 0.40, war_s = 0.02, kow_is = -0.02, war_e = 0.15)
generuj_fale <- function(N) {
  G <- matrix(c(par_lgm[["war_i"]], par_lgm[["kow_is"]], par_lgm[["kow_is"]], par_lgm[["war_s"]]), 2)
  u <- matrix(rnorm(N * 2), N) %*% chol(G)
  i <- par_lgm[["sr_i"]] + u[, 1]; s <- par_lgm[["sr_s"]] + u[, 2]
  y <- sapply(0:4, function(t) i + s * t + rnorm(N, 0, sqrt(par_lgm[["war_e"]])))
  colnames(y) <- paste0("y", 1:5)
  as.data.frame(y)
}
# Brak pomiarów: każda osoba losowo opuszcza jeden (albo dwa) z pomiarów 2, 3 i 4 (pomiar 1 i 5 – wszyscy)
brak_fali <- function(d, ile = 1) {
  wzorce <- combn(2:4, ile, simplify = FALSE)
  f <- sample(rep(seq_along(wzorce), length.out = nrow(d)))
  for (k in seq_along(wzorce)) d[f == k, wzorce[[k]]] <- NA
  d
}
model_lgm <- "i =~ 1*y1 + 1*y2 + 1*y3 + 1*y4 + 1*y5
              s =~ 0*y1 + 1*y2 + 2*y3 + 3*y4 + 4*y5
              y1 ~~ e*y1; y2 ~~ e*y2; y3 ~~ e*y3; y4 ~~ e*y4; y5 ~~ e*y5"
parametry_lgm <- function(d) {
  fit <- tryCatch(suppressWarnings(growth(model_lgm, data = d, missing = "fiml")), error = function(e) NULL)
  if (is.null(fit) || !lavInspect(fit, "converged")) return(rep(NA, 6))
  pe <- parameterEstimates(fit)
  w <- rbind(pe[pe$lhs == "s" & pe$op == "~1", ], pe[pe$lhs == "s" & pe$rhs == "s" & pe$op == "~~", ],
             pe[pe$lhs == "i" & pe$rhs == "i" & pe$op == "~~", ])
  c(w$est, w$se)
}
plany_lgm <- data.frame(plan = c("pelne_300", "brak_fali_300", "pelne_240", "brak_dwoch_fal_300"),
                        N = c(300, 300, 240, 300), braki = c(0, 1, 0, 2))
R_lgm <- 500
wyniki_lgm <- mclapply(seq_len(nrow(plany_lgm)), function(i) {
  set.seed(34300 + i)
  t(replicate(R_lgm, {d <- generuj_fale(plany_lgm$N[i]); if (plany_lgm$braki[i] > 0) d <- brak_fali(d, plany_lgm$braki[i]); parametry_lgm(d)}))
}, mc.cores = 4)
prawda_lgm <- c(srednie_nachylenie = -0.10, wariancja_nachylenia = 0.02, wariancja_poziomu = 0.40)
lgm <- do.call(rbind, lapply(seq_len(nrow(plany_lgm)), function(i) {
  w <- wyniki_lgm[[i]]; w <- w[!is.na(w[, 1]), ]
  data.frame(plan = plany_lgm$plan[i], parametr = names(prawda_lgm), prawda = prawda_lgm,
             obciazenie = colMeans(w[, 1:3]) - prawda_lgm, SE_sr = colMeans(w[, 4:6]), zbiezne = nrow(w) / R_lgm)
}))
lgm$wzgledna_efektywnosc <- (lgm$SE_sr[lgm$plan == "pelne_300"][match(lgm$parametr, names(prawda_lgm))] / lgm$SE_sr)^2
write.csv(lgm, "symulacja-brak-fali.csv", row.names = FALSE)
print(cbind(lgm[1:2], round(lgm[3:7], 4)), row.names = FALSE)
Wynik w R
               plan             parametr prawda obciazenie  SE_sr zbiezne
          pelne_300   srednie_nachylenie  -0.10    -0.0005 0.0108       1
          pelne_300 wariancja_nachylenia   0.02    -0.0002 0.0029       1
          pelne_300    wariancja_poziomu   0.40    -0.0017 0.0401       1
      brak_fali_300   srednie_nachylenie  -0.10    -0.0001 0.0110       1
      brak_fali_300 wariancja_nachylenia   0.02    -0.0001 0.0031       1
      brak_fali_300    wariancja_poziomu   0.40    -0.0021 0.0414       1
          pelne_240   srednie_nachylenie  -0.10     0.0008 0.0120       1
          pelne_240 wariancja_nachylenia   0.02    -0.0002 0.0033       1
          pelne_240    wariancja_poziomu   0.40    -0.0043 0.0446       1
 brak_dwoch_fal_300   srednie_nachylenie  -0.10     0.0001 0.0112       1
 brak_dwoch_fal_300 wariancja_nachylenia   0.02     0.0000 0.0034       1
 brak_dwoch_fal_300    wariancja_poziomu   0.40    -0.0019 0.0435       1
 wzgledna_efektywnosc
               1.0000
               1.0000
               1.0000
               0.9610
               0.8900
               0.9399
               0.8010
               0.8007
               0.8088
               0.9223
               0.7405
               0.8487
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 z pakietami lavaan i mice (obliczenia równoległe: pakiet parallel z dystrybucji R); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- mice (wersja 3.19.0): van Buuren, S., & Groothuis-Oudshoorn, K. (2011). mice: Multivariate imputation by chained equations in R. Journal of Statistical Software, 45(3), 1–67. https://doi.org/10.18637/jss.v045.i03
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Cała skala w jednym bloku. Korelacje między skalami z różnych bloków rotowanych opierają się wtedy na jednej trzeciej próby. Rozłóż pozycje każdej skali na wszystkie bloki.
- Formularze przydzielane według wygody. Gdy formularz zależy od terminu, grupy albo kolejności zgłoszeń, braki przestają być MCAR. Losuj.
- Usuwanie niepełnych przypadków albo średnie z dostępnych pozycji. W tym schemacie nikt nie ma pełnych danych. Używaj FIML albo imputacji wielokrotnej.
- Kluczowe zmienne w blokach rotowanych. Zmienną zależną i zmienne do interakcji umieść w bloku X.
- Brak całych pomiarów, gdy pytanie dotyczy różnic w zmianie. Na tym tracą najbardziej wariancje nachyleń.
- Brak opisu braków nieplanowanych. Planowane braki nie zwalniają z analizy pozostałych braków.
Najczęstsze pytania
Na czym polega schemat trzech formularzy w ankiecie?
Pozycje dzielisz na cztery bloki: X, A, B i C. Blok X dostaje każdy, a z bloków A, B i C każda osoba dostaje dwa, więc powstają trzy formularze (X+A+B, X+A+C, X+B+C) przydzielane losowo. Przy równych blokach każda osoba odpowiada na 3/4 pozycji, a w badaniu masz dane o wszystkich.
Czy planowane braki danych obniżają moc badania?
Trochę, ale zwykle mniej niż zmniejszenie próby o tę samą liczbę odpowiedzi. W symulacji przy 300 osobach i 25% braków średni błąd standardowy korelacji czynników wzrósł z 0.058 do 0.060. Pełna ankieta dla 225 osób, czyli tyle samo odpowiedzi, dała 0.066. Najwięcej tracą korelacje par pozycji z dwóch różnych bloków rotowanych.
Jak analizować dane ze schematu trzech formularzy?
Metodą największej wiarygodności z pełną informacją (w lavaan missing = "fiml") albo imputacją wielokrotną pozycji, np. w pakiecie mice. Nie usuwaj niepełnych przypadków, bo w tym schemacie nikt nie ma pełnych danych. Nie licz też wyników skal jako średnich z dostępnych pozycji.
Jak przydzielić pozycje do bloków w schemacie trzech formularzy?
Rozłóż pozycje każdej skali na wszystkie bloki, a do bloku X daj zmienną zależną, zmienne do interakcji i zmienne pomocnicze. Gdy cała skala trafiła do jednego bloku, średni błąd standardowy korelacji czynników w symulacji wzrósł do 0.082, a względna efektywność spadła do .494.
Czy w badaniu podłużnym można planowo pominąć pomiary?
Można, ale ostrożnie. Średnia zmiana znosi to dobrze, gorzej różnice między osobami w tempie zmian. W symulacji przy dwóch brakujących pomiarach z pięciu wariancja nachyleń zachowała tylko .741 efektywności. Bezpieczniejszy jest schemat trzech formularzy w każdym pomiarze.
Powiązane hasła
Przeczytaj też
Imputacja wielokrotna: reguły Rubina w praktyce
Wydruk pool() i FMI, imputacja interakcji, R² i test D1, SEM na danych imputowanych z D2 i porównanie z FIML – z kodem w R.
Czytaj →PoradnikJak skrócić kwestionariusz
Ładunki CFA, informacja IRT i mapa treści przy wyborze pozycji, a potem walidacja na nowej próbie: omega, korekta korelacji z pełną wersją, trafność.
Czytaj →PoradnikBraki danych i imputacja wielokrotna w R
MCAR, MAR i MNAR, test Little’a, symulacja metod i imputacja wielokrotna w R krok po kroku – z kodem, regułami Rubina i gotowym opisem APA.
Czytaj →Planujesz długą ankietę albo badanie podłużne i chcesz skrócić je bez utraty skal?
Pomożemy zaprojektować przydział pozycji do bloków, sprawdzić plan symulacją i przeprowadzić analizę FIML lub imputację wielokrotną tak, żebyś mógł(a) samodzielnie opisać i obronić schemat przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Enders, C. K. (2022). Applied missing data analysis (2nd ed.). Guilford Press.
- Galesic, M., & Bosnjak, M. (2009). Effects of questionnaire length on participation and indicators of response quality in a web survey. Public Opinion Quarterly, 73(2), 349–360. https://doi.org/10.1093/poq/nfp031 ● Otwarty dostęp: pełny tekst
- Graham, J. W., Taylor, B. J., Olchowski, A. E., & Cumsille, P. E. (2006). Planned missing data designs in psychological research. Psychological Methods, 11(4), 323–343. https://doi.org/10.1037/1082-989x.11.4.323
- Little, T. D., & Rhemtulla, M. (2013). Planned missing data designs for developmental researchers. Child Development Perspectives, 7(4), 199–204. https://doi.org/10.1111/cdep.12043
- Rhemtulla, M., & Little, T. D. (2012). Planned missing data designs for research in cognitive development. Journal of Cognition and Development, 13(4), 425–438. https://doi.org/10.1080/15248372.2012.717340 ● Otwarty dostęp: pełny tekst
- Rhemtulla, M., Jia, F., Wu, W., & Little, T. D. (2014). Planned missing designs to optimize the efficiency of latent growth parameter estimates. International Journal of Behavioral Development, 38(5), 423–434. https://doi.org/10.1177/0165025413514324 ● Otwarty dostęp: pełny tekst
- Rhemtulla, M., Savalei, V., & Little, T. D. (2016). On the asymptotic relative efficiency of planned missingness designs. Psychometrika, 81(1), 60–89. https://doi.org/10.1007/s11336-014-9422-0
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Schafer, J. L., & Graham, J. W. (2002). Missing data: Our view of the state of the art. Psychological Methods, 7(2), 147–177. https://doi.org/10.1037/1082-989X.7.2.147
- van Buuren, S., & Groothuis-Oudshoorn, K. (2011). mice: Multivariate imputation by chained equations in R. Journal of Statistical Software, 45(3), 1–67. https://doi.org/10.18637/jss.v045.i03 ● Otwarty dostęp
Cytowania BibTeX
@book{enders2022applied, author={Enders, Craig K.}, title={{Applied missing data analysis (2nd ed.)}}, year={2022}, publisher={Guilford Press}, url={https://www.guilford.com/books/Applied-Missing-Data-Analysis/Craig-Enders/9781462549863}}@article{galesic2009effects, author={Galesic, M. and Bosnjak, M.}, title={{Effects of questionnaire length on participation and indicators of response quality in a web survey}}, journal={Public Opinion Quarterly}, year={2009}, volume={73}, number={2}, pages={349--360}, doi={10.1093/poq/nfp031}}@article{graham2006planned, author={Graham, John W. and Taylor, Bonnie J. and Olchowski, Allison E. and Cumsille, Patricio E.}, title={{Planned missing data designs in psychological research}}, journal={Psychological Methods}, year={2006}, volume={11}, number={4}, pages={323--343}, doi={10.1037/1082-989x.11.4.323}}@article{little2013planned, author={Little, Todd D. and Rhemtulla, Mijke}, title={{Planned missing data designs for developmental researchers}}, journal={Child Development Perspectives}, year={2013}, volume={7}, number={4}, pages={199--204}, doi={10.1111/cdep.12043}}@article{rhemtulla2012planned, author={Rhemtulla, Mijke and Little, Todd D.}, title={{Planned missing data designs for research in cognitive development}}, journal={Journal of Cognition and Development}, year={2012}, volume={13}, number={4}, pages={425--438}, doi={10.1080/15248372.2012.717340}}@article{rhemtulla2014planned, author={Rhemtulla, Mijke and Jia, Fan and Wu, Wei and Little, Todd D.}, title={{Planned missing designs to optimize the efficiency of latent growth parameter estimates}}, journal={International Journal of Behavioral Development}, year={2014}, volume={38}, number={5}, pages={423--434}, doi={10.1177/0165025413514324}}@article{rhemtulla2016asymptotic, author={Rhemtulla, Mijke and Savalei, Victoria and Little, Todd D.}, title={{On the asymptotic relative efficiency of planned missingness designs}}, journal={Psychometrika}, year={2016}, volume={81}, number={1}, pages={60--89}, doi={10.1007/s11336-014-9422-0}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, pages={1--36}, doi={10.18637/jss.v048.i02}}@article{schafer2002missing, author={Schafer, Joseph L. and Graham, John W.}, title={{Missing data: Our view of the state of the art}}, journal={Psychological Methods}, year={2002}, volume={7}, number={2}, pages={147--177}, doi={10.1037/1082-989x.7.2.147}}@article{vanbuuren2011mice, author={van Buuren, Stef and Groothuis-Oudshoorn, Karin}, title={{mice: Multivariate imputation by chained equations in R}}, journal={Journal of Statistical Software}, year={2011}, volume={45}, number={3}, pages={1--67}, doi={10.18637/jss.v045.i03}}