Co to jest test statystyczny?
Test statystyczny (ang. statistical test) to procedura, która na podstawie danych z próby ocenia, czy wyniki dają się pogodzić z hipotezą zerową – zwykle z założeniem, że w populacji nie ma różnicy ani związku. Każdy test sprowadza dane do jednej liczby, statystyki testowej, i porównuje ją z rozkładem, jakiego należałoby się spodziewać, gdyby hipoteza zerowa była prawdziwa. Wynikiem jest wartość p i decyzja: odrzucić H0 albo nie.
Dzisiejsza praktyka łączy dwie tradycje. Perezgonzalez (2015) odróżnia testy istotności Fishera, w których wartość p jest stopniowalną miarą dowodów przeciw hipotezie zerowej, od testów Neymana–Pearsona, w których przed badaniem ustala się hipotezę alternatywną, α i dopuszczalny błąd II rodzaju, a test służy do podjęcia decyzji. Podstawy drugiego podejścia, z pojęciami mocy oraz wyników fałszywie dodatnich i fałszywie ujemnych, położyli Neyman i Pearson (1933). Powszechnie stosowane NHST jest według Perezgonzaleza niespójnym połączeniem obu podejść – tym bardziej warto rozumieć, z czego składa się każdy test.
Logika testu w pięciu krokach
- Hipotezy. H0 (np. średnie w dwóch grupach są równe) i H1 (są różne), sformułowane przed zebraniem danych.
- Poziom istotności α – akceptowane ryzyko błędu I rodzaju, zwykle .05 (zob. poziom istotności).
- Statystyka testowa – liczba mierząca, jak bardzo dane odbiegają od H0, najczęściej w stosunku do szumu: t, F, χ², U. Jej mianownikiem bywa błąd standardowy.
- Rozkład statystyki przy H0 – teoretyczny (rozkład t, F lub χ² o określonych stopniach swobody) albo zbudowany z samych danych, np. przez permutacje.
- Wartość p i decyzja. p to prawdopodobieństwo uzyskania statystyki co najmniej tak skrajnej jak obserwowana, gdyby H0 była prawdziwa. Gdy p ≤ α, odrzucamy H0; równoważnie można sprawdzić, czy statystyka przekracza wartość krytyczną.
Test nie „udowadnia” ani H1, ani H0. Wynik nieistotny oznacza tylko, że dane nie pozwalają odrzucić H0 – przyczyną może być mała moc testu.
Przykład: test permutacyjny krok po kroku
Logikę testu najłatwiej zobaczyć na teście permutacyjnym, który nie korzysta z gotowego rozkładu teoretycznego, tylko buduje rozkład statystyki przy H0 z samych danych. Ernst (2004) przypomina, że metody permutacyjne sięgają prac Fishera z 1935 roku, dzięki komputerom łatwo je dziś stosować, a w wielu sytuacjach są dokładne i nie wymagają założeń o rozkładzie.
Dwadzieścia cztery osoby losowo przydzielono do dwutygodniowego treningu uważności albo do grupy kontrolnej (po 12 osób, dane symulowane). Przed sesją zmierzono stres skalą PSS-10 (0–40). Średnia w grupie treningowej wyniosła 16.67 (SD = 5.68), a w kontrolnej 22.17 (SD = 5.44).
- Hipotezy: H0 – trening nie zmienia poziomu stresu; H1 – zmienia (test dwustronny, α = .05).
- Statystyka: różnica średnich, trening − kontrola = −5.50 punktu.
- Rozkład przy H0: jeśli trening nie działa, przynależność do grupy jest tylko etykietą – każda osoba miałaby ten sam wynik w dowolnej grupie. Przetasowujemy więc etykiety 10 000 razy i za każdym razem liczymy różnicę średnich.
- Wartość p: różnicę co najmniej tak dużą jak 5.50, w dowolną stronę, dało 297 z 10 000 przetasowań, więc p = .030.
- Decyzja: p < .05, więc odrzucamy H0. Ponieważ przydział do grup był losowy, różnicę można przypisać treningowi.
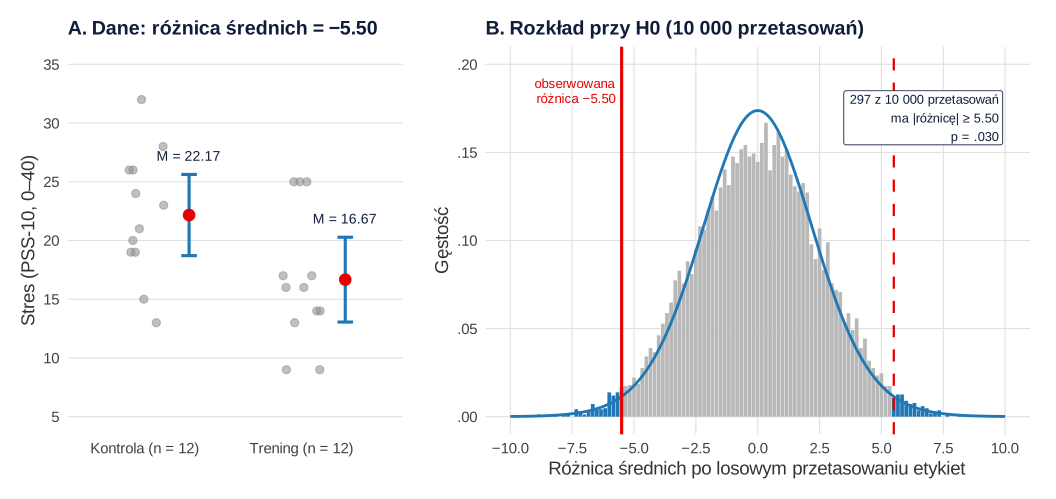
Wszystkich możliwych podziałów 24 osób na dwie dwunastki jest 2 704 156; dokładny test permutacyjny, który uwzględnia je wszystkie, daje p = .028. Niebieska krzywa na rysunku 1B pokazuje, że klasyczny test t dla prób niezależnych jest wygodnym przybliżeniem tego samego rozumowania: t(22) = −2.42, p = .024. Wartość krytyczna dla α = .05 wynosi 2.07, a |−2.42| ją przekracza. Różnica jest też duża w sensie praktycznym: d = −0.99 (zob. d Cohena).
Rodzaje testów statystycznych
| Podział | Na czym polega | Więcej |
|---|---|---|
| Parametryczne i nieparametryczne | czy test zakłada określony rozkład w populacji (np. normalny) i dotyczy parametrów, jak średnia, czy opiera się np. na rangach | testy parametryczne, testy nieparametryczne |
| Dla prób niezależnych i zależnych | czy porównujesz różne osoby, czy te same osoby (lub pary) w kilku pomiarach | test t Studenta, czynnik wewnątrzobiektowy |
| Jednostronne i dwustronne | czy H1 przewiduje kierunek różnicy | test jednostronny i dwustronny |
| Asymptotyczne i dokładne | czy p pochodzi z przybliżenia (rozkład normalny, χ²), czy z dokładnego rozkładu (permutacje, rozkład dwumianowy) – ważne w małych próbach | test McNemara, test Fishera |
| Testy istotności i równoważności | czy sprawdzasz, że efekt różni się od zera, czy że jest mniejszy od najmniejszego interesującego efektu | hipoteza zerowa i alternatywna |
| Częstościowe i bayesowskie | wartość p albo informacja, ile razy bardziej prawdopodobne są dane przy jednej hipotezie niż przy drugiej | czynnik Bayesa |
Jak dobrać test do pytania badawczego
Wybór testu wynika z pytania badawczego, rodzaju zmiennej zależnej (ilościowa, porządkowa, nominalna), liczby porównywanych grup lub pomiarów i tego, czy obserwacje są niezależne. Najczęstsze sytuacje:
| Pytanie | Typowy test | Dane porządkowe lub niespełnione założenia |
|---|---|---|
| Czy średnia różni się od wartości odniesienia? | test t dla jednej próby | test Wilcoxona dla jednej próby |
| Czy dwie niezależne grupy się różnią? | test Welcha (test t) | test U Manna-Whitneya |
| Czy zmienił się wynik tych samych osób (2 pomiary)? | test t dla prób zależnych | test Wilcoxona dla par |
| Czy trzy lub więcej grup się różni? | ANOVA (Welcha) | test Kruskala-Wallisa |
| Czy trzy lub więcej pomiarów się różni? | ANOVA z powtarzanymi pomiarami | test Friedmana |
| Czy dwie zmienne jakościowe są powiązane? | test chi-kwadrat niezależności | test dokładny Fishera |
| Czy zmienił się odsetek odpowiedzi tak/nie? | test McNemara | wersja dokładna lub mid-p |
| Czy rozkład zmiennej jakościowej odpowiada oczekiwanemu? | test chi-kwadrat zgodności | test dokładny (dwumianowy lub wielomianowy) |
| Czy dwie zmienne ilościowe są powiązane? | korelacja Pearsona | korelacja Spearmana |
| Czy predyktory wyjaśniają wynik? | regresja liniowa | regresja logistyczna (wynik tak/nie) |
Osobną grupę stanowią testy założeń, np. test Shapiro-Wilka, test Levene’a czy test Mauchly’ego przy założeniu sferyczności. Traktuj je jako pomoc, a nie automat do wyboru testu. Pełny schemat decyzji z przykładami znajdziesz w poradniku jak dobrać test statystyczny do hipotezy. Test wybierz przed obejrzeniem wyników – sprawdzanie kolejnych testów, aż któryś da p < .05, to p-hacking.
Czego test statystyczny nie mówi
Wasserstein i Lazar (2016) w oświadczeniu Amerykańskiego Towarzystwa Statystycznego przypominają, że wartość p nie mierzy prawdopodobieństwa, że hipoteza jest prawdziwa, ani wielkości efektu, a wnioski nie powinny zależeć wyłącznie od przekroczenia progu istotności. Greenland i in. (2016) zebrali 25 typowych błędnych interpretacji testów i wartości p i zwracają uwagę, że naruszenie niejawnych założeń analizy – np. wybieranie do raportu analiz na podstawie p – może dać małe p nawet przy prawdziwej hipotezie testowanej. Dlatego obok wyniku testu zawsze podawaj wielkość efektu z przedziałem ufności. Jak omówić w dyskusji wynik nieistotny statystycznie, nie pisząc o „trendzie w kierunku istotności”, pokazujemy w poradniku Jak napisać dyskusję wyników.
Jak opisać wynik testu w pracy (APA)
Opis wyniku testu zawiera nazwę testu, statystyki opisowe, wartość statystyki ze stopniami swobody (jeśli są), dokładne p i wielkość efektu z przedziałem ufności. Dla przykładu z tej strony:
Gotowe zdania dla innych testów znajdziesz w poradniku jak opisać wyniki w stylu APA, a więcej o interpretacji p – w tekście wartość p: co naprawdę oznacza.
Test permutacyjny w R
Kod odtwarza dane z przykładu i wykonuje test w czterech krokach: statystyka, rozkład przy H0 z przetasowań, wartość p i porównanie z klasycznym testem t. Liczby w tekście pochodzą z tego kodu; dokładny test permutacyjny (pakiet coin), d Cohena i rysunek – z pełnego skryptu strony.
Test permutacyjny dla różnicy średnich
R
set.seed(15)                                         # dane symulowane: stres (PSS-10, 0–40)
kontrola <- pmin(pmax(round(rnorm(12, 21, 6)), 0), 40)
trening  <- pmin(pmax(round(rnorm(12, 16.5, 6)), 0), 40)

# 1. Statystyka testowa: różnica średnich
obs <- mean(trening) - mean(kontrola)
obs

# 2. Rozkład statystyki przy H0: losowo przetasowujemy etykiety grup
wyniki <- c(kontrola, trening)
set.seed(2024)
perm <- replicate(10000, {
  g <- sample(24, 12)                                # losowy podział na dwie grupy po 12
  mean(wyniki[g]) - mean(wyniki[-g])
})

# 3. Wartość p: odsetek przetasowań z różnicą co najmniej tak dużą jak obserwowana
sum(abs(perm) >= abs(obs))
mean(abs(perm) >= abs(obs))

# 4. Dla porównania klasyczny test t (rozkład teoretyczny zamiast przetasowań)
t.test(trening, kontrola, var.equal = TRUE)
Wynik w R
[1] -5.5
[1] 297
[1] 0.0297

	Two Sample t-test

data:  trening and kontrola
t = -2.4226, df = 22, p-value = 0.02409
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 -10.2082128  -0.7917872
sample estimates:
mean of x mean of y
 16.66667  22.16667
SPSS
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (dokładny test permutacyjny – pakiet coin); rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- coin (wersja 1.4.3): Hothorn, T., Hornik, K., van de Wiel, M. A., & Zeileis, A. (2006). A Lego system for conditional inference. The American Statistician, 60(3), 257–263. https://doi.org/10.1198/000313006X118430
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Wybór testu po obejrzeniu wyników – kilka testów „na próbę” i raportowanie tego z najmniejszym p zawyża ryzyko fałszywego alarmu.
- „Przyjmujemy hipotezę zerową” – wynik nieistotny nie dowodzi braku efektu; do wykazania, że efekt jest pomijalny, służą testy równoważności.
- Traktowanie p jako prawdopodobieństwa, że H0 jest prawdziwa – p opisuje dane przy założeniu H0, a nie odwrotnie (Wasserstein i Lazar, 2016).
- Test dla prób niezależnych zastosowany do pomiarów powtarzanych – albo odwrotnie; struktura danych decyduje o wyborze testu.
- Sama wartość p bez wielkości efektu – w dużej próbie istotna bywa nawet znikoma różnica.
- Wiele testów bez korekty – przy kilku porównaniach zastosuj korektę na porównania wielokrotne.
Najczęstsze pytania
Co to jest test statystyczny?
To procedura, która sprawdza, czy wyniki z próby dają się pogodzić z hipotezą zerową, np. z brakiem różnicy między grupami. Test liczy statystykę (np. t, F, χ²), porównuje ją z rozkładem, jaki miałaby przy prawdziwej H0, i podaje wartość p. Gdy p jest mniejsze od przyjętego α, odrzucamy H0.
Jak działa test statystyczny krok po kroku?
Najpierw formułujesz H0 i H1 oraz ustalasz α, potem liczysz statystykę testową z danych. Następnie porównujesz ją z rozkładem statystyki przy prawdziwej H0 – teoretycznym albo uzyskanym np. z permutacji – i odczytujesz wartość p. Na końcu podejmujesz decyzję i opisujesz wielkość efektu.
Jak wybrać test statystyczny?
Odpowiedz na cztery pytania: czego dotyczy hipoteza (różnica czy związek), na jakiej skali mierzona jest zmienna zależna, ile grup lub pomiarów porównujesz i czy obserwacje są niezależne. Tabela na tej stronie i poradnik jak dobrać test statystyczny do hipotezy przeprowadzą Cię przez te decyzje.
Na czym polega podział na testy parametryczne i nieparametryczne?
Testy parametryczne (np. test t, ANOVA) zakładają określony rozkład w populacji i dotyczą parametrów, takich jak średnia. Testy nieparametryczne (np. test Manna-Whitneya, test Friedmana) opierają się zwykle na rangach i wymagają słabszych założeń, ale odpowiadają na nieco inne pytania. Więcej w hasłach testy parametryczne i testy nieparametryczne.
Co oznacza wynik istotny statystycznie?
Że przy prawdziwej hipotezie zerowej wynik co najmniej tak skrajny jak uzyskany byłby mało prawdopodobny (p ≤ α). Nie oznacza to, że efekt jest duży ani ważny, i nie mówi, z jakim prawdopodobieństwem prawdziwa jest H0. Dlatego obok p podawaj wielkość efektu z przedziałem ufności.
Co to jest test permutacyjny?
To test, który buduje rozkład statystyki przy H0 z samych danych: wielokrotnie losowo przetasowuje etykiety grup i za każdym razem liczy statystykę. Wartość p to odsetek przetasowań z wynikiem co najmniej tak skrajnym jak obserwowany – w przykładzie 297 z 10 000, czyli p = .030. Nie wymaga założeń o rozkładzie zmiennej.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →PoradnikWartość p: co naprawdę oznacza i jak ją poprawnie interpretować
Wartość p bez mitów: definicja, interpretacja, typowe błędy oraz sposób raportowania wraz z wielkością efektu i przedziałem ufności.
Czytaj →PoradnikStatystyka do pracy licencjackiej: analiza krok po kroku
Jak zaplanować analizę statystyczną do pracy licencjackiej, przygotować ankietę i bazę danych oraz otrzymać wyniki, które da się obronić.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Ernst, M. D. (2004). Permutation methods: A basis for exact inference. Statistical Science, 19(4), 676–685. https://doi.org/10.1214/088342304000000396 ● Otwarty dostęp
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3 ● Otwarty dostęp
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 231(694–706), 289–337. https://doi.org/10.1098/rsta.1933.0009 ● Otwarty dostęp
- Perezgonzalez, J. D. (2015). Fisher, Neyman-Pearson or NHST? A tutorial for teaching data testing. Frontiers in Psychology, 6, Article 223. https://doi.org/10.3389/fpsyg.2015.00223 ● Otwarty dostęp
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108 ● Otwarty dostęp
Cytowania BibTeX
@article{ernst2004permutation, author={Ernst, Michael D.}, title={{Permutation methods: A basis for exact inference}}, journal={Statistical Science}, year={2004}, volume={19}, number={4}, pages={676--685}, doi={10.1214/088342304000000396}}@article{greenland2016statistical, author={Greenland, Sander and Senn, Stephen J. and Rothman, Kenneth J. and Carlin, John B. and Poole, Charles and Goodman, Steven N. and Altman, Douglas G.}, title={{Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations}}, journal={European Journal of Epidemiology}, year={2016}, volume={31}, number={4}, pages={337--350}, doi={10.1007/s10654-016-0149-3}}@article{neyman1933problem, author={Neyman, Jerzy and Pearson, Egon S.}, title={{On the problem of the most efficient tests of statistical hypotheses}}, journal={Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character}, year={1933}, volume={231}, number={694–706}, pages={289--337}, doi={10.1098/rsta.1933.0009}}@article{perezgonzalez2015fisher, author={Perezgonzalez, Jose D.}, title={{Fisher, Neyman-Pearson or NHST? A tutorial for teaching data testing}}, journal={Frontiers in Psychology}, year={2015}, volume={6}, eid={223}, doi={10.3389/fpsyg.2015.00223}}@article{wasserstein2016asa, author={Wasserstein, Ronald L. and Lazar, Nicole A.}, title={{The ASA statement on p-values: Context, process, and purpose}}, journal={The American Statistician}, year={2016}, volume={70}, number={2}, pages={129--133}, doi={10.1080/00031305.2016.1154108}}