Co to jest poprawka Šidáka?
Poprawka Šidáka (ang. Šidák correction, także Dunna–Šidáka) to metoda kontroli łącznego błędu I rodzaju (FWER) przy m testach – jedna z odpowiedzi na problem wielokrotnych porównań. Każdy test ocenia się na poziomie:
αŠ = 1 − (1 − α)1/m, a skorygowane p = 1 − (1 − p)m
Wzór wynika z założenia niezależności: jeśli m niezależnych testów ma poziom αŠ, szansa co najmniej jednego fałszywego odrzucenia wynosi dokładnie α.
Założenie niezależności
Gdy testy są zależne, sam wzór nie gwarantuje kontroli FWER. Šidák (1967) udowodnił jednak, że dla średnich z wielowymiarowego rozkładu normalnego prostokątny obszar ufności zbudowany tak, jakby współrzędne były niezależne, jest zachowawczy przy dowolnej korelacji. Dotyczy to więc testów dwustronnych o statystykach normalnych. Przy innych rodzajach zależności bezpieczniejsza jest korekta Bonferroniego, która działa zawsze.
Przykład w R
Przy sześciu testach próg Šidáka wynosi .00851, a Bonferroniego .00833 – zysk jest symboliczny. Dla p = .0085 skorygowane p wynosi .0499 (Šidák) wobec .051 (Bonferroni), więc decyzja zmienia się tylko na granicy. Poprawka Holma na tych samych sześciu wartościach odrzuca trzy hipotezy, a Šidák – dwie. W symulacji sześciu niezależnych testów FWER wyniósł .051, a przy korelacji .6 – .036.
Na rysunku
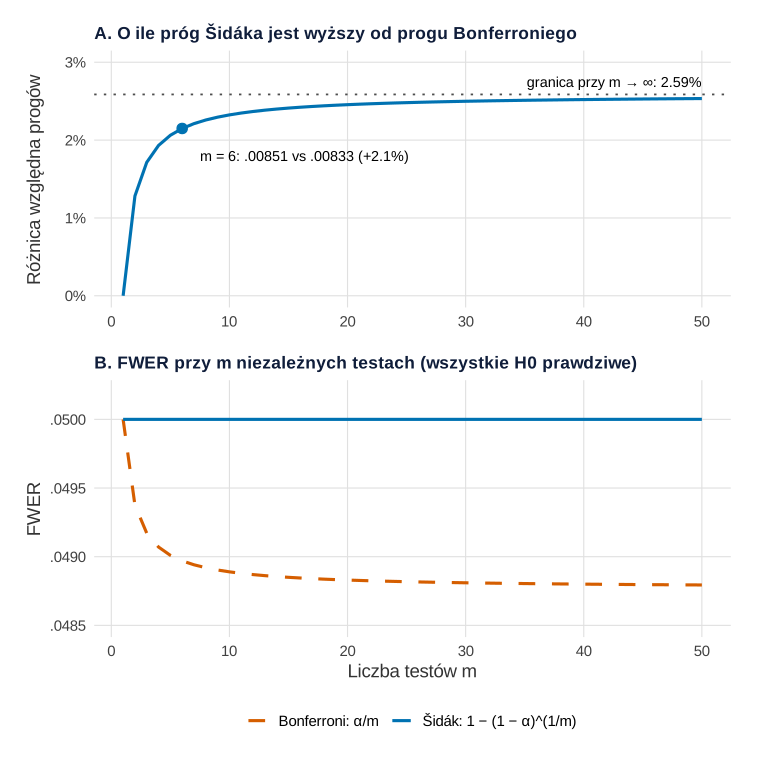
Co widać. Próg Šidáka jest zawsze trochę wyższy niż α/m, ale różnica nigdy nie przekracza 2.59% wartości progu. Przy sześciu testach to .00851 wobec .00833, czyli o 2.1% więcej; przy 50 testach .00103 wobec .00100. Panel B pokazuje, co z tego wynika przy testach niezależnych i prawdziwych hipotezach zerowych. Šidák trzyma FWER dokładnie na .05, a Bonferroni nieco poniżej: .0490 przy sześciu testach i .0488 przy pięćdziesięciu. Różnica to niewiele ponad jeden promil, czyli mniej więcej jedna dodatkowa fałszywa decyzja na tysiąc rodzin testów.
Na co uważać. Oś pionowa panelu B zaczyna się od .0485, więc linie wyglądają na odległe, choć różnią się o ułamek punktu procentowego. Krzywe są policzone ze wzorów przy założeniu niezależności. Przy dodatnio skorelowanych testach obie poprawki są bardziej zachowawcze – w symulacji z przykładu FWER poprawki Šidáka przy korelacji .6 spadło do .036. W praktyce wybór między nimi rzadko zmienia decyzję; większy zysk mocy daje przejście na procedurę krokową, np. Holma. Jak FWER rośnie bez żadnej poprawki, pokazuje wpis Wielokrotne testy w obrazkach.
Podpis do pracy:
Kod R rysunku 1
# Rysunek 1: o ile próg Šidáka jest łagodniejszy od progu Bonferroniego i jaki daje to FWER (testy niezależne)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(bonf = "#D55E00", sidak = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = 13),
        plot.background = element_rect(fill = "white", colour = NA))

alfa <- 0.05
m <- 1:50
progi <- data.frame(m, bonf = alfa / m, sidak = 1 - (1 - alfa)^(1 / m))
progi$wzgl <- 100 * (progi$sidak / progi$bonf - 1)          # o ile % próg Šidáka jest wyższy
# FWER przy m niezależnych testach i prawdziwych H0: P(co najmniej jedno p < próg)
progi$fwer_bonf  <- 1 - (1 - progi$bonf)^m
progi$fwer_sidak <- 1 - (1 - progi$sidak)^m                # z definicji dokładnie α
print(round(progi[m %in% c(2, 6, 10, 20, 50), ], 5), row.names = FALSE)
round(c(granica_wzgl_proc = 100 * (-log(1 - alfa) / alfa - 1),   # m → ∞
        granica_fwer_bonf = 1 - exp(-alfa)), 5)

wyr <- progi[progi$m == 6, ]
pA <- ggplot(progi, aes(m, wzgl)) +
  geom_line(colour = kol[["sidak"]], linewidth = 1.1) +
  geom_hline(yintercept = 100 * (-log(1 - alfa) / alfa - 1), linetype = "dotted", colour = "grey30") +
  annotate("text", x = 50, y = 2.75, hjust = 1, size = 3.8, label = "granica przy m → ∞: 2.59%") +
  geom_point(data = wyr, size = 3.2, colour = kol[["sidak"]]) +
  annotate("text", x = wyr$m + 1.5, y = wyr$wzgl - 0.35, hjust = 0, size = 3.8,
           label = sprintf("m = 6: %s vs %s (+%.1f%%)", sub("^0", "", sprintf("%.5f", wyr$sidak)),
                           sub("^0", "", sprintf("%.5f", wyr$bonf)), wyr$wzgl)) +
  scale_y_continuous(limits = c(0, 3), breaks = 0:3, labels = function(x) paste0(x, "%")) +
  labs(title = "A. O ile próg Šidáka jest wyższy od progu Bonferroniego", x = NULL, y = "Różnica względna progów")
dl <- rbind(data.frame(m, fwer = progi$fwer_bonf,  metoda = "Bonferroni: α/m"),
            data.frame(m, fwer = progi$fwer_sidak, metoda = "Šidák: 1 − (1 − α)^(1/m)"))
pB <- ggplot(dl, aes(m, fwer, colour = metoda, linetype = metoda)) +
  geom_line(linewidth = 1.1) +
  scale_colour_manual(values = unname(kol), name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  scale_y_continuous(limits = c(0.0485, 0.0502), breaks = seq(0.0485, 0.05, 0.0005),
                     labels = function(x) sub("^0", "", sprintf("%.4f", x))) +
  labs(title = "B. FWER przy m niezależnych testach (wszystkie H0 prawdziwe)",
       x = "Liczba testów m", y = "FWER")
p1 <- pA / pB & motyw

p1   # zapis: ggsave("poprawka-sidaka-progi.svg", p1, width = 8, height = 8)
Wynik w R
  m    bonf   sidak    wzgl fwer_bonf fwer_sidak
  2 0.02500 0.02532 1.28226   0.04938       0.05
  6 0.00833 0.00851 2.14934   0.04897       0.05
 10 0.00500 0.00512 2.32394   0.04889       0.05
 20 0.00250 0.00256 2.45515   0.04883       0.05
 50 0.00100 0.00103 2.53399   0.04879       0.05
granica_wzgl_proc granica_fwer_bonf
          2.58659           0.04877
Rysunek na stronie powstał z obiektu p1 z tego kodu z motywem serwisu; dane, geometrie i skale są identyczne. Kod niczego nie losuje – wszystkie wartości pochodzą ze wzorów.
Jak opisać w pracy
Na co uważać
- Mała moc. Šidák jest prawie tak zachowawczy jak Bonferroni. Procedura krokowa Holma kontroluje FWER dla dowolnej kombinacji prawdziwych hipotez (Holm, 1979) i ma większą moc. Gdy wystarczy kontrola odsetka fałszywych odkryć, rozważ procedurę Benjaminiego–Hochberga.
- Brak w
p.adjust(). W R policz ją ręcznie albo użyjadjust = "sidak"w pakiecie emmeans. - Testy rangowe. Po teście Dunna poprawka Šidáka jest częstą opcją.
Porównanie wielu poprawek na jednym zestawie wyników pokazuje wpis Poprawki na wielokrotne porównania.
Poprawka Šidáka w R
Kod porównuje progi Šidáka i Bonferroniego dla różnej liczby testów, koryguje sześć wartości p i symuluje FWER przy testach niezależnych oraz skorelowanych. Liczby w tekście pochodzą z tego kodu.
Progi, skorygowane wartości p i symulacja FWER
R
# Poprawka Šidáka: próg 1 - (1 - alfa)^(1/m) i skorygowane p = 1 - (1 - p)^m
alfa <- 0.05
m <- c(2, 3, 6, 10, 20)
round(data.frame(m, Bonferroni = alfa / m, Sidak = 1 - (1 - alfa)^(1 / m)), 5)
p <- c(0.004, 0.0085, 0.011, 0.020, 0.150, 0.470)   # sześć porównań par
round(cbind(p, Bonferroni = p.adjust(p, "bonferroni"), Sidak = 1 - (1 - p)^length(p),
            Holm = p.adjust(p, "holm")), 4)
# FWER przy 6 testach dwustronnych z (H0 prawdziwe): niezależne vs skorelowane (rho = .6)
set.seed(590)
fwer <- function(rho, reps = 20000) {
  z <- sqrt(rho) * rnorm(reps) + sqrt(1 - rho) * matrix(rnorm(reps * 6), reps)
  pz <- 2 * pnorm(-abs(z))
  mean(apply(pz, 1, min) < 1 - (1 - alfa)^(1 / 6))
}
round(c(niezalezne = fwer(0), rho_0.6 = fwer(0.6)), 3)
Wynik w R
   m Bonferroni   Sidak
1  2    0.02500 0.02532
2  3    0.01667 0.01695
3  6    0.00833 0.00851
4 10    0.00500 0.00512
5 20    0.00250 0.00256
          p Bonferroni  Sidak   Holm
[1,] 0.0040      0.024 0.0238 0.0240
[2,] 0.0085      0.051 0.0499 0.0425
[3,] 0.0110      0.066 0.0642 0.0440
[4,] 0.0200      0.120 0.1142 0.0600
[5,] 0.1500      0.900 0.6229 0.3000
[6,] 0.4700      1.000 0.9778 0.4700
niezalezne    rho_0.6
     0.051      0.036
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietu stats); rysunek wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym poprawka Šidáka różni się od korekty Bonferroniego?
Bonferroni dzieli α przez m, a Šidák liczy 1 − (1 − α)^(1/m), co daje nieco wyższy próg (dla 6 testów .00851 zamiast .00833). Bonferroni działa przy dowolnej zależności testów, a Šidák wymaga niezależności albo szczególnych warunków, np. dwustronnych testów o statystykach normalnych.
Czy poprawkę Šidáka można stosować do testów zależnych?
Wzór wyprowadza się przy niezależności. Dla dwustronnych testów opartych na wielowymiarowym rozkładzie normalnym pozostaje zachowawczy przy dowolnej korelacji (Šidák, 1967); w innych sytuacjach bezpieczniej wybrać Bonferroniego albo Holma.
Jak policzyć poprawkę Šidáka w R?
Funkcja p.adjust() jej nie ma, więc policz 1 - (1 - p)^m ręcznie. Po modelach możesz użyć funkcji pakietu emmeans z argumentem adjust = „sidak”.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Poprawki na wielokrotne porównania
Bonferroni, Holm, Hochberg, BH i BY na jednym przykładzie: co kontroluje każda poprawka, kiedy którą wybrać i jak opisać wynik w pracy.
Czytaj →PoradnikKalkulator poprawek na wielokrotne porównania
Skorygowane p metodami Bonferroniego, Holma, Hochberga, Hommela, Benjaminiego–Hochberga i Benjaminiego–Yekutieliego z wklejonej listy, zgodne z p.adjust() w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Šidák, Z. (1967). Rectangular confidence regions for the means of multivariate normal distributions. Journal of the American Statistical Association, 62(318), 626–633. https://doi.org/10.1080/01621459.1967.10482935
Cytowania BibTeX
@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{sidak1967rectangular, author={Šidák, Zbyněk}, title={{Rectangular confidence regions for the means of multivariate normal distributions}}, journal={Journal of the American Statistical Association}, year={1967}, volume={62}, number={318}, pages={626--633}, doi={10.1080/01621459.1967.10482935}}