Kim była Olive Jean Dunn?
Olive Jean Dunn (1915–2008) urodziła się 1 września 1915 r. – według bazy biograficznej amerykańskich doktorek matematyki prowadzonej przez Margaret Murray – w Winnipeg w Kanadzie. Dyplom i magisterium uzyskała w 1936 r. na Uniwersytecie Kalifornijskim w Los Angeles (UCLA), a doktorat – w sierpniu 1956 r., także w UCLA, u Paula G. Hoela, z rozprawą o problemach estymacji w regresji dla zmiennych zależnych (Murray, b.d.).
Jej kariera naukowa była związana z UCLA i biostatystyką: już pod koniec lat 50. publikowała jako pracowniczka tej uczelni (Dunn, 1959), a przeszła na emeryturę jako profesor biostatystyki i biomatematyki. Pracowała naukowo ponad 40 lat i była członkinią (fellow) American Statistical Association, American Association for the Advancement of Science i American Public Health Association (Dunn i Clark, 2009). Zmarła w styczniu 2008 r. (Murray, b.d.).
Najważniejsze pomysły
- Łączne przedziały ufności (1959). Dunn (1959) szukała przedziałów ufności dla średnich kilku zależnych zmiennych o rozkładzie normalnym, gdy nic nie wiadomo o korelacjach. Najkrótsze okazały się przedziały oparte na rozkładzie t Studenta; metody oparte na T² Hotellinga i przedziałach Scheffégo dawały wyraźnie dłuższe.
- Porównania wielokrotne średnich (1961). W najczęściej cytowanej pracy Dunn (1961) zaproponowała, by z góry wybrać m kontrastów między średnimi i dla każdego zbudować przedział t na poziomie α/m – tak, by łączny poziom ufności był nie mniejszy od założonego. Przy niezbyt dużym m te przedziały są krótsze niż w metodzie Scheffégo i Tukeya. To dzisiejsza korekta Bonferroniego, w części podręczników nazywana metodą Dunna lub Bonferroniego–Dunna (zob. Carlo Emilio Bonferroni).
- Porównania na sumach rang (1964). Dunn (1964) zaproponowała porównywanie par grup na podstawie rang z jednego wspólnego rangowania wszystkich k prób – wygodniej niż osobne rangowanie każdej pary. Podała przybliżenie normalne i sposób postępowania z rangami wiązanymi. To test Dunna, wykonywany po teście Kruskala–Wallisa.
- Podręczniki. Basic Statistics: A Primer for the Biomedical Sciences ukazał się w 1964 r., drugie wydanie w 1977 r., a czwarte – z Virginią A. Clark – w 2009 r.; z Clark napisała też podręcznik analizy wariancji i regresji (Dunn i Clark, 2009).
Ciekawostka
Pracę z 1959 r. Dunn zakończyła otwartym pytaniem: o ile można skrócić łączne przedziały ufności, jeśli coś wiadomo o korelacjach między zmiennymi (Dunn, 1959). Według Wolchover (2017) właśnie w 1959 r., szukając wzoru na łączne przedziały ufności, Dunn postawiła hipotezę nazwaną później nierównością korelacyjną Gaussa: dla skorelowanych zmiennych normalnych szansa, że wszystkie naraz trafią do swoich przedziałów, jest nie mniejsza niż iloczyn szans pojedynczych. Matematycy próbowali ją udowodnić przez dziesięciolecia.
Dowód znalazł dopiero w 2014 r., sześć lat po śmierci Dunn, emerytowany niemiecki statystyk Thomas Royen. Jak opisuje Wolchover (2017), olśnienie przyszło 17 lipca 2014 r., gdy mył zęby. Royen opublikował dowód w mało znanym czasopiśmie i przez kilka lat prawie nikt go nie zauważył.
Przykład na danych z pakietu R
Zbiór genotype z pakietu MASS to – według pliku pomocy – dane z eksperymentu z przybraniem: mioty szczurów odbierano matkom zaraz po urodzeniu i oddawano do wykarmienia matkom zastępczym o jednym z czterech genotypów (A, B, I, J). Zmienną jest średni przyrost masy miotu do 28. dnia (w gramach); źródłem jest podręcznik Scheffégo z 1959 r. Pytamy, czy przyrost zależy od genotypu matki zastępczej. To nasz przykład metody Dunn, nie jej analiza.
Wszystkie 61 miotów rangujemy razem; 12 wyników tworzy 5 grup remisów. Średnie rangi wynoszą 34.56 (A, n = 16), 41.46 (B, n = 14), 29.50 (I, n = 16) i 19.03 (J, n = 15), a mediany przyrostu: 58.20, 59.85, 54.15 i 50.00 g. Test Kruskala–Wallisa z poprawką na remisy daje H(3) = 12.44, p = .006 – to samo co funkcja kruskal.test().
Test Dunna liczymy ręcznie ze wzoru: różnicę średnich rang pary dzielimy przez jej błąd standardowy z poprawką na remisy. Przy czterech grupach jest m = 6 par, więc według pomysłu z 1961 r. każdą porównujemy na poziomie .05/6, co odpowiada progowi |z| = 2.638 zamiast 1.96. Próg przekracza tylko para B–J: z = 3.40, p = .0007, po korekcie Bonferroniego p = .004. Para A–J (z = 2.43, p = .015) bez korekty byłaby „istotna”, po korekcie Bonferroniego p = .090, a Holma p = .075. Pozostałe pary mają |z| poniżej 1.9.
Na rysunku
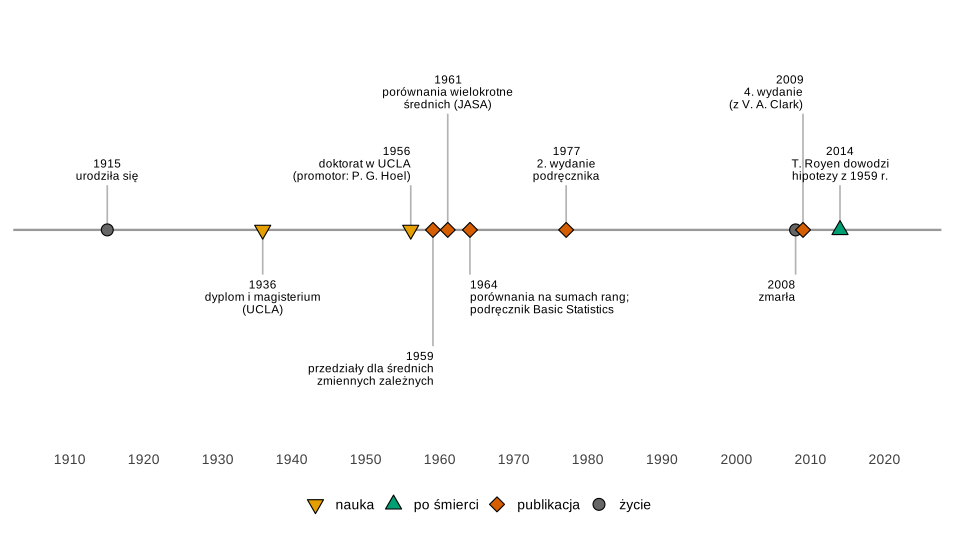
Co widać. Trzy prace, z których Dunn jest znana, ukazały się w ciągu pięciu lat po doktoracie, który obroniła w wieku 40 lat.
Na co uważać. O życiu Dunn wiemy niewiele – nie znaleźliśmy wspomnienia w czasopiśmie naukowym, dlatego oś zawiera głównie daty publikacji. Źródła różnią się co do dnia śmierci (część podaje 12, baza Murray – 15 stycznia 2008 r.), więc podajemy tylko miesiąc.
Podpis do pracy:
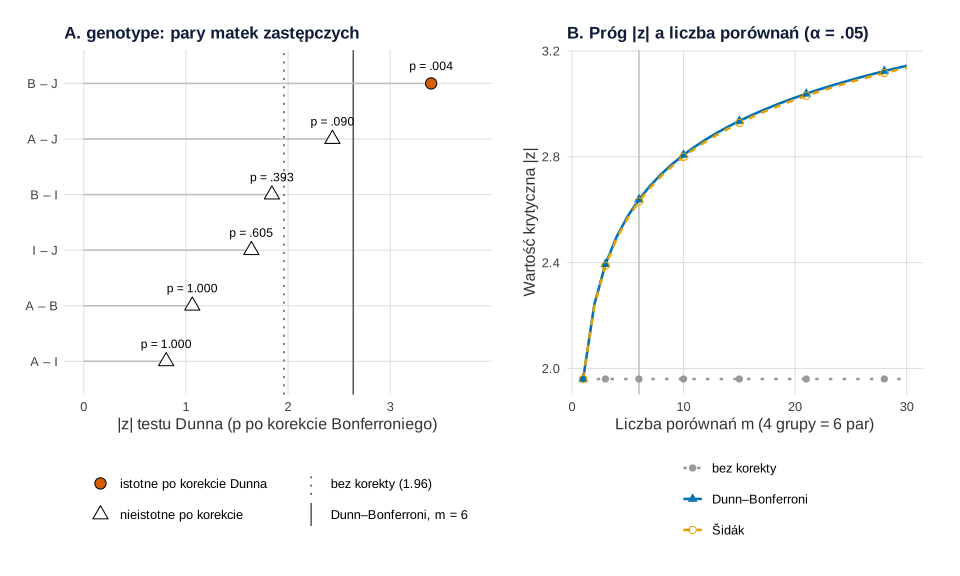
MASS::genotype) i wartości krytyczne przy rosnącej liczbie porównań. Obliczenia i rysunek: R, pakiety ggplot2 i patchwork (bez losowania).Co widać. W panelu A dwie pary leżą za progiem 1.96, ale tylko B–J za progiem po korekcie. Panel B pokazuje cenę pomysłu z 1961 r.: przy 6 porównaniach próg rośnie do 2.64, przy 28 (8 grup) – do ponad 3.1. Poprawka Šidáka jest prawie taka sama, tylko minimalnie łagodniejsza.
Na co uważać. Eksperyment miał dwa czynniki – genotyp matki i genotyp miotu – a test Kruskala–Wallisa bierze pod uwagę tylko jeden. Rangi gubią też odległości w gramach, dlatego w opisie wyniku podaj mediany.
Podpis do pracy:
Gdzie spotkasz Dunn w swojej pracy
Za każdym razem, gdy po istotnym teście ogólnym sprawdzasz, które grupy się różnią:
- po teście Kruskala–Wallisa SPSS, jamovi i pakiety R proponują test Dunna; sprawdź, jaką korektą program poprawił wartości p;
- dzieląc α przez liczbę testów, stosujesz pomysł z 1961 r.; zwykle lepiej użyć poprawki Holma, która kontroluje ten sam błąd przy większej mocy (zob. problem wielokrotnych porównań);
- gdy z góry planujesz kilka porównań zamiast wszystkich par, Dunn (1961) pokazała, że takie przedziały są krótsze – im mniej porównań, tym mniejsza cena za korektę.
Spory, mity i trudne strony
- Dunn czy Dunnett? To dwie różne osoby i dwie różne procedury. Test Dunnetta porównuje kilka grup z jedną grupą kontrolną po analizie wariancji, a test Dunna – pary grup na rangach.
- Bonferroni czy Dunn? Nierówności Bonferroniego powstały w latach 30. XX w., a Dunn (1961) zastosowała je do przedziałów ufności dla porównań średnich. Stąd podwójne nazwy, np. „Bonferroni–Dunn”.
- Test Dunna czy seria testów Manna–Whitneya? Dunn (1964) porównała oba podejścia: w jej teście wszystkie pary korzystają z tych samych rang co test ogólny, a przy osobnych testach Manna–Whitneya każda para jest rangowana od nowa.
Test Dunna ręcznie w R
Kod wczytuje dane genotype, rangi i remisy, liczy test Kruskala–Wallisa z poprawką na remisy (i sprawdza go funkcją kruskal.test()), potem test Dunna dla sześciu par z korektą Bonferroniego i – dla porównania – Holma, a na końcu wartości krytyczne. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje.
1. Kruskal–Wallis i test Dunna: rysunek 2
Kod R rysunku 2
# Dunn (1964): porównania wielokrotne na sumach rang po teście Kruskala–Wallisa – liczone ręcznie (MASS::genotype)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(brak = "#999999", dunn = "#0072B2", sidak = "#E69F00", istotne = "#D55E00")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(genotype, package = "MASS")
# Wt – średni przyrost masy miotu szczurów do 28. dnia (g); Mother – genotyp matki zastępczej (A, B, I, J)
d <- genotype
N <- nrow(d); k <- nlevels(d$Mother)
data.frame(n = c(table(d$Mother)), Me = tapply(d$Wt, d$Mother, median))

# 1. Wspólne rangowanie wszystkich N miotów i średnie rangi grup
d$ranga <- rank(d$Wt)                                   # remisy dostają rangę średnią
n_i <- c(table(d$Mother)); R_sr <- tapply(d$ranga, d$Mother, mean)
round(R_sr, 2)
t_rem <- table(d$Wt); t_rem <- t_rem[t_rem > 1]         # grupy remisów
c(N = N, liczba_grup_remisow = length(t_rem), obserwacje_w_remisach = sum(t_rem))

# 2. Test Kruskala–Wallisa z poprawką na remisy
H0 <- 12 / (N * (N + 1)) * sum(n_i * (R_sr - (N + 1) / 2)^2)
C  <- 1 - sum(t_rem^3 - t_rem) / (N^3 - N)
H  <- H0 / C
round(c(H = H, df = k - 1, p = pchisq(H, k - 1, lower.tail = FALSE)), 4)
kruskal.test(Wt ~ Mother, data = d)$statistic           # kontrola: to samo z funkcji wbudowanej

# 3. Test Dunna: z dla każdej pary ze wspólnych rang, z poprawką na remisy
pary <- t(combn(levels(d$Mother), 2)); m <- nrow(pary)
s2 <- N * (N + 1) / 12 - sum(t_rem^3 - t_rem) / (12 * (N - 1))
wyn <- data.frame(para = paste(pary[, 1], "–", pary[, 2]),
                  roznica = unname(R_sr[pary[, 1]] - R_sr[pary[, 2]]),
                  se = unname(sqrt(s2 * (1 / n_i[pary[, 1]] + 1 / n_i[pary[, 2]]))))
wyn$z <- wyn$roznica / wyn$se
wyn$p <- 2 * pnorm(-abs(wyn$z))
wyn$p_bonferroni <- pmin(1, m * wyn$p)                  # pomysł Dunn: α dzielone na m porównań
wyn$p_holm <- p.adjust(wyn$p, "holm")                    # późniejsza, mocniejsza odmiana (procedura Holma z 1979 r.)
print(transform(wyn, roznica = round(roznica, 2), se = round(se, 2), z = round(z, 3),
                p = round(p, 4), p_bonferroni = round(p_bonferroni, 4), p_holm = round(p_holm, 4)), row.names = FALSE)

# 4. Wartości krytyczne |z| przy α = .05 dla m porównań
alfa <- .05
round(c(m = m, bez_korekty = qnorm(1 - alfa / 2), Dunn_Bonferroni = qnorm(1 - alfa / (2 * m)),
        Sidak = qnorm(1 - (1 - (1 - alfa)^(1 / m)) / 2)), 3)

# Rysunek: A – z Dunna dla sześciu par i progi; B – próg Dunna rośnie z liczbą porównań
wyn$para <- factor(wyn$para, levels = wyn$para[order(abs(wyn$z))])
wyn$wniosek <- ifelse(abs(wyn$z) > qnorm(1 - alfa / (2 * m)), "istotne po korekcie Dunna", "nieistotne po korekcie")
progi <- data.frame(prog = c(qnorm(1 - alfa / 2), qnorm(1 - alfa / (2 * m))),
                    rodzaj = c("bez korekty (1.96)", sprintf("Dunn–Bonferroni, m = %d", m)))
pA <- ggplot(wyn, aes(abs(z), para)) +
  geom_vline(data = progi, aes(xintercept = prog, linetype = rodzaj), colour = "grey35") +
  geom_segment(aes(x = 0, xend = abs(z), yend = para), colour = "grey75") +
  geom_point(aes(shape = wniosek, fill = wniosek), size = 3.6) +
  geom_text(aes(label = paste("p =", sub("^0", "", sprintf("%.3f", p_bonferroni)))), nudge_y = 0.32, size = 3.2) +
  scale_x_continuous(limits = c(0, 3.8)) +
  scale_shape_manual(values = c(21, 24), name = NULL) +
  scale_fill_manual(values = c(kol[["istotne"]], "white"), name = NULL) +
  scale_linetype_manual(values = c("dotted", "solid"), name = NULL) +
  guides(shape = guide_legend(ncol = 1, order = 1), fill = guide_legend(ncol = 1, order = 1),
         linetype = guide_legend(ncol = 1, order = 2)) +
  labs(title = "A. genotype: pary matek zastępczych", x = "|z| testu Dunna (p po korekcie Bonferroniego)", y = NULL) +
  motyw
krzywe <- expand.grid(m = 1:30, metoda = c("bez korekty", "Dunn–Bonferroni", "Šidák"))
krzywe$prog <- with(krzywe, ifelse(metoda == "bez korekty", qnorm(1 - alfa / 2),
                    ifelse(metoda == "Dunn–Bonferroni", qnorm(1 - alfa / (2 * m)),
                           qnorm(1 - (1 - (1 - alfa)^(1 / m)) / 2))))
pB <- ggplot(krzywe, aes(m, prog, colour = metoda, linetype = metoda)) +
  geom_vline(xintercept = m, colour = "grey75") +
  geom_line(linewidth = 0.9) +
  geom_point(data = subset(krzywe, m %in% c(1, 3, 6, 10, 15, 21, 28)), aes(shape = metoda), size = 2.2) +
  scale_colour_manual(values = c(kol[["brak"]], kol[["dunn"]], kol[["sidak"]]), name = NULL) +
  scale_linetype_manual(values = c("dotted", "solid", "22"), name = NULL) +
  scale_shape_manual(values = c(16, 17, 1), name = NULL) +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) +
  labs(title = "B. Próg |z| a liczba porównań (α = .05)", x = "Liczba porównań m (4 grupy = 6 par)",
       y = "Wartość krytyczna |z|") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.2, 1))
p2
Wynik w R
   n    Me
A 16 58.20
B 14 59.85
I 16 54.15
J 15 50.00
    A     B     I     J
34.56 41.46 29.50 19.03
                    N   liczba_grup_remisow obserwacje_w_remisach
                   61                     5                    12
      H      df       p
12.4418  3.0000  0.0060
Kruskal-Wallis chi-squared
                  12.44179
  para roznica   se      z      p p_bonferroni p_holm
 A – B   -6.90 6.50 -1.062 0.2880       1.0000 0.5760
 A – I    5.06 6.28  0.807 0.4198       1.0000 0.5760
 A – J   15.53 6.38  2.434 0.0149       0.0895 0.0746
 B – I   11.96 6.50  1.842 0.0655       0.3930 0.2620
 B – J   22.43 6.60  3.401 0.0007       0.0040 0.0040
 I – J   10.47 6.38  1.641 0.1009       0.6052 0.3026
              m     bez_korekty Dunn_Bonferroni           Sidak
          6.000           1.960           2.638           2.631
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Olive Jean Dunn (1915–2008) – lata według bazy Murray (b.d.), Wolchover (2017) i dat publikacji
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1915, 1936, 1956, 1959, 1961, 1964, 1977, 2008, 2009, 2014),
  opis = c("urodziła się", "dyplom i magisterium\n(UCLA)", "doktorat w UCLA\n(promotor: P. G. Hoel)",
           "przedziały dla średnich\nzmiennych zależnych", "porównania wielokrotne\nśrednich (JASA)",
           "porównania na sumach rang;\npodręcznik Basic Statistics", "2. wydanie\npodręcznika", "zmarła",
           "4. wydanie\n(z V. A. Clark)", "T. Royen dowodzi\nhipotezy z 1959 r."),
  rodzaj = c("życie", "nauka", "nauka", "publikacja", "publikacja", "publikacja", "publikacja", "życie",
             "publikacja", "po śmierci"),
  poziom = c(0.5, -0.5, 0.5, -1.3, 1.3, -0.5, 0.5, -0.5, 1.3, 0.5),   # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.5, 0.5, 1, 1, 0.5, 0, 0.5, 1, 1, 0.5))           # rozsunięcie bliskich etykiet
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "nauka" = 25, "publikacja" = 23, "po śmierci" = 24)
kolory <- c("życie" = "grey40", "nauka" = "#E69F00", "publikacja" = "#D55E00", "po śmierci" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1908, 2022), breaks = seq(1910, 2020, by = 10)) +
  scale_y_continuous(limits = c(-2.2, 2.2)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (rangi, test Kruskala–Wallisa i korekta Holma – funkcje rank(), kruskal.test() i p.adjust() z pakietu stats; dane – pakiet MASS; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim była Olive Jean Dunn?
Amerykańską biostatystyczką (1915–2008) związaną z Uniwersytetem Kalifornijskim w Los Angeles, gdzie w 1956 r. obroniła doktorat u Paula G. Hoela i przeszła na emeryturę jako profesor biostatystyki i biomatematyki. Jest autorką prac o porównaniach wielokrotnych z 1961 i 1964 r. oraz podręcznika Basic Statistics: A Primer for the Biomedical Sciences.
Skąd nazwa test Dunna?
Od pracy Dunn z 1964 r. w Technometrics. Zaproponowała w niej porównywanie par grup na podstawie średnich rang z jednego wspólnego rangowania wszystkich prób, z przybliżeniem normalnym i poprawką na rangi wiązane – dlatego test Dunna wykonuje się po teście Kruskala–Wallisa.
Czy korekta Bonferroniego i metoda Dunna to to samo?
W praktyce tak: dzielenie poziomu α przez liczbę porównań wynika z nierówności Bonferroniego, a Dunn w 1961 r. zastosowała ją do przedziałów ufności dla z góry wybranych porównań średnich. Dlatego część podręczników mówi o metodzie Dunna albo Bonferroniego–Dunna.
Czym różni się test Dunna od testu Dunnetta?
To procedury dwóch różnych autorów. Test Dunna porównuje pary grup na rangach po teście Kruskala–Wallisa, a test Dunnetta porównuje kilka grup eksperymentalnych z jedną grupą kontrolną po analizie wariancji.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Dunn, O. J. (1959). Confidence intervals for the means of dependent, normally distributed variables. Journal of the American Statistical Association, 54(287), 613–621. https://doi.org/10.1080/01621459.1959.10501524
- Dunn, O. J. (1961). Multiple comparisons among means. Journal of the American Statistical Association, 56(293), 52–64. https://doi.org/10.1080/01621459.1961.10482090
- Dunn, O. J. (1964). Multiple comparisons using rank sums. Technometrics, 6(3), 241–252. https://doi.org/10.1080/00401706.1964.10490181
- Dunn, O. J., & Clark, V. A. (2009). Basic statistics: A primer for the biomedical sciences (4th ed.). Wiley.
- Murray, M. A. M. (b.d.). (Olive) Jean Hoover [Ballou] Dunn, UCLA 1956. Women Becoming Mathematicians: U.S. women mathematics PhDs, 1940–1959. Pobrano 20 listopada 2026 z https://womenbecomingmathematicians.net/db/fifties/ucla/dunn1956/ ● Otwarty dostęp
- Wolchover, N. (2017). A long-sought proof, found and almost lost. Quanta Magazine. https://www.quantamagazine.org/statistician-proves-gaussian-correlation-inequality-20170328/ ● Otwarty dostęp
Cytowania BibTeX
@article{dunn1959confidence, author={Dunn, Olive Jean}, title={{Confidence intervals for the means of dependent, normally distributed variables}}, journal={Journal of the American Statistical Association}, year={1959}, volume={54}, number={287}, pages={613--621}, doi={10.1080/01621459.1959.10501524}}@article{dunn1961multiple, author={Dunn, Olive Jean}, title={{Multiple comparisons among means}}, journal={Journal of the American Statistical Association}, year={1961}, volume={56}, number={293}, pages={52--64}, doi={10.1080/01621459.1961.10482090}}@article{dunn1964multiple, author={Dunn, Olive Jean}, title={{Multiple comparisons using rank sums}}, journal={Technometrics}, year={1964}, volume={6}, number={3}, pages={241--252}, doi={10.1080/00401706.1964.10490181}}@book{dunn2009basic, author={Dunn, Olive Jean and Clark, Virginia A.}, title={{Basic statistics: A primer for the biomedical sciences}}, year={2009}, edition={4}, publisher={Wiley}, url={https://www.wiley-vch.de/en/areas-interest/mathematics-statistics/statistics-16st/biostatistics-16st3/basic-statistics-978-0-470-24879-9}}@misc{murraybddunn, author={Murray, Margaret A. M.}, title={{(Olive) Jean Hoover [Ballou] Dunn, UCLA 1956}}, howpublished={Women Becoming Mathematicians: U.S. women mathematics PhDs, 1940–1959}, url={https://womenbecomingmathematicians.net/db/fifties/ucla/dunn1956/}}@misc{wolchover2017long, author={Wolchover, Natalie}, title={{A long-sought proof, found and almost lost}}, howpublished={Quanta Magazine}, year={2017}, publisher={Simons Foundation}, url={https://www.quantamagazine.org/statistician-proves-gaussian-correlation-inequality-20170328/}}