Kim był Harold Hotelling?
Harold Hotelling (1895–1973) był amerykańskim statystykiem i ekonomistą matematycznym. Urodził się 29 września 1895 r. Zaczynał od dziennikarstwa: w 1919 r. uzyskał licencjat z tej dziedziny na University of Washington. Potem studiował matematykę w Princeton i w 1924 r. obronił tam doktorat z topologii. Pracował w Food Research Institute w Stanford, a od 1927 r. był profesorem matematyki na tym uniwersytecie. W 1929 r. spędził pół roku w rolniczej stacji badawczej Rothamsted w Wielkiej Brytanii, ucząc się u Ronalda Fishera (Arrow i Lehmann, 2005).
W 1931 r. przeszedł na wydział ekonomii Uniwersytetu Columbia i przez około 15 lat budował tam program statystyki. Dzięki grantowi Carnegie Corporation zatrudniał asystentów naukowych, m.in. Abrahama Walda i Henry’ego B. Manna. W czasie II wojny światowej przekonał wojsko do utworzenia na Columbii grupy badań statystycznych i został jej dyrektorem. Gdy uczelnia odmówiła utworzenia samodzielnego wydziału statystyki, w 1946 r. przeniósł się do Chapel Hill i zbudował na Uniwersytecie Karoliny Północnej wydział statystyki matematycznej. Przeszedł na emeryturę w 1966 r. i zmarł w Chapel Hill 26 grudnia 1973 r. Wśród jego uczniów byli Samuel Wilks, W. Allen Wallis i Jacob Wolfowitz (Arrow i Lehmann, 2005).
Najważniejsze pomysły
- T² Hotellinga (1931). Uogólnienie ilorazu Studenta na kilka zmiennych naraz (Hotelling, 1931) – test równości wektorów średnich, dziś opisany w haśle T² Hotellinga i będący najprostszym przypadkiem MANOVA. Arrow i Lehmann (2005) podkreślają, że ta sama praca daje obszary ufności dla wektora średnich.
- Główne składowe (1933). W artykule w Journal of Educational Psychology Hotelling (1933) rozłożył zespół zmiennych statystycznych na główne składowe – nieskorelowane kombinacje liniowe, które po kolei wyjaśniają jak najwięcej wariancji. To analiza głównych składowych.
- Korelacja kanoniczna (1936). W pracy o związkach między dwoma zestawami zmiennych Hotelling (1936) szuka par kombinacji liniowych o największej korelacji – to korelacja kanoniczna.
- Pasmo ufności dla prostej regresji (1929). Z Holbrookiem Workingiem opisał niepewność całej linii trendu (Working i Hotelling, 1929); stąd nazwa pasma Workinga–Hotellinga.
- Ekonomia. W modelu konkurencji przestrzennej z 1929 r. firmy skupiają się pośrodku rynku; później powiązano go z twierdzeniem o wyborcy medianowym. W pracy z 1931 r. o zasobach wyczerpywalnych nadwyżka ceny surowca nad kosztem wydobycia rośnie w tempie stopy procentowej (Arrow i Lehmann, 2005).
- Nauczanie statystyki. Hotelling uważał za ważne, by amerykańscy statystycy poznali prace Fishera, i pisał o tym, jak statystykę organizować i uczyć na uniwersytetach (Arrow i Lehmann, 2005).
Przykład na historycznych danych
Hotelling opublikował pracę o głównych składowych w czasopiśmie psychologii wychowawczej, więc przykład dotyczy testów. Zbiór ability.cov z pakietu datasets to macierz kowariancji sześciu testów zdolności rozwiązanych przez 112 osób: ogólny test niewerbalny Cattella, uzupełnianie obrazków, klocki, labirynty, czytanie ze zrozumieniem i słownictwo. Plik pomocy (?ability.cov) podaje jako źródło książkę Bartholomew (1987) i zaznacza, że podane tam macierze kowariancji i korelacji są ze sobą niezgodne.
Na macierzy korelacji pierwsza składowa ma wartość własną 3.08 i wyjaśnia 51.3% wariancji, druga 1.14 i 19.0%; razem 70.3%. Tylko te dwie przekraczają 1 (kryterium Kaisera). Wszystkie testy korelują z pierwszą składową dodatnio, od .50 (labirynty) do .83 (test ogólny) – to ogólny poziom wyników. Druga składowa przeciwstawia testy werbalne (czytanie −.54, słownictwo −.53) testom wykonaniowym (uzupełnianie obrazków .44, klocki .43, labirynty .43). Gdy policzyć PCA na kowariancjach, pierwsza składowa wyjaśnia 62.1% wariancji, ale największe wagi (.63) mają klocki i słownictwo – testy o największej wariancji surowych wyników.
Na rysunku
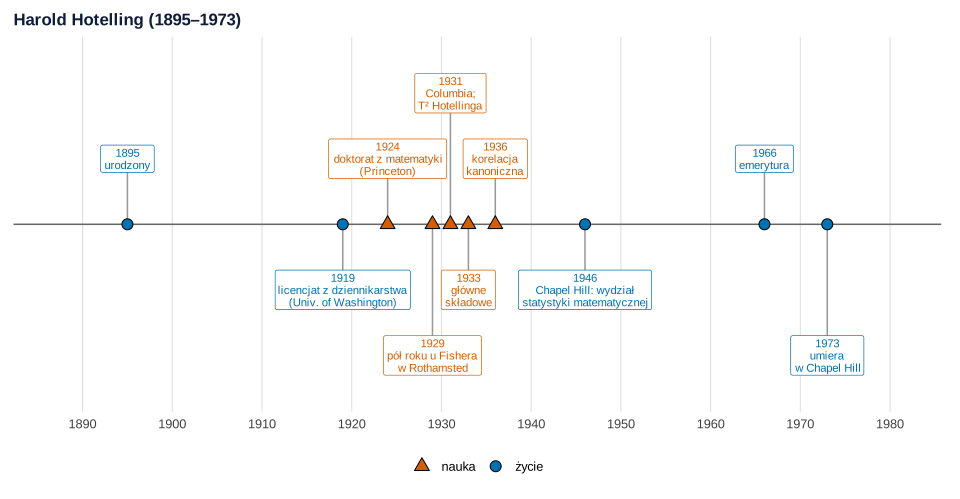
Co widać. Wszystkie trzy wielkie metody wielowymiarowe – T², główne składowe i korelacja kanoniczna – powstały w ciągu pięciu lat, tuż po pobycie u Fishera i w pierwszych latach na Columbii. Druga połowa kariery to budowanie wydziałów i kształcenie statystyków.
Na co uważać. Oś pokazuje wybrane zdarzenia; pomija prace ekonomiczne (1929, 1931), pasmo Workinga–Hotellinga (1929) i wojenną grupę badań statystycznych, żeby etykiety się nie nakładały.
Podpis do pracy:
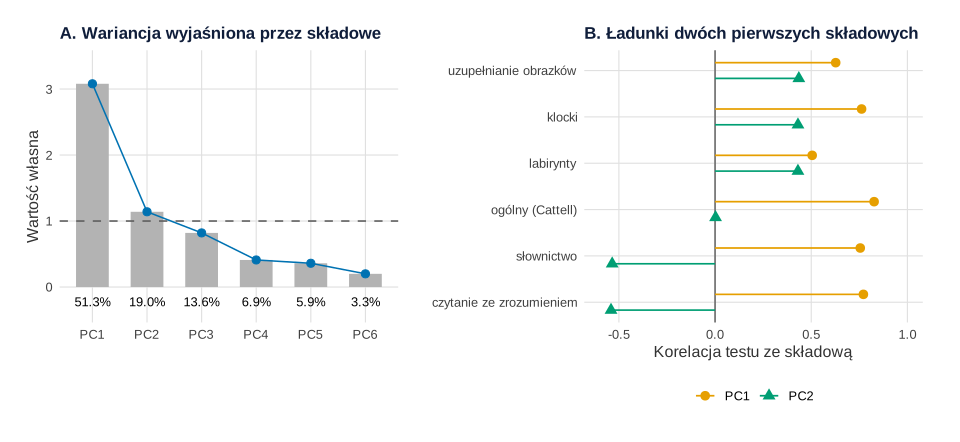
datasets::ability.cov. Rysunek: R, pakiety ggplot2 i patchwork.Co widać. Jedna składowa wyraźnie dominuje (panel A), a druga dzieli testy na dwie grupy (panel B): słownictwo i czytanie po jednej stronie, zadania na materiale obrazkowym i przestrzennym po drugiej. Test ogólny ma na drugiej składowej ładunek bliski zera – koreluje podobnie z testami obu grup.
Na co uważać. Główne składowe to kombinacje zmiennych, nie ukryte zdolności – do pytań o czynniki latentne służy analiza czynnikowa (zob. PCA czy analiza czynnikowa?). Znak składowej jest umowny, a wynik zależy od tego, czy liczysz na korelacjach, czy na kowariancjach.
Podpis do pracy:
Gdzie spotkasz Hotellinga w swojej pracy
Gdy redukujesz liczbę zmiennych przed regresją albo budujesz wskaźnik z kilku pozycji, używasz PCA, a liczbę składowych wybierasz na wykresie osypiska lub kryterium Kaisera. Gdy porównujesz dwie grupy na kilku zmiennych zależnych naraz, liczysz T² Hotellinga lub MANOVA. Gdy łączysz dwa zestawy zmiennych, np. skale osobowości i wyniki w nauce, sięgasz po korelację kanoniczną – krok po kroku pokazuje ją wpis Korelacja kanoniczna krok po kroku. Z T² blisko spokrewniona jest odległość Mahalanobisa, nazwana od Prasanty Chandry Mahalanobisa.
Spory, mity i trudne strony
Kto wymyślił PCA? Pierwszeństwo idei ma Karl Pearson, który w 1901 r. opisał proste i płaszczyzny najlepiej dopasowane do układu punktów w przestrzeni (Pearson, 1901). Nazwa „główne składowe” (principal components) pochodzi z tytułu pracy Hotellinga z 1933 r. W pracy dyplomowej dobrze jest więc cytować obie prace albo podręcznik.
Model z błędem. Arrow i Lehmann (2005) zauważają, że rozumowanie Hotellinga w modelu konkurencji przestrzennej zawierało błąd wskazany około 50 lat później.
Hotelling w R
Kod rysuje oś czasu (rysunek 1) i liczy główne składowe sześciu testów zdolności: zamienia kowariancje na korelacje, wyznacza wartości własne i ładunki, a na końcu dla porównania powtarza analizę na kowariancjach. Funkcja prcomp() wymaga surowych danych, a tu mamy tylko macierz, dlatego używamy eigen(). Rysunki na stronie powstały z tych samych obiektów p1 i p2 z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
Oś czasu i główne składowe testów zdolności
Kod R rysunków 1 i 2
# Harold Hotelling: oś czasu (rysunek 1) i główne składowe sześciu testów zdolności (rysunek 2)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c(zycie = "#0072B2", nauka = "#D55E00", pc1 = "#E69F00", pc2 = "#009E73")  # Okabe–Ito
motyw <- theme_minimal(base_size = 12) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")

# Rysunek 1. Oś czasu (lata ze wspomnienia Arrowa i Lehmanna oraz z prac Hotellinga)
os <- data.frame(
  rok = c(1895, 1919, 1924, 1929, 1931, 1933, 1936, 1946, 1966, 1973),
  opis = c("urodzony", "licencjat z dziennikarstwa\n(Univ. of Washington)", "doktorat z matematyki\n(Princeton)",
           "pół roku u Fishera\nw Rothamsted", "Columbia;\nT² Hotellinga", "główne\nskładowe", "korelacja\nkanoniczna",
           "Chapel Hill: wydział\nstatystyki matematycznej", "emerytura", "umiera\nw Chapel Hill"),
  rodzaj = c("życie", "życie", "nauka", "nauka", "nauka", "nauka", "nauka", "życie", "życie", "życie"),
  y = c(1, -1, 1, -2, 2, -1, 1, -1, 1, -2))          # wysokości etykiet, żeby się nie nakładały
p1 <- ggplot(os) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_segment(aes(x = rok, xend = rok, y = 0, yend = y), colour = "grey60") +
  geom_point(aes(rok, 0, shape = rodzaj, fill = rodzaj), size = 3.5) +
  geom_label(aes(rok, y, label = paste0(rok, "\n", opis), colour = rodzaj), size = 3, lineheight = 0.9, linewidth = 0.25) +
  scale_shape_manual(values = c("życie" = 21, nauka = 24), name = NULL) +
  scale_fill_manual(values = c("życie" = oi[["zycie"]], nauka = oi[["nauka"]]), name = NULL) +
  scale_colour_manual(values = c("życie" = oi[["zycie"]], nauka = oi[["nauka"]]), guide = "none") +
  scale_x_continuous(breaks = seq(1890, 1980, 10), limits = c(1887, 1981)) +
  scale_y_continuous(limits = c(-2.6, 2.6), breaks = NULL) +
  labs(x = NULL, y = NULL, title = "Harold Hotelling (1895–1973)") + motyw

# Rysunek 2. PCA na macierzy korelacji sześciu testów zdolności (112 osób)
data(ability.cov, package = "datasets")
R <- cov2cor(ability.cov$cov)
cat("Macierz korelacji testów (n =", ability.cov$n.obs, "):\n"); print(round(R, 2))
e <- eigen(R)
wariancja <- data.frame(skladowa = paste0("PC", 1:6), wartosc_wlasna = round(e$values, 2),
                        procent = round(100 * e$values / sum(e$values), 1),
                        skumulowany = round(100 * cumsum(e$values) / sum(e$values), 1))
print(wariancja, row.names = FALSE)
V <- e$vectors %*% diag(sign(colSums(e$vectors)))  # znak składowej jest umowny: suma wag dodatnia
ladunki <- V[, 1:2] %*% diag(sqrt(e$values[1:2]))       # ładunki = korelacje testu ze składową
dimnames(ladunki) <- list(rownames(R), c("PC1", "PC2"))
cat("Ładunki (korelacje testów z dwiema pierwszymi składowymi):\n"); print(round(ladunki, 2))
e_cov <- eigen(ability.cov$cov)                         # dla porównania: PCA na kowariancjach (surowe jednostki)
cat("PC1 z macierzy kowariancji wyjaśnia", round(100 * e_cov$values[1] / sum(e_cov$values), 1),
    "% wariancji; wagi:", paste(rownames(R), round(abs(e_cov$vectors[, 1]), 2), sep = " = ", collapse = ", "), "\n")

d_war <- transform(wariancja, skladowa = factor(skladowa, levels = skladowa))
pa <- ggplot(d_war, aes(skladowa, wartosc_wlasna)) +
  geom_col(fill = "grey70", width = 0.6) +
  geom_line(aes(group = 1), colour = oi[["zycie"]]) + geom_point(colour = oi[["zycie"]], size = 2.5) +
  geom_hline(yintercept = 1, linetype = "dashed", colour = "grey35") +
  geom_text(aes(y = -0.22, label = sprintf("%.1f%%", procent)), size = 3.4) +
  scale_y_continuous(limits = c(-0.35, 3.4), breaks = 0:3) +
  labs(title = "A. Wariancja wyjaśniona przez składowe", x = NULL, y = "Wartość własna") + motyw
nazwy <- c(general = "ogólny (Cattell)", picture = "uzupełnianie obrazków", blocks = "klocki",
           maze = "labirynty", reading = "czytanie ze zrozumieniem", vocab = "słownictwo")
kolej <- rownames(R)[order(ladunki[, 2])]                  # testy posortowane według ładunku na PC2
d_lad <- data.frame(test = rep(rownames(R), 2), skladowa = rep(c("PC1", "PC2"), each = 6), ladunek = c(ladunki))
d_lad$y <- match(d_lad$test, kolej) + ifelse(d_lad$skladowa == "PC1", 0.17, -0.17)
pb <- ggplot(d_lad, aes(ladunek, y, colour = skladowa, shape = skladowa)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_segment(aes(x = 0, xend = ladunek, yend = y), linewidth = 0.6) +
  geom_point(size = 3) +
  scale_colour_manual(values = c(PC1 = oi[["pc1"]], PC2 = oi[["pc2"]]), name = NULL) +
  scale_shape_manual(values = c(PC1 = 16, PC2 = 17), name = NULL) +
  scale_y_continuous(breaks = 1:6, labels = nazwy[kolej]) + scale_x_continuous(limits = c(-0.6, 1)) +
  labs(title = "B. Ładunki dwóch pierwszych składowych", x = "Korelacja testu ze składową", y = NULL) + motyw
p2 <- pa + pb
p1
p2
Wynik w R
Macierz korelacji testów (n = 112 ):
        general picture blocks maze reading vocab
general    1.00    0.47   0.55 0.34    0.58  0.51
picture    0.47    1.00   0.57 0.19    0.26  0.24
blocks     0.55    0.57   1.00 0.45    0.35  0.36
maze       0.34    0.19   0.45 1.00    0.18  0.22
reading    0.58    0.26   0.35 0.18    1.00  0.79
vocab      0.51    0.24   0.36 0.22    0.79  1.00
 skladowa wartosc_wlasna procent skumulowany
      PC1           3.08    51.3        51.3
      PC2           1.14    19.0        70.3
      PC3           0.82    13.6        83.9
      PC4           0.41     6.9        90.8
      PC5           0.36     5.9        96.7
      PC6           0.20     3.3       100.0
Ładunki (korelacje testów z dwiema pierwszymi składowymi):
         PC1   PC2
general 0.83  0.00
picture 0.63  0.44
blocks  0.76  0.43
maze    0.50  0.43
reading 0.77 -0.54
vocab   0.75 -0.53
PC1 z macierzy kowariancji wyjaśnia 62.1 % wariancji; wagi: general = 0.23, picture = 0.08, blocks = 0.63, maze = 0.09, reading = 0.37, vocab = 0.63
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (macierz korelacji i wartości własne – funkcje bazowe cov2cor() i eigen(); rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Harold Hotelling?
Amerykańskim statystykiem i ekonomistą matematycznym (1895–1973). Wykładał w Stanford, na Columbii i w Chapel Hill, gdzie zbudował wydział statystyki matematycznej. Od niego pochodzą T² Hotellinga, analiza głównych składowych w obecnej postaci i korelacja kanoniczna.
Czy Hotelling wymyślił analizę głównych składowych?
Nie jako pierwszy. Prostą i płaszczyznę najlepiej dopasowaną do chmury punktów opisał Karl Pearson w 1901 r. Hotelling w 1933 r. rozwinął metodę dla zbioru skorelowanych zmiennych, np. wyników testów, i od jego pracy pochodzi nazwa „główne składowe”.
Skąd się wzięła nazwa T² Hotellinga?
Od pracy Hotellinga z 1931 r., która uogólnia iloraz Studenta – statystykę t – na kilka zmiennych naraz. T² porównuje wektory średnich, a w przypadku jednej zmiennej sprowadza się do kwadratu statystyki t.
Dlaczego ekonomiści znają Hotellinga?
Z modelu konkurencji przestrzennej z 1929 r., w którym firmy skupiają się pośrodku rynku, oraz z pracy z 1931 r. o zasobach wyczerpywalnych. Wynika z niej reguła Hotellinga: nadwyżka ceny surowca nad kosztem wydobycia rośnie w tempie stopy procentowej.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
PCA czy analiza czynnikowa?
Kiedy redukcja danych, a kiedy model konstruktu: tabela „kiedy która” i porównanie PCA z EFA na tych samych danych w R – ładunki, korelacje i wyniki osób.
Czytaj →PoradnikKorelacja kanoniczna krok po kroku
Testy kolejnych par (Wilks, Bartlett, F Rao), wagi a ładunki z supresją, redundancja, liczebność próby i tabela APA – z danymi i kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Arrow, K. J., & Lehmann, E. L. (2005). Harold Hotelling 1895–1973. In Biographical memoirs (Vol. 87) (pp. 220–233). National Academies Press. https://www.nationalacademies.org/read/11522/chapter/13 ● Otwarty dostęp
- Hotelling, H. (1931). The generalization of Student’s ratio. The Annals of Mathematical Statistics, 2(3), 360–378. https://doi.org/10.1214/aoms/1177732979 ● Otwarty dostęp
- Hotelling, H. (1933). Analysis of a complex of statistical variables into principal components. Journal of Educational Psychology, 24(6), 417–441. https://doi.org/10.1037/h0071325
- Hotelling, H. (1936). Relations between two sets of variates. Biometrika, 28(3–4), 321–377. https://doi.org/10.1093/biomet/28.3-4.321
- Pearson, K. (1901). On lines and planes of closest fit to systems of points in space. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 2(11), 559–572. https://doi.org/10.1080/14786440109462720
- Working, H., & Hotelling, H. (1929). Applications of the theory of error to the interpretation of trends. Journal of the American Statistical Association, 24(165A), 73–85. https://doi.org/10.1080/01621459.1929.10506274
Cytowania BibTeX
@incollection{arrow2005hotelling, author={Arrow, Kenneth J. and Lehmann, Erich L.}, title={{Harold Hotelling 1895–1973}}, booktitle={Biographical memoirs (Vol. 87)}, year={2005}, pages={220--233}, publisher={National Academies Press}, url={https://www.nationalacademies.org/read/11522/chapter/13}}@article{hotelling1931generalization, author={Hotelling, Harold}, title={{The generalization of Student’s ratio}}, journal={The Annals of Mathematical Statistics}, year={1931}, volume={2}, number={3}, pages={360--378}, doi={10.1214/aoms/1177732979}}@article{hotelling1933analysis, author={Hotelling, Harold}, title={{Analysis of a complex of statistical variables into principal components}}, journal={Journal of Educational Psychology}, year={1933}, volume={24}, number={6}, pages={417--441}, doi={10.1037/h0071325}}@article{hotelling1936relations, author={Hotelling, Harold}, title={{Relations between two sets of variates}}, journal={Biometrika}, year={1936}, volume={28}, number={3–4}, pages={321--377}, doi={10.1093/biomet/28.3-4.321}}@article{pearson1901lines, author={Pearson, Karl}, title={{On lines and planes of closest fit to systems of points in space}}, journal={The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science}, year={1901}, volume={2}, number={11}, pages={559--572}, doi={10.1080/14786440109462720}}@article{working1929applications, author={Working, Holbrook and Hotelling, Harold}, title={{Applications of the theory of error to the interpretation of trends}}, journal={Journal of the American Statistical Association}, year={1929}, volume={24}, number={165A}, pages={73--85}, doi={10.1080/01621459.1929.10506274}}