Kim był Prasanta Chandra Mahalanobis?
Prasanta Chandra Mahalanobis (1893–1972) był indyjskim fizykiem wykształconym w Cambridge, który stał się jednym z twórców statystyki w Azji (Bera, 2003). Od 1922 roku był profesorem fizyki w Presidency College w Kalkucie i uczył fizyki przez ponad 30 lat (Rao, 1973). W 1931 roku założył Indyjski Instytut Statystyczny (ISI), a także czasopismo Sankhyā (Bera, 2003; Rao, 1973).
W ISI wyrosło pokolenie statystyków. Jednym z nich był C. R. Rao, którego Mahalanobis przyjął do sekcji szkoleniowej Instytutu od 1 stycznia 1941 roku (Bera, 2003) i który napisał później jego wspomnienie biograficzne dla Royal Society (Rao, 1973). Mahalanobis był honorowym doradcą statystycznym rządu Indii i członkiem Komisji Planowania. Zmarł 28 czerwca 1972 roku w Kalkucie, dzień przed 79. urodzinami, wciąż kierując Instytutem (Rao, 1973).
Najważniejsze pomysły
- Uogólniona odległość D². W 1936 roku opisał miarę odległości w wielu zmiennych naraz, uwzględniającą ich wariancje i korelacje (Mahalanobis, 1936/2018). To odległość Mahalanobisa; wzór, próg z rozkładu χ² i wykrywanie nietypowych osób opisuje osobne hasło. Tu pokazujemy odległość między grupami.
- Duże badania próbkowe. W pracy z 1944 roku pokazał, jak dobrać wielkość i liczbę jednostek próby, by przy danym koszcie uzyskać największą precyzję. Przy szacowaniu powierzchni upraw juty w Bengalu w latach 1941–1942 margines błędu wyniósł około 2%, a koszt – jedną piętnastą kosztu pełnego spisu (Mahalanobis, 1944).
- Próby przenikające się (ang. interpenetrating sub-samples). Z populacji pobiera się według tego samego planu kilka podprób; każda daje własne oszacowanie, a z ich rozrzutu liczy się błąd standardowy. Przedział od najmniejszego do największego z s niezależnych oszacowań obejmuje prawdziwą wartość z prawdopodobieństwem 1 − 2(1/2)s, czyli 0.875 dla s = 4. Metodę stosowano m.in. w ogólnokrajowym badaniu próbkowym Indii, National Sample Survey (Kordos i Zięba, 2010).
Przykład na historycznych danych
Dane iris z pakietu datasets to pomiary 150 kwiatów, po 50 z trzech gatunków irysów, zebrane przez Edgara Andersona i opublikowane przez Ronalda Fishera w 1936 roku – tym samym, w którym ukazała się praca Mahalanobisa. Odległość między środkami gatunków liczymy dwa razy: jako euklidesową w jednostkach odchylenia standardowego (pomija korelacje) i jako odległość Mahalanobisa D z połączoną macierzą kowariancji wewnątrz gatunków.
Długość i szerokość działki kielicha korelują wewnątrz gatunków na poziomie .53. Dla setosy i versicolor odległość euklidesowa wynosi 2.65 SD, a D = 3.86: setosa ma działki krótsze, ale szersze, czyli różni się „w poprzek” korelacji. Dla versicolor i virginica jest odwrotnie – 1.40 SD wobec D = 1.27, bo virginica ma działki i dłuższe, i szersze.
Przy wielowymiarowym rozkładzie normalnym i równych macierzach kowariancji najlepsza reguła klasyfikacji myli dwie grupy z prawdopodobieństwem Φ(−D/2). Dla versicolor i virginica to 26.3% przy dwóch zmiennych; po dodaniu wymiarów płatka D rośnie do 4.15 (D² = 17.20), a błąd spada do 1.9%. Na tym opiera się analiza dyskryminacyjna, a D² między średnimi dwóch grup jest częścią statystyki T² Hotellinga.
Na rysunku
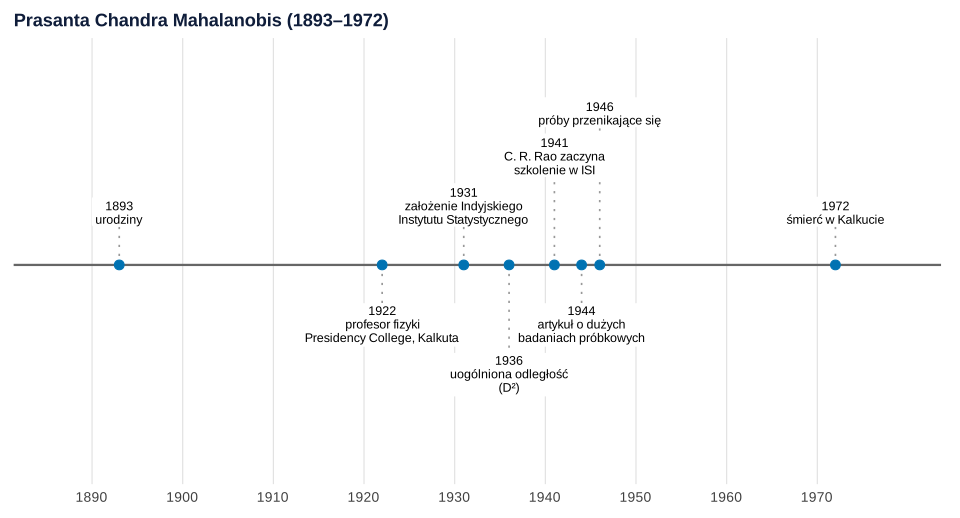
Co widać. Prace statystyczne Mahalanobisa skupiają się w latach 1931–1946, od założenia Instytutu do opisu prób przenikających się. Wcześniej był przede wszystkim fizykiem.
Na co uważać. Oś pokazuje tylko daty potwierdzone w cytowanych źródłach. Rok 1946 to rok pracy Mahalanobisa, na którą jako źródło metody powołują się Kordos i Zięba (2010).
Podpis do pracy:
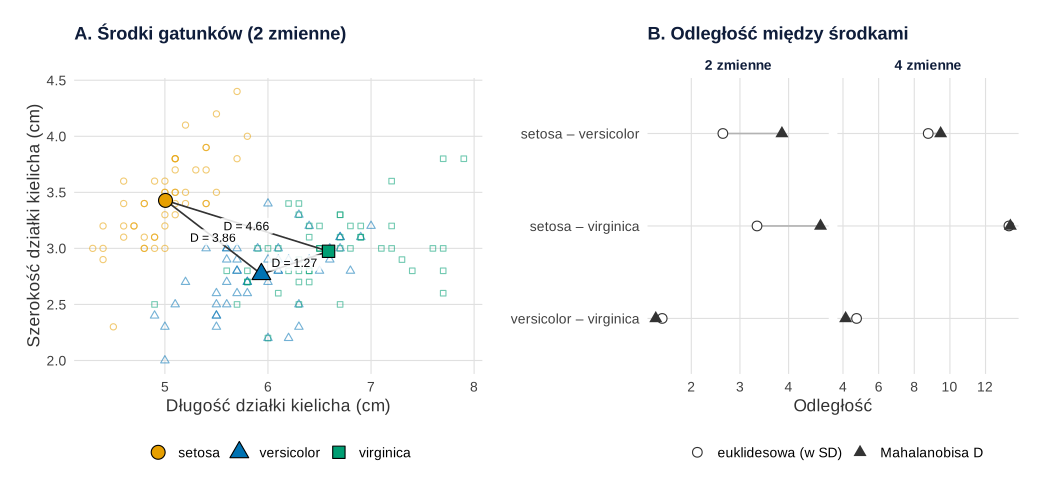
iris, pakiet datasets).Co widać. W każdym gatunku dłuższe działki są zwykle szersze. Setosa leży „pod prąd” tej zależności, więc jej odległości D od pozostałych gatunków są większe niż euklidesowe; para versicolor–virginica różni się zgodnie z korelacją, więc D jest mniejsze. Przy czterech zmiennych obie miary rosną, bo wymiary płatka silnie rozdzielają gatunki.
Na co uważać. D zakłada wspólną macierz kowariancji we wszystkich grupach, a chmura setosy ma inny kształt niż pozostałe – dla par z setosą wynik jest przybliżeniem. Wartości D z różnej liczby zmiennych nie są wprost porównywalne: dodanie zmiennej nie może zmniejszyć D².
Podpis do pracy:
Gdzie spotkasz Mahalanobisa w swojej pracy
- Przesiewanie danych. D² służy do szukania obserwacji odstających w wielu zmiennych przed regresją, MANOVA czy SEM – krok po kroku pokazuje to poradnik wartości odstające: jak je wykryć.
- Porównanie grup w wielu zmiennych. Odległość między środkami grup stoi za analizą dyskryminacyjną i testem T² – zob. hasło o Haroldzie Hotellingu.
- Duże badania sondażowe. Próby przenikające się stosowano w Badaniu Budżetów Gospodarstw Domowych GUS do szacowania błędów standardowych w latach 1970–1999, a w BAEL w latach 1992–1999 (Kordos i Zięba, 2010). Jak błąd losowania łączy się z innymi błędami badania, opisują hasło margines błędu w sondażu i wpis o całkowitym błędzie badania sondażowego.
- Kontrola pracy ankieterów. Gdy podpróby realizują różni ankieterzy, porównanie podprób ujawnia efekt ankietera i błędy w przetwarzaniu danych (Kordos i Zięba, 2010).
Spory i trudne strony
Mahalanobis nie miał formalnego wykształcenia ekonomicznego, a mimo to współtworzył drugi plan pięcioletni Indii. Jako członek Komisji Planowania przekonał do dużych inwestycji w przemysł ciężki; według Rao (1973) przyspieszyło to industrializację, ale rolnictwo przejściowo na tym ucierpiało.
Częste nieporozumienie dotyczy samej odległości: kojarzy się ją tylko z usuwaniem „dziwnych” obserwacji. Tymczasem to ogólna miara różnicy w wielu zmiennych – między osobą a środkiem próby albo między dwiema grupami.
Odległość Mahalanobisa między grupami w R
Kod liczy środki gatunków, połączoną macierz kowariancji wewnątrz gatunków i dla każdej pary gatunków odległość euklidesową w jednostkach SD, D², D (funkcja mahalanobis()) oraz błąd klasyfikacji Φ(−D/2). Kod niczego nie losuje. Rysunki na stronie powstały z obiektów p1 i p2 z drugiego bloku, z krojem i tłem serwisu.
D między środkami trzech gatunków irysów
R
# Uogólniona odległość Mahalanobisa między grupami: trzy gatunki irysów (dane Andersona, Fisher 1936)
data(iris, package = "datasets")
X <- iris[, 1:4]
gatunek <- iris$Species

# Środki grup i wspólna (połączona) macierz kowariancji wewnątrz grup
srodki <- as.matrix(aggregate(X, list(gatunek), mean)[, -1])
rownames(srodki) <- levels(gatunek)
S <- Reduce(`+`, lapply(split(X, gatunek), function(d) (nrow(d) - 1) * cov(d))) / (nrow(X) - nlevels(gatunek))
round(cov2cor(S)[1:2, 1:2], 2)   # korelacja długości i szerokości działki kielicha wewnątrz gatunków

# Odległość euklidesowa w jednostkach odchylenia standardowego (bez korelacji) i odległość Mahalanobisa D
odleglosci <- function(zmienne) {
  pary <- combn(levels(gatunek), 2)
  do.call(rbind, lapply(seq_len(ncol(pary)), function(j) {
    a <- pary[1, j]; b <- pary[2, j]
    roznica <- srodki[a, zmienne] - srodki[b, zmienne]
    S_z <- S[zmienne, zmienne, drop = FALSE]
    D2 <- mahalanobis(srodki[a, zmienne], srodki[b, zmienne], S_z)
    data.frame(para = paste(a, "–", b), zmienne = length(zmienne),
               euklides_SD = sqrt(sum(roznica^2 / diag(S_z))), D2 = D2, D = sqrt(D2),
               blad_klasyfikacji = pnorm(-sqrt(D2) / 2))   # przy normalności i równych kowariancjach
  }))
}
wyniki <- rbind(odleglosci(c("Sepal.Length", "Sepal.Width")), odleglosci(names(X)))
print(transform(wyniki, euklides_SD = round(euklides_SD, 2), D2 = round(D2, 2), D = round(D, 2),
                blad_klasyfikacji = round(blad_klasyfikacji, 4)), row.names = FALSE)
Wynik w R
             Sepal.Length Sepal.Width
Sepal.Length         1.00        0.53
Sepal.Width          0.53        1.00
                   para zmienne euklides_SD     D2     D blad_klasyfikacji
    setosa – versicolor       2        2.65  14.92  3.86            0.0267
     setosa – virginica       2        3.35  21.68  4.66            0.0100
 versicolor – virginica       2        1.40   1.61  1.27            0.2628
    setosa – versicolor       4        8.78  89.86  9.48            0.0000
     setosa – virginica       4       13.31 179.38 13.39            0.0000
 versicolor – virginica       4        4.76  17.20  4.15            0.0191
Rysunki 1 i 2: oś czasu i odległości między gatunkami
Kod R rysunków
# Rysunki 1–2: oś czasu P. C. Mahalanobisa i odległość Mahalanobisa między gatunkami irysów
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c(setosa = "#E69F00", versicolor = "#0072B2", virginica = "#009E73", ciemny = "grey20")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom",
                                               plot.title = element_text(face = "bold"))

# Rysunek 1: oś czasu (lata z cytowanych źródeł)
zdarzenia <- data.frame(
  rok = c(1893, 1922, 1931, 1936, 1941, 1944, 1946, 1972),
  opis = c("urodziny", "profesor fizyki\nPresidency College, Kalkuta", "założenie Indyjskiego\nInstytutu Statystycznego",
           "uogólniona odległość\n(D²)", "C. R. Rao zaczyna\nszkolenie w ISI", "artykuł o dużych\nbadaniach próbkowych",
           "próby przenikające się", "śmierć w Kalkucie"),
  poziom = c(1, -1, 1, -2.3, 2.3, -1, 3.6, 1))
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey40", linewidth = 0.8) +
  geom_segment(aes(xend = rok, yend = poziom), colour = "grey60", linetype = "dotted") +
  geom_point(size = 3, colour = oi[["versicolor"]]) +
  geom_label(aes(y = poziom, label = paste0(rok, "\n", opis)), size = 3.3, lineheight = 0.9,
             linewidth = 0, fill = "white", vjust = ifelse(zdarzenia$poziom > 0, 0, 1)) +
  scale_x_continuous(breaks = seq(1890, 1970, 10), limits = c(1886, 1979)) +
  scale_y_continuous(limits = c(-5.2, 5.4)) +
  labs(x = NULL, y = NULL, title = "Prasanta Chandra Mahalanobis (1893–1972)") +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())

# Rysunek 2: środki gatunków, odległość euklidesowa i Mahalanobisa
data(iris, package = "datasets")
X <- iris[, 1:4]; gatunek <- iris$Species
srodki <- aggregate(X, list(Species = gatunek), mean)
S <- Reduce(`+`, lapply(split(X, gatunek), function(d) (nrow(d) - 1) * cov(d))) / (nrow(X) - 3)
pary <- t(combn(levels(gatunek), 2))
odl <- do.call(rbind, lapply(list(c("Sepal.Length", "Sepal.Width"), names(X)), function(v) {
  do.call(rbind, lapply(1:3, function(j) {
    a <- srodki[srodki$Species == pary[j, 1], v]; b <- srodki[srodki$Species == pary[j, 2], v]
    r <- unlist(a - b); Sv <- S[v, v]
    data.frame(para = paste(pary[j, 1], "–", pary[j, 2]), zmienne = paste(length(v), "zmienne"),
               miara = c("euklidesowa (w SD)", "Mahalanobisa D"),
               wartosc = c(sqrt(sum(r^2 / diag(Sv))), sqrt(mahalanobis(unlist(a), unlist(b), Sv))))
  }))
}))
odl$para <- factor(odl$para, levels = rev(unique(odl$para)))
i1 <- match(pary[, 1], srodki$Species); i2 <- match(pary[, 2], srodki$Species)
odc <- data.frame(x = srodki$Sepal.Length[i1], y = srodki$Sepal.Width[i1],
                  xend = srodki$Sepal.Length[i2], yend = srodki$Sepal.Width[i2],
                  etykieta = sprintf("D = %.2f", odl$wartosc[odl$zmienne == "2 zmienne" & odl$miara == "Mahalanobisa D"]))
odc$xs <- (odc$x + odc$xend) / 2; odc$ys <- (odc$y + odc$yend) / 2
pA <- ggplot(iris, aes(Sepal.Length, Sepal.Width)) +
  geom_point(aes(colour = Species, shape = Species), alpha = 0.55, size = 1.8) +
  geom_segment(data = odc, aes(x = x, y = y, xend = xend, yend = yend), inherit.aes = FALSE, colour = oi[["ciemny"]]) +
  geom_label(data = odc, aes(xs, ys, label = etykieta), inherit.aes = FALSE, size = 3.2, linewidth = 0, alpha = 0.85) +
  geom_point(data = srodki, aes(fill = Species, shape = Species), size = 4.5, colour = "black") +
  scale_colour_manual(values = oi[1:3], name = NULL) + scale_fill_manual(values = oi[1:3], name = NULL) +
  scale_shape_manual(values = c(21, 24, 22), name = NULL) +
  labs(title = "A. Środki gatunków (2 zmienne)", x = "Długość działki kielicha (cm)", y = "Szerokość działki kielicha (cm)") + motyw
pB <- ggplot(odl, aes(wartosc, para, shape = miara)) +
  geom_line(aes(group = para), colour = "grey70") +
  geom_point(size = 3, colour = oi[["ciemny"]], fill = "white") +
  facet_wrap(~zmienne, scales = "free_x") +
  scale_shape_manual(values = c(21, 17), name = NULL) +
  labs(title = "B. Odległość między środkami", x = "Odległość", y = NULL) + motyw
p2 <- pA + pB + plot_layout(widths = c(1.1, 1))

p1   # zapis: ggsave("mahalanobis-os-czasu.svg", p1, width = 10, height = 5.4)
p2   # zapis: ggsave("mahalanobis-odleglosc-gatunki.svg", p2, width = 11, height = 5.2)
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats, dane z pakietu datasets); rysunki wykonano w pakietach ggplot2 i patchwork, a pliki zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Kim był Prasanta Chandra Mahalanobis?
Indyjskim fizykiem i statystykiem (1893–1972). Od 1922 roku był profesorem fizyki w Presidency College w Kalkucie, w 1931 roku założył Indyjski Instytut Statystyczny, a później doradzał rządowi Indii w sprawach statystyki i planowania gospodarczego.
Co wymyślił Mahalanobis?
Najbardziej znany jest z uogólnionej odległości D² (1936), czyli odległości Mahalanobisa, która mierzy różnicę w wielu zmiennych z uwzględnieniem ich korelacji. Rozwinął też planowanie dużych badań próbkowych i metodę prób przenikających się do oceny błędu oszacowań.
Czym są próby przenikające się (interpenetrating samples)?
To kilka podprób pobranych z populacji według tego samego planu. Każda daje własne oszacowanie, a z rozrzutu tych oszacowań liczy się błąd standardowy. Porównanie podprób realizowanych przez różnych ankieterów pozwala też wykryć błędy w zbieraniu i przetwarzaniu danych.
Czy odległość Mahalanobisa służy tylko do wykrywania obserwacji odstających?
Nie. To ogólna miara różnicy w wielu zmiennych. Można nią mierzyć odległość osoby od środka próby, ale też odległość między środkami dwóch grup – na tym opierają się analiza dyskryminacyjna i test T² Hotellinga.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wartości odstające: jak je wykryć i co z nimi zrobić
Reguły ustalone z góry, MAD zamiast ±3 SD, Mahalanobis i MCD, odległość Cooka, winsoryzacja, test Yuena, analiza wrażliwości i opis APA – z kodem R.
Czytaj →PoradnikCałkowity błąd badania sondażowego (TSE)
Pokrycie, brak odpowiedzi, pomiar i ważenie w jednym rachunku MSE: symulacja czterech planów za ten sam budżet i opis ograniczeń.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bera, A. K. (2003). The ET interview: Professor C.R. Rao. Econometric Theory, 19(2), 331–400. https://doi.org/10.1017/s0266466603192067
- Kordos, J., & Zięba, A. (2010). Development of standard error estimation methods in complex household sample surveys in Poland. Statistics in Transition new series, 11(2), 231–252. https://doi.org/10.59170/stattrans-2010-016 ● Otwarty dostęp: pełny tekst
- Mahalanobis, P. C. (1944). On large-scale sample surveys. Philosophical Transactions of the Royal Society of London. Series B, Biological Sciences, 231(584), 329–451. https://doi.org/10.1098/rstb.1944.0002
- Mahalanobis, P. C. (2018). Reprint of: Mahalanobis, P.C. (1936) “On the generalised distance in statistics”. Sankhyā A, 80(S1), 1–7. https://doi.org/10.1007/s13171-019-00164-5
- Rao, C. R. (1973). Prasantha Chandra Mahalanobis, 1893–1972. Biographical Memoirs of Fellows of the Royal Society, 19(19), 455–492. https://doi.org/10.1098/rsbm.1973.0017
Cytowania BibTeX
@article{bera2003et, author={Bera, Anil K.}, title={{The ET interview: Professor C.R. Rao}}, journal={Econometric Theory}, year={2003}, volume={19}, number={2}, pages={331--400}, doi={10.1017/s0266466603192067}}@article{kordos2010development, author={Kordos, Jan and Zięba, Agnieszka}, title={{Development of standard error estimation methods in complex household sample surveys in Poland}}, journal={Statistics in Transition new series}, year={2010}, volume={11}, number={2}, pages={231--252}, doi={10.59170/stattrans-2010-016}}@article{mahalanobis1944large, author={Mahalanobis, Prasanta Chandra}, title={{On large-scale sample surveys}}, journal={Philosophical Transactions of the Royal Society of London. Series B, Biological Sciences}, year={1944}, volume={231}, number={584}, pages={329--451}, doi={10.1098/rstb.1944.0002}}@article{mahalanobis2018reprint, author={Mahalanobis, Prasanta Chandra}, title={{Reprint of: Mahalanobis, P.C. (1936) “On the generalised distance in statistics”}}, journal={Sankhyā A}, year={2018}, volume={80}, number={S1}, pages={1--7}, doi={10.1007/s13171-019-00164-5}}@article{rao1973prasantha, author={Rao, Calyampudi Radhakrishna}, title={{Prasantha Chandra Mahalanobis, 1893–1972}}, journal={Biographical Memoirs of Fellows of the Royal Society}, year={1973}, volume={19}, number={19}, pages={455--492}, doi={10.1098/rsbm.1973.0017}}