Kim był Abraham Wald?
Abraham Wald (1902–1950) był matematykiem i statystykiem, twórcą analizy sekwencyjnej i teorii decyzji statystycznych. Urodził się 31 października 1902 roku w Klausenburgu (węg. Kolozsvár), mieście należącym wtedy do Węgier, a po I wojnie światowej do Rumunii jako Kluż. Pochodził z ortodoksyjnej rodziny żydowskiej i uczył się prywatnie (Schneeweiss, 2005).
Od 1927 roku studiował matematykę w Wiedniu, uczestniczył w kolokwium matematycznym Karla Mengera i w 1931 roku obronił doktorat. Zajmował się wtedy geometrią. Pracy na uniwersytecie nie dostał; zatrudnił się w Austriackim Instytucie Badań Koniunktury kierowanym przez Oskara Morgensterna, gdzie napisał m.in. książkę o usuwaniu wahań sezonowych z szeregów czasowych (1936). Po przejęciu Austrii przez nazistów w 1938 roku stracił pracę i przez Rumunię wyjechał do USA. Większość krewnych, którzy zostali w kraju, została zamordowana (Schneeweiss, 2005).
W USA trafił do Cowles Commission, a jeszcze w 1938 roku – na zaproszenie Harolda Hotellinga – na Columbia University. W 1948 roku był prezesem Institute of Mathematical Statistics. Zginął wraz z żoną w katastrofie lotniczej w Indiach w 1950 roku, podczas cyklu wykładów na zaproszenie rządu Indii (Schneeweiss, 2005).
Najważniejsze pomysły
- Analiza sekwencyjna. W czasie wojny na Columbia University działała Statistical Research Group (SRG), która rozwiązywała problemy statystyczne dla wojska; początki analizy sekwencyjnej sięgają tam 1943 roku (Wallis, 1980). Wald dostał do analizy pomysł próbkowania sekwencyjnego w kontroli jakości i opracował prosty plan: sztuki sprawdza się po kolei, a kontrolę kończy, gdy dane są rozstrzygające. Praca była utajniona do końca wojny (Schneeweiss, 2005); test opublikował w 1945 roku (Wald, 1945). Dziś nazywamy go sekwencyjnym testem ilorazu wiarygodności (SPRT).
- Teoria decyzji statystycznych. Zarysował ją w 1939 roku, a rozwinął w książce z 1950 roku (Schneeweiss, 2005; Wald, 1950). Opiera się na funkcji straty i ryzyku, a estymację i testowanie hipotez traktuje jako szczególne przypadki wyboru decyzji – w tym rachunek błędów I i II rodzaju znany z teorii Neymana i Pearsona.
- Test Walda. Statystyka oparta na oszacowaniu i jego błędzie standardowym, alternatywa dla testu ilorazu wiarygodności (Schneeweiss, 2005). To kolumna „Wald” w tabeli regresji logistycznej – zob. test Walda.
- Współpraca z Jacobem Wolfowitzem, swoim uczniem i przyjacielem (Schneeweiss, 2005). Jej owocem jest m.in. test serii Walda–Wolfowitza.
Przykład
Dane są fikcyjne: odbiorca sprawdza słoiki z partii po jednym. Partię o 0.5% wadliwych sztuk chce przyjmować, a o 3% – odrzucać, przy α = .05 i β = .10 (wartości ustawiono ręcznie). Granice Walda dla ilorazu wiarygodności wynoszą A = 18 i B = 0.105. W liczbie wad d po n sprawdzonych sztukach reguła brzmi: przyjmij, gdy d ≤ −1.24 + 0.014n; odrzuć, gdy d ≥ 1.59 + 0.014n. Bez żadnej wady partię można przyjąć najwcześniej po 89 sztukach. Plan jednorazowy o tych samych ryzykach wymaga 221 sztuk i przyjmuje partię przy najwyżej 3 wadach.
W symulacji 5000 partii przy każdym odsetku wad (set.seed(803), ziarno ustalone raz) plan sekwencyjny przy 0.5% wad sprawdzał średnio 127.6 sztuki i przyjmował 97.2% partii, a przy 3% – średnio 101.2 sztuki i przyjmował 10.2% partii. Błąd Monte Carlo odsetków wynosi najwyżej 0.7 punktu procentowego.
Na rysunku
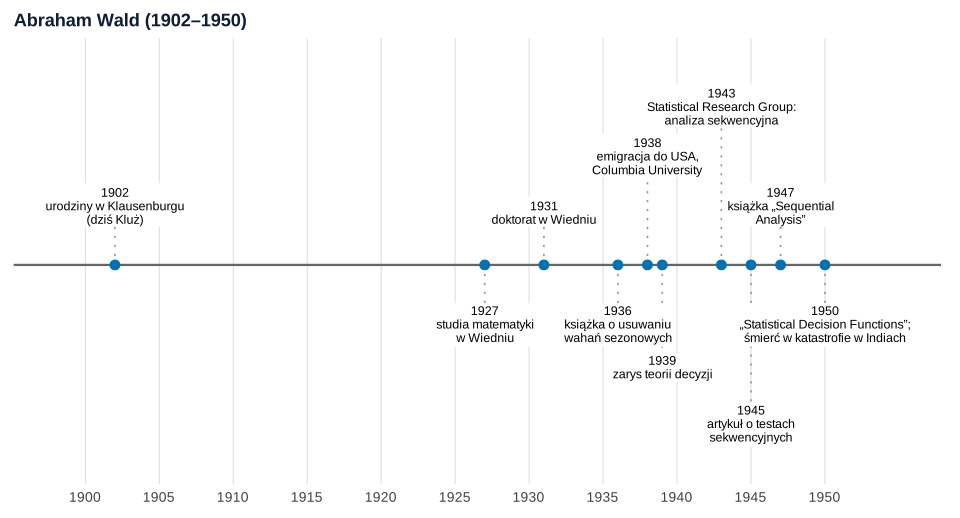
Co widać. Prawie cały dorobek statystyczny Walda powstał w 12 latach – od emigracji w 1938 roku do śmierci w 1950 roku. Wcześniej był geometrą i ekonometrykiem.
Na co uważać. Oś pokazuje tylko daty potwierdzone w cytowanych źródłach; prace z lat 1939–1950 to daty publikacji, a nie powstania pomysłów.
Podpis do pracy:
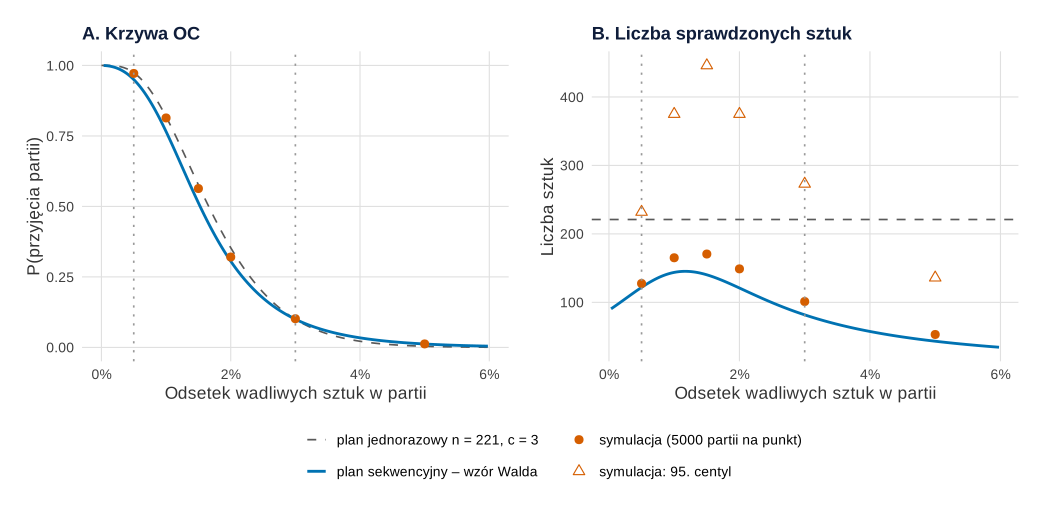
set.seed(803)).Co widać. Krzywe OC obu planów prawie się pokrywają – chronią dostawcę i odbiorcę tak samo. Plan sekwencyjny sprawdza jednak średnio od 53 do 171 sztuk, a więc mniej niż 221 przy każdej jakości partii. Przybliżenia Walda nieco zaniżają średnią liczbę sztuk (121.9 zamiast 127.6 przy 0.5% wad) i zawyżają odsetek odrzuceń dobrych partii: zakładane α = 5%, a w symulacji odrzucono 2.8%.
Na co uważać. Oszczędność dotyczy średniej. Przy jakości pośredniej, np. 1.5% wad, 5% partii wymagało 446 sztuk lub więcej – dwa razy więcej niż plan jednorazowy. Dlatego w praktyce plan sekwencyjny się obcina, ustalając górną liczbę sztuk. Krzywą OC planów jednorazowych i podwójnych pokazuje wpis kontrola odbiorcza i krzywa OC.
Podpis do pracy:
Gdzie spotkasz Walda w swojej pracy
- Tabela regresji logistycznej – kolumna z lub Wald przy każdym współczynniku to test Walda.
- Badania z analizami pośrednimi – plany, w których dane sprawdza się w trakcie zbierania, wyrastają z analizy sekwencyjnej; zob. analiza pośrednia (interim) i sekwencyjny test A/B.
- Planowanie liczebności próby – myślenie o kompromisie między α, β i liczbą obserwacji, opisane w haśle moc testu.
- Kontrola jakości – plany odbiorcze i karty kontrolne.
Spory, mity i trudne strony
Samoloty z dziurami. Najbardziej znana historia o Waldzie dotyczy samolotów wracających z misji z przestrzelinami. Fakty są takie: w SRG Wald napisał memoranda o szacowaniu podatności samolotów na zniszczenie na podstawie danych z maszyn, które przetrwały, a jego metody wykorzystywano w czasie II wojny światowej oraz wojen w Korei i Wietnamie (Mangel i Samaniego, 1984). Popularna wersja – z rysunkiem samolotu usianego kropkami i radą „opancerz miejsca bez dziur” – oddaje tylko intuicję; same memoranda to praca matematyczna o szacowaniu prawdopodobieństwa zniszczenia, którą Mangel i Samaniego streszczają i oceniają na nowo. Sam mechanizm opisuje hasło błąd przeżywalności.
Daty publikacji a daty pomysłów. Prace Walda o analizie sekwencyjnej powstały w ramach badań wojskowych i do końca wojny były utajnione, dlatego publikacje z lat 1945 i 1947 są późniejsze niż sam pomysł (Schneeweiss, 2005).
Sekwencyjny plan Walda w R
Kod w bazowym R wyznacza granice Walda i proste decyzyjne w liczbie wad, krzywą OC i ASN z przybliżeń Walda (parametr pomocniczy h), sprawdza je symulacją i znajduje najmniejszy plan jednorazowy o tych samych ryzykach. Rysunki na stronie powstały z obiektów p1 i p2 z drugiego bloku, z krojem i tłem serwisu.
Krzywa OC i średnia liczba sprawdzonych sztuk
R
# Sekwencyjny plan kontroli odbiorczej Walda: krzywa OC i średnia liczba sprawdzonych sztuk (ASN)
# H0: odsetek wadliwych sztuk 0.5% (partia dobra), H1: 3% (partia zła); alfa = .05, beta = .10
pH0 <- 0.005; pH1 <- 0.03; alfa <- 0.05; beta <- 0.10
A <- (1 - beta) / alfa; B <- beta / (1 - alfa)                  # granice Walda dla ilorazu wiarygodności
g1 <- log(pH1 / pH0); g0 <- log((1 - pH0) / (1 - pH1))              # wkład sztuki wadliwej i dobrej do log LR
# Ta sama reguła w liczbie wad d po n sztukach: odrzuć, gdy d >= h1 + s*n; przyjmij, gdy d <= -h0 + s*n
plan <- c(A = A, B = B, h0 = -log(B) / (g1 + g0), h1 = log(A) / (g1 + g0), s = g0 / (g1 + g0))
round(plan, 4)
c(min_n_do_przyjecia = ceiling(plan[["h0"]] / plan[["s"]]))   # przy zerze wad: najmniej sprawdzonych sztuk

# Krzywa OC i ASN z przybliżeń Walda (parametr pomocniczy h; dla h = 0 wzór graniczny)
h <- seq(-3, 3, by = 0.01); h <- h[abs(h) > 1e-9]
p_h <- (1 - ((1 - pH1) / (1 - pH0))^h) / ((pH1 / pH0)^h - ((1 - pH1) / (1 - pH0))^h)
oc <- (A^h - 1) / (A^h - B^h)                                    # P(przyjęcia partii)
Ez <- p_h * g1 - (1 - p_h) * g0                                  # średni przyrost log LR na sztukę
asn <- (oc * log(B) + (1 - oc) * log(A)) / Ez
krzywe <- data.frame(p = p_h, OC = oc, ASN = asn)
asn_s <- -log(A) * log(B) / (plan[["s"]] * g1^2 + (1 - plan[["s"]]) * g0^2)   # ASN przy p = s (h = 0, wzór graniczny)

# Sprawdzenie symulacją: 5000 partii przy każdym odsetku wad (set.seed(803)), sztuki sprawdzane po jednej
set.seed(803)
symuluj <- function(p, partie = 5000, maks = 3000) {
  x <- matrix(rbinom(partie * maks, 1, p), nrow = partie)
  llr <- t(apply(x * g1 - (1 - x) * g0, 1, cumsum))
  koniec <- apply(llr, 1, function(z) which(z >= log(A) | z <= log(B))[1])
  c(p = p, P_przyjecia = mean(llr[cbind(seq_len(partie), koniec)] <= log(B)),
    srednie_n = mean(koniec), mediana_n = median(koniec), p95_n = unname(quantile(koniec, 0.95)),
    bez_decyzji = sum(is.na(koniec)))
}
sym <- as.data.frame(t(sapply(c(0.005, 0.01, 0.015, 0.02, 0.03, 0.05), symuluj)))
sym$OC_Wald <- approx(krzywe$p, krzywe$OC, sym$p)$y          # przybliżenie Walda w tych samych punktach
sym$ASN_Wald <- approx(krzywe$p, krzywe$ASN, sym$p)$y
round(sym, 3)

# Porównanie: najmniejszy plan jednorazowy (n, c) o tych samych ryzykach (rozkład dwumianowy)
jednorazowy <- NULL
for (n in 1:1000) {
  for (c in 0:20) if (pbinom(c, n, pH0) >= 1 - alfa && pbinom(c, n, pH1) <= beta) { jednorazowy <- c(n = n, c = c); break }
  if (!is.null(jednorazowy)) break
}
jednorazowy
round(c(ASN_p0 = approx(krzywe$p, krzywe$ASN, pH0)$y, ASN_p1 = approx(krzywe$p, krzywe$ASN, pH1)$y,
        ASN_przy_s = asn_s, s = plan[["s"]]), 3)
Wynik w R
      A       B      h0      h1       s
18.0000  0.1053  1.2389  1.5906  0.0140
min_n_do_przyjecia
                89
      p P_przyjecia srednie_n mediana_n  p95_n bez_decyzji OC_Wald ASN_Wald
1 0.005       0.972   127.558      89.0 232.00           0   0.950  121.891
2 0.010       0.814   165.108      97.0 375.00           0   0.766  143.751
3 0.015       0.563   170.579     132.5 446.00           0   0.513  140.224
4 0.020       0.321   148.906      97.0 375.00           0   0.306  120.949
5 0.030       0.102   101.201      84.0 273.05           0   0.100   81.742
6 0.050       0.012    53.066      45.0 136.00           0   0.012   43.230
  n   c
221   3
    ASN_p0     ASN_p1 ASN_przy_s          s
   121.891     81.742    142.717      0.014
Rysunki 1 i 2: oś czasu oraz krzywa OC i ASN
Kod R rysunków
# Rysunki 1–2: oś czasu Abrahama Walda oraz krzywa OC i ASN sekwencyjnego planu kontroli odbiorczej
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c(wald = "#0072B2", symulacja = "#D55E00", jednorazowy = "grey35")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom",
                                               plot.title = element_text(face = "bold"))

# Rysunek 1: oś czasu (lata z cytowanych źródeł)
zdarzenia <- data.frame(
  rok = c(1902, 1927, 1931, 1936, 1938, 1939, 1943, 1945, 1947, 1950),
  opis = c("urodziny w Klausenburgu\n(dziś Kluż)", "studia matematyki\nw Wiedniu", "doktorat w Wiedniu",
           "książka o usuwaniu\nwahań sezonowych", "emigracja do USA,\nColumbia University",
           "zarys teorii decyzji", "Statistical Research Group:\nanaliza sekwencyjna",
           "artykuł o testach\nsekwencyjnych", "książka „Sequential\nAnalysis”",
           "„Statistical Decision Functions”;\nśmierć w katastrofie w Indiach"),
  poziom = c(1, -1, 1, -1, 2.3, -2.3, 3.6, -3.6, 1, -1))
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey40", linewidth = 0.8) +
  geom_segment(aes(xend = rok, yend = poziom), colour = "grey60", linetype = "dotted") +
  geom_point(size = 3, colour = oi[["wald"]]) +
  geom_label(aes(y = poziom, label = paste0(rok, "\n", opis)), size = 3.3, lineheight = 0.9,
             linewidth = 0, fill = "white", vjust = ifelse(zdarzenia$poziom > 0, 0, 1)) +
  scale_x_continuous(breaks = seq(1900, 1950, 5), limits = c(1898, 1955)) +
  scale_y_continuous(limits = c(-5.2, 5.4)) +
  labs(x = NULL, y = NULL, title = "Abraham Wald (1902–1950)") +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())

# Rysunek 2: plan sekwencyjny H0: 0.5% wad vs H1: 3% wad (alfa = .05, beta = .10) i plan jednorazowy n = 221, c = 3
pH0 <- 0.005; pH1 <- 0.03; alfa <- 0.05; beta <- 0.10
A <- (1 - beta) / alfa; B <- beta / (1 - alfa)
g1 <- log(pH1 / pH0); g0 <- log((1 - pH0) / (1 - pH1))
h <- seq(-3, 3, by = 0.01); h <- h[abs(h) > 1e-9]
p_h <- (1 - ((1 - pH1) / (1 - pH0))^h) / ((pH1 / pH0)^h - ((1 - pH1) / (1 - pH0))^h)
oc <- (A^h - 1) / (A^h - B^h)
krzywe <- data.frame(p = p_h, OC = oc, ASN = (oc * log(B) + (1 - oc) * log(A)) / (p_h * g1 - (1 - p_h) * g0))
krzywe <- subset(krzywe, p <= 0.06)
set.seed(803)
symuluj <- function(p, partie = 5000, maks = 3000) {
  x <- matrix(rbinom(partie * maks, 1, p), nrow = partie)
  llr <- t(apply(x * g1 - (1 - x) * g0, 1, cumsum))
  koniec <- apply(llr, 1, function(z) which(z >= log(A) | z <= log(B))[1])
  c(p = p, OC = mean(llr[cbind(seq_len(partie), koniec)] <= log(B)), ASN = mean(koniec),
    p95 = unname(quantile(koniec, 0.95)))
}
sym <- as.data.frame(t(sapply(c(0.005, 0.01, 0.015, 0.02, 0.03, 0.05), symuluj)))
siatka <- data.frame(p = seq(0, 0.06, by = 0.0005))
siatka$OC_jednorazowy <- pbinom(3, 221, siatka$p)

pA <- ggplot() +
  geom_line(data = siatka, aes(p, OC_jednorazowy, linetype = "plan jednorazowy n = 221, c = 3"), colour = oi[["jednorazowy"]]) +
  geom_line(data = krzywe, aes(p, OC, linetype = "plan sekwencyjny – wzór Walda"), colour = oi[["wald"]], linewidth = 1) +
  geom_point(data = sym, aes(p, OC, shape = "symulacja (5000 partii na punkt)"), colour = oi[["symulacja"]], size = 2.8) +
  geom_vline(xintercept = c(pH0, pH1), colour = "grey60", linetype = "dotted") +
  scale_x_continuous(labels = function(x) paste0(100 * x, "%")) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL) + scale_shape_manual(values = c(16, 2), limits = c("symulacja (5000 partii na punkt)", "symulacja: 95. centyl"), name = NULL) +
  labs(title = "A. Krzywa OC", x = "Odsetek wadliwych sztuk w partii", y = "P(przyjęcia partii)") +
  guides(linetype = "none", shape = "none") + motyw   # legenda wspólna – z panelu B
pB <- ggplot() +
  geom_hline(aes(yintercept = 221, linetype = "plan jednorazowy n = 221, c = 3"), colour = oi[["jednorazowy"]]) +
  geom_line(data = krzywe, aes(p, ASN, linetype = "plan sekwencyjny – wzór Walda"), colour = oi[["wald"]], linewidth = 1) +
  geom_point(data = sym, aes(p, ASN, shape = "symulacja (5000 partii na punkt)"), colour = oi[["symulacja"]], size = 2.8) +
  geom_point(data = sym, aes(p, p95, shape = "symulacja: 95. centyl"), colour = oi[["symulacja"]], size = 2.6) +
  geom_vline(xintercept = c(pH0, pH1), colour = "grey60", linetype = "dotted") +
  scale_x_continuous(labels = function(x) paste0(100 * x, "%")) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL) + scale_shape_manual(values = c(16, 2), limits = c("symulacja (5000 partii na punkt)", "symulacja: 95. centyl"), name = NULL) +
  guides(linetype = guide_legend(nrow = 2), shape = guide_legend(nrow = 2)) +
  labs(title = "B. Liczba sprawdzonych sztuk", x = "Odsetek wadliwych sztuk w partii", y = "Liczba sztuk") + motyw
p2 <- (pA + pB) + plot_layout(guides = "collect") & theme(legend.position = "bottom")

p1   # zapis: ggsave("wald-os-czasu.svg", p1, width = 10, height = 5.4)
p2   # zapis: ggsave("wald-krzywa-oc-asn.svg", p2, width = 11, height = 5.4)
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats, m.in. rbinom(), pbinom(), approx()); rysunki wykonano w pakietach ggplot2 i patchwork, a pliki zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Kim był Abraham Wald?
Matematykiem i statystykiem (1902–1950), urodzonym w Klausenburgu (dziś Kluż w Rumunii). Studiował i obronił doktorat w Wiedniu, w 1938 roku wyjechał do USA i pracował na Columbia University. Zginął wraz z żoną w katastrofie lotniczej w Indiach w 1950 roku.
Co wymyślił Abraham Wald?
Analizę sekwencyjną z sekwencyjnym testem ilorazu wiarygodności (SPRT), teorię statystycznych funkcji decyzyjnych i test Walda, który znajdziesz w tabelach współczynników regresji logistycznej. Z Jacobem Wolfowitzem opracował m.in. test serii.
Czy historia o samolotach Walda jest prawdziwa?
Częściowo. Wald rzeczywiście pisał w czasie wojny memoranda o szacowaniu podatności samolotów na zniszczenie na podstawie maszyn, które wróciły. Popularna wersja z rysunkiem samolotu w kropkach i jedną radą o opancerzeniu to uproszczenie tej matematycznej pracy.
Dlaczego test sekwencyjny Walda był tajny?
Powstał w czasie II wojny światowej w Statistical Research Group pracującej dla wojska, jako metoda kontroli jakości. Wyniki utajniono do końca wojny, dlatego artykuł ukazał się w 1945 roku, a książka Sequential Analysis – w 1947 roku.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Kontrola odbiorcza i krzywa OC
Huta szkła i przetwórnia: plan (n, c) z ryzyka α i β, krzywa OC, AOQL, plan podwójny i sezon z dryfem jakości – z kodem R.
Czytaj →PoradnikSekwencyjny test A/B i granice zatrzymania
Gazeta cyfrowa testuje paywall z 4 analizami pośrednimi: granice O’Briena–Fleminga i Pococka, fałszywe alarmy, czas testu i zawyżony efekt – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Mangel, M., & Samaniego, F. J. (1984). Abraham Wald's work on aircraft survivability. Journal of the American Statistical Association, 79(386), 259–267. https://doi.org/10.1080/01621459.1984.10478038
- Schneeweiss, H. (2005). Abraham Wald (Discussion Paper No. 439). Ludwig-Maximilians-Universität München, Sonderforschungsbereich 386. https://hdl.handle.net/10419/31151 ● Otwarty dostęp: pełny tekst
- Wald, A. (1945). Sequential tests of statistical hypotheses. The Annals of Mathematical Statistics, 16(2), 117–186. https://doi.org/10.1214/aoms/1177731118 ● Otwarty dostęp
- Wald, A. (1950). Statistical decision functions. Wiley.
- Wallis, W. A. (1980). The Statistical Research Group, 1942–1945. Journal of the American Statistical Association, 75(370), 320–330. https://doi.org/10.1080/01621459.1980.10477469
Cytowania BibTeX
@article{mangel1984abraham, author={Mangel, Marc and Samaniego, Francisco J.}, title={{Abraham Wald's work on aircraft survivability}}, journal={Journal of the American Statistical Association}, year={1984}, volume={79}, number={386}, pages={259--267}, doi={10.1080/01621459.1984.10478038}}@techreport{schneeweiss2005abraham, author={Schneeweiss, Hans}, title={{Abraham Wald (Discussion Paper No. 439)}}, year={2005}, institution={Ludwig-Maximilians-Universität München, Sonderforschungsbereich 386}, url={https://hdl.handle.net/10419/31151}}@article{wald1945sequential, author={Wald, Abraham}, title={{Sequential tests of statistical hypotheses}}, journal={The Annals of Mathematical Statistics}, year={1945}, volume={16}, number={2}, pages={117--186}, doi={10.1214/aoms/1177731118}}@book{wald1950statistical, author={Wald, Abraham}, title={{Statistical decision functions}}, year={1950}, publisher={Wiley}, url={https://lccn.loc.gov/50009735}}@article{wallis1980statistical, author={Wallis, W. Allen}, title={{The Statistical Research Group, 1942–1945}}, journal={Journal of the American Statistical Association}, year={1980}, volume={75}, number={370}, pages={320--330}, doi={10.1080/01621459.1980.10477469}}