Co to jest test serii?
Test serii (ang. runs test) sprawdza, czy kolejność elementów dwóch rodzajów w ciągu jest losowa. Seria to nieprzerwany ciąg identycznych elementów: w ciągu AABBBA są trzy serie. Zbyt mało serii oznacza, że te same elementy skupiają się w bloki, a zbyt dużo – że regularnie się przeplatają. Wald i Wolfowitz (1940) wykorzystali liczbę serii do porównania dwóch prób, a Swed i Eisenhart (1943) podali tablice dokładnego rozkładu liczby serii dla małych prób.
Dwie wersje testu
- Jedna próba (test losowości). Analizuje ciąg dychotomiczny w kolejności zbierania danych, np. odpowiedzi tak/nie w kolejnych próbach albo wyniki powyżej i poniżej mediany. Przy m elementach jednego rodzaju i n drugiego oczekiwana liczba serii wynosi 1 + 2mn/(m + n).
- Dwie próby (Wald–Wolfowitz). Wyniki obu grup łączy się, sortuje i liczy serie etykiet grup. Mało serii znaczy, że grupy zajmują różne zakresy wartości. Test reaguje na każdą różnicę rozkładów, ale przy samym przesunięciu położenia ma mniejszą moc niż test Manna–Whitneya.
Przykład w R
W losowym ciągu 30 odpowiedzi (14 × A, 16 × B) funkcja RunsTest() z pakietu DescTools znalazła 17 serii przy oczekiwanych 15.9, p = .713. Ciąg z blokami po pięć takich samych odpowiedzi ma tylko 6 serii, p < .001. W wersji dla dwóch prób (po 15 osób, prawdziwa różnica średnich równa 1 SD) test dał 17 serii i p = .848, a test Manna–Whitneya p = .067.
Związek z autokorelacją
W szeregu czasowym albo w resztach regresji znaki odchyleń (+/−) układają się w serie. Za mało serii wskazuje na dodatnią autokorelację, za dużo – na ujemną. Test serii jest więc prostą nieparametryczną alternatywą dla testu Durbina–Watsona, ale korzysta tylko ze znaków, a nie z wielkości odchyleń.
Na rysunku
Dwa symulowane ciągi po 40 reszt: bez autokorelacji i z autokorelacją pierwszego rzędu (AR(1), φ = 0.7 – wartość ustawiona ręcznie, by zależność była wyraźna). Każdy dzielimy na medianie, więc w obu jest 20 reszt powyżej i 20 poniżej, a liczbę serii porównujemy z jednym dokładnym rozkładem przy hipotezie zerowej.
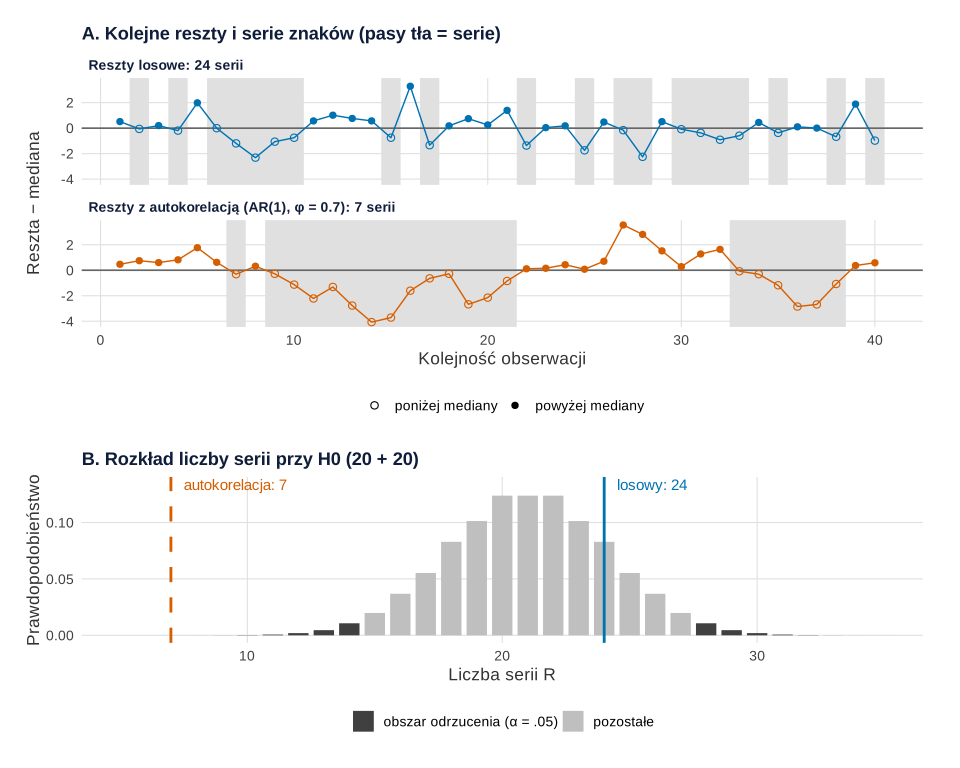
set.seed(4863)).Co widać. Reszty losowe często przechodzą przez medianę: 24 serie przy oczekiwanych 21, dokładne p = .43. Reszty z autokorelacją długo trzymają jedną stronę i tworzą tylko 7 serii, p = 5.8 · 10⁻⁶. Przy 20 + 20 elementach test na poziomie α = .05 odrzuca losowość przy 14 seriach lub mniej (dodatnia autokorelacja) albo 28 lub więcej (ujemna). Autokorelacja z opóźnieniem 1 wynosi w próbach −0.14 i 0.77.
Na co uważać. Test widzi tylko znaki: reszta +0.1 i +3 liczą się tak samo, więc wielkość odchyleń i ich zmienność w czasie zostają poza nim. Liczba serii nie mówi też, jaki jest wzorzec – fale, trend czy sezonowość – trzeba go zobaczyć na wykresie reszt w czasie albo na wykresie opóźnień. Wzorce reszt przy autokorelacji i innych złamanych założeniach zbiera wpis Galeria wykresów reszt.
Podpis do pracy:
Kod odtwarza rysunek i liczby. Ziarno 4863 ustalono raz i nie zmieniano. Rozkład liczby serii liczony jest dokładnie ze wzoru kombinatorycznego, bez symulacji. Rysunek na stronie powstał z obiektu p1 z motywem serwisu; różni się tylko krojem czcionki i siatką.
Kod R rysunku 1
# Rysunek 1. Serie znaków reszt: szereg losowy vs z autokorelacją i dokładny rozkład liczby serii przy H0
library(ggplot2)
library(patchwork)
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom", plot.title = element_text(face = "bold"))
kol <- c(losowy = "#0072B2", autokorelacja = "#D55E00")              # Okabe–Ito

set.seed(4863)
n <- 40
losowy <- rnorm(n)                                                   # reszty bez autokorelacji
autokor <- as.numeric(arima.sim(list(ar = 0.7), n = n))             # reszty z autokorelacją AR(1), phi = 0.7
serie <- function(x) { z <- x > median(x); list(znak = z, R = 1 + sum(diff(z) != 0), m = sum(z), k = sum(!z)) }
s1 <- serie(losowy); s2 <- serie(autokor)

# dokładny rozkład liczby serii R przy H0 dla m elementów jednego rodzaju i k drugiego
rozklad_R <- function(m, k) {
  r <- 2:(2 * min(m, k) + (m != k)); w <- choose(m + k, m)
  pr <- sapply(r, function(r) { j <- r %/% 2
    if (r %% 2 == 0) 2 * choose(m - 1, j - 1) * choose(k - 1, j - 1) / w
    else (choose(m - 1, j - 1) * choose(k - 1, j) + choose(m - 1, j) * choose(k - 1, j - 1)) / w })
  data.frame(R = r, P = pr)
}
H0 <- rozklad_R(s1$m, s1$k)                                          # m = k = 20 w obu szeregach (podział na medianie)
p_dw <- function(R) min(1, 2 * min(sum(H0$P[H0$R <= R]), sum(H0$P[H0$R >= R])))
granice <- c(dolna = max(H0$R[cumsum(H0$P) <= 0.025]), gorna = min(H0$R[rev(cumsum(rev(H0$P))) <= 0.025]))
round(c(oczekiwane = 1 + 2 * s1$m * s1$k / n, sum_P = sum(H0$P)), 2)
granice                                                              # R <= dolna lub R >= gorna: odrzucenie przy alfa = .05
data.frame(szereg = c("losowy", "autokorelacja"), m = c(s1$m, s2$m), k = c(s1$k, s2$k), serie = c(s1$R, s2$R),
           p_dokladne = signif(c(p_dw(s1$R), p_dw(s2$R)), 3),
           r1 = round(c(acf(losowy, plot = FALSE)$acf[2], acf(autokor, plot = FALSE)$acf[2]), 2))

# A: reszty w czasie; tło pokazuje kolejne serie znaków względem mediany
szereg <- function(x, s, nazwa) {
  id_serii <- cumsum(c(1, diff(s$znak) != 0))
  data.frame(t = seq_along(x), e = x - median(x), znak = ifelse(s$znak, "powyżej mediany", "poniżej mediany"),
             seria = id_serii, szereg = sprintf("%s: %d serii", nazwa, s$R))
}
d <- rbind(szereg(losowy, s1, "Reszty losowe"), szereg(autokor, s2, "Reszty z autokorelacją (AR(1), φ = 0.7)"))
d$szereg <- factor(d$szereg, levels = unique(d$szereg))
tlo <- aggregate(t ~ seria + szereg, data = d, FUN = range)
tlo <- data.frame(szereg = tlo$szereg, seria = tlo$seria, od = tlo$t[, 1] - 0.5, do = tlo$t[, 2] + 0.5)
pA <- ggplot(d, aes(t, e)) +
  geom_rect(data = subset(tlo, seria %% 2 == 0), aes(xmin = od, xmax = do, ymin = -Inf, ymax = Inf),
            inherit.aes = FALSE, fill = "grey88") +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_line(aes(colour = szereg), linewidth = 0.5) +
  geom_point(aes(shape = znak, colour = szereg), size = 2.2) +
  facet_wrap(~ szereg, ncol = 1) +
  scale_colour_manual(values = unname(kol), guide = "none") +
  scale_shape_manual(values = c("powyżej mediany" = 16, "poniżej mediany" = 1), name = NULL) +
  labs(title = "A. Kolejne reszty i serie znaków (pasy tła = serie)", x = "Kolejność obserwacji",
       y = "Reszta − mediana") +
  motyw + theme(strip.text = element_text(hjust = 0))

# B: dokładny rozkład liczby serii przy H0 (m = k = 20) i wartości z obu szeregów
H0$obszar <- ifelse(H0$R <= granice[["dolna"]] | H0$R >= granice[["gorna"]], "obszar odrzucenia (α = .05)", "pozostałe")
obs <- data.frame(R = c(s1$R, s2$R), etykieta = c(sprintf("losowy: %d", s1$R), sprintf("autokorelacja: %d", s2$R)))
pB <- ggplot(H0, aes(R, P)) +
  geom_col(aes(fill = obszar), width = 0.8) +
  geom_vline(data = obs, aes(xintercept = R), colour = unname(kol), linetype = c("solid", "dashed"), linewidth = 1) +
  geom_text(data = obs, aes(x = R + 0.5, y = max(H0$P) * 1.08, label = etykieta), colour = unname(kol), size = 4, hjust = 0) +
  scale_fill_manual(values = c("obszar odrzucenia (α = .05)" = "grey25", "pozostałe" = "grey75"), name = NULL) +
  coord_cartesian(xlim = c(5, 35)) +
  labs(title = "B. Rozkład liczby serii przy H0 (20 + 20)", x = "Liczba serii R", y = "Prawdopodobieństwo") +
  motyw
p1 <- pA / pB + plot_layout(heights = c(1.5, 1))
p1   # zapis: ggsave("test-serii-reszty-i-rozklad.svg", p1, width = 10, height = 8)
Wynik w R
oczekiwane      sum_P
        21          1
dolna gorna
   14    28
         szereg  m  k serie p_dokladne    r1
1        losowy 20 20    24   4.26e-01 -0.14
2 autokorelacja 20 20     7   5.76e-06  0.77
Jak opisać w pracy
Na co uważać
- Utrata informacji. Zmienną ciągłą trzeba zamienić na dwie kategorie, np. względem mediany; wartości równe medianie zwykle się pomija.
- Wiązania w dwóch próbach. Równe wartości w różnych grupach dają niejednoznaczną kolejność i zmieniają liczbę serii.
- Nie każdy wzór zostanie wykryty. Mogull (1994) pokazał, że test jednej próby nie sygnalizuje nielosowości, gdy wszystkie serie mają długość dwa (AABBAABB…), a większa próba jeszcze obniża wtedy moc.
Test serii w R
Kod liczy test serii dla losowego i dla blokowego ciągu odpowiedzi A/B oraz wersję Walda–Wolfowitza dla dwóch prób, z testem Manna–Whitneya dla porównania.
Jedna próba i dwie próby
R
library(DescTools)
wynik <- function(t) data.frame(serie = t$parameter[["runs"]], p = format(round(t$p.value, 4), scientific = FALSE))
# Jedna próba: czy kolejność odpowiedzi A/B jest losowa?
set.seed(4861)
losowy <- factor(sample(c("A", "B"), 30, replace = TRUE))
paste(losowy, collapse = "")
wynik(RunsTest(losowy))
seryjny <- factor(rep(rep(c("A", "B"), each = 5), 3))  # bloki po 5 tych samych
wynik(RunsTest(seryjny))
# Dwie próby (Wald–Wolfowitz): czy obie grupy pochodzą z tego samego rozkładu?
set.seed(4862)
g1 <- rnorm(15, mean = 0); g2 <- rnorm(15, mean = 1)
wynik(RunsTest(g1, g2))
round(wilcox.test(g1, g2)$p.value, 3)    # porównanie: test Manna–Whitneya
Wynik w R
[1] "BAAABBBABAABBBAAABBABABBAABBAB"
  serie      p
1    17 0.7131
  serie      p
1     6 0.0003
  serie      p
1    17 0.8481
[1] 0.067
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem DescTools 0.99.60. Rysunek 1 wykonano w pakietach ggplot2 i patchwork (funkcje arima.sim() i acf() z pakietu stats) i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools: Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://CRAN.R-project.org/package=DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Ile serii to „za mało” albo „za dużo”?
Porównaj liczbę serii z oczekiwaną 1 + 2mn/(m + n), gdzie m i n to liczby elementów obu rodzajów. Przy małych m i n użyj rozkładu dokładnego, którego tablice podali Swed i Eisenhart (1943), przy większych – przybliżenia normalnego ze statystyką z.
Czy test Walda–Wolfowitza może zastąpić test Manna–Whitneya?
Nie, gdy pytasz o przesunięcie położenia. Test serii reaguje na każdą różnicę rozkładów, ale ma wtedy mniejszą moc; w przykładzie na tej stronie dał p = .848, a test Manna–Whitneya p = .067.
Jak użyć testu serii dla zmiennej ciągłej?
Ułóż wyniki w kolejności pomiaru i oznacz każdy jako powyżej albo poniżej mediany, pomijając wartości jej równe. Potem policz serie w tym ciągu, np. funkcją RunsTest() z pakietu DescTools.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Mogull, R. G. (1994). Teacher’s corner: The one-sample runs test: A category of exception. Journal of Educational and Behavioral Statistics, 19(3), 296–303. https://doi.org/10.3102/10769986019003296
- Swed, F. S., & Eisenhart, C. (1943). Tables for testing randomness of grouping in a sequence of alternatives. The Annals of Mathematical Statistics, 14(1), 66–87. https://doi.org/10.1214/aoms/1177731494 ● Otwarty dostęp
- Wald, A., & Wolfowitz, J. (1940). On a test whether two samples are from the same population. The Annals of Mathematical Statistics, 11(2), 147–162. https://doi.org/10.1214/aoms/1177731909 ● Otwarty dostęp
Cytowania BibTeX
@article{mogull1994one, author={Mogull, Robert G.}, title={{Teacher’s corner: The one-sample runs test: A category of exception}}, journal={Journal of Educational and Behavioral Statistics}, year={1994}, volume={19}, number={3}, pages={296--303}, doi={10.3102/10769986019003296}}@article{swed1943tables, author={Swed, Frieda S. and Eisenhart, Churchill}, title={{Tables for testing randomness of grouping in a sequence of alternatives}}, journal={The Annals of Mathematical Statistics}, year={1943}, volume={14}, number={1}, pages={66--87}, doi={10.1214/aoms/1177731494}}@article{wald1940test, author={Wald, Abraham and Wolfowitz, Jacob}, title={{On a test whether two samples are from the same population}}, journal={The Annals of Mathematical Statistics}, year={1940}, volume={11}, number={2}, pages={147--162}, doi={10.1214/aoms/1177731909}}