Kim był William Kruskal?
William Henry Kruskal (1919–2005) był amerykańskim statystykiem, który prawie całe życie zawodowe spędził na Uniwersytecie Chicagowskim. Studenci znają go z testu Kruskala–Wallisa, a badacze nauk społecznych – z miar związku Goodmana–Kruskala. Według biografii Fienberga, Stiglera i Tanur (2007) urodził się 10 października 1919 r. w Nowym Jorku. Studiował na Harvardzie, gdzie zdobył licencjat z matematyki i filozofii (1940) oraz magisterium z matematyki (1941).
W czasie wojny, w latach 1941–1946, pracował jako matematyk na poligonie marynarki wojennej USA w Dahlgren w Wirginii. W 1950 r. przyjął posadę w Chicago – rekomendację napisał mu Abraham Wald. Doktorat z Columbii obronił dopiero w 1955 r.: był perfekcjonistą i długo dopracowywał rozprawę. W Chicago kierował wydziałem statystyki (1966–1973), a potem był dziekanem Wydziału Nauk Społecznych (1974–1984). Redagował Annals of Mathematical Statistics (1958–1961), był prezesem Institute of Mathematical Statistics (1970–1971) i American Statistical Association (1982). Zmarł w Chicago 22 kwietnia 2005 r. (Fienberg i in., 2007).
Najważniejsze pomysły
- Test Kruskala–Wallisa (1952). Razem ze starszym kolegą W. Allenem Wallisem zaproponował test, który porównuje kilka niezależnych grup na podstawie rang ze wspólnego uporządkowania wszystkich obserwacji. Statystyka H ma w przybliżeniu rozkład chi-kwadrat z liczbą stopni swobody o jeden mniejszą od liczby grup, a dla małych prób autorzy podali przybliżenia i tablice dokładne (Kruskal i Wallis, 1952). To rangowy odpowiednik jednoczynnikowej ANOVA – szczegóły w haśle test Kruskala–Wallisa.
- Miary związku z Leo Goodmanem (od 1954). Cztery prace w JASA, wydane w ciągu 18 lat i zebrane w książce z 1979 r., zaproponowały miary związku w tabelach krzyżowych o jasnym sensie probabilistycznym zamiast miar opartych na chi-kwadrat (Goodman i Kruskal, 1954). Z tej serii pochodzą gamma i lambda Goodmana–Kruskala.
- Historia pojęć. Interesowało go, skąd biorą się terminy i pomysły statystyki: z Frederickiem Mostellerem prześledził historię „reprezentatywnej próby”, napisał też uwagi historyczne o teście Wilcoxona dla dwóch prób (zob. Frank Wilcoxon).
- Encyklopedie i statystyka publiczna. Był redaktorem działu statystyki International Encyclopedia of the Social Sciences (1962–1968) i współredaktorem International Encyclopedia of Statistics (1978), a w latach 1971–1978 pierwszym przewodniczącym Committee on National Statistics (Fienberg i in., 2007).
Ciekawostka
Kruskal pochodził z niezwykłej rodziny. Był najstarszym z trojga braci i dwóch sióstr. Ojciec prowadził firmę Kruskal & Kruskal – przez dziesięciolecia największą hurtownię futer w USA. Matka, znana później jako Lillian Oppenheimer, założyła organizację, która dziś nazywa się OrigamiUSA, współtworzyła książki o origami i promowała składanie papieru w telewizji (Fienberg i in., 2007).
Wszyscy trzej bracia zostali naukowcami. Joseph Kruskal wspominał, że zaczynali jako matematycy, ale William przeszedł całkiem do statystyki, on sam częściowo do statystyki, a Martin częściowo do fizyki. Joseph, związany z Bell Laboratories, jest znany z twierdzenia Kruskala w informatyce i z prac o skalowaniu wielowymiarowym. Martin był profesorem matematyki w Princeton, a w 1993 r. otrzymał National Medal of Science.
Przykład na historycznych danych
Zbiór chickwts z pakietu datasets to masa 71 kurcząt po sześciu tygodniach. Według pliku pomocy pisklęta przydzielono losowo do sześciu grup, a każda dostawała inny dodatek paszowy; dane opublikowano anonimowo w Biometrice w 1948 r., cztery lata przed artykułem Kruskala i Wallisa. Nazwy pasz w danych są angielskie: horsebean – bób, linseed – siemię lniane, soybean – soja, meatmeal – mączka mięsna, casein – kazeina, sunflower – słonecznik.
Po nadaniu wspólnych rang wszystkim 71 kurczętom średnie rangi grup wynoszą od 9.80 (bób) do 53.88 (słonecznik), przy ogólnej średniej randze 36. Statystyka policzona ze wzoru Kruskala i Wallisa, z poprawką na remisy, wynosi H(5) = 37.34, p < .001 – tyle samo, co z funkcji kruskal.test(). Wielkość efektu ε² = .53. Żeby sprawdzić przybliżenie chi-kwadrat, 10 000 razy przetasowaliśmy etykiety pasz (ziarno 829). W rozkładzie z przetasowań 95. percentyl H wynosi 10.78, a w rozkładzie chi-kwadrat z 5 stopniami swobody 11.07; największe H z przetasowań to 26.19, więc żadne nie dorównało wynikowi z danych. Nie twierdzimy, że Kruskal analizował te dane – to nasz przykład jego metody.
Na rysunku
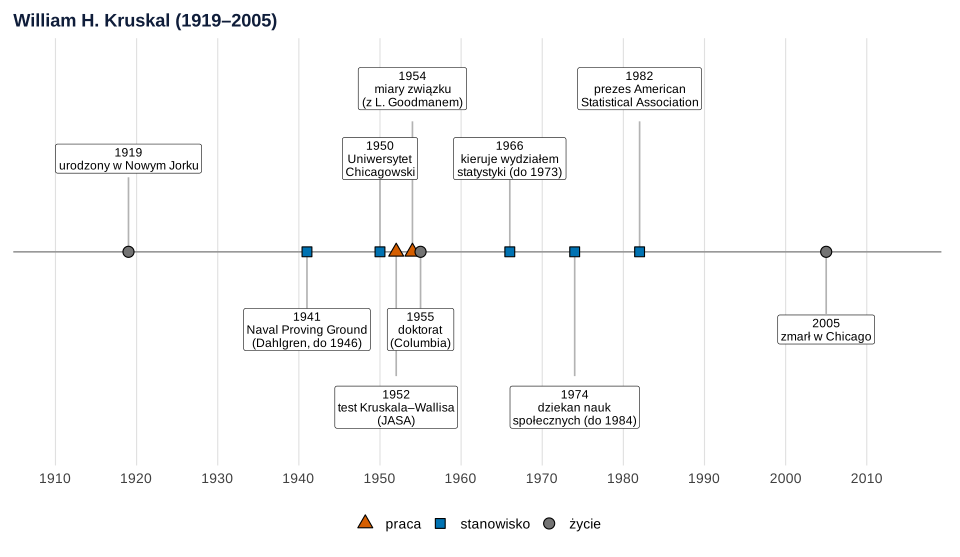
Co widać. Obie metody, z których Kruskala znają studenci, powstały na samym początku jego pracy w Chicago – zanim obronił doktorat.
Na co uważać. To wybór dziesięciu zdarzeń: oś pomija m.in. redakcję Annals, prezesurę IMS i pracę nad encyklopediami.
Podpis do pracy:
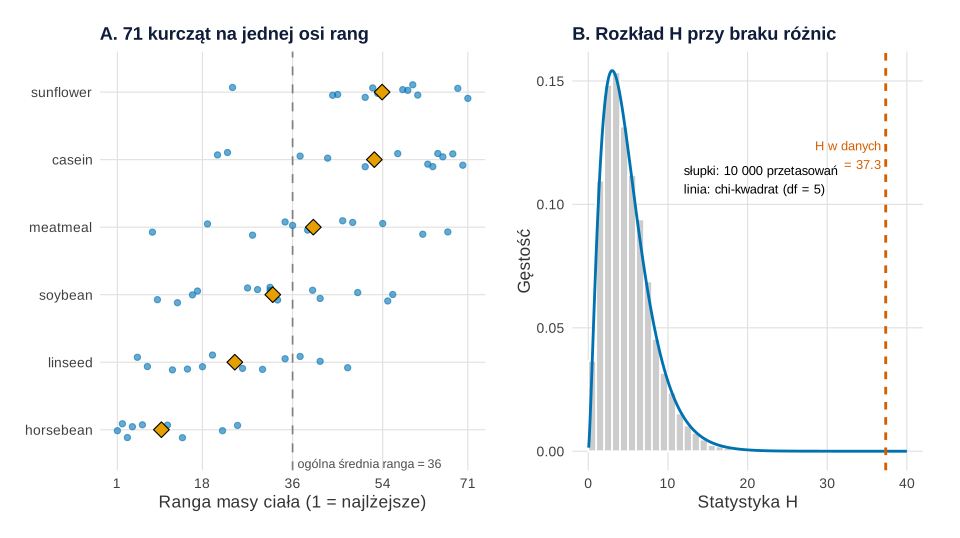
datasets::chickwts (Biometrika, 1948, według pliku pomocy). Rysunek: R, pakiety ggplot2 i patchwork; przetasowania i pionowy rozrzut punktów – set.seed(829).Co widać. Panel A pokazuje to, co widzi test: nie masy w gramach, tylko miejsca w jednym wspólnym rankingu. Kurczęta na bobie zajmują prawie same najniższe miejsca, na słoneczniku i kazeinie – najwyższe. H mierzy, jak daleko romby średnich rang odsuwają się od linii 36. Panel B pokazuje, jakie wartości H dają przypadkowe podziały tych samych 71 rang na grupy tej samej wielkości. Słupki niemal pokrywają się z krzywą chi-kwadrat, więc przybliżenie z 1952 r. działa tu dobrze, a wynik z danych leży daleko poza całym rozkładem.
Na co uważać. Rangi gubią odległości w gramach: z panelu A nie odczytasz, o ile cięższe są kurczęta na słoneczniku. W pracy podaj też mediany. Przy grupach po kilka osób przybliżenie chi-kwadrat jest słabsze – wtedy policz wartość p z przetasowań, jak w teście permutacyjnym. Test mówi, że pasze się różnią, a nie które – do tego służy test Dunna.
Podpis do pracy:
Gdzie spotkasz Kruskala w swojej pracy
- Porównanie kilku grup. Test Kruskala–Wallisa to standardowa alternatywa dla ANOVA przy zmiennej porządkowej albo silnie skośnej, np. pojedynczej pozycji skali Likerta. W R:
kruskal.test(). Przegląd innych testów rangowych jest w haśle testy nieparametryczne. - Tabele krzyżowe. Gamma Goodmana–Kruskala dla dwóch zmiennych porządkowych i lambda dla nominalnych pojawiają się w wynikach procedury tabel krzyżowych w SPSS.
Spory, mity i trudne strony
„Kruskal–Wallis to test median”. Vargha i Delaney (1998) pokazują, że test wykrywa różnice średnich rang (tzw. stochastycznej jednorodności), a nie każdą różnicę rozkładów. O medianach mów tylko wtedy, gdy rozkłady w grupach mają podobny kształt i rozrzut.
„Test nieparametryczny nie ma założeń”. Ma: niezależne obserwacje i grupy oraz zmienną co najmniej porządkową. Nie wymaga tylko normalności.
„Test to pomysł jednego artykułu”. Oprócz wspólnej pracy z Wallisem w JASA Kruskal opublikował w tym samym 1952 r. osobny artykuł o nieparametrycznym teście dla wielu prób w Annals of Mathematical Statistics. Wallis był jego starszym kolegą i założycielem chicagowskiego Committee on Statistics, z którego wyrósł wydział statystyki (Fienberg i in., 2007).
Test Kruskala–Wallisa w R
Kod rysuje oś czasu, nadaje rangi 71 kurczętom, liczy statystykę H ze wzoru Kruskala i Wallisa (z poprawką na remisy) i porównuje ją z kruskal.test(), a potem buduje rozkład H z 10 000 przetasowań etykiet pasz. Rysunki na stronie powstały z tych samych obiektów p_os i p_metoda z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
Oś czasu, rangi i test Kruskala–Wallisa na danych chickwts
Kod R rysunków 1 i 2
# William Kruskal: oś czasu i test Kruskala–Wallisa (1952) na danych chickwts – rangi i rozkład H z permutacji
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", szary = "grey45")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"))

# 1. Oś czasu (lata według Fienberga, Stiglera i Tanur 2007)
zdarzenia <- data.frame(
  rok = c(1919, 1941, 1950, 1952, 1954, 1955, 1966, 1974, 1982, 2005),
  opis = c("urodzony w Nowym Jorku", "Naval Proving Ground\n(Dahlgren, do 1946)", "Uniwersytet\nChicagowski",
           "test Kruskala–Wallisa\n(JASA)", "miary związku\n(z L. Goodmanem)", "doktorat\n(Columbia)",
           "kieruje wydziałem\nstatystyki (do 1973)", "dziekan nauk\nspołecznych (do 1984)", "prezes American\nStatistical Association",
           "zmarł w Chicago"),
  rodzaj = c("życie", "stanowisko", "stanowisko", "praca", "praca", "życie", "stanowisko", "stanowisko", "stanowisko", "życie"))
zdarzenia$y <- c(1.2, -1, 1.2, -2, 2.1, -1, 1.2, -2, 2.1, -1)   # wysokość etykiet, żeby się nie nakładały
p_os <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_segment(aes(xend = rok, yend = y * 0.8), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.5) +
  geom_label(aes(y = y, label = paste0(rok, "\n", opis)), size = 3.2, lineheight = 0.9, linewidth = 0.2) +
  scale_shape_manual(values = c("życie" = 21, "stanowisko" = 22, "praca" = 24), name = NULL) +
  scale_fill_manual(values = c("życie" = oi[["szary"]], "stanowisko" = oi[["niebieski"]], "praca" = oi[["cynober"]]), name = NULL) +
  scale_x_continuous(breaks = seq(1910, 2010, 10), limits = c(1910, 2014)) + scale_y_continuous(limits = c(-2.5, 2.5)) +
  labs(title = "William H. Kruskal (1919–2005)", x = NULL, y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank(), legend.position = "bottom")

# 2. Dane: masa kurcząt (g) po sześciu tygodniach na sześciu paszach (Anonymous 1948, Biometrika)
data(chickwts, package = "datasets")
r <- rank(chickwts$weight)                       # wspólne rangi wszystkich 71 kurcząt (remisy – średnia ranga)
N <- nrow(chickwts); n <- table(chickwts$feed); R <- tapply(r, chickwts$feed, sum)
srednie <- data.frame(n = as.vector(n), mediana_g = tapply(chickwts$weight, chickwts$feed, median),
                      suma_rang = R, srednia_ranga = round(R / as.vector(n), 2))
srednie[order(srednie$srednia_ranga), ]
# Statystyka H ze wzoru Kruskala i Wallisa, z poprawką na remisy
H0 <- 12 / (N * (N + 1)) * sum(R^2 / n) - 3 * (N + 1)
t_rem <- table(chickwts$weight)
H <- H0 / (1 - sum(t_rem^3 - t_rem) / (N^3 - N))
c(H = round(H, 3), df = length(n) - 1, epsilon2 = round(H / (N - 1), 3))
kruskal.test(weight ~ feed, data = chickwts)

# Rozkład H, gdy pasza nie ma znaczenia: 10 000 losowych przetasowań etykiet pasz (ziarno 829)
H_od_rang <- function(rr, g) { Rg <- tapply(rr, g, sum); ng <- tabulate(g)
  (12 / (N * (N + 1)) * sum(Rg^2 / ng) - 3 * (N + 1)) / (1 - sum(t_rem^3 - t_rem) / (N^3 - N)) }
set.seed(829)
H_perm <- replicate(10000, H_od_rang(r, sample(as.integer(chickwts$feed))))
data.frame(kwantyl_95_perm = round(unname(quantile(H_perm, 0.95)), 2), kwantyl_95_chi2 = round(qchisq(0.95, 5), 2),
           odsetek_perm_H_ponad_11.07 = mean(H_perm >= qchisq(0.95, 5)), max_H_perm = round(max(H_perm), 2),
           ile_perm_H_ponad_dane = sum(H_perm >= H))

# Rysunek A: każda kura na osi rang, w wierszu swojej paszy; romb – średnia ranga paszy
kol <- order(srednie$srednia_ranga)
chickwts$pasza <- factor(chickwts$feed, levels = rownames(srednie)[kol])
chickwts$ranga <- r
sr <- data.frame(pasza = factor(rownames(srednie), levels = levels(chickwts$pasza)), sr = srednie$srednia_ranga)
p_rangi <- ggplot(chickwts, aes(ranga, pasza)) +
  geom_vline(xintercept = (N + 1) / 2, linetype = "dashed", colour = "grey50") +
  geom_point(position = position_jitter(width = 0, height = 0.12, seed = 829), colour = oi[["niebieski"]], alpha = 0.6, size = 1.8) +
  geom_point(data = sr, aes(sr, pasza), shape = 23, size = 4, fill = oi[["pomaranczowy"]], colour = "black") +
  annotate("text", x = (N + 1) / 2 + 1, y = 0.5, label = "ogólna średnia ranga = 36", hjust = 0, size = 3.3, colour = "grey30") +
  scale_x_continuous(breaks = c(1, 18, 36, 54, 71)) +
  labs(title = "A. 71 kurcząt na jednej osi rang", x = "Ranga masy ciała (1 = najlżejsze)", y = NULL) + motyw
# Rysunek B: rozkład H z przetasowań i krzywa chi-kwadrat z 5 stopniami swobody
krzywa <- data.frame(h = seq(0.05, 40, by = 0.05)); krzywa$g <- dchisq(krzywa$h, df = 5)
p_perm <- ggplot(data.frame(H = H_perm), aes(H)) +
  geom_histogram(aes(y = after_stat(density)), binwidth = 1, boundary = 0, fill = "grey80", colour = "white") +
  geom_line(data = krzywa, aes(h, g), colour = oi[["niebieski"]], linewidth = 1) +
  geom_vline(xintercept = H, colour = oi[["cynober"]], linewidth = 1, linetype = "22") +
  annotate("text", x = H - 0.6, y = 0.12, label = paste0("H w danych\n= ", round(H, 1)), hjust = 1, size = 3.4, colour = oi[["cynober"]]) +
  annotate("text", x = 12, y = 0.11, label = "słupki: 10 000 przetasowań\nlinia: chi-kwadrat (df = 5)", hjust = 0, size = 3.4) +
  scale_x_continuous(limits = c(0, 40)) +
  labs(title = "B. Rozkład H przy braku różnic", x = "Statystyka H", y = "Gęstość") + motyw
p_metoda <- p_rangi + p_perm + plot_layout(widths = c(1.1, 1))
p_os
p_metoda
Wynik w R
           n mediana_g suma_rang srednia_ranga
horsebean 10     151.5      98.0          9.80
linseed   12     221.0     293.5         24.46
soybean   14     248.0     448.5         32.04
meatmeal  11     263.0     441.5         40.14
casein    12     342.0     628.0         52.33
sunflower 12     328.0     646.5         53.88
       H       df epsilon2
  37.343    5.000    0.533

	Kruskal-Wallis rank sum test

data:  weight by feed
Kruskal-Wallis chi-squared = 37.343, df = 5, p-value = 5.113e-07

  kwantyl_95_perm kwantyl_95_chi2 odsetek_perm_H_ponad_11.07 max_H_perm
1           10.78           11.07                     0.0436      26.19
  ile_perm_H_ponad_dane
1                     0
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (rangi, wzór na H i przetasowania – funkcje bazowe rank(), tapply(), sample(); test – funkcja kruskal.test() z pakietu stats; dane – pakiet datasets; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był William Kruskal?
Amerykańskim statystykiem (1919–2005), który niemal całe życie zawodowe spędził na Uniwersytecie Chicagowskim. Kierował tam wydziałem statystyki i był dziekanem nauk społecznych, przewodniczył Institute of Mathematical Statistics i American Statistical Association.
Dlaczego test nazywa się testem Kruskala–Wallisa?
Od nazwisk autorów artykułu z 1952 r. w Journal of the American Statistical Association: Williama Kruskala i jego starszego kolegi z Chicago, W. Allena Wallisa. Zaproponowali w nim rangowy odpowiednik jednoczynnikowej analizy wariancji.
Co wymyślił William Kruskal oprócz testu Kruskala–Wallisa?
Z Leo Goodmanem opracował serię miar związku dla tabel krzyżowych, z której pochodzą m.in. gamma i lambda Goodmana–Kruskala. Pisał też o liniowych modelach statystycznych bez układu współrzędnych, o historii pojęcia reprezentatywnej próby i redagował encyklopedie statystyki.
Czy to ten sam Kruskal, od którego pochodzi skalowanie wielowymiarowe?
Nie. Prace o skalowaniu wielowymiarowym i twierdzenie Kruskala w informatyce to dorobek jego młodszego brata, Josepha Kruskala z Bell Laboratories. Trzeci brat, Martin, był matematykiem z Princeton.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Fienberg, S. E., Stigler, S. M., & Tanur, J. M. (2007). The William Kruskal legacy: 1919–2005. Statistical Science, 22(2), 255–261. https://doi.org/10.1214/088342306000000420 ● Otwarty dostęp
- Goodman, L. A., & Kruskal, W. H. (1954). Measures of association for cross classifications. Journal of the American Statistical Association, 49(268), 732–764. https://doi.org/10.1080/01621459.1954.10501231
- Kruskal, W. H., & Wallis, W. A. (1952). Use of ranks in one-criterion variance analysis. Journal of the American Statistical Association, 47(260), 583–621. https://doi.org/10.1080/01621459.1952.10483441
- Vargha, A., & Delaney, H. D. (1998). The Kruskal-Wallis test and stochastic homogeneity. Journal of Educational and Behavioral Statistics, 23(2), 170–192. https://doi.org/10.3102/10769986023002170
Cytowania BibTeX
@article{fienberg2007william, author={Fienberg, Stephen E. and Stigler, Stephen M. and Tanur, Judith M.}, title={{The William Kruskal legacy: 1919–2005}}, journal={Statistical Science}, year={2007}, volume={22}, number={2}, pages={255--261}, doi={10.1214/088342306000000420}}@article{goodman1954measures, author={Goodman, Leo A. and Kruskal, William H.}, title={{Measures of association for cross classifications}}, journal={Journal of the American Statistical Association}, year={1954}, volume={49}, number={268}, pages={732--764}, doi={10.1080/01621459.1954.10501231}}@article{kruskal1952use, author={Kruskal, William H. and Wallis, W. Allen}, title={{Use of ranks in one-criterion variance analysis}}, journal={Journal of the American Statistical Association}, year={1952}, volume={47}, number={260}, pages={583--621}, doi={10.1080/01621459.1952.10483441}}@article{vargha1998kruskal, author={Vargha, András and Delaney, Harold D.}, title={{The Kruskal-Wallis test and stochastic homogeneity}}, journal={Journal of Educational and Behavioral Statistics}, year={1998}, volume={23}, number={2}, pages={170--192}, doi={10.3102/10769986023002170}}