Kim był Frank Wilcoxon?
Frank Wilcoxon (1892–1965) był chemikiem pracującym w Stanach Zjednoczonych w badaniach stosowanych, który w 1945 r. ogłosił dwa proste testy oparte na rangach. Dziś noszą jego nazwisko: test znakowanych rang dla par i test sumy rang dla dwóch grup. Urodził się 2 września 1892 r., zmarł 18 listopada 1965 r. (Bradley, 2001).
Jego publikacje pokazują drogę od laboratorium do statystyki. W 1928 r., jako pracownik Boyce Thompson Institute for Plant Research w Yonkers (stan Nowy Jork), oznaczał z Albertem Hartzellem ołów i arsen na jabłkach pryskanych arsenianem ołowiu (Hartzell i Wilcoxon, 1928). W 1947 r. podpisywał prace jako pracownik firmy chemicznej American Cyanamid w Stamford (Wilcoxon, 1947). Jego ostatnie prace, o sekwencyjnych testach rangowych, ukazały się z afiliacją Florida State University – część już po jego śmierci (Bradley i in., 1966). Statystyka była dla niego narzędziem praktyka: chciał szybko i bez długich rachunków sprawdzić, czy jeden sposób postępowania działa lepiej niż drugi.
Najważniejsze pomysły
- Testy rangowe (1945). W krótkim artykule w „Biometrics Bulletin” Wilcoxon (1945) zaproponował porównania oparte na rangach zamiast na surowych wynikach. Później podsumował, że metoda służy do szybkiego, przybliżonego sprawdzenia istotności różnicy między dwoma sposobami postępowania – dla prób niesparowanych, sparowanych i dla danych w grupach (Wilcoxon, 1947).
- Tablice (1947). Pierwsze tablice sum rang Wilcoxon policzył z własności podziałów liczb, co przy większej liczbie powtórzeń stawało się niewygodne. W 1947 r. podał tablice prawdopodobieństw i odnotował, że Mann i Whitney opisali podobny test z własnymi tablicami (Wilcoxon, 1947).
- Sekwencyjne testy rangowe (lata 60.). Z L. J. Rhodesem i Ralphem A. Bradleyem opracował testy, w których obserwacje zbiera się grupami, a po każdej grupie decyduje: przyjąć jedną z hipotez albo zbierać dalej. Autorzy opisali je jako bezpośrednie zastosowanie analizy sekwencyjnej Abrahama Walda, z myślą o eksperymentach przesiewowych (Wilcoxon i in., 1963).
Wspólny pomysł: gdy wyniki zastąpi się rangami, rozkład statystyki przy hipotezie zerowej zależy tylko od liczebności, a nie od kształtu rozkładu danych. Tablice wystarczy więc policzyć raz – dlatego testy rangowe przez dekady były „testami z tablic”.
Przykład na historycznych danych
Zbiór sleep z pakietu datasets zawiera przyrost snu (w godzinach, względem kontroli) u 10 pacjentów po dwóch lekach nasennych. Według pliku pomocy pochodzi z pracy Cushny’ego i Peeblesa z 1905 r. i był użyty przez Studenta w 1908 r. – ten sam, na którym William Gosset pokazywał test t. Tu liczymy go metodą Wilcoxona.
Różnice „lek 2 minus lek 1” to 1.2, 2.4, 1.3, 1.3, 0.0, 1.0, 1.8, 0.8, 4.6 i 1.4 godziny. Jedno zero się pomija, zostaje n = 9 różnic i wszystkie są dodatnie, więc suma rang różnic dodatnich osiąga maksimum: V = 45. Funkcja wilcox.test() przy remisie (dwa razy 1.3) i zerze nie liczy dokładnego p i podaje przybliżenie normalne: p = .009. Dokładne p policzymy sami: przy hipotezie zerowej każdy z 29 = 512 układów znaków jest równie prawdopodobny, a tak skrajne jak w danych są tylko 2 – stąd p = .0039 (dwustronnie). Dla porównania test t dla prób zależnych daje t(9) = 4.06, p = .003, a test znaków p = .0039.
Różnicę podejść widać po jednej zmianie: gdyby największą różnicę zapisano omyłkowo jako 46 zamiast 4.6 godziny, V nadal wynosiłoby 45, a t spadłoby do 1.28 (p = .234). Rangi nie „widzą”, o ile skrajny wynik odstaje – tylko że jest największy.
Na rysunku
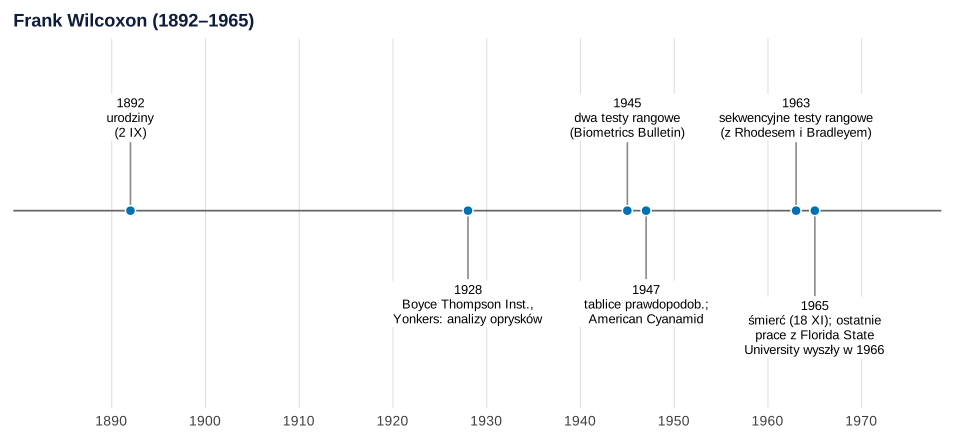
Co widać. Prace statystyczne Wilcoxona zaczynają się, gdy miał ponad 50 lat – wcześniej publikował jako chemik, np. o pozostałościach oprysków na jabłkach. Najważniejsze pomysły skupiają się w latach 1945–1947, a ostatnia dekada to testy sekwencyjne.
Na co uważać. Oś pokazuje tylko zdarzenia potwierdzone w cytowanych pracach – afiliacje odczytane z jego publikacji, a nie pełny przebieg zatrudnienia. Brak punktu nie znaczy, że w danym okresie nic się nie działo.
Podpis do pracy:
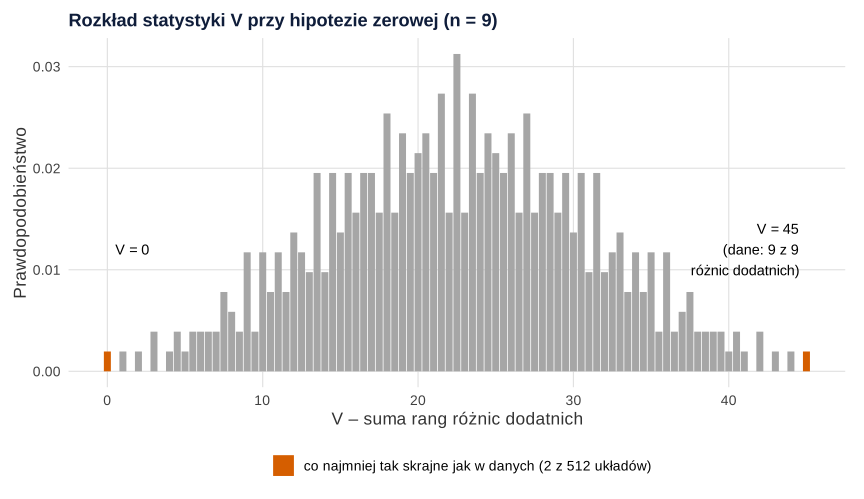
sleep. Obliczenia: R, pakiet ggplot2 (wszystkie 512 układów znaków, bez losowania).Co widać. Każdy słupek to prawdopodobieństwo jednej wartości V, gdy lek nie ma wpływu i znak każdej różnicy jest jak rzut monetą. Rozkład jest symetryczny wokół 22.5. Wynik z danych (V = 45) leży na samym krańcu – razem z lustrzanym V = 0 to 2 z 512 układów, czyli p = .0039.
Na co uważać. Ząbkowanie słupków wynika z remisu (dwie różnice po 1.3 dostają rangę 4.5), więc V przyjmuje też wartości połówkowe. Przy tak małym n najmniejsze możliwe p jest ograniczone liczbą układów – przy n = 5 nawet wszystkie różnice dodatnie nie dadzą dwustronnie p < .05.
Podpis do pracy:
sleep w R).Gdzie spotkasz Wilcoxona w swojej pracy
- Dwa pomiary tych samych osób (przed–po, dwa warunki), gdy różnice są skośne albo dane porządkowe: test Wilcoxona dla par. W R to
wilcox.test(x, y, paired = TRUE)ze statystyką V. - Dwie niezależne grupy: test sumy rang Wilcoxona, czyli test U Manna–Whitneya; w R
wilcox.test(y ~ grupa)ze statystyką W. Jak go czytać na rysunkach, pokazuje wpis Test Manna–Whitneya w obrazkach. - Wielkość efektu: obok V lub W podaj korelację rangowo-dwuseryjną.
- Więcej niż dwie grupy lub pomiary: ta sama logika rang stoi za testem Kruskala–Wallisa i testem Friedmana (to już nie są testy Wilcoxona). Przegląd i wybór testu – testy nieparametryczne i testy nieparametryczne krok po kroku.
Spory, mity i trudne strony
- „Test Wilcoxona” to dwa testy. W pracy zawsze dopisz, który: znakowanych rang (pary) czy sumy rang (grupy niezależne).
- Pierwszeństwo. Test dla dwóch grup niezależnych opisali też Mann i Whitney w 1947 r., co odnotował sam Wilcoxon (1947). Stąd nazwy „test Wilcoxona–Manna–Whitneya” i „test U”. To ten sam test, nie konkurencyjne metody.
- „Nieparametryczny” nie znaczy „bez założeń”. Test znakowanych rang wymaga niezależnych par, a interpretacja jako test mediany różnic – w przybliżeniu symetrycznego rozkładu różnic.
- Nie wiemy wszystkiego. Popularne opowieści o dzieciństwie i studiach Wilcoxona pomijamy, bo nie potwierdziliśmy ich w źródłach, które tu cytujemy.
Test Wilcoxona na danych Studenta w R
Kod liczy test znakowanych rang na danych sleep, dokładny rozkład V przez przejrzenie wszystkich 512 układów znaków, test t i test znaków do porównania, a na końcu rysuje oba rysunki. Rysunki na stronie powstały z tych samych obiektów p1 i p2 z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
Test znakowanych rang i rozkład dokładny V
Kod R (test i rysunki 1–2)
# Frank Wilcoxon: test znakowanych rang na danych Cushny'ego i Peeblesa (datasets::sleep)
suppressPackageStartupMessages({library(ggplot2)})
kol <- c(skrajne = "#D55E00", inne = "grey65", zdarzenie = "#0072B2")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(),
                                               plot.title = element_text(face = "bold"))
data(sleep, package = "datasets")
# Różnica przyrostu snu (lek 2 minus lek 1) u każdego z 10 pacjentów
d <- with(sleep, extra[group == 2] - extra[group == 1])
d
# Test znakowanych rang (zero pominięte, rangi wiązane – przybliżenie normalne)
suppressWarnings(wilcox.test(d, exact = FALSE, correct = TRUE))
# Rozkład dokładny V: przy H0 każdy z 2^9 układów znaków jest jednakowo prawdopodobny
dn <- d[d != 0]; r <- rank(abs(dn)); n <- length(dn)
znaki <- as.matrix(expand.grid(rep(list(c(0, 1)), n)))
V0 <- as.vector(znaki %*% r)
V_obs <- sum(r[dn > 0])
round(c(n_bez_zera = n, V = V_obs, liczba_ukladow = length(V0),
        p_dokladne = mean(abs(V0 - mean(V0)) >= abs(V_obs - mean(V0)))), 4)
# Dla porównania: test t dla prób zależnych (Student) i test znaków
tt <- t.test(d)
round(c(t = unname(tt$statistic), df = unname(tt$parameter), p_t = tt$p.value,
        p_test_znakow = binom.test(sum(dn > 0), n)$p.value), 4)
# Gdyby największa różnica wynosiła 46 zamiast 4.6: V się nie zmienia, t – tak
d46 <- replace(d, which.max(d), 46)
round(c(V = sum(rank(abs(d46[d46 != 0]))[d46[d46 != 0] > 0]), t = unname(t.test(d46)$statistic),
        p_t = t.test(d46)$p.value), 4)
# Rysunek 2: rozkład dokładny V i wynik z danych
rozklad <- as.data.frame(table(V = V0)); rozklad$V <- as.numeric(as.character(rozklad$V))
rozklad$typ <- ifelse(abs(rozklad$V - mean(V0)) >= abs(V_obs - mean(V0)), "skrajne", "inne")
p2 <- ggplot(rozklad, aes(V, Freq / length(V0), fill = typ)) +
  geom_col(width = 0.45) +
  annotate("text", x = V_obs - 0.5, y = 0.012, label = "V = 45\n(dane: 9 z 9\nróżnic dodatnich)",
           hjust = 1, size = 3.8) +
  annotate("text", x = 0.5, y = 0.012, label = "V = 0", hjust = 0, size = 3.8) +
  scale_fill_manual(values = kol, breaks = "skrajne",
                    labels = "co najmniej tak skrajne jak w danych (2 z 512 układów)") +
  labs(title = "Rozkład statystyki V przy hipotezie zerowej (n = 9)",
       x = "V – suma rang różnic dodatnich", y = "Prawdopodobieństwo", fill = NULL) +
  motyw + theme(legend.position = "bottom")
# Rysunek 1: oś czasu (lata z cytowanych źródeł)
os <- data.frame(rok = c(1892, 1928, 1945, 1947, 1963, 1965),
                 opis = c("urodziny\n(2 IX)", "Boyce Thompson Inst.,\nYonkers: analizy oprysków",
                          "dwa testy rangowe\n(Biometrics Bulletin)", "tablice prawdopodob.;\nAmerican Cyanamid",
                          "sekwencyjne testy rangowe\n(z Rhodesem i Bradleyem)",
                          "śmierć (18 XI); ostatnie\nprace z Florida State\nUniversity wyszły w 1966"),
                 poziom = c(1, -1, 1, -1, 1, -1.25))
p1 <- ggplot(os, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_segment(aes(xend = rok, y = 0, yend = poziom * 0.55), colour = "grey55") +
  geom_point(size = 3, shape = 21, fill = kol[["zdarzenie"]], colour = "white", stroke = 0.8) +
  geom_label(aes(y = poziom * 0.75, label = paste0(rok, "\n", opis)), size = 3.4,
             linewidth = 0, fill = "white", lineheight = 0.95) +
  scale_x_continuous(breaks = seq(1890, 1970, 10), limits = c(1884, 1974)) +
  scale_y_continuous(limits = c(-1.45, 1.25)) +
  labs(title = "Frank Wilcoxon (1892–1965)", x = NULL, y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())
p1
p2
Wynik w R
 [1] 1.2 2.4 1.3 1.3 0.0 1.0 1.8 0.8 4.6 1.4

	Wilcoxon signed rank test with continuity correction

data:  d
V = 45, p-value = 0.009091
alternative hypothesis: true location is not equal to 0

    n_bez_zera              V liczba_ukladow     p_dokladne
        9.0000        45.0000       512.0000         0.0039
            t            df           p_t p_test_znakow
       4.0621        9.0000        0.0028        0.0039
      V       t     p_t
45.0000  1.2768  0.2336
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (testy – funkcje bazowe wilcox.test(), t.test(), binom.test(); dane – pakiet datasets; rysunki – pakiet ggplot2). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Kim był Frank Wilcoxon?
Chemikiem (1892–1965) pracującym w Stanach Zjednoczonych, m.in. w Boyce Thompson Institute w Yonkers i w firmie American Cyanamid, który w 1945 r. opublikował dwa testy oparte na rangach. Pod koniec życia zajmował się sekwencyjnymi testami rangowymi na Florida State University.
Co wymyślił Frank Wilcoxon?
Test znakowanych rang dla dwóch pomiarów tych samych osób i test sumy rang dla dwóch niezależnych grup (1945), tablice prawdopodobieństw do nich (1947) oraz – z Rhodesem i Bradleyem – sekwencyjne testy rangowe dla eksperymentów przesiewowych.
Dlaczego test Manna–Whitneya nazywa się też testem Wilcoxona?
Bo ten sam test dla dwóch grup niezależnych opisał Wilcoxon w 1945 r., a Mann i Whitney w 1947 r. podali jego wersję ze statystyką U i własnymi tablicami. To jeden test pod kilkoma nazwami – w R funkcja wilcox.test() zwraca dla dwóch grup statystykę W.
Dlaczego wynik testu Wilcoxona nie zależy od wartości skrajnych?
Bo test używa rang, a nie surowych wyników. Największa różnica dostaje najwyższą rangę bez względu na to, czy wynosi 4.6, czy 46. W danych sleep po takiej zmianie V zostaje równe 45, a statystyka t spada z 4.06 do 1.28.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Testy nieparametryczne krok po kroku
Kiedy test rangowy ma sens, Mann–Whitney, Wilcoxon, Kruskal–Wallis z testem Dunna i Friedman na jednym badaniu – z wielkością efektu i opisem APA.
Czytaj →PoradnikTest Manna–Whitneya w obrazkach
Rangi, wszystkie pary i P(X > Y), równe mediany a istotny wynik, mała próba i estymator Hodgesa–Lehmanna – pięć symulacji z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bradley, R. A. (2001). Frank Wilcoxon. In C. C. Heyde & E. Seneta (Eds.), Statisticians of the centuries (pp. 420–424). Springer. https://doi.org/10.1007/978-1-4613-0179-0_90
- Bradley, R. A., Merchant, S. D., & Wilcoxon, F. (1966). Sequential rank tests II. Modified two-sample procedures. Technometrics, 8(4), 615–623. https://doi.org/10.1080/00401706.1966.10490406
- Hartzell, A., & Wilcoxon, F. (1928). Analyses of sprayed apples for lead and arsenic. Journal of Economic Entomology, 21(1), 125–130. https://doi.org/10.1093/jee/21.1.125
- Wilcoxon, F. (1945). Individual comparisons by ranking methods. Biometrics Bulletin, 1(6), 80–83. https://doi.org/10.2307/3001968
- Wilcoxon, F. (1947). Probability tables for individual comparisons by ranking methods. Biometrics, 3(3), 119–122. https://doi.org/10.2307/3001946
- Wilcoxon, F., Rhodes, L. J., & Bradley, R. A. (1963). Two sequential two-sample grouped rank tests with applications to screening experiments. Biometrics, 19(1), 58–84. https://doi.org/10.2307/2527572
Cytowania BibTeX
@incollection{bradley2001frank, author={Bradley, Ralph A.}, title={{Frank Wilcoxon}}, booktitle={Statisticians of the centuries}, year={2001}, pages={420--424}, publisher={Springer}, doi={10.1007/978-1-4613-0179-0_90}}@article{bradley1966sequential, author={Bradley, Ralph A. and Merchant, Sarla D. and Wilcoxon, Frank}, title={{Sequential rank tests II. Modified two-sample procedures}}, journal={Technometrics}, year={1966}, volume={8}, number={4}, pages={615--623}, doi={10.1080/00401706.1966.10490406}}@article{hartzell1928analyses, author={Hartzell, Albert and Wilcoxon, Frank}, title={{Analyses of sprayed apples for lead and arsenic}}, journal={Journal of Economic Entomology}, year={1928}, volume={21}, number={1}, pages={125--130}, doi={10.1093/jee/21.1.125}}@article{wilcoxon1945individual, author={Wilcoxon, Frank}, title={{Individual comparisons by ranking methods}}, journal={Biometrics Bulletin}, year={1945}, volume={1}, number={6}, pages={80--83}, doi={10.2307/3001968}}@article{wilcoxon1947probability, author={Wilcoxon, Frank}, title={{Probability tables for individual comparisons by ranking methods}}, journal={Biometrics}, year={1947}, volume={3}, number={3}, pages={119--122}, doi={10.2307/3001946}}@article{wilcoxon1963two, author={Wilcoxon, Frank and Rhodes, L. J. and Bradley, Ralph A.}, title={{Two sequential two-sample grouped rank tests with applications to screening experiments}}, journal={Biometrics}, year={1963}, volume={19}, number={1}, pages={58--84}, doi={10.2307/2527572}}