Co to jest indeks kruchości?
Indeks kruchości (fragility index, FI) to najmniejsza liczba pacjentów, którym trzeba zmienić wynik, aby istotny wynik badania z wynikiem dwuwartościowym przestał być istotny. Walsh i in. (2014) zdefiniowali go tak: w grupie z mniejszą liczbą zdarzeń zamienia się kolejnych pacjentów bez zdarzenia na pacjentów ze zdarzeniem, licząc za każdym razem test dokładny Fishera, aż wartość p przekroczy 0.05. W 399 badaniach z czołowych czasopism medycznych mediana FI wyniosła 8, co czwarte badanie miało FI ≤ 3, a w 53% badań FI było mniejsze niż liczba osób utraconych z obserwacji.
Przykład
W symulowanym badaniu po 150 osób w ramieniu zdarzenie wystąpiło u 11 leczonych (7.3%) i 32 osób z grupy kontrolnej (21.3%). Ryzyko względne wynosi 0.34, NNT po zaokrągleniu w górę 8, a test Fishera daje p = .0008. Mimo tak małego p wystarczy 8 dodatkowych zdarzeń w grupie leczonej, by p wzrosło do .064. Iloraz kruchości (FI podzielone przez liczbę uczestników) to 8/300 = 0.027. Jeśli wyniku nie znamy u 9 osób, FI jest mniejszy od utraty uczestników i nieznane wyniki tych osób mogłyby zmienić wniosek.
Ograniczenia
Carter, McKie i Storlie (2017) w symulacjach pokazali, że FI jest prawie odwrotnością logarytmu p (ρ Spearmana = −0.94), czyli w dużej mierze przepakowaną wartością p. Przy stałym efekcie FI rośnie z liczebnością: w kodzie poniżej przy ryzyku 8% wobec 20% wynosi 5, 18 i 46 dla 150, 300 i 600 osób w ramieniu. FI nie mierzy więc siły efektu, a badania planowane na moc 80% z natury mają mały FI.
Na rysunku
Pierwszy rysunek pokazuje samą procedurę na danych z przykładu (set.seed(7281)), drugi – zależność z części o ograniczeniach.
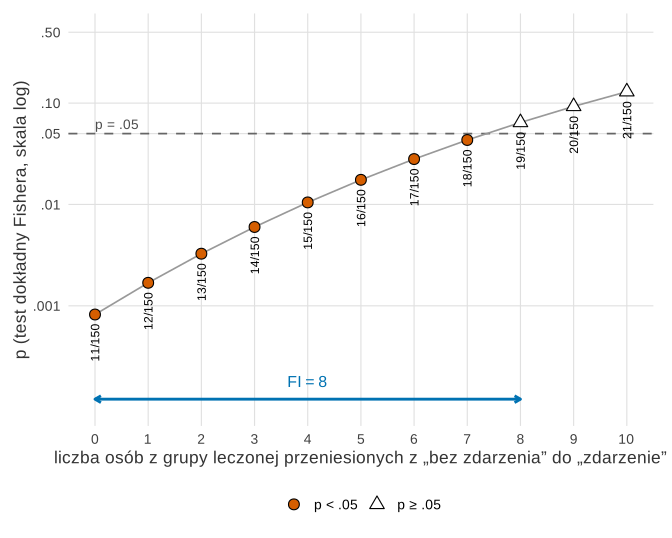
Co widać. Każdy krok to jedna osoba z grupy leczonej, której wynik zmieniamy z „bez zdarzenia” na „zdarzenie” (liczby pod punktami to zdarzenia na 150 leczonych). Na skali logarytmicznej p rośnie prawie liniowo: z .0008 do .043 po siedmiu zmianach i .064 po ósmej. Stąd FI = 8.
Na co uważać. Odległość od .0008 do .05 wygląda na dużą, a to tylko 8 osób z 300. Wykres nie mówi, czy taka zmiana jest prawdopodobna – to zależy od tego, ilu wyników nie znamy (tu 9) i dlaczego.
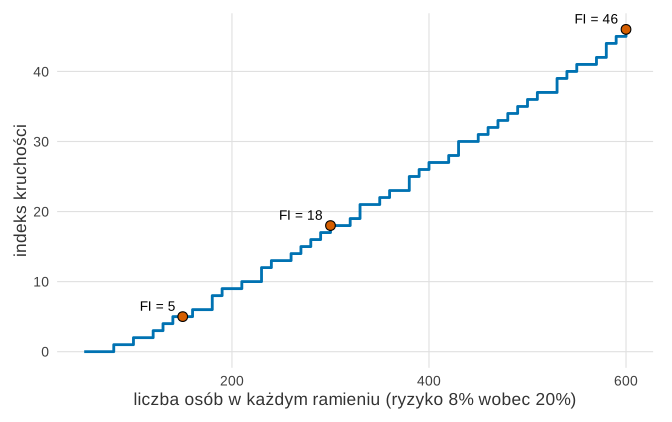
Co widać. Efekt jest wszędzie ten sam (RR = 0.4), a FI rośnie razem z liczebnością: od 0 przy 50 osobach w ramieniu (wynik nieistotny), przez 5 przy 150, do 46 przy 600. Tak jak p, FI mierzy głównie, jak daleko wynik jest od progu .05.
Na co uważać. Wysokiego FI w dużym badaniu nie czytaj jako silnego efektu, a niskiego w małym – jako słabego. Ryzyka zaokrąglono do pełnych zdarzeń, stąd schodki. Jak przy tym samym efekcie liczebność zmienia szansę na istotny wynik, pokazuje wpis Moc testu w obrazkach.
Kod poniżej odtwarza dane z przykładu i oba wykresy (tylko funkcje bazowe R i ggplot2). Rysunki na stronie różnią się od wyniku kodu tylko motywem (czcionka, siatka).
Kod R rysunków 1 i 2
library(ggplot2)
kol <- c(akcent = "#D55E00", drugi = "#0072B2")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(legend.position = "bottom", panel.grid.minor = element_blank())
set.seed(7281)                                          # dane z przykładu: po 150 osób w ramieniu
n <- 150
zdarz_L <- rbinom(1, n, 0.08)
zdarz_K <- rbinom(1, n, 0.20)
p_fisher <- function(a, b, n1, n2) fisher.test(matrix(c(a, n1 - a, b, n2 - b), 2))$p.value
indeks_kruchosci <- function(a, b, n1, n2, alfa = 0.05) {
  if (p_fisher(a, b, n1, n2) >= alfa) return(0)
  fi <- 0
  while (p_fisher(a, b, n1, n2) < alfa) { if (a <= b) a <- a + 1 else b <- b + 1; fi <- fi + 1 }
  fi
}
# Rysunek 1: p po kolejnych zmianach wyniku w grupie leczonej
kroki <- data.frame(k = 0:10)
kroki$p <- sapply(kroki$k, function(k) p_fisher(zdarz_L + k, zdarz_K, n, n))
kroki$zdarzenia <- paste0(zdarz_L + kroki$k, "/", n)
FI <- min(kroki$k[kroki$p >= .05])
kroki$stan <- factor(ifelse(kroki$p < .05, "p < .05", "p ≥ .05"), c("p < .05", "p ≥ .05"))
c(zdarz_L = zdarz_L, zdarz_K = zdarz_K, FI = FI)
print(transform(kroki[, c("k", "zdarzenia")], p = round(kroki$p, 4)), row.names = FALSE)
p1 <- ggplot(kroki, aes(k, p)) +
  geom_hline(yintercept = 0.05, colour = "grey40", linetype = "dashed") +
  annotate("text", x = 0, y = 0.062, label = "p = .05", hjust = 0, size = 3.6, colour = "grey30") +
  geom_line(colour = "grey60") +
  geom_point(aes(shape = stan, fill = stan), size = 3.4) +
  geom_text(aes(label = zdarzenia), angle = 90, hjust = 1.25, size = 3.2) +
  annotate("segment", x = 0, xend = FI, y = 0.00012, yend = 0.00012, colour = kol[["drugi"]], linewidth = 1,
           arrow = arrow(length = unit(0.18, "cm"), ends = "both")) +
  annotate("text", x = FI / 2, y = 0.00018, label = paste("FI =", FI), colour = kol[["drugi"]], size = 4.2) +
  scale_shape_manual(values = c(21, 24), name = NULL) +
  scale_fill_manual(values = c(kol[["akcent"]], "white"), name = NULL) +
  scale_y_log10(limits = c(0.0001, 0.5), breaks = c(0.001, 0.01, 0.05, 0.1, 0.5), labels = c(".001", ".01", ".05", ".10", ".50")) +
  scale_x_continuous(breaks = 0:10) +
  labs(x = "liczba osób z grupy leczonej przeniesionych z „bez zdarzenia” do „zdarzenie”",
       y = "p (test dokładny Fishera, skala log)") + motyw
# Rysunek 2: ten sam efekt (8% wobec 20%), rosnąca liczebność – FI rośnie
siatka <- data.frame(n = seq(50, 600, by = 10))
siatka$FI <- sapply(siatka$n, function(m) indeks_kruchosci(round(0.08 * m), round(0.20 * m), m, m))
siatka[siatka$n %in% c(50, 100, 150, 300, 600), ]
p2 <- ggplot(siatka, aes(n, FI)) +
  geom_step(colour = kol[["drugi"]], linewidth = 1) +
  geom_point(data = subset(siatka, n %in% c(150, 300, 600)), shape = 21, fill = kol[["akcent"]], size = 3) +
  geom_text(data = subset(siatka, n %in% c(150, 300, 600)), aes(label = paste("FI =", FI)), hjust = 1.2, vjust = -0.6,
            size = 3.6) +
  labs(x = "liczba osób w każdym ramieniu (ryzyko 8% wobec 20%)", y = "indeks kruchości") + motyw
# print(p1); print(p2)   # albo: ggsave("rysunek-1.svg", p1, width = 7, height = 5.6)
Wynik w R
zdarz_L zdarz_K      FI
     11      32       8
  k zdarzenia      p
  0    11/150 0.0008
  1    12/150 0.0017
  2    13/150 0.0033
  3    14/150 0.0060
  4    15/150 0.0105
  5    16/150 0.0175
  6    17/150 0.0280
  7    18/150 0.0433
  8    19/150 0.0644
  9    20/150 0.0927
 10    21/150 0.1295
     n FI
1   50  0
6  100  2
11 150  5
26 300 18
56 600 46
Jak opisać w pracy
Na co uważać
- Tylko istotne wyniki dwuwartościowe. Dla wyniku nieistotnego FI = 0 i nic nie mówi.
- Brak progu. Porównuj FI z utratą uczestników, a nie z umowną granicą.
- Uzupełnienie, nie zamiennik. Podawaj efekt z przedziałem ufności i pełną analizę wrażliwości.
Mały FI to sygnał, by ostrożnie mówić o replikowalności wyniku. Co oznacza samo p, wyjaśnia wpis Wartość p – interpretacja.
Indeks kruchości w R
Kod symuluje badanie z dwoma ramionami, liczy ryzyko, RR, NNT i test dokładny Fishera, a potem w pętli zamienia pacjentów bez zdarzenia na pacjentów ze zdarzeniem w grupie z mniejszą liczbą zdarzeń, aż p ≥ .05. Na końcu pokazuje, jak FI rośnie z liczebnością przy tym samym efekcie. Liczby w tekście pochodzą z tego kodu.
Indeks kruchości pętlą z fisher.test
R
set.seed(7281)
n <- 150                                              # osób w każdym ramieniu (dane symulowane)
zdarz_L <- rbinom(1, n, 0.08)                         # zdarzenia: grupa leczona
zdarz_K <- rbinom(1, n, 0.20)                         # zdarzenia: grupa kontrolna
p_fisher <- function(a, b, n1, n2) fisher.test(matrix(c(a, n1 - a, b, n2 - b), 2))$p.value
indeks_kruchosci <- function(a, b, n1, n2, alfa = 0.05) {
  if (p_fisher(a, b, n1, n2) >= alfa) return(0)
  fi <- 0
  while (p_fisher(a, b, n1, n2) < alfa) {             # w grupie z mniejszą liczbą zdarzeń
    if (a <= b) a <- a + 1 else b <- b + 1             # zmieniamy brak zdarzenia na zdarzenie
    fi <- fi + 1
  }
  fi
}
c(leczona = zdarz_L, kontrola = zdarz_K)
round(c(ryzyko_L = zdarz_L / n, ryzyko_K = zdarz_K / n, RR = (zdarz_L / n) / (zdarz_K / n),
        NNT = 1 / (zdarz_K / n - zdarz_L / n), p = p_fisher(zdarz_L, zdarz_K, n, n)), 4)
FI <- indeks_kruchosci(zdarz_L, zdarz_K, n, n)
c(FI = FI, utraceni_z_obserwacji = 9)                 # 9 osób bez danych o wyniku (założenie)
round(FI / (2 * n), 4)                                # iloraz kruchości (fragility quotient)
round(sapply(0:FI, function(k) p_fisher(zdarz_L + k, zdarz_K, n, n)), 4)  # p po kolejnych zmianach
# to samo ryzyko 8% i 20% (RR = 0.4), większe próby: FI rośnie z n
sapply(c(n150 = 150, n300 = 300, n600 = 600), function(m)
  indeks_kruchosci(round(0.08 * m), round(0.20 * m), m, m))
Wynik w R
 leczona kontrola
      11       32
ryzyko_L ryzyko_K       RR      NNT        p
  0.0733   0.2133   0.3438   7.1429   0.0008
                   FI utraceni_z_obserwacji
                    8                     9
[1] 0.0267
[1] 0.0008 0.0017 0.0033 0.0060 0.0105 0.0175 0.0280 0.0433 0.0644
n150 n300 n600
   5   18   46
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe, m.in. fisher.test()); Rysunki 1 i 2 wykonano w pakiecie ggplot2. W pracy podaj wersje R i pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Jak policzyć indeks kruchości?
Weź tabelę 2×2 z istotnym wynikiem. W grupie z mniejszą liczbą zdarzeń zamieniaj po jednym pacjencie bez zdarzenia na pacjenta ze zdarzeniem i za każdym razem licz test dokładny Fishera. Liczba zmian potrzebnych, by p ≥ .05, to indeks kruchości.
Jaki indeks kruchości jest mały?
Nie ma progu. Walsh i in. (2014) w 399 badaniach z czołowych czasopism medycznych uzyskali medianę 8, a w co czwartym badaniu indeks wynosił 3 lub mniej. Szczególnie niepokoi indeks mniejszy niż liczba osób utraconych z obserwacji.
Czy indeks kruchości mierzy siłę efektu?
Nie. Jest silnie związany z wartością p i rośnie z liczebnością próby przy tym samym efekcie. Siłę efektu opisuj ryzykiem względnym, różnicą ryzyka lub NNT z przedziałem ufności.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Carter, R. E., McKie, P. M., & Storlie, C. B. (2017). The Fragility Index: A P-value in sheep's clothing? European Heart Journal, 38(5), 346–348. https://doi.org/10.1093/eurheartj/ehw495
- Walsh, M., Srinathan, S. K., McAuley, D. F., Mrkobrada, M., Levine, O., Ribic, C., Molnar, A. O., Dattani, N. D., Burke, A., Guyatt, G., Thabane, L., Walter, S. D., Pogue, J., & Devereaux, P. J. (2014). The statistical significance of randomized controlled trial results is frequently fragile: A case for a Fragility Index. Journal of Clinical Epidemiology, 67(6), 622–628. https://doi.org/10.1016/j.jclinepi.2013.10.019 ● Otwarty dostęp
Cytowania BibTeX
@article{carter2017fragility, author={Carter, Rickey E. and McKie, Paul M. and Storlie, Curtis B.}, title={{The Fragility Index: A P-value in sheep's clothing?}}, journal={European Heart Journal}, year={2017}, volume={38}, number={5}, pages={346--348}, doi={10.1093/eurheartj/ehw495}}@article{walsh2014statistical, author={Walsh, Michael and Srinathan, Sadeesh K. and McAuley, Daniel F. and Mrkobrada, Marko and Levine, Oren and Ribic, Christine and Molnar, Amber O. and Dattani, Neil D. and Burke, Andrew and Guyatt, Gordon and Thabane, Lehana and Walter, Stephen D. and Pogue, Janice and Devereaux, P. J.}, title={{The statistical significance of randomized controlled trial results is frequently fragile: A case for a Fragility Index}}, journal={Journal of Clinical Epidemiology}, year={2014}, volume={67}, number={6}, pages={622--628}, doi={10.1016/j.jclinepi.2013.10.019}}