Co to jest estymacja dla małych obszarów?
Estymacja dla małych obszarów (ang. small area estimation, SAE) to zbiór metod szacowania średnich, odsetków lub sum dla powiatów, gmin czy wąskich podgrup, w których próba z badania ogólnokrajowego jest zbyt mała. Oszacowanie bezpośrednie, czyli średnia z kilku ankiet w powiecie, ma wtedy ogromny błąd standardowy. Rao i Molina (2015) opisują estymatory pośrednie, które „pożyczają siłę” z innych obszarów lub okresów i w ten sposób zwiększają efektywną liczebność próby. Dzielą modele na obszarowe (oszacowanie bezpośrednie a zmienne pomocnicze obszaru) i jednostkowe (wartości osób a ich cechy).
Jak to działa
Estymator złożony łączy oszacowanie bezpośrednie z syntetycznym, przewidzianym z regresji na zmiennych pomocniczych znanych dla wszystkich obszarów (spis, rejestry): θ̂i = γi·bezpośredni + (1 − γi)·syntetyczny, gdzie γi = σ²u/(σ²u + ψi). Im większa wariancja oszacowania bezpośredniego ψi, tym silniej wynik jest ściągany do części syntetycznej. Fay i Herriot (1979) zastosowali adaptację estymatora Jamesa–Steina z regresją przy nierównych wariancjach do dochodów w miejscowościach poniżej 1000 mieszkańców ze spisu z 1970 roku. Nowe oszacowania miały mniejszy przeciętny błąd niż oszacowania z próby i niż średnie hrabstw. To ten sam mechanizm ściągania co w modelu wielopoziomowym z losowym efektem obszaru (zob. efekty stałe i losowe).
Przykład
W 20 symulowanych powiatach liczba ankiet wynosi od 5 do 150. Wariancję efektów powiatów oszacowano metodą REML: σ²u = 9.04 (w symulacji prawdziwa wartość to 4). Przy n = 5 waga γ wynosi 0.31: oszacowanie bezpośrednie 36.04 przesuwa się do 30.95 przy prawdziwej wartości 31.55. Przy n = 150 (γ = 0.93) zmiana jest niewielka: z 32.58 na 32.44. Pierwiastek z błędu średniokwadratowego dla 20 powiatów spada z 3.77 do 1.42.
Na rysunku
Rysunek pokazuje 20 powiatów z przykładu (set.seed(670)): jak estymator złożony przesuwa oszacowania bezpośrednie i co to daje dla błędu.
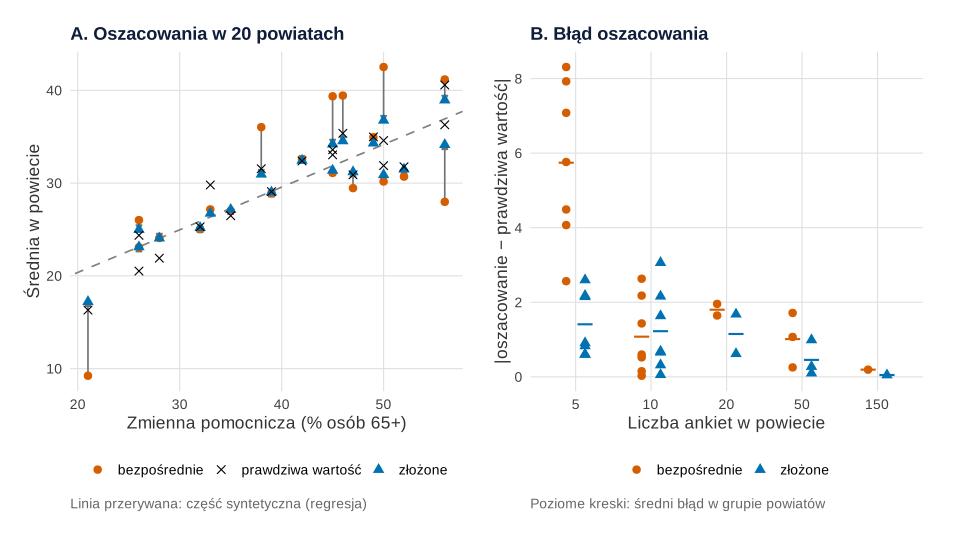
set.seed(670)).Co widać. W panelu A strzałka prowadzi od oszacowania bezpośredniego do złożonego, zawsze w stronę przerywanej prostej, czyli części syntetycznej. Długość strzałki zależy od dwóch rzeczy: jak daleko kółko leży od prostej i jak mała jest waga γ. W 7 powiatach z 5 ankietami (γ = 0.31) oszacowanie przesunęło się średnio o 5.01 punktu, a w powiecie ze 150 ankietami (γ = 0.93) tylko o 0.14. Panel B pokazuje, co to daje. Przy 5 ankietach średni błąd bezwzględny spadł z 5.74 do 1.41, a przy 50 ankietach z 1.01 do 0.45. Łącznie estymator złożony był bliżej prawdy w 15 z 20 powiatów.
Na co uważać. Zysk jest przeciętny, nie gwarantowany dla każdego powiatu. W grupie z 10 ankietami średni błąd złożonego był nawet trochę większy (1.22 wobec 1.08). Powiat, który naprawdę odbiega od prostej, zostanie do niej przyciągnięty, a jego odrębność zginie. Rysunek nie pokazuje też niepewności: przy każdym oszacowaniu warto podać MSE z mseFH(). W prawdziwych danych nie widać krzyżyków, więc nie da się w ten sposób sprawdzić błędu. Ten sam mechanizm w modelu mieszanym, ze ściąganiem do średniej ogólnej zamiast do prostej, pokazuje wpis Model mieszany w obrazkach.
Podpis do pracy:
Kod rysunku jest samowystarczalny. Rysunek na stronie powstał z tego samego kodu, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. Kurczenie oszacowań bezpośrednich do części syntetycznej w modelu Faya–Herriota
suppressPackageStartupMessages({library(sae); library(ggplot2); library(patchwork)})

kol <- c("bezpośrednie" = "#D55E00", "złożone" = "#0072B2", "prawdziwa wartość" = "#000000")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

set.seed(670)                                    # te same dane co w przykładzie w haśle
m <- 20
x <- round(runif(m, 20, 60))
theta <- 10 + 0.5 * x + rnorm(m, 0, 2)
n <- sample(c(5, 10, 20, 50, 150), m, replace = TRUE)
psi <- 10^2 / n
y_dir <- theta + rnorm(m, 0, sqrt(psi))
fh <- eblupFH(y_dir ~ x, vardir = psi, method = "REML")
s2u <- fh$fit$refvar
gamma <- s2u / (s2u + psi)
beta <- coef(lm(y_dir ~ x, weights = 1 / (s2u + psi)))
synt <- beta[1] + beta[2] * x                    # część syntetyczna
y_zl <- gamma * y_dir + (1 - gamma) * synt       # estymator złożony
d <- data.frame(x, n, theta, y_dir, y_zl, gamma,
                bl_dir = abs(y_dir - theta), bl_zl = abs(y_zl - theta))
# Średnio w grupach powiatów o tej samej liczbie ankiet: waga γ, przesunięcie i błędy bezwzględne
sr <- aggregate(cbind(gamma, przesuniecie = abs(y_zl - y_dir), bl_dir, bl_zl) ~ n, d, mean)
print(cbind(powiaty = as.vector(table(d$n)), round(sr, 2)), row.names = FALSE)
c(powiaty_blizej_prawdy = sum(d$bl_zl < d$bl_dir), z = m)

# Panel A: strzałki od oszacowania bezpośredniego do złożonego
pA <- ggplot(d, aes(x)) +
  geom_abline(intercept = beta[1], slope = beta[2], colour = "grey50", linetype = "dashed") +
  geom_segment(aes(y = y_dir, yend = y_zl, xend = x), colour = "grey45",
               arrow = arrow(length = unit(0.14, "cm"), type = "closed")) +
  geom_point(aes(y = y_dir, colour = "bezpośrednie", shape = "bezpośrednie"), size = 2.6) +
  geom_point(aes(y = y_zl, colour = "złożone", shape = "złożone"), size = 2.6) +
  geom_point(aes(y = theta, colour = "prawdziwa wartość", shape = "prawdziwa wartość"), size = 2.4) +
  scale_colour_manual(NULL, values = kol) +
  scale_shape_manual(NULL, values = c("bezpośrednie" = 16, "złożone" = 17, "prawdziwa wartość" = 4)) +
  labs(title = "A. Oszacowania w 20 powiatach", x = "Zmienna pomocnicza (% osób 65+)",
       y = "Średnia w powiecie", caption = "Linia przerywana: część syntetyczna (regresja)") + motyw

# Panel B: błąd bezwzględny obu oszacowań a liczba ankiet w powiecie
dB <- rbind(data.frame(n = d$n, blad = d$bl_dir, typ = "bezpośrednie"),
            data.frame(n = d$n, blad = d$bl_zl, typ = "złożone"))
pB <- ggplot(dB, aes(factor(n), blad, colour = typ, shape = typ)) +
  geom_point(size = 2.6, position = position_dodge(width = 0.5)) +
  stat_summary(fun = mean, geom = "crossbar", width = 0.4, linewidth = 0.3,
               position = position_dodge(width = 0.5), show.legend = FALSE) +
  scale_colour_manual(NULL, values = kol[1:2]) + scale_shape_manual(NULL, values = c(16, 17)) +
  labs(title = "B. Błąd oszacowania", x = "Liczba ankiet w powiecie",
       y = "|oszacowanie − prawdziwa wartość|", caption = "Poziome kreski: średni błąd w grupie powiatów") + motyw
p1 <- pA | pB
p1
Wynik w R
 powiaty   n gamma przesuniecie bl_dir bl_zl
       7   5  0.31         5.01   5.74  1.41
       7  10  0.47         0.76   1.08  1.22
       2  20  0.64         0.65   1.80  1.15
       3  50  0.82         0.56   1.01  0.45
       1 150  0.93         0.14   0.19  0.05
powiaty_blizej_prawdy                     z
                   15                    20
Jak opisać w pracy
Na co uważać
- Model, nie losowanie. Estymator złożony jest obciążony dla pojedynczego obszaru; zyskuje na średnim błędzie, a jakość zależy od zmiennych pomocniczych.
- Szacuj σ²u i MSE. W praktyce wariancję efektów szacuje się z danych (np. REML), a błąd średniokwadratowy podaje dla każdego obszaru. Oszacowania bezpośrednie liczy się zwykle estymatorem Horvitza–Thompsona z wagami doboru.
Estymator złożony w R
Kod symuluje 20 powiatów, liczy część syntetyczną regresją ważoną i estymator złożony z wariancją efektów oszacowaną funkcją sae::eblupFH() (REML). Obliczenie ręczne daje to samo co eblupFH(), a mseFH() podaje MSE dla każdego powiatu. Liczby w tekście pochodzą z tego kodu.
Oszacowanie bezpośrednie, waga γ i estymator złożony
R
set.seed(670)
m <- 20                                          # 20 powiatów (dane symulowane)
x <- round(runif(m, 20, 60))                     # zmienna pomocnicza z rejestru, np. % osób 65+
theta <- 10 + 0.5 * x + rnorm(m, 0, 2)           # prawdziwa średnia w powiecie
n <- sample(c(5, 10, 20, 50, 150), m, replace = TRUE)   # liczba ankiet w powiecie
psi <- 10^2 / n                                  # wariancja oszacowania bezpośredniego (SD = 10)
y_dir <- theta + rnorm(m, 0, sqrt(psi))          # oszacowanie bezpośrednie (średnia z próby)
library(sae)
fh <- eblupFH(y_dir ~ x, vardir = psi, method = "REML")   # model Faya–Herriota, σ²u szacowane metodą REML
s2u <- fh$fit$refvar                             # wariancja efektów powiatów (w symulacji prawdziwa: 4)
round(s2u, 2)
w <- 1 / (s2u + psi)
beta <- coef(lm(y_dir ~ x, weights = w))         # część syntetyczna: regresja ważona
synt <- beta[1] + beta[2] * x
gamma <- s2u / (s2u + psi)                       # waga oszacowania bezpośredniego
y_zl <- gamma * y_dir + (1 - gamma) * synt       # estymator złożony – ręcznie
all.equal(y_zl, fh$eblup[, 1], check.attributes = FALSE)   # TRUE: to samo co eblupFH()
mse <- mseFH(y_dir ~ x, vardir = psi)$mse        # błąd średniokwadratowy dla każdego powiatu
tab <- data.frame(n, prawda = theta, bezposr = y_dir, gamma, zlozony = y_zl, MSE = mse)
print(round(tab[order(tab$n), ][c(1:3, 18:20), ], 2), row.names = FALSE)
round(c(RMSE_bezposr = sqrt(mean((y_dir - theta)^2)),
        RMSE_zlozony = sqrt(mean((y_zl - theta)^2))), 2)
Wynik w R
[1] 9.04
[1] TRUE
   n prawda bezposr gamma zlozony  MSE
   5  31.55   36.04  0.31   30.95 7.59
   5  16.31    9.23  0.31   17.22 9.32
   5  33.60   39.36  0.31   34.20 7.61
  50  31.76   30.69  0.82   31.49 1.87
  50  25.29   25.04  0.82   25.19 1.86
 150  32.39   32.58  0.93   32.44 0.65
RMSE_bezposr RMSE_zlozony
        3.77         1.42
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet sae: eblupFH(), mseFH()). Rysunek 1 przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sae (wersja 1.4): Molina, I., & Marhuenda, Y. (2026). sae: Small area estimation (R package version 1.4) [Computer software]. https://doi.org/10.32614/CRAN.package.sae
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czy estymacja dla małych obszarów to to samo co model wielopoziomowy?
Model Faya–Herriota zawiera losowy efekt obszaru, więc jest bliski modelowi wielopoziomowemu. Różni je cel: SAE służy do przewidywania wartości dla konkretnych obszarów, a nie do szacowania efektów predyktorów.
Kiedy wystarczy oszacowanie bezpośrednie dla obszaru?
Gdy próba w obszarze jest na tyle duża, że błąd standardowy mieści się w przyjętym progu precyzji. Wtedy waga γ jest bliska 1 i estymator złożony niewiele zmienia.
Skąd wziąć zmienne pomocnicze do modelu małych obszarów?
Z danych znanych dla wszystkich obszarów, np. ze spisu powszechnego, rejestrów administracyjnych lub Banku Danych Lokalnych GUS. Muszą być mierzone jednakowo w każdym obszarze i silnie związane z badaną cechą.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Model wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikWażenie danych sondażowych krok po kroku
Wagi schematu, korekta braku odpowiedzi, raking w R, przycinanie wag, efektywna liczebność Kisha, błąd standardowy i wzór opisu.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Fay, R. E., & Herriot, R. A. (1979). Estimates of income for small places: An application of James–Stein procedures to census data. Journal of the American Statistical Association, 74(366a), 269–277. https://doi.org/10.1080/01621459.1979.10482505
- Rao, J. N. K., & Molina, I. (2015). Small area estimation. Wiley. https://doi.org/10.1002/9781118735855
Cytowania BibTeX
@article{fay1979estimates, author={Fay, Robert E. and Herriot, Roger A.}, title={{Estimates of income for small places: An application of James–Stein procedures to census data}}, journal={Journal of the American Statistical Association}, year={1979}, volume={74}, number={366a}, pages={269--277}, doi={10.1080/01621459.1979.10482505}}@book{rao2015small, author={Rao, J. N. K. and Molina, Isabel}, title={{Small area estimation}}, year={2015}, publisher={Wiley}, doi={10.1002/9781118735855}}