Co to jest błąd atomistyczny?
Błąd atomistyczny (ang. atomistic fallacy, nazywany też błędem indywidualistycznym, individualistic fallacy) to wnioskowanie o zależnościach między grupami – regionami, szkołami, firmami – na podstawie związku zmierzonego u pojedynczych osób. Jest odwrotnością błędu ekologicznego, w którym z danych zagregowanych wnioskuje się o osobach. Subramanian i in. (2009), analizując ponownie dane Robinsona ze spisu ludności USA z 1930 roku, pokazali, że groźne są oba błędy: związków indywidualnych nie da się poprawnie zinterpretować bez uwzględnienia dużych różnic między stanami.
Przykład
Zamożniejsi mieszkańcy regionu są zdrowsi od swoich sąsiadów, więc badacz pisze, że „bogatsze regiony mają zdrowszych mieszkańców”. W symulacji w R (30 regionów po 40 osób) nachylenie z regresji na wszystkich osobach wynosi 0.37. Po rozbiciu dochodu na odchylenie od średniej regionu i średnią regionu nachylenie wynosi 0.49 wewnątrz regionów i −0.22 między nimi. Regresja na średnich regionów także daje −0.22. W danych założono ujemny efekt średniego dochodu regionu, a analiza samych osób go nie pokazuje: daje zdanie o regionach odwrotne do prawdy.
Na rysunku
Rysunek pokazuje te same dane co przykład i kod w sekcji „Błąd atomistyczny w R” (30 regionów po 40 osób, to samo ziarno). Zamiast 1200 punktów narysowano prostą regresji w każdym regionie i średnie regionów.
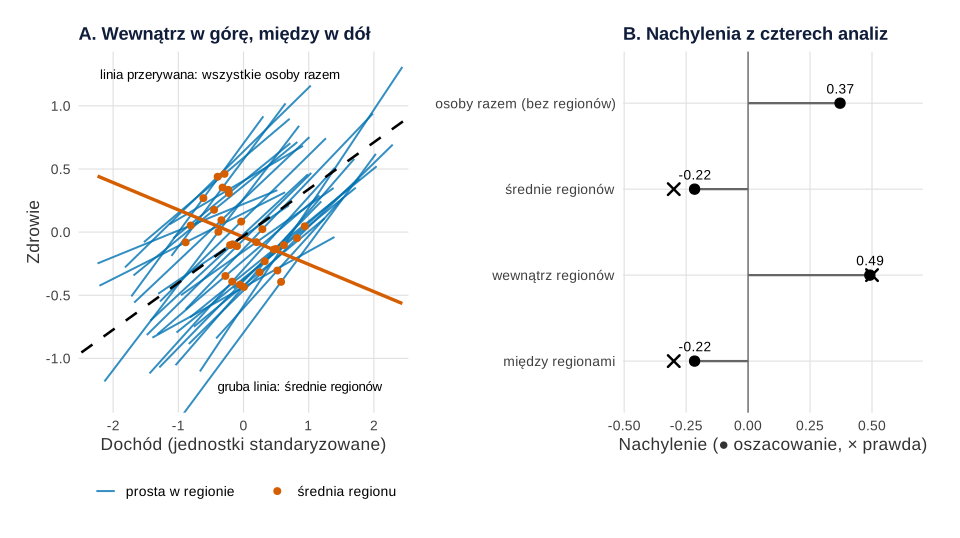
set.seed(585)).Co widać. W panelu A wszystkie 30 prostych w regionach rośnie: zamożniejszy od sąsiadów to zdrowszy. Średnie regionów układają się jednak wzdłuż prostej opadającej. Linia przerywana dla wszystkich osób razem rośnie (nachylenie 0.37), bo większość zróżnicowania dochodu leży wewnątrz regionów – ta linia mówi o osobach, nie o regionach. Panel B zestawia cztery nachylenia: analiza osób daje 0.37, a związek między regionami ma znak przeciwny (−0.22 z rozkładu na dwie części, tyle samo z regresji na średnich).
Na co uważać. Odcinki w panelu A są celowo krótkie (od 10. do 90. centyla dochodu w regionie) – nie przedłużaj ich poza dane. Nachylenie między regionami opiera się na 30 średnich, nie na 1200 osobach, więc ma większy błąd i trafia gorzej niż nachylenie wewnątrz (−0.22 wobec prawdziwego −0.30). Dla linii przerywanej nie ma jednej „prawdziwej” wartości: to mieszanina obu efektów. Podobne odwrócenie znaku po uwzględnieniu grup pokazuje wpis Paradoks Simpsona – wizualizacja, a modelowanie regionów jako efektów losowych – Model mieszany w obrazkach.
Podpis do pracy:
Kod rysunku jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. Związek dochodu ze zdrowiem wewnątrz regionów i między nimi (A) oraz nachylenia z czterech analiz (B)
library(ggplot2)
library(patchwork)

kol <- c(wewnatrz = "#0072B2", miedzy = "#D55E00")   # Okabe–Ito, czytelne przy deuteranopii
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

set.seed(585)                                   # te same dane co w sekcji „Błąd atomistyczny w R”
k <- 30; n <- 40                                # 30 regionów po 40 osób
region <- rep(1:k, each = n)
dochod_reg <- rnorm(k, sd = 0.5)                # średni dochód regionu
x <- dochod_reg[region] + rnorm(k * n)          # dochód osoby
y <- 0.50 * (x - dochod_reg[region]) - 0.30 * dochod_reg[region] + rnorm(k * n)
xc <- x - ave(x, region); xm <- ave(x, region)  # część wewnątrz i między regionami
srednie <- aggregate(cbind(x, y) ~ region, FUN = mean)
b <- c(osoby = unname(coef(lm(y ~ x))[2]),
       regiony = unname(coef(lm(y ~ x, data = srednie))[2]),
       wewnatrz = unname(coef(lm(y ~ xc + xm))["xc"]), miedzy = unname(coef(lm(y ~ xc + xm))["xm"]))
print(round(b, 2))

# A: krótka prosta w każdym regionie (od 10. do 90. centyla dochodu w regionie) i średnie regionów
odc <- do.call(rbind, lapply(1:k, function(j) {
  i <- region == j
  f <- coef(lm(y[i] ~ x[i])); q <- quantile(x[i], c(0.1, 0.9))
  data.frame(region = j, x = q[1], xend = q[2], y = f[1] + f[2] * q[1], yend = f[1] + f[2] * q[2])
}))
print(round(c(regionow_z_dodatnim_nachyleniem = sum(odc$yend > odc$y)), 0))
pA <- ggplot() +
  geom_segment(data = odc, aes(x, y, xend = xend, yend = yend, colour = "prosta w regionie"),
               linewidth = 0.7, alpha = 0.8) +
  geom_point(data = srednie, aes(x, y, shape = "średnia regionu"), size = 2.4, colour = kol[["miedzy"]]) +
  geom_smooth(data = srednie, aes(x, y), method = "lm", formula = y ~ x, se = FALSE,
              colour = kol[["miedzy"]], linewidth = 1.2, fullrange = TRUE) +
  geom_abline(intercept = coef(lm(y ~ x))[1], slope = b[["osoby"]], linetype = "dashed", linewidth = 0.9) +
  annotate("text", x = c(-2.2, -0.4), y = c(1.25, -1.22), hjust = 0, size = 3.5,
           label = c("linia przerywana: wszystkie osoby razem", "gruba linia: średnie regionów")) +
  scale_colour_manual(NULL, values = c("prosta w regionie" = kol[["wewnatrz"]])) +
  scale_shape_manual(NULL, values = c("średnia regionu" = 16)) +
  coord_cartesian(xlim = c(-2.3, 2.3), ylim = c(-1.3, 1.3)) +
  labs(x = "Dochód (jednostki standaryzowane)", y = "Zdrowie",
       title = "A. Wewnątrz w górę, między w dół")

# B: nachylenie dochodu w czterech analizach i wartości prawdziwe (0.50 i −0.30)
dB <- data.frame(analiza = factor(c("osoby razem (bez regionów)", "średnie regionów",
                                    "wewnątrz regionów", "między regionami"),
                                  rev(c("osoby razem (bez regionów)", "średnie regionów",
                                        "wewnątrz regionów", "między regionami"))),
                 b = unname(b), prawda = c(NA, -0.30, 0.50, -0.30))
pB <- ggplot(dB, aes(b, analiza)) +
  geom_vline(xintercept = 0, colour = "grey50") +
  geom_segment(aes(x = 0, xend = b, yend = analiza), linewidth = 0.8, colour = "grey40") +
  geom_point(size = 3.2) +
  geom_point(aes(x = prawda), shape = 4, size = 3.2, stroke = 1.3, na.rm = TRUE) +
  geom_text(aes(label = sprintf("%.2f", b)), vjust = -1, size = 3.6) +
  scale_x_continuous(limits = c(-0.45, 0.65)) +
  labs(x = "Nachylenie (● oszacowanie, × prawda)", y = NULL,
       title = "B. Nachylenia z czterech analiz")
p1 <- (pA | pB) + plot_layout(widths = c(1.1, 1)) & motyw
p1
Wynik w R
   osoby  regiony wewnatrz   miedzy
    0.37    -0.22     0.49    -0.22
regionow_z_dodatnim_nachyleniem
                             30
Jak go uniknąć
- Napisz wprost, na jakim poziomie stawiasz hipotezę: osób, grup czy obu.
- Przy danych zagnieżdżonych użyj modelu wielopoziomowego i rozdziel efekt wewnątrz- i międzygrupowy: centrowanie w grupach plus średnia grupy jako osobny predyktor.
- Różnicę obu nachyleń interpretuj jako efekt kontekstowy.
- Wnioski o grupach opieraj na liczbie grup, nie na liczbie osób.
Schwartz (1994) proponuje traktować problemy wnioskowania między poziomami jako kwestię trafności, która nie dotyczy wyłącznie analiz ekologicznych, i podkreśla samodzielną wartość zmiennych opisujących grupy.
Jak opisać w pracy
Na co uważać
Duża liczba osób nie zastępuje wielu grup: przy kilku szkołach o efekcie szkoły wiadomo niewiele. Agregacja danych nie jest błędem, gdy pytanie dotyczy grup. Odwrócenie kierunku związku po uwzględnieniu grup przypomina paradoks Simpsona. Krok po kroku rozdzielanie efektów pokazuje wpis model wielopoziomowy w R.
Błąd atomistyczny w R
Kod symuluje osoby w regionach z dodatnim związkiem dochodu ze zdrowiem wewnątrz regionów i ujemnym między nimi, a potem porównuje regresję na osobach, na średnich regionów i z rozkładem dochodu na dwie części.
Osoby, regiony i rozkład efektu
R
# Błąd atomistyczny: związek u osób nie mówi, jaki jest związek między regionami
set.seed(585)
k <- 30; n <- 40                            # 30 regionów po 40 osób
region <- rep(1:k, each = n)
dochod_reg <- rnorm(k, sd = 0.5)            # średni dochód regionu
x <- dochod_reg[region] + rnorm(k * n)      # dochód osoby
# zdrowie: +0.50 za dochód osoby względem regionu, -0.30 za średni dochód regionu
y <- 0.50 * (x - dochod_reg[region]) - 0.30 * dochod_reg[region] + rnorm(k * n)
osoby <- coef(lm(y ~ x))["x"]                         # analiza na osobach (bez regionów)
srednie <- aggregate(cbind(x, y) ~ region, FUN = mean)
regiony <- coef(lm(y ~ x, data = srednie))["x"]       # analiza na średnich regionów
xc <- x - ave(x, region); xm <- ave(x, region)        # część wewnątrz i między regionami
wm <- coef(lm(y ~ xc + xm))[c("xc", "xm")]
round(c(osoby = unname(osoby), regiony = unname(regiony),
        wewnatrz = unname(wm[1]), miedzy = unname(wm[2])), 2)
Wynik w R
   osoby  regiony wewnatrz   miedzy
    0.37    -0.22     0.49    -0.22
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Obliczenia nie wymagają dodatkowych pakietów; rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym błąd atomistyczny różni się od błędu ekologicznego?
Kierunkiem wnioskowania. Błąd ekologiczny przenosi związek z danych zagregowanych na osoby, a atomistyczny przenosi związek zmierzony u osób na grupy, np. regiony lub szkoły.
Czy model wielopoziomowy chroni przed błędem atomistycznym?
Tylko gdy rozdzielisz efekt wewnątrz grup i między grupami, np. centrowaniem w grupach i średnią grupy jako predyktorem. Sam losowy wyraz wolny miesza oba efekty w jednym nachyleniu.
Czy błąd atomistyczny dotyczy tylko badań regionalnych?
Nie. Dotyczy każdej struktury zagnieżdżonej: uczniów w klasach, pracowników w firmach, pomiarów w osobach. Związek wewnątrz jednostki wyższego poziomu może się różnić od związku między nimi.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Schwartz, S. (1994). The fallacy of the ecological fallacy: The potential misuse of a concept and the consequences. American Journal of Public Health, 84(5), 819–824. https://doi.org/10.2105/ajph.84.5.819 ● Otwarty dostęp: pełny tekst
- Subramanian, S. V., Jones, K., Kaddour, A., & Krieger, N. (2009). Revisiting Robinson: The perils of individualistic and ecologic fallacy. International Journal of Epidemiology, 38(2), 342–360. https://doi.org/10.1093/ije/dyn359 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{schwartz1994fallacy, author={Schwartz, Sharon}, title={{The fallacy of the ecological fallacy: The potential misuse of a concept and the consequences}}, journal={American Journal of Public Health}, year={1994}, volume={84}, number={5}, pages={819--824}, doi={10.2105/ajph.84.5.819}}@article{subramanian2009revisiting, author={Subramanian, S. V. and Jones, Kelvyn and Kaddour, Afamia and Krieger, Nancy}, title={{Revisiting Robinson: The perils of individualistic and ecologic fallacy}}, journal={International Journal of Epidemiology}, year={2009}, volume={38}, number={2}, pages={342--360}, doi={10.1093/ije/dyn359}}