Kim są Stephen Raudenbush i Anthony Bryk?
Stephen W. Raudenbush i Anthony S. Bryk to amerykańscy badacze edukacji, autorzy podręcznika Hierarchical Linear Models, od którego pochodzi jedna z nazw modelu wielopoziomowego – hierarchiczny model liniowy (HLM). Obaj żyją; piszemy tylko o ich pracy zawodowej.
Raudenbush całe studia odbył na Uniwersytecie Harvarda: licencjat w 1968 r., magisterium Ed.M. w 1980 r. i doktorat Ed.D. w 1984 r. Dziś jest profesorem socjologii i polityki publicznej na Uniwersytecie Chicagowskim (katedra Lewis-Sebring), członkiem National Academy of Sciences i American Academy of Arts and Sciences oraz laureatem nagrody American Educational Research Association za wybitny wkład w badania edukacyjne. Zajmuje się rozwojem umiejętności czytania i matematyki u małych dzieci i metodami oceny jakości szkół i klas (University of Chicago Department of Sociology, b.d.).
Bryk na Uniwersytecie Chicagowskim współtworzył Center for School Improvement (dziś Urban Education Institute) i Consortium on Chicago School Research. Napisał m.in. książki o doskonaleniu szkół: Trust in Schools (2002), Organizing Schools for Improvement (2010) i How a City Learned to Improve Its Schools (2023). W latach 2008–2020 był dziewiątym prezesem Carnegie Foundation for the Advancement of Teaching (UChicago Consortium on School Research, b.d.).
Najważniejsze pomysły
- Model efektów szkoły (1986). W „Sociology of Education” przedstawili ogólną metodę analizy danych hierarchicznych: średni wynik szkoły i to, jak silnie wynik ucznia zależy od jego pochodzenia, stają się „wynikami” na poziomie szkoły, a ich zróżnicowanie wyjaśnia się cechami szkół (Raudenbush i Bryk, 1986). To zapis modelu w dwóch równaniach, znany dziś z każdego podręcznika.
- „Hierarchical Linear Models” (1992, 2002). Na początku lat 90. Bryk i Raudenbush promowali w Chicago swoje podejście HLM, równolegle do szkoły londyńskiej Harveya Goldsteina (Gray i in., 2020). Drugie wydanie (Raudenbush i Bryk, 2002) rozszerzyło je o wyniki binarne, liczebności i dane porządkowe.
- Rzetelność średniej grupy. Średnia szkoły z próby uczniów jest tylko oszacowaniem jej prawdziwej średniej. Jej rzetelność λj = τ00 / (τ00 + σ²/nj) zależy od korelacji wewnątrzklasowej i liczby uczniów. Ta sama wielkość mówi, jak mocno model ściąga średnią szkoły ku średniej ogólnej.
- Efekty wewnątrz i między grupami. Predyktor ucznia rozkłada się na odchylenie od średniej grupy i samą średnią grupy (centrowanie względem średniej grupy). Różnica dwóch nachyleń to efekt kontekstowy.
Ciekawostka
Najsłynniejszy zbiór danych modeli wielopoziomowych narodził się ze sporu o to, czy szkoły katolickie uczą lepiej niż publiczne. Raudenbush i Bryk (1986) zilustrowali swój model właśnie ponowną analizą danych z badania High School and Beyond i tego sporu.
Wyciąg z tych danych – wyniki z matematyki 7185 uczniów ze 160 szkół z 1982 r. – posłużył im za przykład w podręczniku. Jest dostępny w pakiecie nlme jako MathAchieve i MathAchSchool, razem z sektorem szkoły: publiczna albo katolicka (Fox i Weisberg, 2015). Klasyczny przykład można więc powtórzyć w kilku liniach kodu.
Przykład na danych z pakietu R
Plik pomocy pakietu nlme opisuje zmienne: wynik z matematyki (MathAch), status społeczno-ekonomiczny ucznia (SES), płeć, przynależność do mniejszości i szkołę; pochodzenie danych podają Fox i Weisberg (2015). W szkołach było od 14 do 67 uczniów, średnio 44.9.
Model pusty. Średni wynik wynosi 12.64 punktu, wariancja średnich szkół τ00 = 8.61, a wariancja uczniów w szkole σ² = 39.15. ICC = .18: 18% zróżnicowania wyników przypada na różnice między szkołami.
Rzetelność. Rzetelność średniej szkoły waha się od .755 (14 uczniów) do .936 (67 uczniów), średnio .901. Średnie dużych szkół są więc dobrymi oszacowaniami, a najmniejsze szkoły model wyraźniej przyciąga do średniej ogólnej.
Efekt kontekstowy. Po rozłożeniu SES na odchylenie od średniej szkoły i średni SES szkoły uczeń o jednostkę zamożniejszy od kolegów z tej samej szkoły ma przeciętnie o 2.19 punktu wyższy wynik, a szkoła o jednostkę zamożniejsza – o 5.87 punktu. Różnica, 3.68 punktu, to efekt kontekstowy: przy tym samym własnym SES wynik jest wyższy w szkole o zamożniejszym składzie. Średni SES szkoły wyjaśnia 68.7% wariancji między szkołami (τ00 spada z 8.61 do 2.69).
Na rysunku
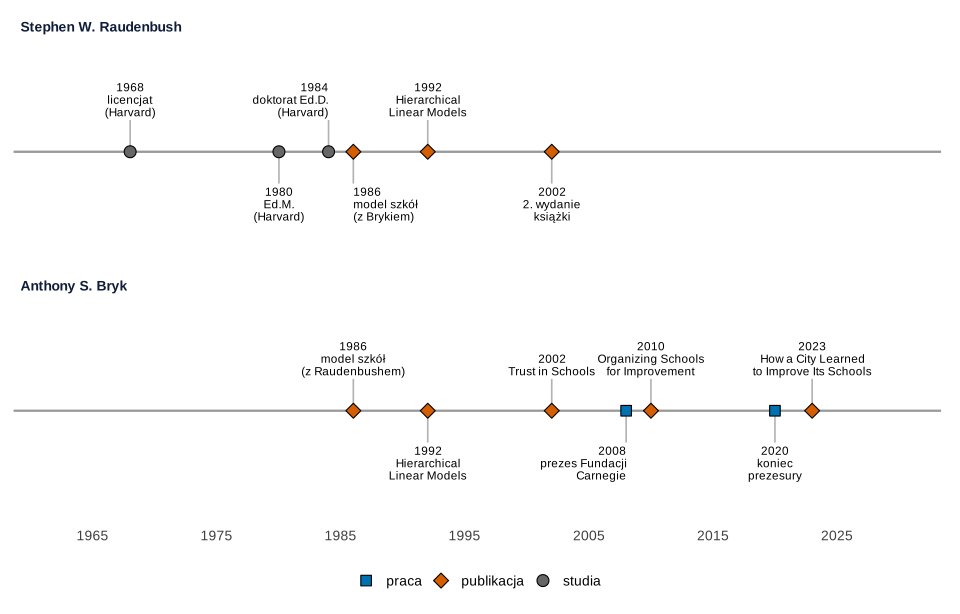
Co widać. Drogi obu autorów przecinają się w latach 1986–2002, gdy powstały wspólny artykuł i dwa wydania podręcznika. Potem Bryk zajął się głównie doskonaleniem szkół, a Raudenbush – badaniami rozwoju dzieci i jakości szkół.
Na co uważać. Oś pomija daty, których cytowane źródła nie podają, m.in. lata pracy obu autorów na kolejnych uczelniach.
Podpis do pracy:
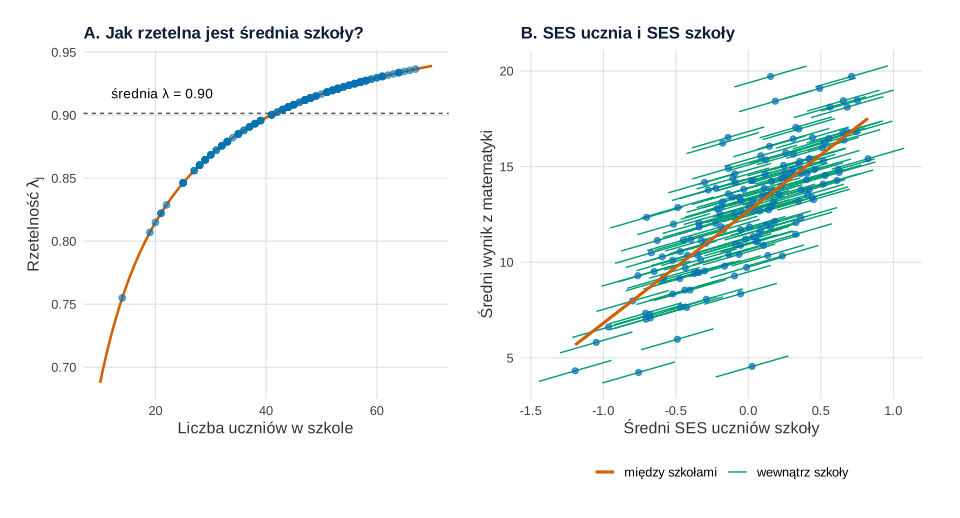
nlme::MathAchieve. Obliczenia i rysunek: R, pakiety nlme, ggplot2 i patchwork (bez losowania).Co widać. Panel A: rzetelność średniej szybko rośnie z liczbą uczniów i od około 40 uczniów przekracza .90. Panel B: zielone odcinki (zależność wewnątrz szkoły) są wyraźnie łagodniejsze niż pomarańczowa linia łącząca szkoły. Gdyby SES działał tylko na poziomie ucznia, linia i odcinki miałyby to samo nachylenie.
Na co uważać. Efekt kontekstowy to związek, nie dowód wpływu składu szkoły – zamożniejsze szkoły mogą różnić się też innymi cechami. Średni SES szkoły liczony z próby uczniów jest ponadto zmierzony z błędem.
Podpis do pracy:
Gdzie spotkasz Raudenbusha i Bryka w swojej pracy
Przy każdej analizie danych zagnieżdżonych – uczniów w klasach, pracowników w zespołach, pomiarów w osobach:
- zapis modelu w dwóch poziomach (γ00, τ00, u0j) i nazwa HLM pochodzą z ich podręcznika – krok po kroku pokazuje to wpis model wielopoziomowy w R;
- model pusty i ICC to pierwszy krok analizy; od nich zależy efekt schematu;
- rozdzielenie efektu wewnątrz i między grupami wymaga centrowania względem średniej grupy; bez niego łatwo o błąd ekologiczny;
- dalsze kroki to losowe nachylenia i interakcje międzypoziomowe, a przy danych podłużnych – modele wzrostu.
W R modele wielopoziomowe dopasowuje się zwykle pakietami nlme i lme4, z którymi związany jest Douglas Bates.
Spory, mity i trudne strony
- Model hierarchiczny to nie regresja hierarchiczna. Hierarchiczny model liniowy dotyczy danych zagnieżdżonych, a regresja hierarchiczna – wprowadzania predyktorów blokami. Nazwy są podobne, metody zupełnie różne.
- Czy szkoły katolickie są lepsze? Analiza z 1986 r. służyła pokazaniu metody na spornych danych. Cytowane źródła nie rozstrzygają sporu i nie należy tego robić na podstawie przykładu z podręcznika.
- HLM czy MLM? Te same modele w Wielkiej Brytanii rozwijał równolegle Harvey Goldstein (Gray i in., 2020); różnice w nazwach i oznaczeniach wynikają z tradycji, nie z innej statystyki.
Model Raudenbusha i Bryka w R
Kod wczytuje dane z pakietu nlme, dopasowuje model pusty (ICC), liczy rzetelność średnich szkół i model z SES rozłożonym na część wewnątrz szkoły i średnią szkoły, a potem rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje.
1. ICC, rzetelność i efekt kontekstowy: rysunek 2
Kod R rysunku 2
# Raudenbush i Bryk: model z losowym wyrazem wolnym, rzetelność średnich szkół i efekt kontekstowy – nlme::MathAchieve
suppressPackageStartupMessages({library(nlme); library(ggplot2); library(patchwork)})
kol <- c(szkola = "#0072B2", model = "#D55E00", wewnatrz = "#009E73")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(MathAchieve, package = "nlme")
d <- as.data.frame(MathAchieve)            # 7185 uczniów; MathAch – wynik z matematyki, SES – status społeczno-ekonomiczny
d$School <- factor(as.character(d$School))
n_j <- as.numeric(table(d$School))         # liczba uczniów w każdej ze 160 szkół
c(uczniowie = nrow(d), szkoly = nlevels(d$School))
summary(n_j)

# 1. Model pusty (jednoczynnikowa ANOVA z efektami losowymi): MathAch_ij = γ00 + u_0j + r_ij, REML
m0 <- lme(MathAch ~ 1, random = ~ 1 | School, data = d, method = "REML")
tau00 <- as.numeric(getVarCov(m0))         # wariancja średnich szkół
sigma2 <- m0$sigma^2                       # wariancja uczniów wewnątrz szkół
round(c(gamma00 = as.numeric(fixef(m0)), tau00 = tau00, sigma2 = sigma2, ICC = tau00 / (tau00 + sigma2)), 3)

# 2. Rzetelność średniej szkoły jako oszacowania jej prawdziwej średniej: λ_j = τ00 / (τ00 + σ² / n_j)
lambda <- tau00 / (tau00 + sigma2 / n_j)
round(c(lambda_min = min(lambda), lambda_srednia = mean(lambda), lambda_max = max(lambda)), 3)

# 3. Efekt wewnątrz szkół i między szkołami: SES centrowany względem średniej szkoły + średni SES szkoły
d$ses_sr <- ave(d$SES, d$School)           # średni SES uczniów szkoły w tych danych
d$ses_c  <- d$SES - d$ses_sr               # odchylenie ucznia od średniej jego szkoły
m1 <- lme(MathAch ~ ses_c + ses_sr, random = ~ 1 | School, data = d, method = "REML")
b <- fixef(m1)
round(summary(m1)$tTable[, c("Value", "Std.Error", "t-value")], 3)
round(c(wewnatrz_szkol = b[["ses_c"]], miedzy_szkolami = b[["ses_sr"]],
        efekt_kontekstowy = b[["ses_sr"]] - b[["ses_c"]]), 3)
tau00_m1 <- as.numeric(getVarCov(m1))
round(c(tau00_m1 = tau00_m1, spadek_tau00_proc = 100 * (1 - tau00_m1 / tau00)), 2)

# Rysunek: A – rzetelność λ_j a liczba uczniów; B – nachylenie wewnątrz szkół i między szkołami
szkoly <- data.frame(n = n_j, lambda = lambda,
                     ses_sr = tapply(d$SES, d$School, mean), mat_sr = tapply(d$MathAch, d$School, mean))
krzywa <- data.frame(n = seq(10, 70, by = 0.5))
krzywa$lambda <- tau00 / (tau00 + sigma2 / krzywa$n)
pA <- ggplot(szkoly, aes(n, lambda)) +
  geom_line(data = krzywa, colour = kol[["model"]], linewidth = 0.9) +
  geom_point(colour = kol[["szkola"]], alpha = 0.6, size = 2) +
  geom_hline(yintercept = mean(lambda), linetype = "22", colour = "grey35") +
  annotate("text", x = 12, y = mean(lambda) + 0.012, label = sprintf("średnia λ = %.2f", mean(lambda)),
           hjust = 0, vjust = 0, size = 3.6) +
  labs(title = "A. Jak rzetelna jest średnia szkoły?", x = "Liczba uczniów w szkole",
       y = expression(paste("Rzetelność ", lambda[j]))) +
  motyw
odc <- data.frame(x = szkoly$ses_sr - 0.25, xend = szkoly$ses_sr + 0.25,
                  y = szkoly$mat_sr - 0.25 * b[["ses_c"]], yend = szkoly$mat_sr + 0.25 * b[["ses_c"]])
linia <- data.frame(x = range(szkoly$ses_sr))
linia$y <- b[["(Intercept)"]] + b[["ses_sr"]] * linia$x
pB <- ggplot(szkoly, aes(ses_sr, mat_sr)) +
  geom_segment(data = odc, aes(x = x, xend = xend, y = y, yend = yend, linetype = "wewnątrz szkoły"),
               colour = kol[["wewnatrz"]], linewidth = 0.5) +
  geom_point(colour = kol[["szkola"]], alpha = 0.7, size = 1.8) +
  geom_line(data = linia, aes(x, y, linetype = "między szkołami"), colour = kol[["model"]], linewidth = 1.1) +
  scale_linetype_manual(values = c(`między szkołami` = "solid", `wewnątrz szkoły` = "solid"), name = NULL,
                        guide = guide_legend(override.aes = list(colour = c(kol[["model"]], kol[["wewnatrz"]]),
                                                                  linewidth = c(1.1, 0.5)))) +
  labs(title = "B. SES ucznia i SES szkoły", x = "Średni SES uczniów szkoły", y = "Średni wynik z matematyki") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1, 1.1))
p2
Wynik w R
uczniowie    szkoly
     7185       160
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
  14.00   35.00   47.00   44.91   54.00   67.00
gamma00   tau00  sigma2     ICC
 12.637   8.614  39.148   0.180
    lambda_min lambda_srednia     lambda_max
         0.755          0.901          0.936
             Value Std.Error t-value
(Intercept) 12.683     0.149  84.906
ses_c        2.191     0.109  20.164
ses_sr       5.866     0.362  16.218
   wewnatrz_szkol   miedzy_szkolami efekt_kontekstowy
            2.191             5.866             3.675
         tau00_m1 spadek_tau00_proc
             2.69             68.74
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Stephen W. Raudenbush i Anthony S. Bryk – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1968, 1980, 1984, 1986, 1992, 2002,
          1986, 1992, 2002, 2008, 2010, 2020, 2023),
  osoba = c(rep("Stephen W. Raudenbush", 6), rep("Anthony S. Bryk", 7)),
  opis = c("licencjat\n(Harvard)", "Ed.M.\n(Harvard)", "doktorat Ed.D.\n(Harvard)", "model szkół\n(z Brykiem)",
           "Hierarchical\nLinear Models", "2. wydanie\nksiążki",
           "model szkół\n(z Raudenbushem)", "Hierarchical\nLinear Models", "Trust in Schools", "prezes Fundacji\nCarnegie",
           "Organizing Schools\nfor Improvement", "koniec\nprezesury", "How a City Learned\nto Improve Its Schools"),
  rodzaj = c("studia", "studia", "studia", "publikacja", "publikacja", "publikacja",
             "publikacja", "publikacja", "publikacja", "praca", "publikacja", "praca", "publikacja"),
  poziom = c(0.5, -0.5, 0.5, -0.5, 0.5, -0.5,
             0.5, -0.5, 0.5, -0.5, 0.5, -0.5, 0.5),          # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.5, 0.5, 1, 0, 0.5, 0.5,
                 0.5, 0.5, 0.5, 1, 0.5, 0.5, 0.5))           # rozsunięcie bliskich etykiet
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
zdarzenia$osoba <- factor(zdarzenia$osoba, levels = c("Stephen W. Raudenbush", "Anthony S. Bryk"))
ksztalty <- c("studia" = 21, "praca" = 22, "publikacja" = 23)
kolory <- c("studia" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  facet_wrap(~ osoba, ncol = 1) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1962, 2030), breaks = seq(1965, 2025, by = 10)) +
  scale_y_continuous(limits = c(-1.6, 1.6)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        strip.text = element_text(face = "bold", hjust = 0), legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (modele z efektami losowymi – funkcja lme() z pakietu nlme, metoda REML; dane – pakiet nlme; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- nlme (wersja 3.1.168): Pinheiro, J., Bates, D., & R Core Team. (2025). nlme: Linear and nonlinear mixed effects models [R package]. https://doi.org/10.32614/CRAN.package.nlme
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim są Stephen Raudenbush i Anthony Bryk?
Amerykańskimi badaczami edukacji. Raudenbush (doktorat na Harvardzie w 1984 r.) jest profesorem socjologii na Uniwersytecie Chicagowskim i członkiem National Academy of Sciences. Bryk współtworzył Consortium on Chicago School Research, a w latach 2008–2020 kierował Carnegie Foundation for the Advancement of Teaching. Razem napisali podręcznik Hierarchical Linear Models.
Skąd nazwa HLM – hierarchiczny model liniowy?
Od tytułu podręcznika Raudenbusha i Bryka Hierarchical Linear Models (1992, drugie wydanie 2002). To ten sam model, który inni nazywają modelem wielopoziomowym albo liniowym modelem mieszanym. Nie należy go mylić z regresją hierarchiczną, czyli wprowadzaniem predyktorów blokami.
Co to jest rzetelność średniej grupy w modelu wielopoziomowym?
To stosunek wariancji prawdziwych średnich grup τ00 do wariancji średnich z próby: λj = τ00 / (τ00 + σ²/nj). W danych o 160 szkołach rzetelność wynosiła od .755 przy 14 uczniach do .936 przy 67, średnio .901. Im mniejsza rzetelność, tym silniej model ściąga średnią grupy ku średniej ogólnej.
Czym jest efekt kontekstowy w modelu wielopoziomowym?
To różnica między nachyleniem predyktora między grupami a nachyleniem wewnątrz grup, np. między efektem średniego SES szkoły a efektem SES ucznia na tle kolegów. W danych High School and Beyond nachylenia wyniosły 5.87 i 2.19 punktu, więc efekt kontekstowy to 3.68 punktu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Model wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikModele wzrostu w lme4
Losowy wyraz wolny i nachylenie czasu, kodowanie czasu, nieregularne terminy, predyktor × czas, braki MAR, porównanie z LGM i wzór opisu APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Fox, J., & Weisberg, S. (2015). Mixed-effects models in R: An appendix to An R Companion to Applied Regression, second edition. https://utstat.toronto.edu/reid/sta2101f/Appendix-Mixed-Models.pdf ● Otwarty dostęp
- Gray, J., Diamond, I., & Steele, F. (2020). Harvey Goldstein, 1939–2020. Biographical Memoirs of Fellows of the British Academy, 19, 357–376. https://www.thebritishacademy.ac.uk/documents/2681/19-Memoirs-16-Goldstein.pdf ● Otwarty dostęp
- Raudenbush, S. W., & Bryk, A. S. (2002). Hierarchical linear models: Applications and data analysis methods (2nd ed.). Sage.
- Raudenbush, S., & Bryk, A. S. (1986). A hierarchical model for studying school effects. Sociology of Education, 59(1), 1–17. https://doi.org/10.2307/2112482
- UChicago Consortium on School Research. (b.d.). Anthony S. Bryk. Pobrano 22 listopada 2026 z https://consortium.uchicago.edu/about/staff/Anthony-S.-Bryk ● Otwarty dostęp
- University of Chicago Department of Sociology. (b.d.). Stephen Raudenbush. Pobrano 22 listopada 2026 z https://sociology.uchicago.edu/directory/Stephen-Raudenbush ● Otwarty dostęp
Cytowania BibTeX
@misc{fox2015mixed, author={Fox, John and Weisberg, Sanford}, title={{Mixed-effects models in R: An appendix to An R Companion to Applied Regression, second edition}}, year={2015}, url={https://utstat.toronto.edu/reid/sta2101f/Appendix-Mixed-Models.pdf}}@article{gray2020harvey, author={Gray, John and Diamond, Ian and Steele, Fiona}, title={{Harvey Goldstein, 1939–2020}}, journal={Biographical Memoirs of Fellows of the British Academy}, year={2020}, volume={19}, pages={357--376}, publisher={The British Academy}, url={https://www.thebritishacademy.ac.uk/documents/2681/19-Memoirs-16-Goldstein.pdf}}@book{raudenbush2002hierarchical, author={Raudenbush, Stephen W. and Bryk, Anthony S.}, title={{Hierarchical linear models: Applications and data analysis methods (2nd ed.)}}, year={2002}, publisher={Sage}}@article{raudenbush1986hierarchical, author={Raudenbush, Stephen and Bryk, Anthony S.}, title={{A hierarchical model for studying school effects}}, journal={Sociology of Education}, year={1986}, volume={59}, number={1}, pages={1--17}, doi={10.2307/2112482}}@misc{uchicagoconsortiumbryknd, author={{UChicago Consortium on School Research}}, title={{Anthony S. Bryk}}, url={https://consortium.uchicago.edu/about/staff/Anthony-S.-Bryk}}@misc{uchicagoraudenbushnd, author={{University of Chicago Department of Sociology}}, title={{Stephen Raudenbush}}, url={https://sociology.uchicago.edu/directory/Stephen-Raudenbush}}