Kim jest Douglas Bates?
Douglas M. Bates to statystyk i twórca oprogramowania, profesor emeritus statystyki na Uniwersytecie Wisconsin w Madison. Jest głównym autorem pakietów R nlme i lme4 do modeli z efektami mieszanymi (wielopoziomowych), a później także pakietu MixedModels w języku Julia (Wong, 2022).
Doktorat ze statystyki uzyskał w 1978 r. na Queen’s University w Kingston w Kanadzie. Potem pracował na wydziale matematyki University of Alberta, a w 1980 r. przeszedł do Madison. W latach 1991–1994 kierował tamtejszym wydziałem statystyki. Od 1992 r. jest członkiem (Fellow) American Statistical Association. Był członkiem-założycielem zespołu R Development Core Team, który rozwija język R (Wong, 2022), i działał w nim przez 20 lat, do marca 2024 r. (Open Source Program Office, b.d.) Według profilu przygotowanego przez uczelnię także po przejściu na emeryturę pracuje z doktorantami i pracownikami wydziału (Open Source Program Office, b.d.).
Z wolnym oprogramowaniem zetknął się w latach 80. Zaskoczyło go wtedy, że otwarty edytor Emacs był lepszy od komercyjnego. Uczelnia uznawała jego pracę nad R i Julią za działalność badawczą (Open Source Program Office, b.d.).
Najważniejsze pomysły
- Regresja nieliniowa (1988). Z Donaldem G. Wattsem napisał podręcznik Nonlinear Regression Analysis and Its Applications. Łączy on teorię, praktykę i obliczenia modeli nieliniowych z geometrycznym ujęciem regresji liniowej (Bates i Watts, 1988).
- Nieliniowe modele mieszane (1990). Z Mary J. Lindstrom zaproponował ogólny nieliniowy model z efektami mieszanymi dla pomiarów powtarzanych. Estymatory łączą metodę najmniejszych kwadratów dla części nieliniowej z metodą największej wiarygodności albo REML dla części liniowej (Lindstrom i Bates, 1990).
- nlme i książka z 2000 r. Z José C. Pinheiro napisał monografię Mixed-Effects Models in S and S-PLUS (Pinheiro i Bates, 2000). Towarzyszący jej pakiet nlme pozwala modelować autokorelację i niejednorodną wariancję reszt (Bates i in., 2015).
- lme4 (2015). Następca nlme ma wydajniejszą algebrę macierzy, prostszy zapis efektów skrzyżowanych (np. osoby × bodźce), przedziały z profilu wiarygodności dla parametrów losowych i uogólnione modele mieszane. Losowe nachylenie zapisuje się w nim jako
(x | grupa)(Bates i in., 2015).
Ciekawostka
Najsłynniejsza cecha lme4 to coś, czego w nim nie ma. Funkcja lmer() nie podaje wartości p dla efektów stałych. Autorzy sami nazywają to jedną z bardziej kontrowersyjnych decyzji projektowych pakietu (Bates i in., 2015). Przy niezrównoważonych schematach lub efektach częściowo skrzyżowanych statystyki nie mają w skończonych próbach rozkładu t ani F. Przybliżone stopnie swobody (Satterthwaite, Kenward–Roger) są według autorów w najlepszym razie rozwiązaniami doraźnymi.
Zamiast wartości p pakiet ma stronę pomocy help("pvalues"). Wskazuje ona inne pakiety oraz podpowiada test ilorazu wiarygodności oraz przedziały ufności; sam lme4 oferuje też bootstrap parametryczny (Bates i in., 2015). Starszy nlme tego samego autora wartości p podaje – w przykładzie niżej widać obie tabele.
Przykład: losowe nachylenie na danych o braku snu
Zbiór sleepstudy z pakietu lme4 to według pliku pomocy średnie czasy reakcji (ms) z badania Belenky’ego i współpracowników (2003). To grupa, która spała 3 godziny na dobę, w pierwszych 10 dniach badania. Plik pomocy podaje, że dni 0–1 były adaptacją i treningiem, dzień 2 – pomiarem wyjściowym, a ograniczenie snu zaczęło się po dniu 2. Bierzemy więc dni 2–9 (18 osób, 144 pomiary) i liczymy dni od pomiaru wyjściowego.
Model ma losowy wyraz wolny i losowe nachylenie dla osoby (REML). lme4::lmer i nlme::lme dają identyczne wyniki (log-wiarygodność −702.047). Średni czas reakcji w dniu wyjściowym wynosi 267.97 ms i rośnie średnio o 11.44 ms na każdy dzień ograniczonego snu. SD wyrazów wolnych wynosi 30.96 ms, SD nachyleń 6.77 ms na dzień (korelacja .18), SD reszt 25.53 ms.
Tabela lme4 kończy się na t = 6.197. nlme do tego samego t dodaje 125 stopni swobody i p = 7.66·10⁻⁹. Test ilorazu wiarygodności względem modelu z samym losowym wyrazem wolnym daje χ²(2) = 25.93, p < .001. Bez losowego nachylenia błąd standardowy średniego nachylenia wynosi 1.10 zamiast 1.85 ms na dzień.
Na rysunku
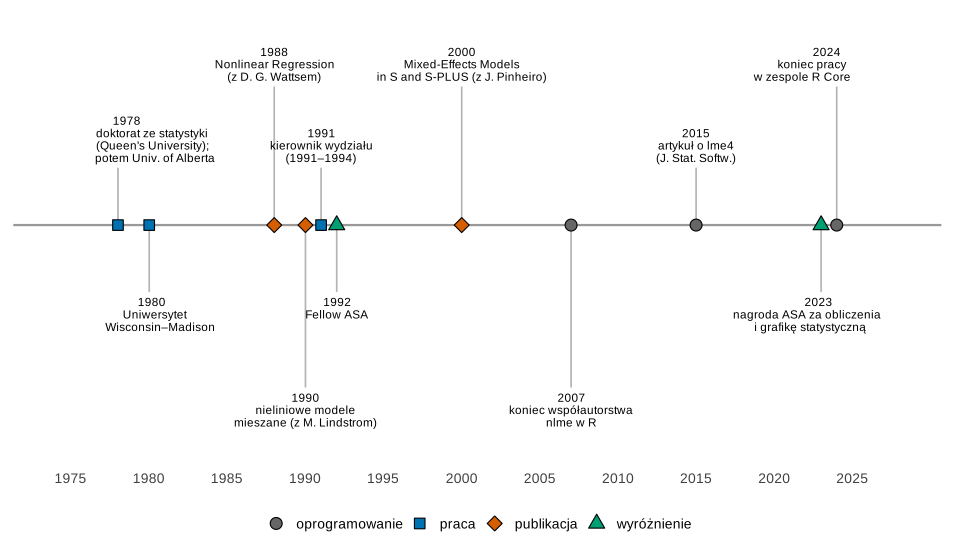
Co widać. Ponad 40 lat w Madison: od regresji nieliniowej, przez nieliniowe modele mieszane, po pakiety do modeli mieszanych w R.
Na co uważać. Daty przy oprogramowaniu to publikacje i zmiany ról, nie początek prac – źródła nie podają, od kiedy powstawały nlme i lme4.
Podpis do pracy:
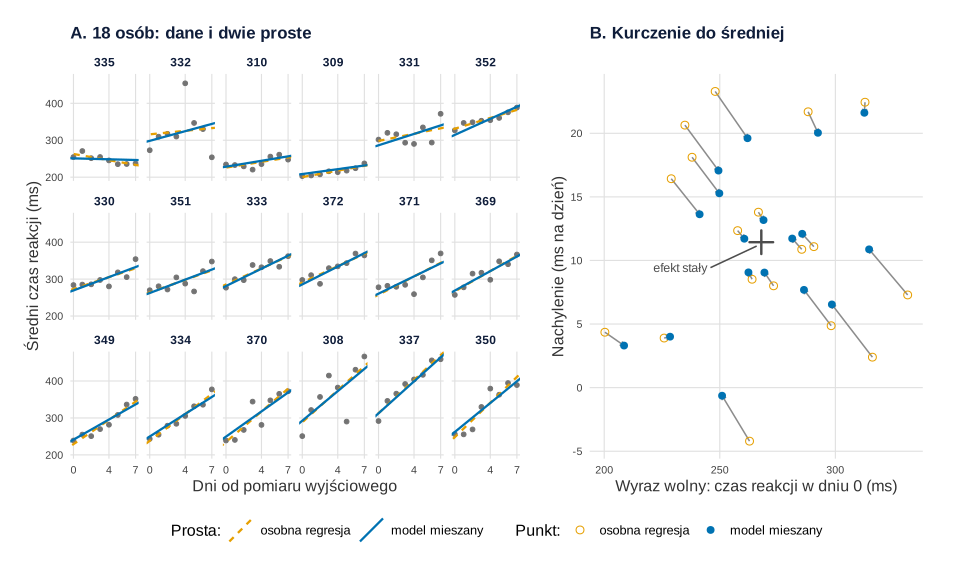
lme4::sleepstudy, dni 2–9. Obliczenia i rysunek: R, pakiety lme4, nlme, ggplot2 i patchwork.Co widać. W panelu A model mieszany prawie nie zmienia prostych osób z wieloma regularnymi pomiarami. Najmocniej poprawia osoby nietypowe. Osoba 335 w osobnej regresji „poprawia się” (−4.2 ms na dzień), a w modelu ma −0.6. U osoby 332 jeden bardzo wysoki i jeden bardzo niski pomiar spłaszczają prostą (2.4), a model podnosi nachylenie do 6.5. Panel B pokazuje to dla wszystkich osób naraz. Strzałki biegną na ogół w stronę efektu stałego, więc SD nachyleń maleje z 7.8 do 6.0 ms na dzień, a SD wyrazów wolnych – z 35.1 do 28.1 ms. To kurczenie do średniej.
Na co uważać. Kurczenie to kompromis między danymi osoby a danymi całej grupy, a nie błąd. Druga pułapka: artykuł o lme4 (Bates i in., 2015) opisuje dzień 0 jako noc normalnego snu i używa wszystkich 10 dni, a aktualny plik pomocy traktuje dni 0–1 jako trening. Wybór dni zmienia wyniki, więc trzeba go opisać.
Podpis do pracy:
Gdzie spotkasz Batesa w swojej pracy
- Każdy model mieszany w R. Formuła
y ~ x + (x | grupa)to zapis lme4. Jak zdecydować o losowym nachyleniu i REML czy ML, opisują hasła o efektach stałych i losowych i wpis o opisywaniu wyników modelu mieszanego. - Brak wartości p w
summary(). To zamierzone. W pracy podaj test ilorazu wiarygodności, przedział ufności albo wartości p z wybraną poprawką stopni swobody (np. Kenwarda–Rogera lub Satterthwaite’a) i napisz, którą metodą je policzono. - Ostrzeżenia o zbieżności. Co robić z komunikatami lme4 o dopasowaniu osobliwym (singular fit), opisuje wpis o singular fit i braku zbieżności.
- Autokorelacja reszt. Gdy pomiary w czasie są skorelowane ponad to, co wyjaśniają efekty losowe, przydaje się starszy nlme ze strukturami reszt (Bates i in., 2015).
Spory, mity i trudne strony
- Wartości p w modelach mieszanych. Spór nie dotyczy tego, czy liczyć niepewność, tylko tego, jak ją przybliżać w skończonych próbach. Bates i współautorzy (2015) uważają przybliżone stopnie swobody za rozwiązanie doraźne i proponują test ilorazu wiarygodności, bootstrap parametryczny lub przedziały z profilu. Inni autorzy dostarczają te poprawki w osobnych pakietach, do których odsyła strona
help("pvalues").
Losowe nachylenie w lme4 i nlme
Kod wybiera dni 2–9 ze zbioru sleepstudy, dopasowuje ten sam model z losowym wyrazem wolnym i losowym nachyleniem w lme4 i nlme, porównuje tabele efektów stałych, testuje losowe nachylenie, zestawia osobne regresje osób z przewidywaniami modelu i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje, więc nie ma ziarna.
1. Model z losowym nachyleniem i kurczenie: rysunek 2
Kod R rysunku 2
# Model z losowym nachyleniem na danych sleepstudy: lme4::lmer i nlme::lme, kurczenie do średniej
suppressPackageStartupMessages({library(lme4); library(nlme); library(ggplot2); library(patchwork)})
kol <- c(osobne = "#E69F00", model = "#0072B2", srednia = "grey30")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

# Dane: Belenky i in. (2003), grupa 3 godzin snu na dobę; według pliku pomocy dni 0–1 to adaptacja i trening,
# dzień 2 – pomiar wyjściowy, ograniczenie snu zaczęło się po dniu 2. Bierzemy dni 2–9 i liczymy dni od pomiaru wyjściowego.
data(sleepstudy, package = "lme4")
sen <- subset(sleepstudy, Days >= 2)
sen$dni <- sen$Days - 2
c(osoby = nlevels(droplevels(sen$Subject)), pomiary = nrow(sen))

# 1. Ten sam model w dwóch pakietach Batesa: losowy wyraz wolny i losowe nachylenie, REML
m_lme4 <- lmer(Reaction ~ dni + (dni | Subject), data = sen)
m_nlme <- lme(Reaction ~ dni, random = ~ dni | Subject, data = sen)
round(rbind(lme4 = fixef(m_lme4), nlme = fixef(m_nlme)), 2)
VarCorr(m_lme4)
round(rbind(lme4 = c(logLik = as.numeric(logLik(m_lme4))), nlme = c(logLik = as.numeric(logLik(m_nlme)))), 3)

# 2. Tabele efektów stałych: lme4 nie podaje wartości p, nlme podaje (test t z df wewnątrz osób)
round(coef(summary(m_lme4)), 3)
signif(summary(m_nlme)$tTable, 4)

# 3. Czy losowe nachylenie jest potrzebne? Test ilorazu wiarygodności (REML, ta sama część stała)
m0 <- lmer(Reaction ~ dni + (1 | Subject), data = sen)
anova(m0, m_lme4, refit = FALSE)
# błąd standardowy średniego nachylenia z losowym nachyleniem i bez niego
round(c(bez_losowego_nachylenia = coef(summary(m0))["dni", "Std. Error"],
        z_losowym_nachyleniem = coef(summary(m_lme4))["dni", "Std. Error"]), 2)

# 4. Kurczenie: osobne regresje każdej osoby a przewidywania modelu mieszanego
osobne <- t(sapply(split(sen, droplevels(sen$Subject)), function(d) coef(lm(Reaction ~ dni, data = d))))
mieszany <- as.matrix(coef(m_lme4)$Subject)
kurcz <- data.frame(osoba = rownames(osobne),
                    w0_osobne = osobne[, 1], nach_osobne = osobne[, 2],
                    w0_model = mieszany[rownames(osobne), 1], nach_model = mieszany[rownames(osobne), 2])
round(head(kurcz[order(kurcz$nach_osobne), -1], 4), 1)
round(c(SD_nachylen_osobne = sd(kurcz$nach_osobne), SD_nachylen_model = sd(kurcz$nach_model),
        SD_wyrazow_osobne = sd(kurcz$w0_osobne), SD_wyrazow_model = sd(kurcz$w0_model)), 1)
round(range(kurcz$nach_osobne), 1); round(range(kurcz$nach_model), 1)

# Rysunek: A – dane każdej osoby z prostą z osobnej regresji i z modelu; B – kurczenie par (wyraz wolny, nachylenie)
kolejnosc <- kurcz$osoba[order(kurcz$nach_osobne)]
proste <- rbind(data.frame(osoba = kurcz$osoba, a = kurcz$w0_osobne, b = kurcz$nach_osobne, rodzaj = "osobna regresja"),
                data.frame(osoba = kurcz$osoba, a = kurcz$w0_model, b = kurcz$nach_model, rodzaj = "model mieszany"))
proste$rodzaj <- factor(proste$rodzaj, levels = c("osobna regresja", "model mieszany"))
proste$osoba <- factor(proste$osoba, levels = kolejnosc)
sen$osoba <- factor(as.character(sen$Subject), levels = kolejnosc)
pA <- ggplot(sen, aes(dni, Reaction)) +
  geom_point(colour = "grey45", size = 1.3) +
  geom_abline(data = proste, aes(intercept = a, slope = b, colour = rodzaj, linetype = rodzaj), linewidth = 0.8) +
  facet_wrap(~ osoba, nrow = 3) +
  scale_colour_manual(values = unname(kol[c("osobne", "model")]), name = "Prosta:") +
  scale_linetype_manual(values = c("22", "solid"), name = "Prosta:") +
  scale_x_continuous(breaks = c(0, 4, 7)) +
  labs(title = "A. 18 osób: dane i dwie proste", x = "Dni od pomiaru wyjściowego", y = "Średni czas reakcji (ms)") +
  motyw + theme(strip.text = element_text(size = 9), axis.text = element_text(size = 8))
sr <- fixef(m_lme4)
pB <- ggplot(kurcz) +
  geom_segment(aes(x = w0_osobne, y = nach_osobne, xend = w0_model, yend = nach_model),
               colour = "grey55", arrow = arrow(length = unit(0.12, "cm"))) +
  geom_point(aes(w0_osobne, nach_osobne, colour = "osobna regresja", shape = "osobna regresja"), size = 2.4) +
  geom_point(aes(w0_model, nach_model, colour = "model mieszany", shape = "model mieszany"), size = 2.4) +
  annotate("point", x = sr[1], y = sr[2], shape = 3, size = 5, stroke = 1.3, colour = kol[["srednia"]]) +
  annotate("segment", x = sr[1] - 22, y = sr[2] - 2, xend = sr[1] - 2, yend = sr[2] - 0.3, colour = kol[["srednia"]]) +
  annotate("text", x = sr[1] - 23, y = sr[2] - 2, label = "efekt stały", hjust = 1, size = 3.3, colour = kol[["srednia"]]) +
  scale_colour_manual(values = c("osobna regresja" = kol[["osobne"]], "model mieszany" = kol[["model"]]),
                      breaks = c("osobna regresja", "model mieszany"), name = "Punkt:") +
  scale_shape_manual(values = c("osobna regresja" = 1, "model mieszany" = 16),
                     breaks = c("osobna regresja", "model mieszany"), name = "Punkt:") +
  labs(title = "B. Kurczenie do średniej", x = "Wyraz wolny: czas reakcji w dniu 0 (ms)",
       y = "Nachylenie (ms na dzień)") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.35, 1), guides = "collect") & theme(legend.position = "bottom")
p2
Wynik w R
  osoby pomiary
     18     144
     (Intercept)   dni
lme4      267.97 11.44
nlme      267.97 11.44
 Groups   Name        Std.Dev. Corr
 Subject  (Intercept) 30.9573
          dni          6.7659  0.178
 Residual             25.5264
       logLik
lme4 -702.047
nlme -702.047
            Estimate Std. Error t value
(Intercept)  267.967      8.266  32.418
dni           11.435      1.845   6.197
             Value Std.Error  DF t-value   p-value
(Intercept) 268.00     8.266 125  32.420 1.081e-62
dni          11.44     1.845 125   6.197 7.660e-09
Data: sen
Models:
m0: Reaction ~ dni + (1 | Subject)
m_lme4: Reaction ~ dni + (dni | Subject)
       npar    AIC    BIC  logLik -2*log(L)  Chisq Df Pr(>Chisq)
m0        4 1438.0 1449.9 -715.01    1430.0
m_lme4    6 1416.1 1433.9 -702.05    1404.1 25.926  2  2.346e-06 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
bez_losowego_nachylenia   z_losowym_nachyleniem
                   1.10                    1.85
    w0_osobne nach_osobne w0_model nach_model
335     262.9        -4.2    251.0       -0.6
332     316.0         2.4    298.5        6.5
310     225.9         3.9    228.5        4.0
309     200.3         4.4    208.6        3.3
SD_nachylen_osobne  SD_nachylen_model  SD_wyrazow_osobne   SD_wyrazow_model
               7.8                6.0               35.1               28.1
[1] -4.2 23.3
[1] -0.6 21.6
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Douglas Bates – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1978, 1980, 1988, 1990, 1991, 1992, 2000, 2007, 2015, 2023, 2024),
  opis = c("doktorat ze statystyki\n(Queen's University);\npotem Univ. of Alberta", "Uniwersytet\nWisconsin–Madison",
           "Nonlinear Regression\n(z D. G. Wattsem)", "nieliniowe modele\nmieszane (z M. Lindstrom)",
           "kierownik wydziału\n(1991–1994)", "Fellow ASA", "Mixed-Effects Models\nin S and S-PLUS (z J. Pinheiro)",
           "koniec współautorstwa\nnlme w R", "artykuł o lme4\n(J. Stat. Softw.)", "nagroda ASA za obliczenia\ni grafikę statystyczną",
           "koniec pracy\nw zespole R Core"),
  rodzaj = c("praca", "praca", "publikacja", "publikacja", "praca", "wyróżnienie", "publikacja", "oprogramowanie",
             "oprogramowanie", "wyróżnienie", "oprogramowanie"),
  poziom = c(0.6, -0.7, 1.45, -1.7, 0.6, -0.7, 1.45, -1.7, 0.6, -0.7, 1.45),   # wysokość etykiety
  wyrownanie = c(0.2, 0.4, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.6, 0.85))
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("praca" = 22, "publikacja" = 23, "oprogramowanie" = 21, "wyróżnienie" = 24)
kolory <- c("praca" = "#0072B2", "publikacja" = "#D55E00", "oprogramowanie" = "grey40", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1974, 2028), breaks = seq(1975, 2025, by = 5)) +
  scale_y_continuous(limits = c(-2.3, 2.0)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (modele mieszane – lmer() z pakietu lme4 i lme() z pakietu nlme; regresje osób – lm() z pakietu stats; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- nlme (wersja 3.1.168): Pinheiro, J., Bates, D., & R Core Team. (2025). nlme: Linear and nonlinear mixed effects models [R package]. https://doi.org/10.32614/CRAN.package.nlme
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim jest Douglas Bates?
Statystykiem i twórcą oprogramowania, profesorem emeritus statystyki na Uniwersytecie Wisconsin w Madison. Doktorat ze statystyki uzyskał w 1978 r. na Queen’s University w Kanadzie, w Madison pracuje od 1980 r. Jest głównym autorem pakietów R nlme i lme4 do modeli mieszanych i był członkiem-założycielem zespołu R Core (Wong, 2022).
Dlaczego lme4 nie podaje wartości p?
Bo przy niezrównoważonych danych i efektach częściowo skrzyżowanych statystyki testowe nie mają w skończonych próbach dokładnego rozkładu t ani F, a przybliżone stopnie swobody są według autorów rozwiązaniem doraźnym. Pakiet proponuje test ilorazu wiarygodności, przedziały ufności i bootstrap parametryczny, a strona help("pvalues") wskazuje pakiety z poprawkami (Bates i in., 2015).
Czym różni się lme4 od nlme?
lme4 ma wydajniejszą algebrę macierzy, prostszy zapis efektów skrzyżowanych, przedziały z profilu wiarygodności i uogólnione modele mieszane. nlme pozwala modelować strukturę reszt, np. autokorelację i niejednorodną wariancję. Ten sam prosty model daje w obu pakietach identyczne oszacowania.
Co to jest zbiór sleepstudy?
Zbiór z pakietu lme4: średnie czasy reakcji (ms) 18 osób, które przez kolejne noce spały 3 godziny, z badania Belenky’ego i in. (2003). Według pliku pomocy dni 0–1 to trening, dzień 2 – pomiar wyjściowy. Bates używa go jako głównego przykładu modelu z losowym nachyleniem.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Model mieszany w obrazkach
Strzałki od średnich szkół do modelu, kurczenie a liczebność i ICC, wachlarz losowych nachyleń i wykres gąsienicowy – pięć rysunków z kodem R.
Czytaj →PoradnikJak opisać wyniki modelu mieszanego
Co przepisać z wydruku lmer do pracy: struktura modelu, REML, df Satterthwaite’a, efekty stałe z CI, wariancje losowe, ICC i R² Nakagawy – z tabelą APA i wzorami zdań.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bates, D. M., & Watts, D. G. (1988). Nonlinear regression analysis and its applications. Wiley. https://doi.org/10.1002/9780470316757
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Lindstrom, M. J., & Bates, D. M. (1990). Nonlinear mixed effects models for repeated measures data. Biometrics, 46(3), 673–687. https://doi.org/10.2307/2532087
- Open Source Program Office. (b.d.). Meet Douglas Bates – How a UW–Madison professor helped shape R and continues to advocate for open source technology. University of Wisconsin–Madison. Pobrano 22 listopada 2026 z https://ospo.wisc.edu/?p=1089 ● Otwarty dostęp
- Pinheiro, J. C., & Bates, D. M. (2000). Mixed-effects models in S and S-PLUS. Springer. https://doi.org/10.1007/b98882
- Wong, R. (2022). 2023 ASA Statistical Computing and Graphics Award. ASA Connect (American Statistical Association). https://community.amstat.org/discussion/2023-asa-statistical-computing-and-graphics-award-2 ● Otwarty dostęp
Cytowania BibTeX
@book{bates1988nonlinear, author={Bates, Douglas M. and Watts, Donald G.}, title={{Nonlinear regression analysis and its applications}}, year={1988}, publisher={Wiley}, doi={10.1002/9780470316757}}@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{lindstrom1990nonlinear, author={Lindstrom, Mary J. and Bates, Douglas M.}, title={{Nonlinear mixed effects models for repeated measures data}}, journal={Biometrics}, year={1990}, volume={46}, number={3}, pages={673--687}, doi={10.2307/2532087}}@misc{uwospo2026bates, author={{Open Source Program Office}}, title={{Meet Douglas Bates – How a UW–Madison professor helped shape R and continues to advocate for open source technology}}, publisher={University of Wisconsin–Madison}, url={https://ospo.wisc.edu/?p=1089}}@book{pinheiro2000mixed, author={Pinheiro, José C. and Bates, Douglas M.}, title={{Mixed-effects models in S and S-PLUS}}, year={2000}, publisher={Springer}, doi={10.1007/b98882}}@misc{wong2022batesaward, author={Wong, Raymond}, title={{2023 ASA Statistical Computing and Graphics Award}}, howpublished={ASA Connect (American Statistical Association)}, year={2022}, publisher={American Statistical Association}, url={https://community.amstat.org/discussion/2023-asa-statistical-computing-and-graphics-award-2}}