Kim jest Hadley Wickham?
Hadley Wickham to statystyk i twórca oprogramowania, absolwent Uniwersytetu w Auckland, autor pakietu ggplot2 do wykresów, pojęcia danych uporządkowanych (tidy data) i pierwszy autor artykułu opisującego tidyverse – rodzinę pakietów języka R (stworzonego przez Rossa Ihakę i Roberta Gentlemana) o wspólnej filozofii (Wickham, 2014; Wickham i in., 2019). Jeśli rysujesz wykresy w R funkcją ggplot() albo przestawiasz tabelę funkcją pivot_longer(), korzystasz z jego narzędzi.
Nie od początku chciał być statystykiem. Jako nastolatek marzył o inżynierii genetycznej i zaczął na Uniwersytecie w Auckland studia z biologii człowieka z myślą o medycynie. Medycyna mu nie odpowiadała, więc wrócił do statystyki i programowania, które lubił w szkole. Ukończył tam licencjat ze statystyki i informatyki oraz studia magisterskie (University of Auckland, 2017). Doktorat ze statystyki obronił w 2008 r. na Iowa State University. Rozprawa nosiła tytuł Practical tools for exploring data and models, a promotorkami były Dianne Cook i Heike Hofmann (Mathematics Genealogy Project, b.d.).
Przez cztery lata był adiunktem statystyki na Rice University. Potem przeszedł do pracy poza uczelnią: jako główny naukowiec (chief scientist) firmy rozwijającej oprogramowanie dla R, gdzie – według artykułu uczelni – pracuje nad tym, by R był lepszym środowiskiem do analizy danych. W 2017 r. Uniwersytet w Auckland mianował go swoim profesorem (adjunct professor) statystyki. W marcu tego roku wygłosił wykład w pierwszej edycji cyklu Ihaka Lectures (University of Auckland, 2017).
Najważniejsze pomysły
- Warstwowa gramatyka grafiki (2010). ggplot2 rozwija pomysł Lelanda Wilkinsona: wykres to nie gotowy szablon, tylko złożenie danych, odwzorowań zmiennych na estetyki (oś, kolor, kształt), warstw (geometria i statystyka), skal, układu współrzędnych i paneli (Wickham, 2010).
- Dane uporządkowane (2014). Każda zmienna w osobnej kolumnie, każda obserwacja w osobnym wierszu, każdy typ jednostki obserwacji w osobnej tabeli. Wickham (2014) pokazał, że niewielki zestaw operacji wystarcza, by uporządkować większość nieuporządkowanych tabel. Szczegóły opisuje hasło dane uporządkowane.
- Tidyverse (2019). Zbiór pakietów o wspólnej gramatyce i strukturach danych, tak by nauka jednego ułatwiała naukę kolejnego. Rdzeń tworzą m.in. dplyr, tidyr, ggplot2, readr i purrr. Tidyverse obejmuje import, porządkowanie, przekształcanie danych, wykresy i programowanie, a celowo pomija modelowanie (Wickham i in., 2019).
- Narzędzia do nauczania. Pakiety stringr (napisy) i lubridate (daty, z Garrettem Grolemundem) powstały – jak mówił – z niechęci do uczenia tematu, który jest tylko zbiorem przypadków szczególnych (Simply Statistics, 2012).
Ciekawostka
W 2012 r. Wickham opowiadał, że wydanie ggplot2 w wersji 0.9.0 zepsuło ponad 40 innych pakietów w repozytorium CRAN, które z niego korzystały. Wyciągnął z tego wnioski: od tamtej pory zapowiada nowe wydania z miesięcznym wyprzedzeniem i przed publikacją sprawdza pakiety, które od jego pakietu zależą (Simply Statistics, 2012).
W tym samym wywiadzie mówił z dumą o liście dyskusyjnej ggplot2: wyrośli na niej eksperci, którzy odpowiadają na więcej pytań niż on sam. Siedem lat później artykuł o tidyverse miał już 24 autorów (Wickham i in., 2019).
Przykład: religia i dochody w postaci szerokiej i uporządkowanej
Zbiór relig_income z pakietu tidyr to według pliku pomocy dane z sondażu Pew Research Center o religii i dochodach, pobrane w listopadzie 2009 r. Ten sam zbiór otwiera winietę „Tidy data” pakietu tidyr, nieformalną wersję artykułu z 2014 r., jako przykład tabeli, w której nagłówki kolumn są wartościami, a nie nazwami zmiennych.
Tabela ma 18 wierszy (grupy wyznaniowe) i 11 kolumn: wyznanie i 10 przedziałów dochodu, w komórkach liczby respondentów. Do czytania to wygodny układ, do analizy – nie, bo dochód, jedna zmienna, jest rozrzucony po 10 kolumnach. Jedno wywołanie pivot_longer() daje 180 wierszy i 3 kolumny: religion, dochod, n. Teraz odsetki w obrębie wyznania to jedna operacja na grupach (group_by() i mutate()). Odpowiedzi „nie wiem/odmowa” o dochodzie pomijamy.
Największy odsetek osób z dochodem co najmniej 75 tys. dolarów mają hinduiści (67.7%, n = 220) i żydzi (59.0%, n = 520), najmniejszy – Świadkowie Jehowy (18.0%) i członkowie historycznie czarnych kościołów protestanckich (17.5%, n = 1656). Na koniec kod sprawdza, że odsetki policzone w postaci szerokiej, jako odsetki wierszowe z macierzy (prop.table()), są identyczne z tymi z tabeli uporządkowanej. Postać danych nie zmienia liczb, zmienia tylko to, jak łatwo się do nich dostać.
Na rysunku
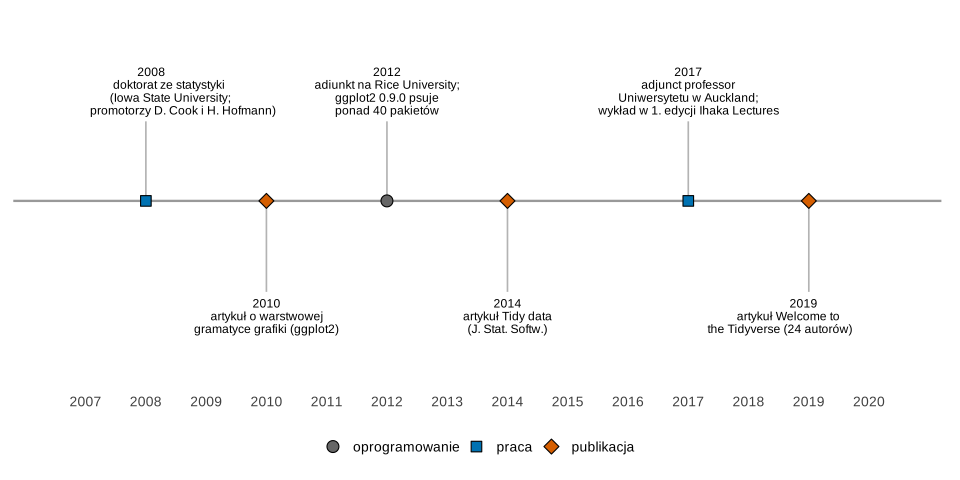
Co widać. Od doktoratu do artykułu o tidyverse minęło 11 lat: najpierw wykresy, potem kształt danych, na końcu cały zestaw narzędzi.
Na co uważać. Rok 2012 to data wywiadu, w którym Wickham opisał skutki wydania 0.9.0 – źródło nie podaje dokładnej daty samego wydania. Cytowane źródła nie podają też lat studiów w Auckland ani roku odejścia z Rice.
Podpis do pracy:
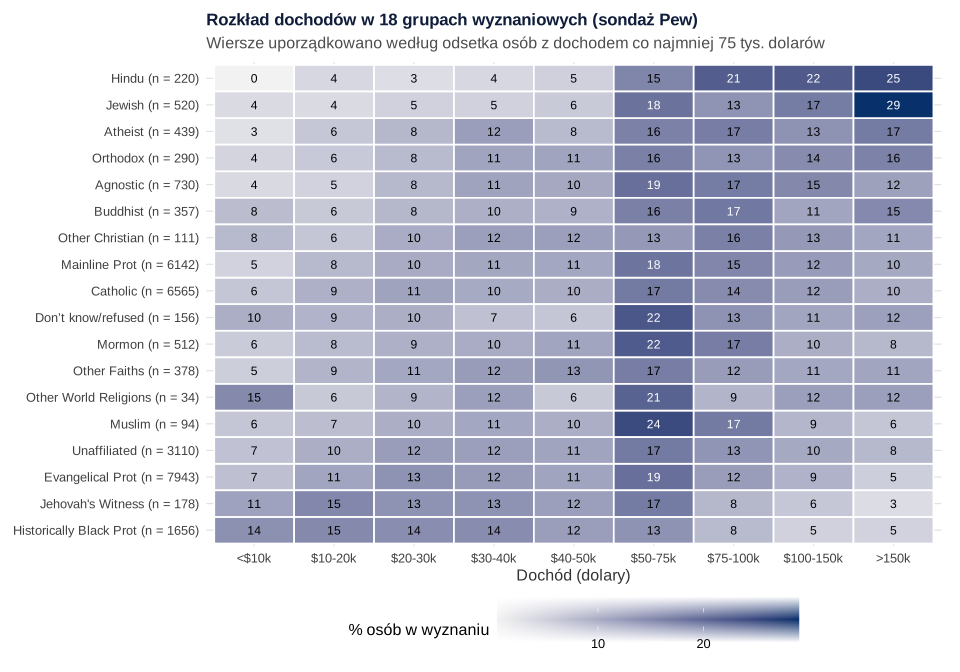
tidyr::relig_income (sondaż Pew, pobrane w 2009 r.). Obliczenia i rysunek: R, pakiety tidyr, dplyr i ggplot2.Co widać. Wykres ma dwie warstwy na tej samej uporządkowanej tabeli: kafelki (geom_tile()) i liczby (geom_text()). Każdej zmiennej odpowiada jedna estetyka: dochód – oś pozioma, wyznanie – oś pionowa, odsetek – kolor wypełnienia i etykieta. W postaci szerokiej taki wykres trzeba by składać z 9 osobnych kolumn. Po uporządkowaniu wystarcza jedno wywołanie ggplot().
Na co uważać. Grupy mają bardzo różne liczebności – od 34 osób („Other World Religions”) do 7943 – więc odsetki w małych grupach są mało precyzyjne. To dane opisowe z jednego sondażu, a nie dowód, że religia wpływa na dochód. Kolor nie jest jedynym nośnikiem informacji, bo każdy kafelek ma liczbę.
Podpis do pracy:
Gdzie spotkasz Wickhama w swojej pracy
- Przygotowanie danych. Dane z formularzy i arkuszy rzadko są uporządkowane. Przestawianie tabel opisują hasła o formacie długim i szerokim i kodowaniu zmiennych w R, a cały proces – wpis R dla początkujących.
- Modele wielopoziomowe. Pakiety do modeli mieszanych, np. lme4 Douglasa Batesa, wymagają danych w postaci długiej: jeden pomiar w wierszu.
- Wykresy do pracy. Większość rysunków w naszym słowniku powstała w ggplot2. Gramatyka grafiki pozwala zamienić wykres słupkowy na małe wielokrotności jedną linijką kodu.
- Agregacja. Agregacja danych i tabele krzyżowe w dplyr to grupowanie i podsumowanie na tabeli uporządkowanej.
Spory, mity i trudne strony
- Stabilność czy lepsze interfejsy. Według autorów artykułu o tidyverse największa różnica wobec bazowego R dotyczy priorytetów: bazowy R stawia na stabilność, a tidyverse jest gotów wprowadzać zmiany niezgodne z wcześniejszymi wersjami, jeśli prowadzą do lepszych interfejsów (Wickham i in., 2019). Dla autora pracy dyplomowej wniosek jest praktyczny: zapisz wersje pakietów (
sessionInfo()), bo skrypt sprzed kilku lat może działać inaczej. - Mit: „tidy = format długi”. Uporządkowanie dotyczy tego, co jest zmienną i obserwacją, a nie długości tabeli. Tabela szeroka z jednym wierszem na osobę też bywa uporządkowana – wyjaśnia to hasło o danych uporządkowanych.
Z postaci szerokiej do uporządkowanej w R
Kod przestawia zbiór relig_income do postaci uporządkowanej, liczy odsetki w obrębie wyznania i odsetek osób z dochodem co najmniej 75 tys. dolarów, sprawdza zgodność z odsetkami wierszowymi z macierzy i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje, więc nie ma ziarna; próg 17% przy zmianie koloru etykiet na biały dobrano ręcznie dla czytelności.
1. Dane szerokie, uporządkowane i mapa cieplna: rysunek 2
Kod R rysunku 2
# Dane Pew o religii i dochodach: z postaci szerokiej do uporządkowanej (tidy) i jeden wykres z dwóch warstw
suppressPackageStartupMessages({library(tidyr); library(dplyr); library(ggplot2)})
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

# Dane: tidyr::relig_income – sondaż Pew o religii i dochodach (plik pomocy: pobrane w listopadzie 2009 r.).
# Postać szeroka: wiersz = wyznanie, kolumny = przedziały dochodu, w komórkach liczby respondentów.
data(relig_income, package = "tidyr")
dim(relig_income)
names(relig_income)
relig_income[1:3, 1:5]

# 1. Postać uporządkowana: jedna obserwacja (wyznanie × przedział dochodu) w wierszu, trzy zmienne w kolumnach
dlugie <- relig_income |>
  pivot_longer(-religion, names_to = "dochod", values_to = "n")
dim(dlugie)
head(dlugie, 4)

# 2. Odsetki w obrębie wyznania (bez odpowiedzi „nie wiem/odmowa” w dochodzie) – jedna grupa operacji
przedzialy <- setdiff(names(relig_income), c("religion", "Don't know/refused"))
odsetki <- dlugie |>
  filter(dochod %in% przedzialy) |>
  mutate(dochod = factor(dochod, levels = przedzialy)) |>
  group_by(religion) |>
  mutate(N = sum(n), proc = 100 * n / N) |>
  ungroup()
# ile osób z podanym dochodem w każdym wyznaniu i jaki odsetek zarabia co najmniej 75 tys. dolarów
podsum <- odsetki |>
  group_by(religion) |>
  summarise(N = first(N), od_75k = sum(proc[dochod %in% c("$75-100k", "$100-150k", ">150k")]), .groups = "drop") |>
  arrange(desc(od_75k))
print(podsum, n = 18)
sum(dlugie$n)

# 3. To samo w postaci szerokiej: odsetki wierszowe z macierzy – liczby muszą być identyczne
macierz <- as.matrix(relig_income[, przedzialy])
rownames(macierz) <- relig_income$religion
szer_proc <- 100 * prop.table(macierz, margin = 1)
z_dlugich <- xtabs(proc ~ religion + dochod, data = odsetki)
all.equal(as.vector(szer_proc[rownames(z_dlugich), ]), as.vector(unclass(z_dlugich)), check.attributes = FALSE)

# Rysunek: mapa cieplna z etykietami – dwie warstwy (kafelki i tekst) na tej samej uporządkowanej tabeli
odsetki$religion <- factor(odsetki$religion, levels = rev(podsum$religion))
odsetki$etykieta <- sprintf("%.0f", odsetki$proc)
p2 <- ggplot(odsetki, aes(x = dochod, y = religion)) +
  geom_tile(aes(fill = proc), colour = "white", linewidth = 0.6) +                    # warstwa 1: kafelki
  geom_text(aes(label = etykieta, colour = proc > 17), size = 3.2, show.legend = FALSE) + # warstwa 2: tekst
  scale_fill_gradient(low = "#F2F2F2", high = "#08306B", name = "% osób w wyznaniu") +
  scale_colour_manual(values = c(`FALSE` = "black", `TRUE` = "white")) +
  scale_y_discrete(labels = function(x) paste0(x, " (n = ", podsum$N[match(x, podsum$religion)], ")")) +
  labs(title = "Rozkład dochodów w 18 grupach wyznaniowych (sondaż Pew)",
       subtitle = "Wiersze uporządkowano według odsetka osób z dochodem co najmniej 75 tys. dolarów",
       x = "Dochód (dolary)", y = NULL) +
  motyw + theme(legend.key.width = unit(1.6, "cm"))
p2
Wynik w R
[1] 18 11
 [1] "religion"           "<$10k"              "$10-20k"
 [4] "$20-30k"            "$30-40k"            "$40-50k"
 [7] "$50-75k"            "$75-100k"           "$100-150k"
[10] ">150k"              "Don't know/refused"
# A tibble: 3 × 5
  religion `<$10k` `$10-20k` `$20-30k` `$30-40k`
  <chr>      <dbl>     <dbl>     <dbl>     <dbl>
1 Agnostic      27        34        60        81
2 Atheist       12        27        37        52
3 Buddhist      27        21        30        34
[1] 180   3
# A tibble: 4 × 3
  religion dochod      n
  <chr>    <chr>   <dbl>
1 Agnostic <$10k      27
2 Agnostic $10-20k    34
3 Agnostic $20-30k    60
4 Agnostic $30-40k    81
# A tibble: 18 × 3
   religion                    N od_75k
   <chr>                   <dbl>  <dbl>
 1 Hindu                     220   67.7
 2 Jewish                    520   59.0
 3 Atheist                   439   46.9
 4 Orthodox                  290   43.4
 5 Agnostic                  730   43.2
 6 Buddhist                  357   43.1
 7 Other Christian           111   39.6
 8 Mainline Prot            6142   37.9
 9 Catholic                 6565   36.2
10 Don’t know/refused        156   35.9
11 Mormon                    512   34.4
12 Other Faiths              378   33.6
13 Other World Religions      34   32.4
14 Muslim                     94   31.9
15 Unaffiliated             3110   31.7
16 Evangelical Prot         7943   26.3
17 Jehovah's Witness         178   18.0
18 Historically Black Prot  1656   17.5
[1] 35556
[1] TRUE
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Hadley Wickham – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(2008, 2010, 2012, 2014, 2017, 2019),
  opis = c("doktorat ze statystyki\n(Iowa State University;\npromotorzy D. Cook i H. Hofmann)",
           "artykuł o warstwowej\ngramatyce grafiki (ggplot2)",
           "adiunkt na Rice University;\nggplot2 0.9.0 psuje\nponad 40 pakietów",
           "artykuł Tidy data\n(J. Stat. Softw.)",
           "adjunct professor\nUniwersytetu w Auckland;\nwykład w 1. edycji Ihaka Lectures",
           "artykuł Welcome to\nthe Tidyverse (24 autorów)"),
  rodzaj = c("praca", "publikacja", "oprogramowanie", "publikacja", "praca", "publikacja"),
  poziom = c(0.7, -0.8, 0.7, -0.8, 0.7, -0.8),   # wysokość etykiety
  wyrownanie = c(0.3, 0.5, 0.5, 0.5, 0.5, 0.7))
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("praca" = 22, "publikacja" = 23, "oprogramowanie" = 21)
kolory <- c("praca" = "#0072B2", "publikacja" = "#D55E00", "oprogramowanie" = "grey40")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.2, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(2006.5, 2020.5), breaks = 2007:2020) +
  scale_y_continuous(limits = c(-1.5, 1.5)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (przestawianie tabeli – pivot_longer() z pakietu tidyr; grupowanie i podsumowania – pakiet dplyr; odsetki wierszowe – prop.table() i xtabs() z pakietów base i stats; rysunki – pakiet ggplot2). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- tidyr (wersja 1.3.2): Wickham, H., Vaughan, D., & Girlich, M. (2025). tidyr: Tidy messy data [R package]. https://doi.org/10.32614/CRAN.package.tidyr
- dplyr (wersja 1.2.0): Wickham, H., François, R., Henry, L., Müller, K., & Vaughan, D. (2026). dplyr: A grammar of data manipulation [R package]. https://doi.org/10.32614/CRAN.package.dplyr
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Kim jest Hadley Wickham?
Statystykiem i twórcą oprogramowania, autorem pakietu ggplot2 i pojęcia danych uporządkowanych (tidy data). Studiował statystykę i informatykę na Uniwersytecie w Auckland, doktorat obronił w 2008 r. na Iowa State University, przez cztery lata był adiunktem na Rice University, a potem przeszedł do pracy nad oprogramowaniem dla R poza uczelnią (University of Auckland, 2017).
Co to jest tidyverse?
Zbiór pakietów R o wspólnej filozofii, gramatyce i strukturach danych – m.in. dplyr, tidyr, ggplot2, readr, purrr, tibble, stringr i forcats. Obejmuje import, porządkowanie, przekształcanie danych, wykresy i programowanie, a celowo pomija modelowanie statystyczne (Wickham i in., 2019).
Skąd się wziął ggplot2?
Z gramatyki grafiki Lelanda Wilkinsona. Wickham (2010) opisał jej warstwową wersję: wykres składa się z danych, odwzorowań zmiennych na estetyki, warstw z geometrią i statystyką, skal, układu współrzędnych i paneli.
Co to jest zbiór relig_income?
Zbiór z pakietu tidyr: liczby respondentów sondażu Pew Research Center w 18 grupach wyznaniowych i 10 kategoriach dochodu (pobrane w 2009 r.). Ma nagłówki kolumn będące wartościami zmiennej, więc służy jako przykład danych nieuporządkowanych.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Mathematics Genealogy Project. (b.d.). Hadley Alexander Wickham. Pobrano 22 listopada 2026 z https://mathgenealogy.org/id.php?id=145799 ● Otwarty dostęp
- Simply Statistics. (2012). Interview with Hadley Wickham – Developer of ggplot2. https://simplystatistics.org/posts/2012-05-11-ha ● Otwarty dostęp
- University of Auckland. (2017). Problem-solving, pits of success, and improving the R environment. inSCight (Faculty of Science alumni magazine). https://www.auckland.ac.nz/en/news/2017/12/05/problem-solving-pits-of-success.html ● Otwarty dostęp
- Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3–28. https://doi.org/10.1198/jcgs.2009.07098
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10 ● Otwarty dostęp
- Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., . . . Yutani, H. (2019). Welcome to the tidyverse. Journal of Open Source Software, 4(43), Article 1686. https://doi.org/10.21105/joss.01686 ● Otwarty dostęp
Cytowania BibTeX
@misc{mgp2026wickham, author={{Mathematics Genealogy Project}}, title={{Hadley Alexander Wickham}}, howpublished={Mathematics Genealogy Project}, url={https://mathgenealogy.org/id.php?id=145799}}@misc{simplystatistics2012wickham, author={{Simply Statistics}}, title={{Interview with Hadley Wickham – Developer of ggplot2}}, howpublished={Simply Statistics}, year={2012}, url={https://simplystatistics.org/posts/2012-05-11-ha}}@misc{auckland2017wickham, author={{University of Auckland}}, title={{Problem-solving, pits of success, and improving the R environment}}, howpublished={inSCight (Faculty of Science alumni magazine)}, year={2017}, publisher={University of Auckland}, url={https://www.auckland.ac.nz/en/news/2017/12/05/problem-solving-pits-of-success.html}}@article{wickham2010layered, author={Wickham, Hadley}, title={{A layered grammar of graphics}}, journal={Journal of Computational and Graphical Statistics}, year={2010}, volume={19}, number={1}, pages={3--28}, doi={10.1198/jcgs.2009.07098}}@article{wickham2014tidy, author={Wickham, Hadley}, title={{Tidy data}}, journal={Journal of Statistical Software}, year={2014}, volume={59}, number={10}, pages={1--23}, doi={10.18637/jss.v059.i10}}@article{wickham2019welcome, author={Wickham, Hadley and Averick, Mara and Bryan, Jennifer and Chang, Winston and McGowan, Lucy D'Agostino and François, Romain and Grolemund, Garrett and Hayes, Alex and Henry, Lionel and Hester, Jim and Kuhn, Max and Pedersen, Thomas Lin and Miller, Evan and Bache, Stephan Milton and Müller, Kirill and Ooms, Jeroen and Robinson, David and Seidel, Dana Paige and Spinu, Vitalie and Takahashi, Kohske and Vaughan, Davis and Wilke, Claus and Woo, Kara and Yutani, Hiroaki}, title={{Welcome to the tidyverse}}, journal={Journal of Open Source Software}, year={2019}, volume={4}, number={43}, eid={1686}, doi={10.21105/joss.01686}}