Kim są Ross Ihaka i Robert Gentleman?
Ross Ihaka i Robert Gentleman to statystycy, od których zaczął się język R. Według Foxa (2009) projekt ruszył około 1990 r. jako ich nieformalne przedsięwzięcie na Uniwersytecie w Auckland w Nowej Zelandii, gdzie obaj wtedy pracowali. Przez pierwsze lata R był wyłącznie ich projektem, z udziałem kilku studentów. W 1996 r. opisali go w artykule w Journal of Computational and Graphical Statistics (Ihaka i Gentleman, 1996).
Obaj nadal należą do R Core – grupy, która ma prawo zmieniać kod źródłowy R; w 2026 r. liczy ona 19 osób (Hornik i R Core Team, 2026). Gentleman jest też pierwszym autorem artykułu z 2004 r. o projekcie Bioconductor, podpisanego afiliacją Dana-Farber Cancer Institute w Bostonie (Gentleman i in., 2004).
Najważniejsze pomysły
- Język z dwóch wzorców. W artykule z 1996 r. autorzy piszą, że chcieli połączyć przydatne cechy dwóch istniejących języków, i wymieniają korzyści nowego: przenośność, wydajność obliczeń, zarządzanie pamięcią i reguły zasięgu (Ihaka i Gentleman, 1996). Tymi wzorcami były S z Bell Labs, od którego R ma wygląd i składnię, oraz Scheme – dialekt Lispu, od którego ma semantykę, m.in. zasięg leksykalny funkcji (Fox, 2009; Hornik i R Core Team, 2026).
- Od projektu dwóch osób do projektu wspólnoty. Fox (2009) dzieli wczesną historię R na trzy etapy: około 1990–1994 – projekt Ihaki i Gentlemana, około 1994–1997 – cel „odtworzyć i ulepszyć S” Johna Chambersa (zob. John M. Chambers), od 1997 r. – grupa R Core, na początku dziewięcioosobowa. Twórcy otworzyli projekt i wydali R na licencji GNU GPL; Fox uważa ten model rozwoju za jeden z powodów sukcesu R.
- Pakiety i CRAN. W 2009 r. archiwum CRAN liczyło prawie 2000 pakietów, a ich liczba rosła w przybliżeniu wykładniczo (Fox, 2009). Chambers (2020) zauważa, że opisowi nowej metody statystycznej często towarzyszy pakiet R.
- Bioconductor. Projekt otwartego oprogramowania do biologii obliczeniowej i bioinformatyki, zbudowany na systemie pakietów R. Wśród celów autorzy wymieniają wspólny rozwój narzędzi, obniżenie barier w badaniach interdyscyplinarnych i odtwarzalność wyników (Gentleman i in., 2004) – postulaty bliskie dzisiejszej otwartej nauce.
Ciekawostka
Skąd nazwa „R”? Według oficjalnego FAQ projektu nazwa ma dwa źródła naraz. Po pierwsze, to wspólna pierwsza litera imion dwóch pierwszych autorów – Roberta i Rossa. Po drugie, to gra z nazwą języka S z Bell Labs, na którym R się wzorował (Hornik i R Core Team, 2026). Jedna litera mieści więc i autorów, i rodowód języka.
Ten rodowód widać do dziś. Według FAQ R trzyma się definicji S z książek nazywanych „Blue Book” i „White Book” na tyle wiernie, że jest w istocie implementacją S, a zarazem zagnieżdżone funkcje działają w nim według reguł Scheme (Hornik i R Core Team, 2026). Przykład niżej pokazuje to drugie dziedzictwo w praktyce.
Przykład: trzy idee języka R na danych o opadach
Ihaka i Gentleman nie stworzyli metody statystycznej, tylko narzędzie, więc przykład pokazuje cechy języka, o których piszą źródła. Dane precip z pakietu datasets to – według pliku pomocy – średnie roczne opady (w calach) z lat 1941–1970 w 70 miastach USA i Portoryko, zaczerpnięte ze Statistical Abstracts of the United States z 1975 r. Średnia wynosi 34.89 cala, mediana 36.60, zakres 7–67.
- Wektoryzacja. Standaryzacja wszystkich 70 wartości to jedno wyrażenie
(precip - mean(precip)) / sd(precip); pętlafordaje identyczny wynik (all.equal()zwracaTRUE). Najwyższe wyniki z mają Mobile (2.34), Miami (1.82) i San Juan (1.77). - Funkcje jako obiekty. Średnią, medianę i średnią ucinaną 10% trzymamy w jednej liście i liczymy jednym poleceniem: 34.89, 36.60 i 35.22 cala.
- Domknięcie. Funkcja
bootstrapuj()zwraca nową funkcję, która „pamięta” dane i liczbę losowań – w jej środowisku są tylko obiektyBix. Tę jedną funkcję stosujemy do trzech statystyk. Przy 5000 próbach bootstrapowych (ziarno 850, oba parametry wybrane przez nas) błąd standardowy wynosi 1.65 dla średniej, 1.51 dla mediany i 1.74 dla średniej ucinanej, a 95% przedziały percentylowe to [31.67, 38.14], [33.90, 40.05] i [31.76, 38.58] cala.
Nie twierdzimy, że Ihaka i Gentleman pokazywali ten przykład – to nasza ilustracja cech języka opisanych w cytowanych źródłach.
Na rysunku
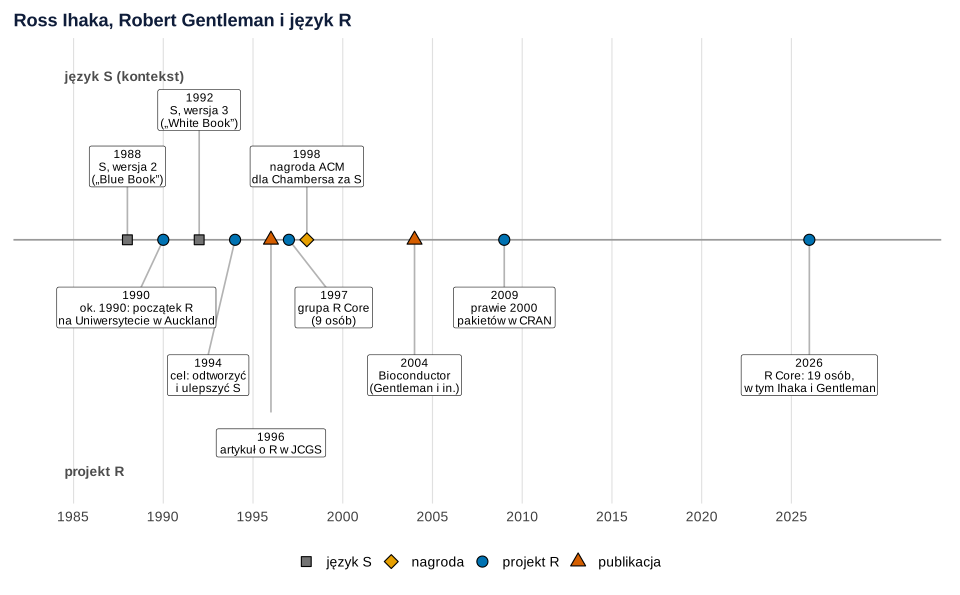
Co widać. R powstawał równolegle do kolejnych wersji S: kiedy w 1992 r. ukazała się trzecia wersja S, projekt z Auckland miał około dwóch lat. Przełomem organizacyjnym był rok 1997 – od dwóch autorów do grupy R Core.
Na co uważać. Rok 1990 jest przybliżony („około”, jak u Foxa), a rok publikacji nie jest rokiem powstania pomysłu. Oś pomija autorów pakietów.
Podpis do pracy:
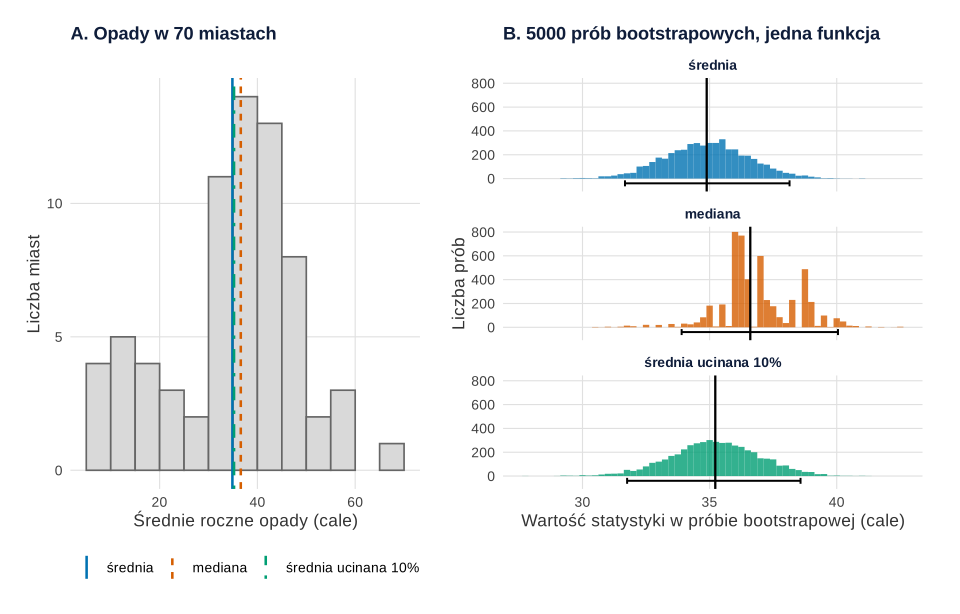
datasets::precip (Statistical Abstracts of the United States, 1975, według pliku pomocy). Rysunek: R, pakiety ggplot2 i patchwork; 5000 prób bootstrapowych (set.seed(850)).Co widać. Rozkład opadów ma długi lewy ogon więc średnia leży poniżej mediany. Ta sama funkcja boot_opady() dała trzy różne rozkłady: dla średniej i średniej ucinanej – gładkie, dla mediany – poszarpany, bo mediana z danych podanych z dokładnością do 0.1 cala przyjmuje niewiele różnych wartości.
Na co uważać. Rysunek ilustruje cechę języka, a nie rekomendację metody: przedziały percentylowe przy medianie bywają niestabilne, a wybór statystyki zależy od pytania badawczego. Liczba prób (5000) i ziarno nie mają znaczenia historycznego.
Podpis do pracy:
Gdzie spotkasz Ihakę i Gentlemana w swojej pracy
- W każdej analizie w R. Cytując R w pracy, podajesz autora zbiorowego „R Core Team” – grupę, którą obaj współtworzą. Jak podać wersję i pakiety, opisuje hasło R (język programowania).
- Metody symulacyjne. Bootstrap, testy permutacyjne i badania symulacyjne to w R kilka linijek z
replicate()i własnymi funkcjami – zob. Bootstrap i test permutacyjny krok po kroku, przedział BCa i hasło o twórcy bootstrapu, Bradleyu Efronie. - Pakiety z nowymi metodami. Nowe metody często trafiają do użytkowników jako pakiety R towarzyszące ich opisom (Chambers, 2020).
- Bioinformatyka. Do analizy danych genomowych w R służą pakiety projektu Bioconductor (Gentleman i in., 2004).
Spory, mity i trudne strony
„R to darmowa kopia S”. Częściowo. Chambers (2020) pisze, że R świadomie zaprojektowano tak, by odtworzyć S w otwartym oprogramowaniu, a Fox (2009) wskazuje ten cel dla lat ok. 1994–1997. Ale semantyka R pochodzi ze Scheme, a Fox zaznacza, że wierne powtórzenie S nie było początkowym celem obu autorów.
„R napisały dwie osoby”. Na początku tak. Od 1997 r. rozwija go R Core (dziś 19 osób), a w CRAN już w 2009 r. było prawie 2000 pakietów.
„R powstał w 1996 roku”. To rok artykułu w JCGS. Projekt zaczął się wcześniej – około 1990 r. według Foxa (2009); dokładniejszych dat z wczesnych lat nie podajemy, bo cytowane źródła ich nie ustalają.
Idee języka R w kodzie
Kod rysuje oś czasu, standaryzuje dane wektorowo i pętlą, liczy trzy statystyki z listy funkcji i ich rozkłady bootstrapowe z jednej funkcji-domknięcia. Rysunki na stronie powstały z tych samych obiektów p_os i p_metoda z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
Oś czasu, wektoryzacja, funkcje jako obiekty i domknięcie na danych precip
Kod R rysunków 1 i 2
# Ross Ihaka i Robert Gentleman: oś czasu projektu R i pokaz trzech idei języka (wektoryzacja, funkcje jako obiekty,
# domknięcia z zasięgiem leksykalnym) na danych precip
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", zielony = "#009E73", szary = "grey45")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"))

# 1. Oś czasu (lata według Foxa 2009, Hornika i R Core Team 2026 oraz Gentlemana i in. 2004)
zdarzenia <- data.frame(
  rok = c(1988, 1992, 1998, 1990, 1994, 1996, 1997, 2004, 2009, 2026),
  opis = c("S, wersja 2\n(„Blue Book”)", "S, wersja 3\n(„White Book”)", "nagroda ACM\ndla Chambersa za S",
           "ok. 1990: początek R\nna Uniwersytecie w Auckland", "cel: odtworzyć\ni ulepszyć S",
           "artykuł o R w JCGS", "grupa R Core\n(9 osób)", "Bioconductor\n(Gentleman i in.)",
           "prawie 2000\npakietów w CRAN", "R Core: 19 osób,\nw tym Ihaka i Gentleman"),
  tor = c(rep("język S (Bell Labs)", 3), rep("projekt R", 7)),
  rodzaj = c("język S", "język S", "nagroda", "projekt R", "projekt R", "publikacja", "projekt R", "publikacja", "projekt R", "projekt R"))
zdarzenia$y <- c(1.3, 2.3, 1.3, -1.2, -2.4, -3.6, -1.2, -2.4, -1.2, -2.4)   # wysokość etykiet: S nad osią, R pod osią
zdarzenia$x_etykiety <- zdarzenia$rok + c(0, 0, 0, -1.5, -1.5, 0, 2.5, 0, 0, 0)  # przesunięcie, żeby się nie nakładały
p_os <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_segment(aes(xend = x_etykiety, yend = y * 0.85), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.5) +
  geom_label(aes(x = x_etykiety, y = y, label = paste0(rok, "\n", opis)), size = 3.1, lineheight = 0.9, linewidth = 0.2) +
  annotate("text", x = 1984.5, y = c(2.9, -4.1), label = c("język S (kontekst)", "projekt R"), hjust = 0,
           fontface = "bold", size = 3.6, colour = "grey30") +
  scale_shape_manual(values = c("język S" = 22, "nagroda" = 23, "projekt R" = 21, "publikacja" = 24), name = NULL) +
  scale_fill_manual(values = c("język S" = oi[["szary"]], "nagroda" = oi[["pomaranczowy"]], "projekt R" = oi[["niebieski"]],
                               "publikacja" = oi[["cynober"]]), name = NULL) +
  scale_x_continuous(breaks = seq(1985, 2025, 5), limits = c(1984, 2031)) + scale_y_continuous(limits = c(-4.3, 3.2)) +
  labs(title = "Ross Ihaka, Robert Gentleman i język R", x = NULL, y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank(), legend.position = "bottom")

# 2. Dane: średnie roczne opady (w calach, 1941–1970) w 70 miastach USA i Portoryko
data(precip, package = "datasets")
length(precip)
summary(precip)

# Idea 1 – wektoryzacja: jedno wyrażenie działa na całym wektorze; pętla daje to samo, ale dłużej się ją pisze
z_wektor <- (precip - mean(precip)) / sd(precip)
z_petla <- numeric(length(precip))
for (i in seq_along(precip)) z_petla[i] <- (precip[i] - mean(precip)) / sd(precip)
all.equal(unname(z_wektor), z_petla)
round(head(sort(z_wektor, decreasing = TRUE), 3), 2)

# Idea 2 – funkcje są obiektami: można je trzymać w liście i przekazywać innym funkcjom
statystyki <- list("średnia" = mean, "mediana" = median, "średnia ucinana 10%" = function(x) mean(x, trim = 0.1))
round(sapply(statystyki, function(f) f(precip)), 2)

# Idea 3 – domknięcie: funkcja zwraca funkcję, która „pamięta” dane x i liczbę losowań B (zasięg leksykalny ze Scheme)
bootstrapuj <- function(x, B) {
  function(statystyka) replicate(B, statystyka(sample(x, replace = TRUE)))
}
boot_opady <- bootstrapuj(precip, B = 5000)
ls(environment(boot_opady))
set.seed(850)
rozklady <- lapply(statystyki, boot_opady)
wyniki <- data.frame(z_proby = sapply(statystyki, function(f) f(precip)),
                     blad_standardowy = sapply(rozklady, sd),
                     dolna_2.5 = sapply(rozklady, quantile, 0.025),
                     gorna_97.5 = sapply(rozklady, quantile, 0.975))
round(wyniki, 2)

# Rysunek: dane (A) i rozkłady bootstrapowe trzech statystyk policzone jedną funkcją (B)
staty_df <- data.frame(statystyka = factor(names(statystyki), levels = names(statystyki)), wartosc = wyniki$z_proby)
p_dane <- ggplot(data.frame(opady = precip), aes(opady)) +
  geom_histogram(binwidth = 5, boundary = 0, fill = "grey85", colour = "grey40") +
  geom_vline(data = staty_df, aes(xintercept = wartosc, linetype = statystyka, colour = statystyka), linewidth = 0.9) +
  scale_linetype_manual(values = c("solid", "22", "dotdash"), name = NULL) +
  scale_colour_manual(values = unname(oi[c("niebieski", "cynober", "zielony")]), name = NULL) +
  labs(title = "A. Opady w 70 miastach", x = "Średnie roczne opady (cale)", y = "Liczba miast") +
  motyw + theme(legend.position = "bottom", legend.direction = "vertical")
boot_df <- data.frame(statystyka = factor(rep(names(rozklady), lengths(rozklady)), levels = names(statystyki)),
                      wartosc = unlist(rozklady, use.names = FALSE))
przedzialy <- data.frame(statystyka = staty_df$statystyka, dolna = wyniki$dolna_2.5, gorna = wyniki$gorna_97.5)
p_boot <- ggplot(boot_df, aes(wartosc)) +
  geom_histogram(aes(fill = statystyka), binwidth = 0.25, colour = NA, alpha = 0.8, show.legend = FALSE) +
  geom_vline(data = staty_df, aes(xintercept = wartosc), linewidth = 0.8) +
  geom_errorbar(data = przedzialy, aes(xmin = dolna, xmax = gorna, y = -40), width = 50, orientation = "y",
                inherit.aes = FALSE, linewidth = 0.7) +
  facet_wrap(~ statystyka, ncol = 1) +
  scale_fill_manual(values = unname(oi[c("niebieski", "cynober", "zielony")])) +
  labs(title = "B. 5000 prób bootstrapowych, jedna funkcja", x = "Wartość statystyki w próbie bootstrapowej (cale)",
       y = "Liczba prób") + motyw
p_metoda <- p_dane + p_boot + plot_layout(widths = c(1, 1.2))
p_os
p_metoda
Wynik w R
[1] 70
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
   7.00   29.38   36.60   34.89   42.77   67.00
[1] TRUE
  Mobile    Miami San Juan
    2.34     1.82     1.77
            średnia             mediana średnia ucinana 10%
              34.89               36.60               35.22
[1] "B" "x"
                    z_proby blad_standardowy dolna_2.5 gorna_97.5
średnia               34.89             1.65     31.67      38.14
mediana               36.60             1.51     33.90      40.05
średnia ucinana 10%   35.22             1.74     31.76      38.58
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (obliczenia – funkcje bazowe mean(), median(), sd(), sample(), replicate(), quantile(); rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim są Ross Ihaka i Robert Gentleman?
To statystycy, którzy około 1990 r. na Uniwersytecie w Auckland w Nowej Zelandii zaczęli pisać język R i opisali go w 1996 r. w Journal of Computational and Graphical Statistics. Obaj należą do R Core – grupy rozwijającej R. Gentleman jest też pierwszym autorem artykułu o projekcie Bioconductor.
Dlaczego język R nazywa się R?
Według oficjalnego FAQ projektu nazwa ma dwa źródła: to pierwsza litera imion dwóch pierwszych autorów – Roberta Gentlemana i Rossa Ihaki – i zarazem gra z nazwą języka S z Bell Labs, na którym R się wzorował.
Czy R to to samo co S?
Nie, choć są bardzo podobne. R wygląda jak S i stara się zgadzać z jego definicją z książek „Blue Book” i „White Book”. Implementacja i semantyka R, np. zasięg leksykalny funkcji, pochodzą jednak z języka Scheme.
Co to jest R Core?
Grupa osób z prawem zmieniania kodu źródłowego R. Powstała w 1997 r. z dziewięcioma członkami; w 2026 r. liczy 19 osób, w tym Rossa Ihakę, Roberta Gentlemana i Johna Chambersa. W pracy cytujesz R jako „R Core Team”.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Chambers, J. M. (2020). S, R, and data science. Proceedings of the ACM on Programming Languages, 4(HOPL), 1–17. https://doi.org/10.1145/3386334 ● Otwarty dostęp
- Fox, J. (2009). Aspects of the social organization and trajectory of the R Project. The R Journal, 1(2), 5–13. https://doi.org/10.32614/rj-2009-014 ● Otwarty dostęp
- Gentleman, R. C., Carey, V. J., Bates, D. M., Bolstad, B., Dettling, M., Dudoit, S., Ellis, B., Gautier, L., Ge, Y., Gentry, J., Hornik, K., Hothorn, T., Huber, W., Iacus, S., Irizarry, R., Leisch, F., Li, C., Maechler, M., Rossini, A. J., . . . Zhang, J. (2004). Bioconductor: Open software development for computational biology and bioinformatics. Genome Biology, 5(10), Article R80. https://doi.org/10.1186/gb-2004-5-10-r80 ● Otwarty dostęp
- Hornik, K., & R Core Team. (2026). The R FAQ. https://cran.r-project.org/doc/FAQ/R-FAQ.html ● Otwarty dostęp
- Ihaka, R., & Gentleman, R. (1996). R: A language for data analysis and graphics. Journal of Computational and Graphical Statistics, 5(3), 299–314. https://doi.org/10.1080/10618600.1996.10474713
Cytowania BibTeX
@article{chambers2020s, author={Chambers, John M.}, title={{S, R, and data science}}, journal={Proceedings of the ACM on Programming Languages}, year={2020}, volume={4}, number={HOPL}, pages={1--17}, doi={10.1145/3386334}}@article{fox2009aspects, author={Fox, John}, title={{Aspects of the social organization and trajectory of the R Project}}, journal={The R Journal}, year={2009}, volume={1}, number={2}, pages={5--13}, doi={10.32614/rj-2009-014}}@article{gentleman2004bioconductor, author={Gentleman, Robert C. and Carey, Vincent J. and Bates, Douglas M. and Bolstad, Ben and Dettling, Marcel and Dudoit, Sandrine and Ellis, Byron and Gautier, Laurent and Ge, Yongchao and Gentry, Jeff and Hornik, Kurt and Hothorn, Torsten and Huber, Wolfgang and Iacus, Stefano and Irizarry, Rafael and Leisch, Friedrich and Li, Cheng and Maechler, Martin and Rossini, Anthony J. and Sawitzki, Gunther and Smith, Colin and Smyth, Gordon and Tierney, Luke and Yang, Jean Y. H. and Zhang, Jianhua}, title={{Bioconductor: Open software development for computational biology and bioinformatics}}, journal={Genome Biology}, year={2004}, volume={5}, number={10}, eid={R80}, doi={10.1186/gb-2004-5-10-r80}}@misc{hornik2026r, author={Hornik, Kurt and {R Core Team}}, title={{The R FAQ}}, year={2026}, url={https://cran.r-project.org/doc/FAQ/R-FAQ.html}}@article{ihaka1996r, author={Ihaka, Ross and Gentleman, Robert}, title={{R: A language for data analysis and graphics}}, journal={Journal of Computational and Graphical Statistics}, year={1996}, volume={5}, number={3}, pages={299--314}, doi={10.1080/10618600.1996.10474713}}