y ~ x używaną dziś w lm() i glm(). Laureat nagrody ACM Software System Award (1998), członek R Core.Kim jest John M. Chambers?
John M. Chambers to statystyk, główny projektant języka S, z którego wyrósł R. Według opisu jego wywiadu dla Computer History Museum studiował matematykę, fizykę i chemię na Uniwersytecie Toronto, a ze statystyką i Fortranem zetknął się w 1960 r. Podczas doktoratu na Harvardzie profesor podsunął mu letni staż w Bell Laboratories, który zamienił się w stałą pracę. W Bell Labs współpracował m.in. z Johnem Tukeyem (Chambers, 2022).
Tam kierował tworzeniem S – interaktywnego języka zaproponowanego w 1976 r. w miejsce nieinteraktywnych programów w Fortranie, którymi badacze liczyli statystyki. S działał najpierw w systemie Honeywell GCOS, potem w UNIX-ie (Chambers, 2022). Sam Chambers (2020) podkreśla, że S nie był osobnym projektem języka programowania, lecz częścią środowiska pracy badaczy analizy danych. W 1998 r. ACM przyznało mu, jako głównemu projektantowi S, nagrodę Software System Award; dziś należy do R Core – grupy rozwijającej R (Hornik i R Core Team, 2026).
Najważniejsze pomysły
- Język S w czterech książkach. FAQ projektu R wylicza kolejne etapy: „Brown Book” Beckera i Chambersa z 1984 r., „Blue Book” Beckera, Chambersa i Wilksa z 1988 r. (S w wersji 2), „White Book” Chambersa i Hastiego z 1992 r. (wersja 3, która dodała struktury do modelowania statystycznego) i „Green Book” Chambersa z 1998 r. (wersja 4) (Hornik i R Core Team, 2026).
- Formuła modelu. Zapis
y ~ x1 + x2pochodzi z modeli statystycznych w S opisanych w „White Book” (Chambers i Hastie, 1992); dokumentacja R przy opisie formuł wciąż odsyła do rozdziału 2 tej książki. Formuła oddziela co modelujemy (zmienne, interakcje) od jak dopasowujemy model: ta sama formuła trafia do regresji liniowej, ANOVA, regresji logistycznej czy regresji Poissona. - Od S do R. R świadomie zaprojektowano tak, by odtworzyć S w otwartym oprogramowaniu, a cechy S przeszły do R (Chambers, 2020). Historię tej drugiej strony opisuje hasło Ross Ihaka i Robert Gentleman.
- Analiza danych jako dziedzina. Chambers (2020) traktuje R jako język dziedzinowy analizy danych – dziś mówimy: data science.
Ciekawostka
Nagroda, która co roku wraca do studentów. ACM uzasadniło nagrodę z 1998 r. tym, że S „forever altered the way people analyze, visualize, and manipulate data” – przytacza je FAQ projektu R (Hornik i R Core Team, 2026) – trwale zmienił sposób analizowania, wizualizowania i przetwarzania danych.
Chambers przekazał nagrodę pieniężną sekcji Statistical Computing Amerykańskiego Towarzystwa Statystycznego (ASA). Z tych pieniędzy ufundowano coroczną John M. Chambers Statistical Software Award – nagrodę za oprogramowanie statystyczne tworzone przez studentów dowolnego kierunku (American Statistical Association, b.d.).
Przykład: jedna formuła, trzy modele
Dane warpbreaks z pakietu datasets to – według pliku pomocy – liczba zerwań osnowy na krosno (krosno odpowiada ustalonej długości przędzy) dla dwóch rodzajów wełny (A, B) i trzech poziomów naprężenia (L, M, H), po 9 krosien w każdej z sześciu kombinacji; źródło: książka L. H. C. Tippetta z 1950 r. Zapisujemy jedną formułę breaks ~ wool + tension. To zwykły obiekt klasy formula: można go przechować, obejrzeć (all.vars() zwraca breaks, wool, tension) i przekazać dowolnej funkcji.
- Macierz modelu.
model.matrix()zamienia formułę na 54 wiersze i 4 kolumny: wyraz wolny,woolB,tensionMitensionH– kodowanie zero-jedynkowe względem wełny A i naprężenia L (zob. też kodowanie zmiennych w R). lm(). Współczynniki: 39.28 zerwań dla wełny A przy naprężeniu L, −5.78 dla wełny B, −10.00 dla M i −14.72 dla H – efekty się dodają.aov(). Ta sama formuła daje tabelę ANOVA: naprężenie F(2, 50) = 7.54, p = .001, wełna F(1, 50) = 3.34, p = .074.glm(..., family = poisson). Te same cztery kolumny (identical()zwracaTRUE), ale po potęgowaniu współczynniki są mnożnikami: wełna B 0.814 (o ok. 19% mniej zerwań), naprężenie M 0.725, H 0.595. Stosunek sumy kwadratów reszt Pearsona do stopni swobody wynosi 4.26, czyli dane wykazują nadmierną dyspersję.update(). Formułę zmienia się jak równanie:. ~ . + wool:tensiondodaje interakcję, która poprawia dopasowanie, F(2, 48) = 4.19, p = .021.
Nie twierdzimy, że Chambers analizował te dane – to nasza ilustracja idei formuły.
Na rysunku
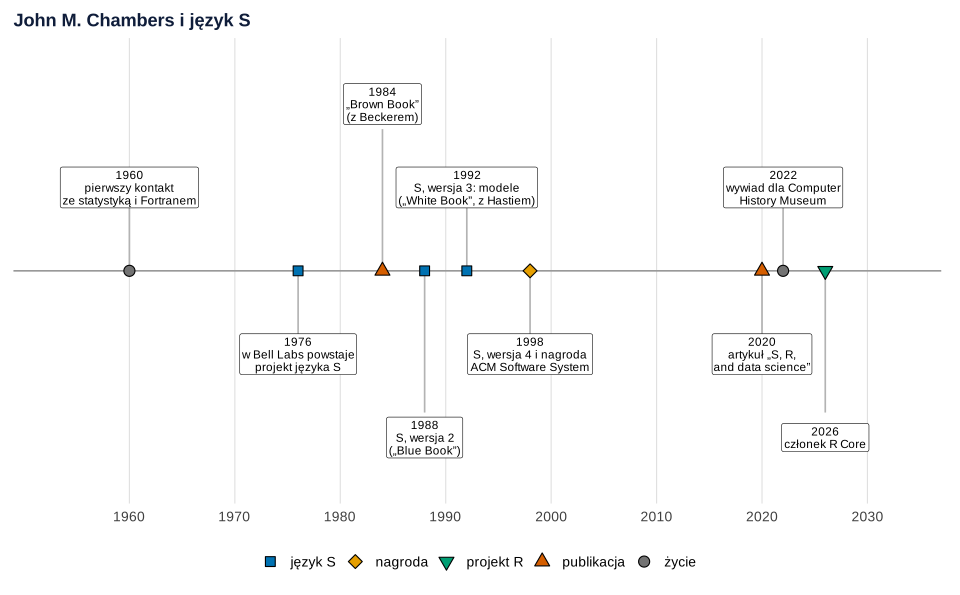
Co widać. Od propozycji języka (1976) do wersji 4 (1998) minęło ponad 20 lat, a każdą wersję S wyznacza książka. Formuła modelu pojawia się dopiero w trzeciej wersji, w 1992 r.
Na co uważać. Oś pokazuje tylko zdarzenia potwierdzone w cytowanych źródłach; pomija m.in. rok przejścia do Bell Labs, którego te źródła nie podają. Rok książki to rok publikacji, nie powstania pomysłu.
Podpis do pracy:
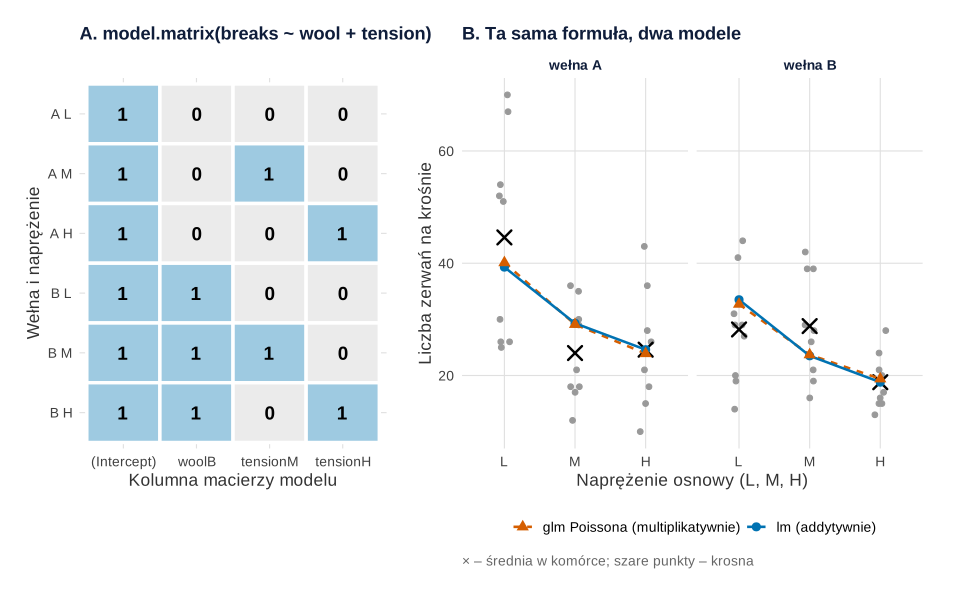
breaks ~ wool + tension (A) i przewidywania dwóch modeli dopasowanych z tej samej formuły (B). Dane: datasets::warpbreaks (Tippett, 1950, według pliku pomocy). Rysunek: R, pakiety ggplot2 i patchwork; rozrzut punktów w poziomie losowy (seed = 851).Co widać. Panel A to dosłownie to, co R robi z formułą: każdą kombinację czynników zamienia na wiersz zer i jedynek. Na panelu B model liniowy (efekty się dodają) i model Poissona (efekty się mnożą) dają tu prawie te same przewidywania – i oba mijają się ze średnią 44.6 dla wełny A przy naprężeniu L, bo formuła bez interakcji zakłada ten sam spadek dla obu wełen.
Na co uważać. Ta sama formuła nie znaczy tego samego modelu: współczynniki lm() to różnice w liczbie zerwań, a glm() – różnice logarytmów (po potęgowaniu: ilorazy). Model Poissona przy nadmiernej dyspersji zaniża błędy standardowe.
Podpis do pracy:
Gdzie spotkasz Chambersa w swojej pracy
- Każdy model w R.
lm(wynik ~ grupa + wiek),glm(..., family = binomial),aov(), a nawett.test(wynik ~ grupa)– wszystkie przyjmują formułę z S. - Zmienne kategorialne. Gdy czynnik wchodzi do formuły, R sam tworzy kolumny 0/1; który poziom jest odniesieniem, decyduje kolejność poziomów czynnika.
- Modele dla zliczeń. Ten sam zapis w
glm()z inną funkcją łączącą – zob. Regresja dla zliczeń krok po kroku. - Samo R. Podstawy pracy w R opisuje hasło R (język programowania).
Spory, mity i trudne strony
„Chambers sam napisał S”. FAQ R nazywa go głównym projektantem, ale książki o S mają współautorów: Richarda A. Beckera, Allana R. Wilksa i Trevora J. Hastiego (Hornik i R Core Team, 2026).
„Formuła y ~ x to wynalazek R”. Nie – R przejął ją z trzeciej wersji S (Chambers i Hastie, 1992), zgodnie z zasadą, że R trzyma się definicji S z „Blue Book” i „White Book”.
„Ta sama formuła – ten sam wynik”. Formuła opisuje tylko strukturę modelu. Rozkład, funkcja łącząca i metoda estymacji zależą od funkcji, której ją przekażesz – i od nich zależy interpretacja współczynników.
Formuła modelu w R
Kod rysuje oś czasu, tworzy formułę i macierz modelu, dopasowuje z tej samej formuły lm(), aov() i glm(), sprawdza nadmierną dyspersję i dodaje interakcję przez update(). Rysunki na stronie powstały z tych samych obiektów p_os i p_metoda z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
Oś czasu i jedna formuła w trzech modelach na danych warpbreaks
Kod R rysunków 1 i 2
# John M. Chambers: oś czasu i formuła modelu z języka S – jedna formuła, trzy modele (lm, aov, glm) na danych warpbreaks
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", zielony = "#009E73", szary = "grey45")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"))

# 1. Oś czasu (lata według Computer History Museum 2022, Hornika i R Core Team 2026, ASA i Chambersa 2020)
zdarzenia <- data.frame(
  rok = c(1960, 1976, 1984, 1988, 1992, 1998, 2020, 2022, 2026),
  opis = c("pierwszy kontakt\nze statystyką i Fortranem", "w Bell Labs powstaje\nprojekt języka S", "„Brown Book”\n(z Beckerem)",
           "S, wersja 2\n(„Blue Book”)", "S, wersja 3: modele\n(„White Book”, z Hastiem)", "S, wersja 4 i nagroda\nACM Software System",
           "artykuł „S, R,\nand data science”", "wywiad dla Computer\nHistory Museum",
           "członek R Core"),
  rodzaj = c("życie", "język S", "publikacja", "język S", "język S", "nagroda", "publikacja", "życie", "projekt R"))
zdarzenia$y <- c(1.3, -1.3, 2.6, -2.6, 1.3, -1.3, -1.3, 1.3, -2.6)   # wysokość etykiet, żeby się nie nakładały
p_os <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_segment(aes(xend = rok, yend = y * 0.85), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.5) +
  geom_label(aes(y = y, label = paste0(rok, "\n", opis)), size = 3.1, lineheight = 0.9, linewidth = 0.2) +
  scale_shape_manual(values = c("życie" = 21, "język S" = 22, "publikacja" = 24, "nagroda" = 23, "projekt R" = 25), name = NULL) +
  scale_fill_manual(values = c("życie" = oi[["szary"]], "język S" = oi[["niebieski"]], "publikacja" = oi[["cynober"]],
                               "nagroda" = oi[["pomaranczowy"]], "projekt R" = oi[["zielony"]]), name = NULL) +
  scale_x_continuous(breaks = seq(1960, 2030, 10), limits = c(1953, 2033)) + scale_y_continuous(limits = c(-3.3, 3.3)) +
  labs(title = "John M. Chambers i język S", x = NULL, y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank(), legend.position = "bottom")

# 2. Dane: liczba zerwań osnowy na krosnach – 2 rodzaje wełny × 3 poziomy naprężenia, po 9 krosien (Tippett 1950)
data(warpbreaks, package = "datasets")
str(warpbreaks)

# Formuła to zwykły obiekt języka: można ją zapisać, obejrzeć i przekazać dowolnej funkcji modelującej
f <- breaks ~ wool + tension
class(f)
all.vars(f)

# model.matrix() zamienia formułę i czynniki na kolumny 0/1 (kodowanie zero-jedynkowe względem poziomów A i L)
X <- model.matrix(f, data = warpbreaks)
dim(X)
komorki <- unique(data.frame(warpbreaks[, c("wool", "tension")], X, check.names = FALSE))
rownames(komorki) <- NULL
komorki

# Ta sama formuła, trzy modele
m_lm <- lm(f, data = warpbreaks)
m_aov <- aov(f, data = warpbreaks)
m_glm <- glm(f, family = poisson, data = warpbreaks)
round(coef(m_lm), 2)
summary(m_aov)
round(exp(coef(m_glm)), 3)
identical(colnames(model.matrix(m_glm)), names(coef(m_lm)))
# Nadmierna dyspersja w modelu Poissona: suma kwadratów reszt Pearsona / stopnie swobody (przy dobrym dopasowaniu ≈ 1)
round(sum(residuals(m_glm, type = "pearson")^2) / df.residual(m_glm), 2)

# Formułę można zmieniać jak tekst równania: update() dodaje interakcję
f_int <- update(f, . ~ . + wool:tension)
f_int
anova(m_lm, lm(f_int, data = warpbreaks))

# Przewidywania obu modeli addytywnych dla sześciu komórek planu
siatka <- expand.grid(wool = levels(warpbreaks$wool), tension = levels(warpbreaks$tension))
siatka$srednia <- as.vector(tapply(warpbreaks$breaks, list(warpbreaks$wool, warpbreaks$tension), mean))
siatka$lm <- predict(m_lm, siatka)
siatka$glm_poisson <- predict(m_glm, siatka, type = "response")
siatka[, 3:5] <- round(siatka[, 3:5], 1)
siatka

# Rysunek: macierz modelu dla sześciu komórek (A) i przewidywania lm vs glm z tej samej formuły (B)
X_df <- data.frame(komorka = rep(paste(komorki$wool, komorki$tension), ncol(X)),
                   kolumna = factor(rep(colnames(X), each = nrow(komorki)), levels = colnames(X)),
                   wartosc = as.vector(as.matrix(komorki[, colnames(X)])))
X_df$komorka <- factor(X_df$komorka, levels = rev(unique(X_df$komorka)))
p_X <- ggplot(X_df, aes(kolumna, komorka, fill = factor(wartosc))) +
  geom_tile(colour = "white", linewidth = 1.2) +
  geom_text(aes(label = wartosc), size = 5, fontface = "bold") +
  scale_fill_manual(values = c("0" = "grey92", "1" = "#9ecae1"), guide = "none") +
  labs(title = "A. model.matrix(breaks ~ wool + tension)", x = "Kolumna macierzy modelu", y = "Wełna i naprężenie") +
  motyw + theme(panel.grid = element_blank())
dl <- rbind(data.frame(siatka[, c("wool", "tension")], model = "lm (addytywnie)", wartosc = siatka$lm),
            data.frame(siatka[, c("wool", "tension")], model = "glm Poissona (multiplikatywnie)", wartosc = siatka$glm_poisson))
p_pred <- ggplot(warpbreaks, aes(tension, breaks)) +
  geom_point(position = position_jitter(width = 0.08, height = 0, seed = 851), colour = "grey60", size = 1.6) +
  geom_point(data = siatka, aes(y = srednia), shape = 4, size = 4, stroke = 1.3) +
  geom_line(data = dl, aes(y = wartosc, group = model, colour = model, linetype = model), linewidth = 0.9) +
  geom_point(data = dl, aes(y = wartosc, colour = model, shape = model), size = 2.8) +
  facet_wrap(~ wool, labeller = labeller(wool = c(A = "wełna A", B = "wełna B"))) +
  scale_colour_manual(values = c("lm (addytywnie)" = oi[["niebieski"]], "glm Poissona (multiplikatywnie)" = oi[["cynober"]]), name = NULL) +
  scale_linetype_manual(values = c("lm (addytywnie)" = "solid", "glm Poissona (multiplikatywnie)" = "22"), name = NULL) +
  scale_shape_manual(values = c("lm (addytywnie)" = 16, "glm Poissona (multiplikatywnie)" = 17), name = NULL) +
  labs(title = "B. Ta sama formuła, dwa modele", x = "Naprężenie osnowy (L, M, H)", y = "Liczba zerwań na krośnie",
       caption = "× – średnia w komórce; szare punkty – krosna") +
  motyw + theme(legend.position = "bottom")
p_metoda <- p_X + p_pred + plot_layout(widths = c(1, 1.5))
p_os
p_metoda
Wynik w R
'data.frame':	54 obs. of  3 variables:
 $ breaks : num  26 30 54 25 70 52 51 26 67 18 ...
 $ wool   : Factor w/ 2 levels "A","B": 1 1 1 1 1 1 1 1 1 1 ...
 $ tension: Factor w/ 3 levels "L","M","H": 1 1 1 1 1 1 1 1 1 2 ...
[1] "formula"
[1] "breaks"  "wool"    "tension"
[1] 54  4
  wool tension (Intercept) woolB tensionM tensionH
1    A       L           1     0        0        0
2    A       M           1     0        1        0
3    A       H           1     0        0        1
4    B       L           1     1        0        0
5    B       M           1     1        1        0
6    B       H           1     1        0        1
(Intercept)       woolB    tensionM    tensionH
      39.28       -5.78      -10.00      -14.72
            Df Sum Sq Mean Sq F value  Pr(>F)
wool         1    451   450.7   3.339 0.07361 .
tension      2   2034  1017.1   7.537 0.00138 **
Residuals   50   6748   135.0
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
(Intercept)       woolB    tensionM    tensionH
     40.124       0.814       0.725       0.595
[1] TRUE
[1] 4.26
breaks ~ wool + tension + wool:tension
Analysis of Variance Table

Model 1: breaks ~ wool + tension
Model 2: breaks ~ wool + tension + wool:tension
  Res.Df    RSS Df Sum of Sq      F  Pr(>F)
1     50 6747.9
2     48 5745.1  2    1002.8 4.1891 0.02104 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
  wool tension srednia   lm glm_poisson
1    A       L    44.6 39.3        40.1
2    B       L    28.2 33.5        32.7
3    A       M    24.0 29.3        29.1
4    B       M    28.8 23.5        23.7
5    A       H    24.6 24.6        23.9
6    B       H    18.8 18.8        19.4
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (modele – funkcje bazowe model.matrix(), lm(), aov(), glm(), update(), anova(); rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim jest John M. Chambers?
Statystykiem, który w Bell Laboratories kierował tworzeniem języka S – interaktywnego środowiska do analizy danych, zaproponowanego w 1976 r. Z S wyrósł język R; Chambers należy dziś do R Core, grupy rozwijającej R.
Co ma wspólnego język S z językiem R?
R powstał jako otwarta implementacja S: ma tę samą składnię i stara się zgadzać z definicją S z książek „Blue Book” i „White Book”, choć jego semantyka pochodzi z języka Scheme. Dlatego np. formuła modelu z „White Book” działa w R tak samo jak w S.
Skąd w R zapis formuły y ~ x?
Z trzeciej wersji języka S, opisanej w książce Statistical Models in S (Chambers i Hastie, 1992). Formuła opisuje strukturę modelu, a funkcja, której ją przekażesz (lm, aov, glm), decyduje, jaki model zostanie dopasowany.
Za co John Chambers dostał nagrodę ACM?
W 1998 r. Association for Computing Machinery przyznało mu Software System Award za system S. Nagrodę pieniężną przekazał Amerykańskiemu Towarzystwu Statystycznemu, które ufundowało z niej coroczną nagrodę dla studentów tworzących oprogramowanie statystyczne.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- American Statistical Association. (b.d.). John M. Chambers Statistical Software Award. Pobrano 18 listopada 2026 z https://community.amstat.org/jointscsg-section/awards/john-m-chambers ● Otwarty dostęp
- Chambers, J. (2022). Chambers, John oral history [Interview by J. Mashey; catalog no. 102792762]. Computer History Museum. https://www.computerhistory.org/collections/catalog/102792762 ● Otwarty dostęp
- Chambers, J. M. (2020). S, R, and data science. Proceedings of the ACM on Programming Languages, 4(HOPL), 1–17. https://doi.org/10.1145/3386334 ● Otwarty dostęp
- Chambers, J. M., & Hastie, T. J. (Eds.). (1992). Statistical models in S. Wadsworth & Brooks/Cole.
- Hornik, K., & R Core Team. (2026). The R FAQ. https://cran.r-project.org/doc/FAQ/R-FAQ.html ● Otwarty dostęp
Cytowania BibTeX
@misc{asandchambersaward, author={{American Statistical Association}}, title={{John M. Chambers Statistical Software Award}}, url={https://community.amstat.org/jointscsg-section/awards/john-m-chambers}}@misc{chm2022chambers, author={Chambers, John}, title={{Chambers, John oral history [Interview by J. Mashey; catalog no. 102792762]}}, year={2022}, publisher={Computer History Museum}, url={https://www.computerhistory.org/collections/catalog/102792762}}@article{chambers2020s, author={Chambers, John M.}, title={{S, R, and data science}}, journal={Proceedings of the ACM on Programming Languages}, year={2020}, volume={4}, number={HOPL}, pages={1--17}, doi={10.1145/3386334}}@book{chambers1992statistical, author={Chambers, John M. and Hastie, Trevor J.}, title={{Statistical models in S}}, year={1992}, publisher={Wadsworth \& Brooks/Cole}}@misc{hornik2026r, author={Hornik, Kurt and {R Core Team}}, title={{The R FAQ}}, year={2026}, url={https://cran.r-project.org/doc/FAQ/R-FAQ.html}}