Kim był Harvey Goldstein?
Harvey Goldstein (1939–2020) urodził się 30 października 1939 r. w Whitechapel we wschodnim Londynie. Studiował matematykę na Uniwersytecie w Manchesterze, gdzie chodził też na kursy statystyki u Toby’ego Lewisa, a potem zrobił dyplom ze statystyki w University College London. Jego pierwszą publikacją była krótka praca w „Nature” napisana m.in. z Richardem Dollem (Gray i in., 2020).
Od 1964 r. był wykładowcą w londyńskim Institute of Child Health i z Jimem Tannerem badał rozwój dzieci. W latach 1972–1977 pracował w National Children’s Bureau nad brytyjską kohortą urodzonych w 1958 r.. W 1977 r. objął w Institute of Education w Londynie katedrę metod statystycznych – pierwszą w Wielkiej Brytanii katedrę statystyki w instytucie badań edukacyjnych. W 1996 r. jako pierwszy badacz z wydziału edukacji został członkiem British Academy, a dwa lata później otrzymał srebrny Medal Guya Royal Statistical Society. Gdy jego zespół przeniósł się na Uniwersytet w Bristolu, w 2005 r. podążył za nim i objął tam profesurę na część etatu. Zmarł w kwietniu 2020 r., w wieku 80 lat, jako jedna z wczesnych ofiar pandemii koronawirusa (Gray i in., 2020).
Najważniejsze pomysły
- Estymacja modeli wielopoziomowych (1986). W „Biometrice” podał iteracyjną metodę uogólnionych najmniejszych kwadratów (IGLS) dla danych o strukturze hierarchicznej i pokazał, że przy rozkładzie normalnym jest równoważna metodzie największej wiarygodności (Goldstein, 1986). Ogólną postać modelu wielopoziomowego zapisał już w niepublikowanej pracy z 1983 r. – szukając uczciwego sposobu porównywania szkół (Gray i in., 2020).
- Podręcznik. Pierwsze wydanie ukazało się w 1987 r. jako Multilevel Models in Educational and Social Research, kolejne pod tytułem Multilevel Statistical Models, czwarte w 2010 r. (Goldstein, 2010).
- Programy. Z programistą Jonem Rasbashem rozwijał kolejne programy do modeli wielopoziomowych: ML2, ML3, MLn i MLwiN; z MLwiN skorzystało około 30 tysięcy użytkowników na świecie (Gray i in., 2020).
- Krytyka tabel ligowych. Pokazywał, że przedziały ufności dla efektów szkół są tak szerokie, że większości szkół nie da się wiarygodnie rozróżnić, a dokładnej kolejności szkół nie można uczciwie ustalić (Goldstein i in., 1993; Goldstein i Spiegelhalter, 1996).
Ciekawostka
Narodziny brytyjskiej szkoły modeli wielopoziomowych opisał naoczny świadek, John Gray. Na wieczornym, nieplanowanym seminarium w Lancasterze Nicholas Longford przez kwadrans zapisywał tablicę symbolami, po czym oddał głos Goldsteinowi, który przedstawił swoje rozwiązanie tego samego problemu. Po krótkiej wymianie zdań obaj podali sobie ręce i usiedli, a sąsiad Graya nazwał to wydarzeniem historycznym. (relacja Graya z 1998 r. przytoczona we wspomnieniu: Gray i in., 2020).
Goldstein cenił niezależność. W jego życiorysie zawodowym, jak podają autorzy wspomnienia, figuruje nietypowy wpis: w 2006 r. odmówił przyjęcia Orderu Imperium Brytyjskiego (CBE), bo – jak piszą – przyjęcie orderu oznaczałoby przymknięcie oka na lata, w których ministrowie odrzucali jego rady, i mogło naruszyć jego niezależność.
Przykład na danych z pakietu R
Pakiet jomo zawiera zbiór ExamScores: według pliku pomocy wyniki egzaminów uczniów z sześciu okręgów szkolnych wewnętrznego Londynu, opisane w pracy Goldsteina i współpracowników (1993). Wynik egzaminu w wieku 16 lat jest znormalizowany, a wynik testu czytania London Reading Test w wieku 11 lat – standaryzowany. To wersja do ćwiczeń z brakami danych, więc bierzemy tylko uczniów z obydwoma wynikami: 2476 osób z 65 szkół (od 2 do 117 uczniów).
Dopasowujemy dwa modele z losowym wyrazem wolnym szkoły. Pierwszy porządkuje szkoły według samych wyników egzaminu – jak „surowa” tabela ligowa. Drugi uwzględnia wynik na wejściu, czyli liczy wartość dodaną: każde odchylenie standardowe wyniku w wieku 11 lat wiąże się ze wzrostem wyniku egzaminu o 0.53 SD, a odchylenie standardowe efektów szkół spada z 0.40 do 0.31.
Obie tabele są podobne (korelacja rang Spearmana .89), ale 18 z 65 szkół przesuwa się o co najmniej 10 miejsc, jedna – o 23. Niepewność miejsca sprawdzamy, losując 10 000 razy efekty szkół z rozkładów normalnych wokół oszacowań, z ich błędami standardowymi. Mediana szerokości 95% przedziału dla miejsca wynosi 31 pozycji, a u 28 szkół przedział obejmuje ponad połowę tabeli. Efekt 40 z 65 szkół nie różni się od przeciętnego; od średniej odróżnia się 12 szkół powyżej i 13 poniżej. Nawet najlepsza szkoła może zajmować miejsca od 1 do 3, a trzecia – od 1 do 9.
Na rysunku
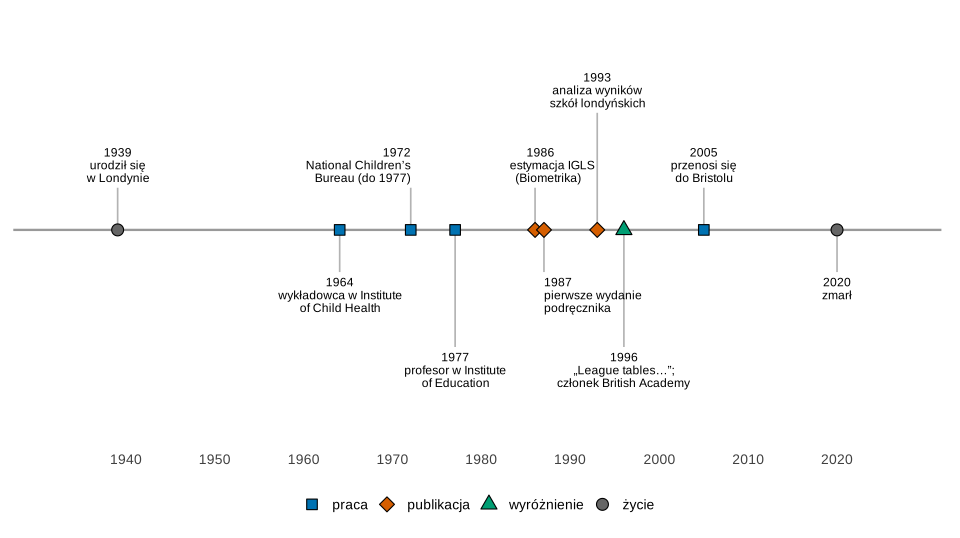
Co widać. Przez kilkanaście lat Goldstein był statystykiem medycznym; modele wielopoziomowe i krytyka tabel ligowych przyszły po 1977 r.
Na co uważać. Oś pomija lata studiów, których cytowane wspomnienie nie podaje, i Medal Guya, który wspomnienie datuje tylko względnie („dwa lata później” niż członkostwo British Academy).
Podpis do pracy:
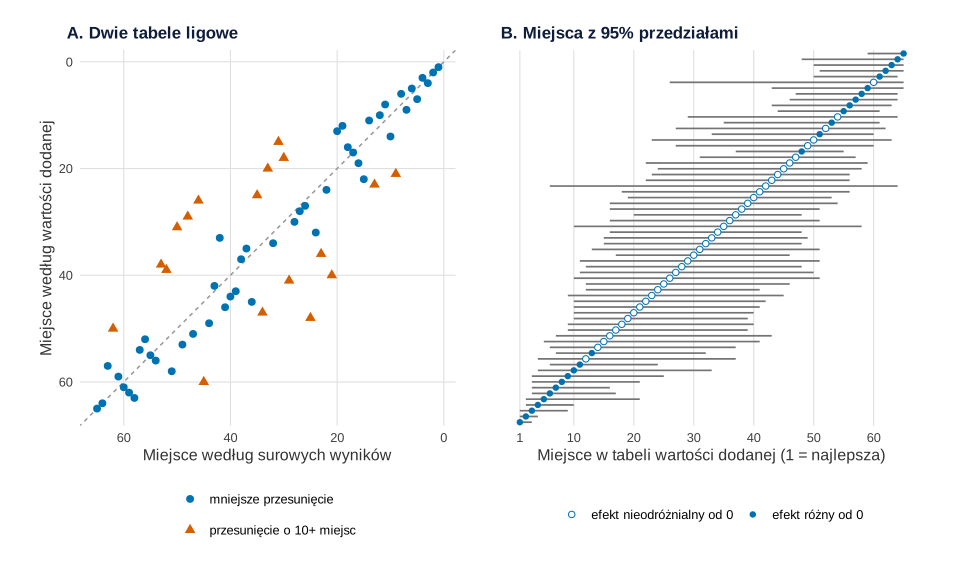
jomo::ExamScores, uczniowie z obydwoma wynikami. Obliczenia i rysunek: R, pakiety lme4, ggplot2 i patchwork (10 000 losowań, set.seed(971)).Co widać. Panel A: uwzględnienie wyniku na wejściu przetasowuje zwłaszcza środek tabeli. Panel B: tylko na obu krańcach tabeli przedziały są krótkie. W środku szkoła z 30. miejsca mogłaby równie dobrze zajmować dowolne miejsce od 17. do 46.
Na co uważać. Losowanie efektów szkół z niezależnych rozkładów normalnych pomija niepewność parametrów modelu, więc prawdziwe przedziały są raczej szersze. Model nie uwzględnia innych cech uczniów, jak praca z 1993 r.
Podpis do pracy:
Gdzie spotkasz Goldsteina w swojej pracy
- Porównując szkoły, szpitale czy zespoły, efekty grup z modelu wielopoziomowego pokaż z przedziałami, np. na wykresie gąsienicowym, a nie jako ranking. Różnicę między rankingiem a oceną pozycji wyjaśnia hasło ranking a ocena pozycji.
- Ranking wartości dodanej wymaga uwzględnienia wyniku na wejściu; bez tego mierzysz głównie skład uczniów. Jak efekty grup są ściągane ku średniej, pokazuje wpis model mieszany w obrazkach.
- Pozycje w rankingu zmieniają się z roku na rok także przez regresję do średniej – przykład znajdziesz we wpisie o rankingu kampanii.
- Część zróżnicowania wyników przypadającą na grupy opisuje korelacja wewnątrzklasowa, a o różnicy między efektami stałymi i losowymi pisze hasło efekty stałe i losowe.
Te same modele w USA rozwijali Stephen Raudenbush i Anthony Bryk.
Spory, mity i trudne strony
- Tabele ligowe szkół. Przez dwie dekady Goldstein przekonywał, że przedziały dla efektów szkół są zbyt szerokie na drobny ranking, a wyniki wartości dodanej są mało stabilne w czasie (Gray i in., 2020). Rodzic wybierający szkołę patrzy na wyniki rocznika, który zaczął naukę kilka lat wcześniej, więc ranking niewiele mu mówi (Leckie i Goldstein, 2009). Goldstein i Spiegelhalter (1996) nie odrzucali porównań instytucji, ale zalecali w nich dużą ostrożność.
- Spór o model Rascha. Krytyka stosowania modelu Rascha w brytyjskiej National Foundation for Educational Research, wówczas głównym twórcy testów szkolnych, skończyła się publicznym sporem (Gray i in., 2020).
- Czy wartość dodana rozwiązuje problem? Nie do końca: jest lepsza od surowych wyników, ale ma inne ograniczenia (Goldstein i Spiegelhalter, 1996).
Tabela ligowa Goldsteina w R
Kod wczytuje dane egzaminacyjne z pakietu jomo, dopasowuje dwa modele z losowym wyrazem wolnym szkoły (surowy i wartości dodanej), porównuje miejsca szkół, wyznacza 95% przedziały dla miejsc z 10 000 losowań i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Jedyne losowanie to symulacja miejsc (set.seed(971), ziarno ustalone raz).
1. Dwie tabele ligowe i niepewność miejsc: rysunek 2
Kod R rysunku 2
# Harvey Goldstein: tabela ligowa szkół i niepewność miejsc w rankingu – dane egzaminacyjne z Londynu (jomo::ExamScores)
suppressPackageStartupMessages({library(jomo); library(lme4); library(ggplot2); library(patchwork)})
kol <- c(surowy = "#E69F00", dodana = "#0072B2", przedzial = "grey45", wyrozniona = "#D55E00")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(ExamScores, package = "jomo")
# normexam – znormalizowany wynik egzaminu w wieku 16 lat; standlrt – standaryzowany wynik London Reading Test w wieku 11 lat
# W tej wersji zbioru część wyników jest brakująca – bierzemy uczniów, którzy mają oba wyniki
d <- ExamScores[complete.cases(ExamScores[, c("normexam", "standlrt")]), c("school", "normexam", "standlrt")]
d$school <- droplevels(d$school)
n_j <- as.numeric(table(d$school))
c(uczniowie = nrow(d), szkoly = nlevels(d$school))
summary(n_j)

# 1. Tabela „surowa”: same wyniki egzaminu; 2. wartość dodana: wynik egzaminu po uwzględnieniu wyniku na wejściu
m_sur <- lmer(normexam ~ 1 + (1 | school), data = d)
m_wd  <- lmer(normexam ~ standlrt + (1 | school), data = d)
round(fixef(m_wd), 3)
round(c(sd_szkol_surowy = as.numeric(attr(VarCorr(m_sur)$school, "stddev")),
        sd_szkol_wd = as.numeric(attr(VarCorr(m_wd)$school, "stddev")), sd_reszt_wd = sigma(m_wd)), 3)

efekty <- function(m) {                    # efekt szkoły (BLUP) i jego warunkowy błąd standardowy
  r <- ranef(m, condVar = TRUE)$school
  data.frame(school = rownames(r), efekt = r[, 1], se = sqrt(attr(r, "postVar")[1, 1, ]))
}
e <- merge(efekty(m_sur), efekty(m_wd), by = "school", suffixes = c("_sur", "_wd"))
J <- nrow(e)
e$miejsce_sur <- rank(-e$efekt_sur)        # 1 = najlepsza szkoła
e$miejsce_wd  <- rank(-e$efekt_wd)
round(c(korelacja_rang = cor(e$miejsce_sur, e$miejsce_wd, method = "spearman"),
        przesuniecie_o_10_i_wiecej = sum(abs(e$miejsce_sur - e$miejsce_wd) >= 10),
        najwieksze_przesuniecie = max(abs(e$miejsce_sur - e$miejsce_wd))), 2)

# 3. Niepewność miejsca: losujemy efekty szkół z rozkładów normalnych o średniej = oszacowanie i SD = błąd standardowy
set.seed(971)
B <- 10000
los <- matrix(rnorm(B * J, mean = rep(e$efekt_wd, each = B), sd = rep(e$se_wd, each = B)), nrow = B)
miejsca <- t(apply(-los, 1, rank))         # B × J: miejsce każdej szkoły w każdym losowaniu
e$od <- apply(miejsca, 2, quantile, probs = 0.025)
e$do <- apply(miejsca, 2, quantile, probs = 0.975)
e$szerokosc <- e$do - e$od
e$rozna_od_zera <- abs(e$efekt_wd) > 1.96 * e$se_wd
round(c(szkoly = J, mediana_szerokosci_przedzialu = median(e$szerokosc),
        przedzial_ponad_polowe_tabeli = sum(e$szerokosc > J / 2),
        efekt_rozny_od_zera = sum(e$rozna_od_zera),
        powyzej = sum(e$rozna_od_zera & e$efekt_wd > 0), ponizej = sum(e$rozna_od_zera & e$efekt_wd < 0)), 2)
naj <- e[order(e$miejsce_wd), c("school", "miejsce_sur", "miejsce_wd", "od", "do")]
head(naj, 3)

# Rysunek: A – miejsce w tabeli surowej i w tabeli wartości dodanej; B – miejsca z 95% przedziałami
e$zmiana <- ifelse(abs(e$miejsce_sur - e$miejsce_wd) >= 10, "przesunięcie o 10+ miejsc", "mniejsze przesunięcie")
pA <- ggplot(e, aes(miejsce_sur, miejsce_wd)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey60", linetype = "22") +
  geom_point(aes(shape = zmiana, colour = zmiana), size = 2.4) +
  scale_shape_manual(values = c(`przesunięcie o 10+ miejsc` = 17, `mniejsze przesunięcie` = 16), name = NULL) +
  scale_colour_manual(values = c(`przesunięcie o 10+ miejsc` = kol[["wyrozniona"]], `mniejsze przesunięcie` = kol[["dodana"]]),
                      name = NULL) +
  scale_x_reverse() + scale_y_reverse() + coord_equal() +
  labs(title = "A. Dwie tabele ligowe", x = "Miejsce według surowych wyników", y = "Miejsce według wartości dodanej") +
  motyw + guides(shape = guide_legend(nrow = 2), colour = guide_legend(nrow = 2))
e$poz <- factor(e$school, levels = e$school[order(e$miejsce_wd)])
pB <- ggplot(e, aes(x = miejsce_wd, y = poz)) +
  geom_segment(aes(x = od, xend = do, yend = poz), colour = kol[["przedzial"]], linewidth = 0.6) +
  geom_point(aes(shape = rozna_od_zera), size = 1.9, colour = kol[["dodana"]], fill = "white") +
  scale_shape_manual(values = c(`TRUE` = 16, `FALSE` = 21), labels = c(`TRUE` = "efekt różny od 0", `FALSE` = "efekt nieodróżnialny od 0"),
                     name = NULL) +
  scale_x_continuous(breaks = c(1, 10, 20, 30, 40, 50, 60)) + scale_y_discrete(labels = NULL) +
  labs(title = "B. Miejsca z 95% przedziałami", x = "Miejsce w tabeli wartości dodanej (1 = najlepsza)", y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())
p2 <- pA + pB + plot_layout(widths = c(1, 1.05))
p2
Wynik w R
uczniowie    szkoly
     2476        65
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
   2.00   27.00   38.00   38.09   45.00  117.00
(Intercept)    standlrt
      0.113       0.526
sd_szkol_surowy     sd_szkol_wd     sd_reszt_wd
          0.402           0.310           0.720
            korelacja_rang przesuniecie_o_10_i_wiecej
                      0.89                      18.00
   najwieksze_przesuniecie
                     23.00
                       szkoly mediana_szerokosci_przedzialu
                           65                            31
przedzial_ponad_polowe_tabeli           efekt_rozny_od_zera
                           28                            25
                      powyzej                       ponizej
                           12                            13
   school miejsce_sur miejsce_wd od do
49     53           1          1  1  3
12      2           2          2  1  4
23      3           4          3  1  9
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Harvey Goldstein (1939–2020) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1939, 1964, 1972, 1977, 1986, 1987, 1993, 1996, 2005, 2020),
  opis = c("urodził się\nw Londynie", "wykładowca w Institute\nof Child Health", "National Children’s\nBureau (do 1977)",
           "profesor w Institute\nof Education", "estymacja IGLS\n(Biometrika)", "pierwsze wydanie\npodręcznika",
           "analiza wyników\nszkół londyńskich", "„League tables…”;\nczłonek British Academy",
           "przenosi się\ndo Bristolu", "zmarł"),
  rodzaj = c("życie", "praca", "praca", "praca", "publikacja", "publikacja", "publikacja", "wyróżnienie",
             "praca", "życie"),
  poziom = c(0.45, -0.45, 0.45, -1.25, 0.45, -0.45, 1.25, -1.25, 0.45, -0.45),   # wysokość etykiety
  wyrownanie = c(0.5, 0.5, 1, 0.5, 0.3, 0, 0.5, 0.5, 0.5, 0.5))                   # rozsunięcie bliskich etykiet
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.2, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1932, 2027), breaks = seq(1940, 2020, by = 10)) +
  scale_y_continuous(limits = c(-2.1, 2.1)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (modele z losowym wyrazem wolnym – funkcja lmer() z pakietu lme4, metoda REML, efekty szkół i ich błędy – ranef(condVar = TRUE); dane – pakiet jomo; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- jomo (wersja 2.7.6): Quartagno, M., & Carpenter, J. (2023). jomo: A package for multilevel joint modelling multiple imputation [R package]. https://doi.org/10.32614/CRAN.package.jomo
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Harvey Goldstein?
Brytyjskim statystykiem (1939–2020). Był wykładowcą w Institute of Child Health, od 1977 r. profesorem metod statystycznych w Institute of Education w Londynie, a od 2005 r. profesorem w Bristolu. Rozwinął modele wielopoziomowe i program MLwiN, w 1996 r. został członkiem British Academy. Zmarł w kwietniu 2020 r.
Co to jest metoda IGLS Goldsteina?
Iteracyjne uogólnione najmniejsze kwadraty – metoda estymacji modeli wielopoziomowych, którą Goldstein opisał w Biometrice w 1986 r. Na zmianę szacuje się efekty stałe i składniki wariancji; przy rozkładzie normalnym daje to samo co metoda największej wiarygodności.
Dlaczego Goldstein krytykował tabele ligowe szkół?
Bo przedziały dla efektów szkół są szerokie, a większości szkół nie da się wiarygodnie odróżnić od siebie. W przykładzie z 65 szkołami londyńskimi mediana szerokości 95% przedziału dla miejsca w tabeli wartości dodanej wyniosła 31 pozycji, a efekt 40 szkół nie różnił się od przeciętnego.
Czym różni się ranking surowy od rankingu wartości dodanej?
Ranking surowy porządkuje szkoły według samych wyników, więc w dużej mierze odzwierciedla, jakich uczniów przyjęły. Ranking wartości dodanej uwzględnia wynik na wejściu. W danych londyńskich obie tabele były podobne (korelacja rang .89), ale 18 z 65 szkół przesunęło się o co najmniej 10 miejsc.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Model mieszany w obrazkach
Strzałki od średnich szkół do modelu, kurczenie a liczebność i ICC, wachlarz losowych nachyleń i wykres gąsienicowy – pięć rysunków z kodem R.
Czytaj →PoradnikKampania miesiąca i regresja do średniej
Sieć szkół jazdy i 60 kampanii: wykres lejkowy, spadek zwycięzcy w następnym miesiącu, ściąganie w modelu mieszanym i symulacja – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Goldstein, H. (1986). Multilevel mixed linear model analysis using iterative generalized least squares. Biometrika, 73(1), 43–56. https://doi.org/10.1093/biomet/73.1.43
- Goldstein, H. (2010). Multilevel statistical models (4th ed.). Wiley. https://doi.org/10.1002/9780470973394
- Goldstein, H., & Spiegelhalter, D. J. (1996). League tables and their limitations: Statistical issues in comparisons of institutional performance. Journal of the Royal Statistical Society. Series A (Statistics in Society), 159(3), 385–443. https://doi.org/10.2307/2983325
- Goldstein, H., Rasbash, J., Yang, M., Woodhouse, G., Pan, H., Nuttall, D., & Thomas, S. (1993). A multilevel analysis of school examination results. Oxford Review of Education, 19(4), 425–433. https://doi.org/10.1080/0305498930190401
- Gray, J., Diamond, I., & Steele, F. (2020). Harvey Goldstein, 1939–2020. Biographical Memoirs of Fellows of the British Academy, 19, 357–376. https://www.thebritishacademy.ac.uk/documents/2681/19-Memoirs-16-Goldstein.pdf ● Otwarty dostęp
- Leckie, G., & Goldstein, H. (2009). The limitations of using school league tables to inform school choice. Journal of the Royal Statistical Society: Series A (Statistics in Society), 172(4), 835–851. https://doi.org/10.1111/j.1467-985x.2009.00597.x
Cytowania BibTeX
@article{goldstein1986multilevel, author={Goldstein, Harvey}, title={{Multilevel mixed linear model analysis using iterative generalized least squares}}, journal={Biometrika}, year={1986}, volume={73}, number={1}, pages={43--56}, doi={10.1093/biomet/73.1.43}}@book{goldstein2010multilevel, author={Goldstein, Harvey}, title={{Multilevel statistical models (4th ed.)}}, year={2010}, publisher={Wiley}, doi={10.1002/9780470973394}}@article{goldstein1996league, author={Goldstein, Harvey and Spiegelhalter, David J.}, title={{League tables and their limitations: Statistical issues in comparisons of institutional performance}}, journal={Journal of the Royal Statistical Society. Series A (Statistics in Society)}, year={1996}, volume={159}, number={3}, pages={385--443}, doi={10.2307/2983325}}@article{goldstein1993multilevel, author={Goldstein, Harvey and Rasbash, Jon and Yang, Min and Woodhouse, Geoffrey and Pan, Huiqi and Nuttall, Desmond and Thomas, Sally}, title={{A multilevel analysis of school examination results}}, journal={Oxford Review of Education}, year={1993}, volume={19}, number={4}, pages={425--433}, doi={10.1080/0305498930190401}}@article{gray2020harvey, author={Gray, John and Diamond, Ian and Steele, Fiona}, title={{Harvey Goldstein, 1939–2020}}, journal={Biographical Memoirs of Fellows of the British Academy}, year={2020}, volume={19}, pages={357--376}, publisher={The British Academy}, url={https://www.thebritishacademy.ac.uk/documents/2681/19-Memoirs-16-Goldstein.pdf}}@article{leckie2009limitations, author={Leckie, George and Goldstein, Harvey}, title={{The limitations of using school league tables to inform school choice}}, journal={Journal of the Royal Statistical Society: Series A (Statistics in Society)}, year={2009}, volume={172}, number={4}, pages={835--851}, doi={10.1111/j.1467-985x.2009.00597.x}}