Pięć typowych projektów w pracy z WF i nauk o sporcie
Prace z wychowania fizycznego i nauk o sporcie opierają się zwykle na testach sprawności: skoku w dal z miejsca, wyskoku pionowym, biegach na czas, testach wytrzymałości. Wyniki tych testów porównuje się między grupami, śledzi w czasie treningu albo sprawdza, czy sam test jest powtarzalny. Uzupełnieniem są ankiety o aktywności fizycznej. Tabela pokazuje pięć projektów, które omawiamy w tym poradniku.
| Projekt | Typowe pytanie | Dane | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Sprawność w grupach | Czy uczniowie klas sportowych skaczą dalej? | wynik testu, grupa, płeć | test t Welcha, ANOVA dwuczynnikowa | g Hedgesa, cząstkowe η² |
| 2. Rzetelność testu | Czy wyskok CMJ daje powtarzalny wynik? | ten sam test w dwóch sesjach | ICC, typowy błąd, CV, Bland–Altman | ICC z 95% CI, MDC95 |
| 3. Trening z pomiarami powtarzanymi | Czy program plyometryczny poprawia wyskok? | grupa × 3 pomiary | ANOVA mieszana z poprawką Greenhouse’a–Geissera, ANCOVA | η²G, różnica z 95% CI |
| 4. Ankieta aktywności fizycznej | Czy mężczyźni są bardziej aktywni niż kobiety? | minuty aktywności w tygodniu | test Manna–Whitneya, korelacja Spearmana | korelacja rangowo-dwuseryjna, ρ |
| 5. Pojedynczy zawodnik | Czy poprawa zawodnika jest większa niż błąd testu? | zmiana indywidualna | porównanie z MDC95 | odsetek zawodników powyżej progu |
Wszystkie dane są symulowane. Możesz je pobrać jako plik XLSX (arkusz dla każdego projektu i arkusz z opisem) i powtórzyć analizy w swoim programie. Część zagadnień – ból, zakres ruchu, siła mierzona dynamometrem – opisujemy też w poradniku statystyka dla fizjoterapeuty.
Zanim zaczniesz: test, protokół i jednostka analizy
Dobierz test do pytania. Currell i Jeukendrup (2008) wskazują trzy cechy dobrego testu wysiłkowego: trafność (jak wiernie odtwarza wysiłek, o który pytasz), rzetelność (jak mało zmienia się przy powtórzeniu) i czułość, czyli zdolność wykrycia małej, ale ważnej zmiany. Test, który dobrze różnicuje uczniów, nie musi wykrywać zmian po 6 tygodniach treningu.
Zapisz protokół. Rozgrzewka, liczba prób, przerwy, pora dnia, nawierzchnia, obuwie, sposób liczenia wyniku (najlepsza próba czy średnia z prób) – wszystko to wpływa na wynik. Opisz protokół tak, aby inna osoba mogła go powtórzyć, a przy testach z gotowych baterii trzymaj się podręcznika autorów i zacytuj go.
Ustal jednostkę analizy. Jeśli każdy zawodnik wykonuje trzy skoki, to nadal masz jednego zawodnika, a nie trzy obserwacje. Do analizy wprowadź jeden wynik na osobę w danym pomiarze. Podobnie przy badaniu kilku klas albo drużyn: uczniowie z jednej klasy są do siebie podobni, co wymaga uwzględnienia zagnieżdżenia (zob. model wielopoziomowy krok po kroku).
Badania z udziałem dzieci i młodzieży wymagają zgody rodziców lub opiekunów, a badania z wysiłkiem fizycznym zwykle także opinii komisji bioetycznej. Zasady sprawdź w regulaminie uczelni i u promotora przed rozpoczęciem pomiarów.
Projekt 1. Testy sprawności w grupach
Przykład: 100 uczniów szkoły podstawowej (48 z klas sportowych, 52 z klas ogólnych) wykonało skok w dal z miejsca. Uczniowie klas sportowych uzyskali średnio 178.88 cm (SD = 16.40), a klas ogólnych 162.48 cm (SD = 22.71). Odchylenia standardowe wyraźnie się różnią, dlatego porównanie wykonaj testem t Welcha, który nie zakłada równych wariancji. Delacre i in. (2017) zalecają go jako wybór domyślny: lepiej kontroluje błąd I rodzaju przy nierównych wariancjach i niewiele traci, gdy wariancje są równe. Wynik: t(92.78) = 4.16, p < .001, różnica 16.39 cm, 95% CI [8.57, 24.22], g Hedgesa = 0.82, 95% CI [0.41, 1.22].
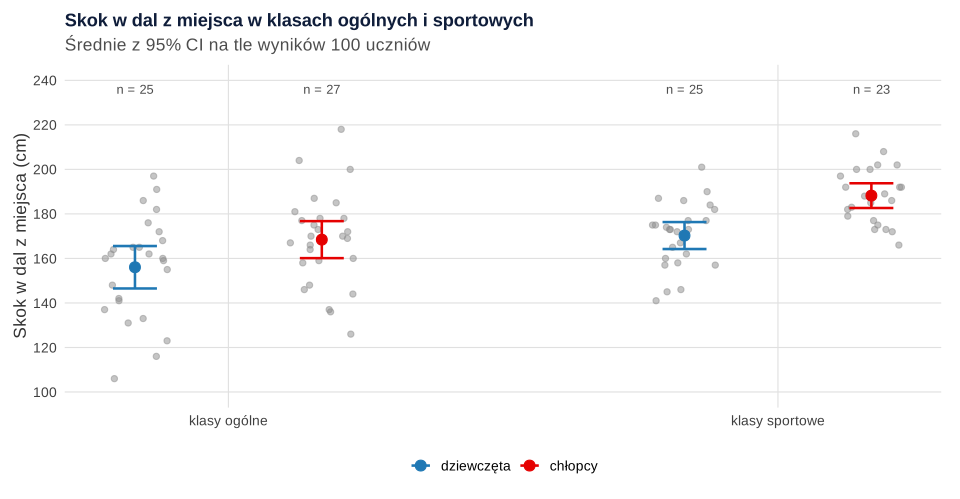
W testach sprawności prawie zawsze trzeba uwzględnić płeć, a często także wiek. Gdy masz dwa czynniki, użyj dwuczynnikowej analizy wariancji. Typ klasy miał efekt F(1, 96) = 20.91, p < .001, cząstkowe η² = .179, a płeć F(1, 96) = 16.64, p < .001, cząstkowe η² = .148. Interakcja klasa × płeć była nieistotna, F(1, 96) = 0.55, p = .459, cząstkowe η² = .006. Przewaga klas sportowych była więc podobna u dziewcząt (170.28 wobec 156.04 cm) i u chłopców (188.22 wobec 168.44 cm). Kolejne kroki ANOVA, w tym testy post hoc i tabelę APA, pokazujemy w poradniku ANOVA krok po kroku.
Pamiętaj, że uczniowie nie trafili do klas losowo. Do klas sportowych często przyjmuje się na podstawie testów sprawności, więc różnica opisuje dobór, a nie efekt szkolenia w klasie sportowej.
Projekt 2. Rzetelność testu sprawności
Zanim użyjesz testu do oceny treningu, sprawdź, jak bardzo jego wynik zmienia się bez żadnej interwencji. Przykład: 30 zawodników wykonało wyskok z zamachem rękoma i przeciwruchem (CMJ, ang. countermovement jump) w dwóch sesjach w odstępie tygodnia, po trzy próby w każdej sesji. To klasyczne badanie test–retest. Ogólne zasady planowania takiego badania, wybór formy ICC i wykres Blanda–Altmana opisujemy w poradniku badanie rzetelności pomiaru klinicznego. Tutaj skupiamy się na tym, co jest specyficzne dla testów sportowych.
Trzy składniki rzetelności
Hopkins (2000) wymienia trzy główne miary: losową zmienność wewnątrzosobniczą, systematyczną zmianę średniej między sesjami i korelację test–retest. Atkinson i Nevill (1998) dodają, że korelacja, także ICC, opisuje rzetelność względną i silnie zależy od zróżnicowania próby. Nawet ICC powyżej .90 nie przesądza więc, czy test wykryje zmianę po treningu. Dlatego obok ICC podaj miary bezwzględne w jednostkach testu.
| Miara | Najlepsza z 3 prób | Średnia z 3 prób |
|---|---|---|
| Sesja 1, M (SD), cm | 39.28 (6.61) | 38.00 (6.47) |
| Sesja 2, M (SD), cm | 39.94 (6.83) | 38.69 (6.80) |
| Zmiana średniej (sesja 2 − 1), cm | 0.65, p = .017 | 0.69, p = .005 |
| ICC(A,1) [95% CI] | .974 [.938, .988] | .978 [.939, .991] |
| ICC(C,1) [95% CI] | .978 [.954, .989] | .983 [.964, .992] |
| Typowy błąd (SEM), cm | 1.00 | 0.87 |
| CV | 2.52% | 2.27% |
| MDC95, cm | 2.77 | 2.41 |
| 95% granice zgodności, cm | [−2.11, 3.42] | [−1.73, 3.10] |
Błąd systematyczny. W drugiej sesji zawodnicy skakali średnio o 0.65 cm wyżej, 95% CI [0.13, 1.18], t(29) = 2.54, p = .017. To typowy efekt uczenia się: zawodnik poznaje test i za drugim razem wykonuje go lepiej. Weir (2005) zwraca uwagę, że formy ICC różnią się właśnie tym, czy uwzględniają taki błąd systematyczny. ICC(A,1), czyli ICC(2,1) w notacji Shrouta i Fleissa (1979), go uwzględnia, a ICC(C,1), czyli ICC(3,1) – nie. Przy test–retest podaj ICC zgodności bezwzględnej (A,1), bo interesuje Cię, czy zawodnik uzyska ten sam wynik. Koo i Li (2016) wymagają, aby w raporcie podać model, typ i definicję ICC oraz interpretować wynik na podstawie 95% CI. W praktyce oznacza to też sesję zapoznawczą przed właściwymi pomiarami.
Typowy błąd i CV. Typowy błąd pomiaru to odchylenie standardowe różnic podzielone przez √2, czyli standardowy błąd pomiaru w jednostkach testu. Dla najlepszej próby wyniósł 1.00 cm. Hopkins (2000) zaleca wyrażać go często jako współczynnik zmienności, czyli procent średniej: tu 2.52%. Taka miara pozwala porównać rzetelność testów o różnych jednostkach i dobrze pasuje do wyników sportowych, w których błąd rośnie zwykle z poziomem wyniku. W przykładzie różnica nie zależała wyraźnie od poziomu wyskoku (r = .16, p = .405), więc wykres Blanda–Altmana nie wymagał transformacji.
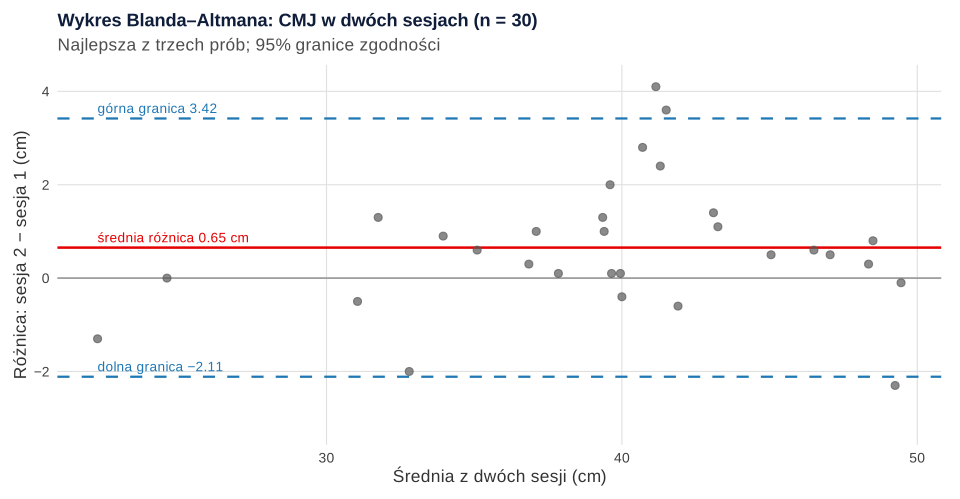
Granice zgodności. Bland i Altman (1986) pokazali, że korelacja dwóch serii pomiarów wprowadza w błąd przy ocenie zgodności. Na wykresie widać, że przy powtórzeniu testu wynik zawodnika może się różnić od −2.11 do 3.42 cm, choć korelacja sesji wynosiła .978. Szczegóły interpretacji opisujemy w haśle metoda Blanda–Altmana.
Najlepsza czy średnia z prób? W przykładzie średnia z trzech prób miała mniejszy typowy błąd (0.87 wobec 1.00 cm) niż najlepsza próba. Wybierz sposób liczenia wyniku przed badaniem i trzymaj się go we wszystkich pomiarach. Sam wybór opisz w metodzie.
Ile osób. Hopkins (2000) ocenia, że rozsądnie precyzyjne oszacowanie rzetelności wymaga około 50 uczestników i co najmniej 3 pomiarów. Nasz przykład z 30 zawodnikami i 2 sesjami jest więc skromny, co widać po szerokości przedziałów ufności. Walter i in. (1998) podają sposób liczenia próby dla badania ICC i pokazują, że przy rzetelności .40 lub wyższej dwa albo trzy pomiary na osobę minimalizują łączną liczbę pomiarów.
Projekt 3. Trening z pomiarami powtarzanymi
Przykład: 40 zawodników podzielono losowo na grupę treningową (8 tygodni treningu plyometrycznego) i kontrolną (dotychczasowy trening). CMJ zmierzono w tygodniu 0, 4 i 8. To schemat z czynnikiem międzyobiektowym (grupa) i wewnątrzobiektowym (czas). Pytanie badawcze dotyczy interakcji grupa × czas: czy wynik zmieniał się inaczej w obu grupach?
ANOVA mieszana i sferyczność
Klasyczną analizą jest ANOVA z powtarzanymi pomiarami z czynnikiem grupy. Przy trzech i więcej pomiarach obowiązuje założenie sferyczności. Blanca i in. (2023) w symulacji pokazali, że nieskorygowany test F staje się tym bardziej liberalny, im silniej sferyczność jest naruszona, i zalecają domyślnie poprawkę Greenhouse’a–Geissera, bez polegania na wstępnym teście Mauchly’ego. W przykładzie test Mauchly’ego dał W = .852, p = .052, a ε Greenhouse’a–Geissera = .87.
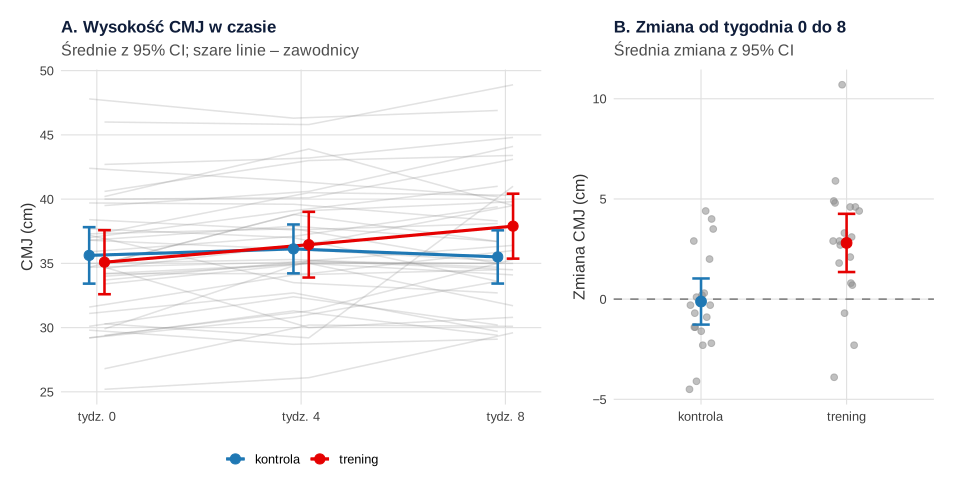
Interakcja grupa × czas była istotna, F(1.74, 66.20) = 7.27, p = .002, η²G = .016. Efekt czasu: F(1.74, 66.20) = 6.10, p = .005, η²G = .014, a grupy: F(1, 38) = 0.24, p = .626. Jako wielkość efektu podaj uogólnione eta kwadrat (η²G). Bakeman (2005) zaleca je dla schematów z pomiarami powtarzanymi, bo w odróżnieniu od cząstkowego η² pozwala porównywać efekty między schematami. Wartość .016 wydaje się mała, bo η²G zostawia w mianowniku dużą zmienność między zawodnikami. Dlatego obok niej podaj efekt w centymetrach: w grupie treningowej CMJ wzrósł od tygodnia 0 do 8 o 2.81 cm, 95% CI [1.54, 4.07], a w kontrolnej zmienił się o −0.12 cm, 95% CI [−1.39, 1.15].
Dlaczego porównanie w tygodniu 8 jest za słabe
W tygodniu 8 grupa treningowa skakała wyżej o 2.40 cm, ale różnica była nieistotna: 95% CI [−0.77, 5.56], p = .133. Przyczyną jest duże zróżnicowanie zawodników, które widać na rysunku 3A. ANCOVA wyniku z tygodnia 8 z pomiarem wyjściowym jako kowariantem usuwa tę zmienność: skorygowana różnica wyniosła 2.83 cm, 95% CI [1.10, 4.57], p = .002. W badaniach z randomizacją ANCOVA i analiza zmian są nieobciążone, ale ANCOVA ma większą moc (Van Breukelen, 2006). Porównanie strategii opisujemy w poradniku ANCOVA w badaniu przed i po, a ANOVA z powtarzanymi pomiarami krok po kroku – w poradniku ANOVA z powtarzanymi pomiarami krok po kroku. Jeśli masz braki danych albo nierówne odstępy między pomiarami, zajrzyj do porównania ANOVA z powtarzanymi pomiarami czy model mieszany.
Ile zawodników potrzeba
Odchylenie standardowe zmian od tygodnia 0 do 8 wyniosło w próbie 3.14 cm. Przy takiej zmienności wykrycie różnicy zmian o 2 cm z mocą .80 i α = .05 wymaga około 40 zawodników w każdej grupie (z obliczeń wychodzi 39.57). Nasze badanie z 20 osobami w grupie miało więc za mało mocy dla tak małego efektu. Liczbę osób dla swoich założeń sprawdzisz w kalkulatorze liczebności próby.
Projekt 4. Ankieta aktywności fizycznej
Kwestionariusze aktywności fizycznej mają własne zasady przeliczania odpowiedzi na minuty albo wydatek energetyczny, czyszczenia nierealnych wartości i tworzenia kategorii aktywności. Stosuj je dokładnie według publikacji lub podręcznika autorów narzędzia i zacytuj to źródło. Nie wymyślaj własnych progów „niskiej” i „wysokiej” aktywności.
Przykład: 200 studentów, wynik w minutach aktywności umiarkowanej i intensywnej w tygodniu. Rozkład jest silnie prawoskośny (skośność = 1.46): średnia 252.85 min (SD = 209.80) jest wyraźnie wyższa od mediany 200 min (Q1–Q3: 100–330). Opisuj więc medianę i kwartyle, a grupy porównuj testem rangowym. Mężczyźni (n = 94, Me = 235 min, Q1–Q3: 122.5–420) deklarowali więcej aktywności niż kobiety (n = 106, Me = 160 min, Q1–Q3: 90–295), test Manna–Whitneya: W = 3922, p = .009, korelacja rangowo-dwuseryjna r = .21, 95% CI [.06, .36]. Związek aktywności z BMI był słaby i nieistotny: ρ Spearmana = −.12, p = .083. Pamiętaj, że to deklaracje, a nie pomiar akcelerometrem, i że badanie przekrojowe nie wskazuje kierunku zależności. Testy rangowe szczegółowo omawiamy w poradniku testy nieparametryczne krok po kroku.
Projekt 5. Czy poprawa zawodnika jest prawdziwa?
Trener pyta zwykle nie o średnią grupy, ale o konkretnego zawodnika: czy jego wynik naprawdę się poprawił? Do odpowiedzi potrzebujesz błędu pomiaru z projektu 2. Minimalna wykrywalna zmiana MDC95 wynosiła 2.77 cm. Zmianę mniejszą niż ta wartość trudno odróżnić od błędu pomiaru. W grupie treningowej z projektu 3 próg przekroczyło 12 z 20 zawodników, a w grupie kontrolnej 4 z 20. Ten drugi wynik jest ważną przestrogą: w kontrolnej zmiana wynikała tylko z wahań wyniku, większych niż w badaniu rzetelności. MDC pochodzi z określonej próby i protokołu, więc najlepiej wyznacz go w tych samych warunkach, w których mierzysz zawodników. Pokrewny wskaźnik wiarygodnej zmiany i oba progi policzysz w kalkulatorze RCI i MDC, a ich teorię opisujemy w poradniku RCI, MDC i MCID.
W literaturze z nauk o sporcie spotkasz też wnioskowanie oparte na wielkości efektu (ang. magnitude-based inference, MBI), z określeniami typu „prawdopodobnie korzystny efekt”. Nie używaj tej metody w pracy. Sainani (2018) wykazała w reanalizie symulacji jej autorów, że przy małych i umiarkowanych próbach MBI zawyża błąd I rodzaju dwu- do sześciokrotnie w porównaniu ze standardowym testowaniem hipotez, i konkluduje, że MBI nie powinno być stosowane. Zamiast tego podaj efekt w jednostkach testu z 95% CI i porównaj go z ustaloną z góry najmniejszą zmianą, która ma dla Ciebie znaczenie praktyczne.
Jak opisać analizę statystyczną w pracy
W metodzie opisz protokół testów (rozgrzewka, liczba prób, sposób liczenia wyniku), sposób podziału na grupy, liczbę osób, które ukończyły program, i analizy. Wzór akapitu dla projektów 2 i 3:
Jeśli chcesz, aby ktoś sprawdził plan analiz albo pomógł zinterpretować wyniki przed rozmową z promotorem, zajrzyj do oferty analizy statystyczne dla studentów. Pamiętaj, że wyniki musisz rozumieć i umieć obronić samodzielnie.
Analizy z pięciu projektów w R
Kod odtwarza wszystkie liczby z tego wpisu, a ostatni przepis – rysunki i plik XLSX do pobrania. Każdy przepis tworzy własne dane symulowane, więc możesz go uruchomić osobno. Najważniejszy jest przepis 2 z pełną analizą rzetelności testu CMJ. ICC liczy pakiet psych, ANOVA mieszaną – pakiet afex, a porównania średnich – pakiet emmeans.
1. Projekt 1: skok w dal – test t Welcha, g Hedgesa i ANOVA 2 × 2
R
# Projekt 1: test sprawności w dwóch typach klas i u obu płci (dane symulowane).
# 100 uczniów szkoły podstawowej (klasy sportowe i ogólne), skok w dal z miejsca (cm).
suppressPackageStartupMessages({ library(effectsize); library(afex) })
set.seed(7201)
klasa <- factor(c(rep("sportowa", 48), rep("ogólna", 52)), levels = c("ogólna", "sportowa"))
plec <- factor(sample(rep(c("dziewczęta", "chłopcy"), 50)), levels = c("dziewczęta", "chłopcy"))
skok <- round(158 + 14 * (klasa == "sportowa") + 11 * (plec == "chłopcy") + 4 * (klasa == "sportowa") * (plec == "chłopcy") +
              rnorm(100, 0, ifelse(klasa == "sportowa", 15, 20)))
p1 <- data.frame(id = factor(1:100), klasa, plec, skok)
aggregate(skok ~ klasa, p1, function(x) round(c(n = length(x), M = mean(x), SD = sd(x)), 2))
aggregate(skok ~ klasa + plec, p1, function(x) round(c(n = length(x), M = mean(x), SD = sd(x)), 2))
t.test(skok ~ klasa, data = p1)
hedges_g(skok ~ klasa, data = p1, pooled_sd = FALSE)
# ANOVA 2 × 2 (klasa × płeć), typ III, z cząstkowym η²
a <- aov_ez("id", "skok", p1, between = c("klasa", "plec"), anova_table = list(es = "pes"))
nice(a)
Wynik w R
     klasa skok.n skok.M skok.SD
1   ogólna  52.00 162.48   22.71
2 sportowa  48.00 178.88   16.40
     klasa       plec skok.n skok.M skok.SD
1   ogólna dziewczęta  25.00 156.04   23.10
2 sportowa dziewczęta  25.00 170.28   14.66
3   ogólna    chłopcy  27.00 168.44   21.02
4 sportowa    chłopcy  23.00 188.22   12.84

	Welch Two Sample t-test

data:  skok by klasa
t = -4.1614, df = 92.78, p-value = 7.063e-05
alternative hypothesis: true difference in means between group ogólna and group sportowa is not equal to 0
95 percent confidence interval:
 -24.217673  -8.570789
sample estimates:
  mean in group ogólna mean in group sportowa
              162.4808               178.8750

Hedges' g |         95% CI
--------------------------
-0.82     | [-1.22, -0.41]

- Estimated using un-pooled SD.Contrasts set to contr.sum for the following variables: klasa, plec
Anova Table (Type 3 tests)

Response: skok
      Effect    df    MSE         F  pes p.value
1      klasa 1, 96 344.67 20.91 *** .179   <.001
2       plec 1, 96 344.67 16.64 *** .148   <.001
3 klasa:plec 1, 96 344.67      0.55 .006    .459
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘+’ 0.1 ‘ ’ 1
2. Projekt 2: pełna analiza rzetelności testu CMJ
R
# Projekt 2: rzetelność testu wyskoku CMJ (test–retest) – 30 zawodników, dwie sesje co tydzień,
# w każdej sesji 3 próby; wysokość wyskoku w cm (dane symulowane).
suppressPackageStartupMessages(library(psych))
set.seed(7202)
n <- 30
prawdziwa <- rnorm(n, 38, 5.5)                         # „prawdziwa” wysokość wyskoku zawodnika
proby <- function(przes) sapply(1:3, function(k) round(prawdziwa + przes + rnorm(n, 0, 1.3) + rnorm(n, 0, 0.8), 1))
s1 <- proby(0); s2 <- proby(0.6)                       # w 2. sesji mały efekt uczenia się
colnames(s1) <- paste0("s1_p", 1:3); colnames(s2) <- paste0("s2_p", 1:3)
p2 <- data.frame(id = 1:n, s1, s2)
p2$s1_max <- apply(s1, 1, max); p2$s2_max <- apply(s2, 1, max)
p2$s1_sr <- rowMeans(s1);       p2$s2_sr <- rowMeans(s2)

rzetelnosc <- function(a, b) {
  r <- b - a; te <- sd(r) / sqrt(2)                    # typowy błąd (SEM z różnic)
  ic <- psych::ICC(cbind(a, b), lmer = FALSE)$results
  c(M1 = mean(a), SD1 = sd(a), M2 = mean(b), SD2 = sd(b), bias = mean(r), SD_r = sd(r),
    LoA_lo = mean(r) - 1.96 * sd(r), LoA_hi = mean(r) + 1.96 * sd(r),
    TE = te, CV_proc = 100 * te / mean(c(a, b)), MDC95 = 1.96 * sqrt(2) * te,
    ICC_A1 = ic$ICC[2], A1_lo = ic$`lower bound`[2], A1_hi = ic$`upper bound`[2],
    ICC_C1 = ic$ICC[3], C1_lo = ic$`lower bound`[3], C1_hi = ic$`upper bound`[3],
    r_pearson = cor(a, b), p_bias = t.test(b, a, paired = TRUE)$p.value)
}
round(rbind(najlepsza_z_3 = rzetelnosc(p2$s1_max, p2$s2_max), srednia_z_3 = rzetelnosc(p2$s1_sr, p2$s2_sr)), 3)
t.test(p2$s2_max, p2$s1_max, paired = TRUE)
# Pełny wydruk psych::ICC dla najlepszej próby
psych::ICC(p2[, c("s1_max", "s2_max")], lmer = FALSE)$results[, c("type", "ICC", "F", "df1", "df2", "p", "lower bound", "upper bound")]
# Czy różnica zależy od poziomu wyskoku? (heteroskedastyczność na wykresie Blanda–Altmana)
cor.test(rowMeans(p2[, c("s1_max", "s2_max")]), p2$s2_max - p2$s1_max)
Wynik w R
                  M1   SD1     M2   SD2  bias  SD_r LoA_lo LoA_hi    TE CV_proc MDC95 ICC_A1 A1_lo A1_hi
najlepsza_z_3 39.283 6.611 39.937 6.832 0.653 1.411 -2.113  3.419 0.998   2.519 2.766  0.974 0.938 0.988
srednia_z_3   38.002 6.471 38.688 6.795 0.686 1.230 -1.725  3.096 0.870   2.268 2.411  0.978 0.939 0.991
              ICC_C1 C1_lo C1_hi r_pearson p_bias
najlepsza_z_3  0.978 0.954 0.989     0.978  0.017
srednia_z_3    0.983 0.964 0.992     0.984  0.005

	Paired t-test

data:  p2$s2_max and p2$s1_max
t = 2.5357, df = 29, p-value = 0.01687
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 0.1263753 1.1802913
sample estimates:
mean difference
      0.6533333

                         type       ICC        F df1 df2            p lower bound upper bound
Single_raters_absolute   ICC1 0.9740294 76.01026  29  30 3.792775e-21   0.9466620   0.9875029
Single_random_raters     ICC2 0.9740810 89.76778  29  29 1.396708e-21   0.9378374   0.9883856
Single_fixed_raters      ICC3 0.9779657 89.76778  29  29 1.396708e-21   0.9542609   0.9894516
Average_raters_absolute ICC1k 0.9868439 76.01026  29  30 3.792775e-21   0.9726003   0.9937122
Average_random_raters   ICC2k 0.9868704 89.76778  29  29 1.396708e-21   0.9679216   0.9941589
Average_fixed_raters    ICC3k 0.9888601 89.76778  29  29 1.396708e-21   0.9765952   0.9946978

	Pearson's product-moment correlation

data:  rowMeans(p2[, c("s1_max", "s2_max")]) and p2$s2_max - p2$s1_max
t = 0.84499, df = 28, p-value = 0.4053
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 -0.2147815  0.4901150
sample estimates:
      cor
0.1576896
3. Projekt 3 i 5: trening z pomiarami powtarzanymi, ANCOVA, moc i zawodnicy powyżej MDC
R
# Projekt 3: 8-tygodniowy trening plyometryczny – grupa treningowa i kontrolna, CMJ (cm) w tygodniu 0, 4 i 8 (dane symulowane).
suppressPackageStartupMessages({ library(afex); library(emmeans) })
set.seed(7203)
n <- 20
grupa <- factor(rep(c("trening", "kontrola"), each = n), levels = c("kontrola", "trening"))
os <- rnorm(2 * n, 0, 5)
wzrost <- ifelse(grupa == "trening", 1, 0)
cmj0 <- round(36 + os + rnorm(2 * n, 0, 1.5), 1)
cmj4 <- round(36 + os + 1.4 * wzrost + 0.3 + rnorm(2 * n, 0, 1.6 + 0.4 * wzrost), 1)
cmj8 <- round(36 + os + 2.9 * wzrost + 0.4 + rnorm(2 * n, 0, 1.6 + 0.9 * wzrost), 1)
p3 <- data.frame(id = factor(1:(2 * n)), grupa, cmj0, cmj4, cmj8)
dl <- reshape(p3, direction = "long", varying = c("cmj0", "cmj4", "cmj8"), v.names = "cmj", timevar = "tydzien",
              times = c("0", "4", "8"), idvar = "id")
dl$tydzien <- factor(dl$tydzien, levels = c("0", "4", "8"))
aggregate(cmj ~ grupa + tydzien, dl, function(x) round(c(M = mean(x), SD = sd(x)), 2))
a <- aov_ez("id", "cmj", dl, between = "grupa", within = "tydzien", anova_table = list(es = "ges", correction = "GG"))
nice(a)
summary(a)$sphericity.tests
summary(a)$pval.adjustments
# Porównanie grup w każdym tygodniu i zmiany w czasie w każdej grupie
em <- emmeans(a, ~ grupa | tydzien)
pairs(em, reverse = TRUE)
confint(pairs(em, reverse = TRUE))
em2 <- emmeans(a, ~ tydzien | grupa)
confint(contrast(em2, list(`8 vs 0` = c(-1, 0, 1))))
# ANCOVA: wynik w tygodniu 8 skorygowany o pomiar wyjściowy
m <- lm(cmj8 ~ cmj0 + grupa, data = p3); round(cbind(b = coef(m), confint(m), p = summary(m)$coefficients[, 4]), 3)
# Liczebność do wykrycia różnicy zmian 2 cm (SD zmian jak w tej próbie), moc .80, α = .05
sd_zm <- sd(p3$cmj8 - p3$cmj0); round(sd_zm, 2)
power.t.test(delta = 2, sd = sd_zm, power = .80)
# Ilu zawodników poprawiło CMJ o więcej niż MDC95 = 2.77 cm z projektu 2 (najlepsza z trzech prób)?
table(p3$grupa, poprawa_ponad_MDC = (p3$cmj8 - p3$cmj0) > 2.77)
Wynik w R
     grupa tydzien cmj.M cmj.SD
1 kontrola       0 35.62   4.69
2  trening       0 35.09   5.33
3 kontrola       4 36.12   4.07
4  trening       4 36.45   5.46
5 kontrola       8 35.50   4.43
6  trening       8 37.89   5.40
Contrasts set to contr.sum for the following variables: grupa
Anova Table (Type 3 tests)

Response: cmj
         Effect          df   MSE       F  ges p.value
1         grupa       1, 38 66.54    0.24 .006    .626
2       tydzien 1.74, 66.20  3.57 6.10 ** .014    .005
3 grupa:tydzien 1.74, 66.20  3.57 7.27 ** .016    .002
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘+’ 0.1 ‘ ’ 1

Sphericity correction method: GG
              Test statistic  p-value
tydzien                0.852 0.051662
grupa:tydzien          0.852 0.051662
                 GG eps  Pr(>F[GG])    HF eps  Pr(>F[HF])
tydzien       0.8710832 0.005332227 0.9093826 0.004702713
grupa:tydzien 0.8710832 0.002197973 0.9093826 0.001874756
attr(,"na.action")
(Intercept)       grupa
          1           2
attr(,"class")
[1] "omit"
tydzien = X0:
 contrast           estimate   SE df t.ratio p.value
 trening - kontrola    -0.53 1.59 38  -0.334  0.7403

tydzien = X4:
 contrast           estimate   SE df t.ratio p.value
 trening - kontrola     0.33 1.52 38   0.217  0.8296

tydzien = X8:
 contrast           estimate   SE df t.ratio p.value
 trening - kontrola     2.40 1.56 38   1.534  0.1333

tydzien = X0:
 contrast           estimate   SE df lower.CL upper.CL
 trening - kontrola    -0.53 1.59 38   -3.744     2.68

tydzien = X4:
 contrast           estimate   SE df lower.CL upper.CL
 trening - kontrola     0.33 1.52 38   -2.752     3.41

tydzien = X8:
 contrast           estimate   SE df lower.CL upper.CL
 trening - kontrola     2.40 1.56 38   -0.766     5.56

Confidence level used: 0.95
grupa = kontrola:
 contrast estimate    SE df lower.CL upper.CL
 8 vs 0      -0.12 0.626 38    -1.39     1.15

grupa = trening:
 contrast estimate    SE df lower.CL upper.CL
 8 vs 0       2.81 0.626 38     1.54     4.07

Confidence level used: 0.95
                 b  2.5 % 97.5 %     p
(Intercept)  6.004 -0.409 12.418 0.066
cmj0         0.828  0.651  1.005 0.000
grupatrening 2.834  1.102  4.566 0.002
[1] 3.14

     Two-sample t test power calculation

              n = 39.57176
          delta = 2
             sd = 3.135724
      sig.level = 0.05
          power = 0.8
    alternative = two.sided

NOTE: n is number in *each* group

          poprawa_ponad_MDC
           FALSE TRUE
  kontrola    16    4
  trening      8   12
4. Projekt 4: ankieta aktywności fizycznej
R
# Projekt 4: ankieta aktywności fizycznej studentów – minuty aktywności umiarkowanej i intensywnej
# w tygodniu (wynik przeliczony według zasad narzędzia), płeć i BMI (dane symulowane, N = 200).
suppressPackageStartupMessages(library(effectsize))
set.seed(7204)
n <- 200
plec <- factor(sample(c("kobiety", "mężczyźni"), n, TRUE, prob = c(.55, .45)), levels = c("kobiety", "mężczyźni"))
mvpa <- round(rgamma(n, shape = 1.6, scale = ifelse(plec == "mężczyźni", 190, 140)) / 10) * 10
bmi <- round(23.2 + 1.2 * (plec == "mężczyźni") - 0.004 * (mvpa - 250) + rnorm(n, 0, 3), 1)
p4 <- data.frame(id = 1:n, plec, mvpa, bmi)
round(c(M = mean(p4$mvpa), SD = sd(p4$mvpa), Me = median(p4$mvpa), Q1 = unname(quantile(p4$mvpa, .25)),
        Q3 = unname(quantile(p4$mvpa, .75)), skosnosc = psych::skew(p4$mvpa), zero = sum(p4$mvpa == 0)), 2)
aggregate(mvpa ~ plec, p4, function(x) c(n = length(x), Me = median(x), Q1 = unname(quantile(x, .25)), Q3 = unname(quantile(x, .75))))
suppressWarnings(wilcox.test(mvpa ~ plec, data = p4, exact = FALSE))
rank_biserial(mvpa ~ plec, data = p4)
cor.test(p4$mvpa, p4$bmi, method = "spearman", exact = FALSE)
Wynik w R
       M       SD       Me       Q1       Q3 skosnosc     zero
  252.85   209.80   200.00   100.00   330.00     1.46     0.00
       plec mvpa.n mvpa.Me mvpa.Q1 mvpa.Q3
1   kobiety  106.0   160.0    90.0   295.0
2 mężczyźni   94.0   235.0   122.5   420.0

	Wilcoxon rank sum test with continuity correction

data:  mvpa by plec
W = 3922, p-value = 0.009477
alternative hypothesis: true location shift is not equal to 0

r (rank biserial) |         95% CI
----------------------------------
-0.21             | [-0.36, -0.06]

	Spearman's rank correlation rho

data:  p4$mvpa and p4$bmi
S = 1497112, p-value = 0.08306
alternative hypothesis: true rho is not equal to 0
sample estimates:
       rho
-0.1228624
5. Rysunki i plik XLSX
R
# Rysunki i plik XLSX do wpisu (uruchom z folderu kod/): LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b72-rysunki.R > b72-rysunki-wynik.txt
library(ggplot2)
theme_metodolog <- function(base_size = 12) theme_minimal(base_size = base_size)
zapisz_svg <- function(p, plik, szer = 10, wys = 5) ggsave(plik, p, width = szer, height = wys)
suppressPackageStartupMessages({ library(patchwork); library(openxlsx) })
pdf(NULL)
invisible(capture.output({ for (f in c("b72-1-grupy-sprawnosc.R", "b72-2-rzetelnosc-cmj.R", "b72-3-trening-pomiary.R", "b72-4-aktywnosc-ankieta.R")) source(f) }))
minus <- function(x) gsub("-", "−", x)
ci_m <- function(x) { n <- length(x); h <- qt(.975, n - 1) * sd(x) / sqrt(n); c(M = mean(x), lo = mean(x) - h, hi = mean(x) + h, n = n) }

# Rysunek 1: skok w dal z miejsca według klasy i płci
s1 <- do.call(rbind, lapply(split(p1, list(p1$klasa, p1$plec)), function(d) data.frame(klasa = d$klasa[1], plec = d$plec[1], t(ci_m(d$skok)))))
print(s1, digits = 4, row.names = FALSE)
set.seed(5); p1$xj <- as.integer(p1$klasa) + ifelse(p1$plec == "chłopcy", .17, -.17) + runif(100, -.06, .06)
s1$x <- as.integer(s1$klasa) + ifelse(s1$plec == "chłopcy", .17, -.17)
r1 <- ggplot() + geom_point(data = p1, aes(xj, skok), colour = KOLORY[["dane"]], alpha = .5, size = 1.8) +
  geom_errorbar(data = s1, aes(x = x, ymin = lo, ymax = hi, colour = plec), width = .08, linewidth = .9) +
  geom_point(data = s1, aes(x = x, y = M, colour = plec), size = 3.4) +
  geom_text(data = s1, aes(x = x, y = 236, label = paste0("n = ", n)), size = 3.4, colour = "grey30") +
  scale_colour_manual(values = c(dziewczęta = KOLORY[["drugi"]], chłopcy = KOLORY[["akcent"]]), name = NULL) +
  scale_x_continuous(breaks = 1:2, labels = c("klasy ogólne", "klasy sportowe")) +
  scale_y_continuous(limits = c(100, 240), breaks = seq(100, 240, 20)) +
  labs(title = "Skok w dal z miejsca w klasach ogólnych i sportowych", subtitle = "Średnie z 95% CI na tle wyników 100 uczniów",
       x = NULL, y = "Skok w dal z miejsca (cm)") + theme_metodolog(13)
zapisz_svg(r1, "../statystyka-sport-skok-w-dal-grupy.svg", szer = 10, wys = 5.2)

# Rysunek 2: wykres Blanda–Altmana dla CMJ (najlepsza z trzech prób, sesja 2 − sesja 1)
ba <- data.frame(sr = (p2$s1_max + p2$s2_max) / 2, r = p2$s2_max - p2$s1_max)
b <- mean(ba$r); lo <- b - 1.96 * sd(ba$r); hi <- b + 1.96 * sd(ba$r); print(round(c(bias = b, lo = lo, hi = hi), 2))
r2 <- ggplot(ba, aes(sr, r)) + geom_hline(yintercept = 0, colour = "grey60") +
  geom_hline(yintercept = b, colour = KOLORY[["akcent"]], linewidth = .9) +
  geom_hline(yintercept = c(lo, hi), colour = KOLORY[["drugi"]], linetype = 2, linewidth = .8) +
  geom_point(colour = "grey35", alpha = .7, size = 2.4) +
  annotate("text", x = min(ba$sr), y = c(b, lo, hi) + .22, hjust = 0, size = 3.6,
           label = minus(c(sprintf("średnia różnica %.2f cm", b), sprintf("dolna granica %.2f", lo), sprintf("górna granica %.2f", hi))),
           colour = c(KOLORY[["akcent"]], KOLORY[["drugi"]], KOLORY[["drugi"]])) +
  scale_y_continuous(limits = c(-3.2, 4.2), labels = minus) +
  labs(title = "Wykres Blanda–Altmana: CMJ w dwóch sesjach (n = 30)", subtitle = "Najlepsza z trzech prób; 95% granice zgodności",
       x = "Średnia z dwóch sesji (cm)", y = "Różnica: sesja 2 − sesja 1 (cm)") + theme_metodolog(13)
zapisz_svg(r2, "../statystyka-sport-bland-altman-cmj.svg", szer = 10, wys = 5.2)

# Rysunek 3: CMJ w tygodniach 0, 4 i 8 w grupie treningowej i kontrolnej
s3 <- do.call(rbind, lapply(split(dl, list(dl$grupa, dl$tydzien)), function(d) data.frame(grupa = d$grupa[1], tydzien = d$tydzien[1], t(ci_m(d$cmj)))))
s3$x <- as.numeric(as.character(s3$tydzien)) + ifelse(s3$grupa == "trening", .15, -.15); print(s3, digits = 4, row.names = FALSE)
dl$x <- as.numeric(as.character(dl$tydzien)) + ifelse(dl$grupa == "trening", .15, -.15)
r3a <- ggplot() + geom_line(data = dl, aes(x, cmj, group = id), colour = KOLORY[["dane"]], alpha = .25) +
  geom_line(data = s3, aes(x, M, colour = grupa), linewidth = 1.1) +
  geom_errorbar(data = s3, aes(x = x, ymin = lo, ymax = hi, colour = grupa), width = .25, linewidth = .9) +
  geom_point(data = s3, aes(x, M, colour = grupa), size = 3.2) +
  scale_colour_manual(values = c(kontrola = KOLORY[["drugi"]], trening = KOLORY[["akcent"]]), name = NULL) +
  scale_x_continuous(breaks = c(0, 4, 8), labels = paste("tydz.", c(0, 4, 8))) +
  labs(title = "A. Wysokość CMJ w czasie", subtitle = "Średnie z 95% CI; szare linie – zawodnicy", x = NULL, y = "CMJ (cm)") + theme_metodolog(12)
zm <- data.frame(grupa = p3$grupa, zm = p3$cmj8 - p3$cmj0)
s4 <- do.call(rbind, lapply(split(zm, zm$grupa), function(d) data.frame(grupa = d$grupa[1], t(ci_m(d$zm))))); print(s4, digits = 3, row.names = FALSE)
set.seed(6)
r3b <- ggplot(zm, aes(grupa, zm)) + geom_hline(yintercept = 0, linetype = 2, colour = "grey50") +
  geom_jitter(width = .1, height = 0, colour = KOLORY[["dane"]], alpha = .55, size = 2) +
  geom_errorbar(data = s4, aes(x = grupa, ymin = lo, ymax = hi, colour = grupa), inherit.aes = FALSE, width = .12, linewidth = .9) +
  geom_point(data = s4, aes(x = grupa, y = M, colour = grupa), inherit.aes = FALSE, size = 3.4) +
  scale_colour_manual(values = c(kontrola = KOLORY[["drugi"]], trening = KOLORY[["akcent"]]), guide = "none") +
  scale_y_continuous(labels = minus) +
  labs(title = "B. Zmiana od tygodnia 0 do 8", subtitle = "Średnia zmiana z 95% CI", x = NULL, y = "Zmiana CMJ (cm)") + theme_metodolog(12)
zapisz_svg(r3a + r3b + plot_layout(widths = c(1.5, 1)), "../statystyka-sport-trening-pomiary-powtarzane.svg", szer = 10, wys = 5.2)

# Plik XLSX z danymi do pobrania
wb <- createWorkbook(creator = "Metodolog.pl", title = "Statystyka w pracy z wychowania fizycznego i sportu – dane przykładowe")
setLastModifiedBy(wb, "Metodolog.pl")
opis <- data.frame(arkusz = c("P1_skok_w_dal", "P2_rzetelnosc_CMJ", "P3_trening", "P4_aktywnosc"),
  zawartosc = c("100 uczniów: typ klasy, płeć, skok w dal z miejsca (cm)",
                "30 zawodników: CMJ (cm), 3 próby w sesji 1 i 3 próby w sesji 2, najlepsza i średnia z prób",
                "40 zawodników: grupa (trening/kontrola), CMJ (cm) w tygodniu 0, 4 i 8 (format szeroki)",
                "200 studentów: płeć, minuty aktywności umiarkowanej i intensywnej w tygodniu, BMI"),
  uwaga = "Dane symulowane do nauki analizy; nie pochodzą z prawdziwego badania.")
for (ark in list(list("Opis", opis), list("P1_skok_w_dal", p1[, c("id", "klasa", "plec", "skok")]), list("P2_rzetelnosc_CMJ", p2),
                 list("P3_trening", p3), list("P4_aktywnosc", p4))) {
  addWorksheet(wb, ark[[1]]); writeData(wb, ark[[1]], ark[[2]]); setColWidths(wb, ark[[1]], 1:ncol(ark[[2]]), "auto") }
PL <- "../statystyka-sport-dane-przyklad.xlsx"
saveWorkbook(wb, PL, overwrite = TRUE)
sapply(getSheetNames(PL), function(s) nrow(read.xlsx(PL, s)))
tmp <- tempfile(); unzip(PL, exdir = tmp)
core <- paste(readLines(file.path(tmp, "docProps", "core.xml"), warn = FALSE, encoding = "UTF-8"), collapse = "")
cat("creator:", sub(".*<dc:creator>(.*?)</dc:creator>.*", "\\1", core), "| lastModifiedBy:",
    sub(".*<cp:lastModifiedBy>(.*?)</cp:lastModifiedBy>.*", "\\1", core), "\n")
cat("rozmiar KB:", round(file.info(PL)$size / 1024), "\n")
Wynik w R
Contrasts set to contr.sum for the following variables: klasa, plec
Contrasts set to contr.sum for the following variables: grupa
    klasa       plec     M    lo    hi  n
   ogólna dziewczęta 156.0 146.5 165.6 25
 sportowa dziewczęta 170.3 164.2 176.3 25
   ogólna    chłopcy 168.4 160.1 176.8 27
 sportowa    chłopcy 188.2 182.7 193.8 23
Zapisano ../statystyka-sport-skok-w-dal-grupy.svg: w HTML width="1000" height="520" (22 KB)
 bias    lo    hi
 0.65 -2.11  3.42
Zapisano ../statystyka-sport-bland-altman-cmj.svg: w HTML width="1000" height="520" (9 KB)
    grupa tydzien     M    lo    hi  n     x
 kontrola       0 35.62 33.42 37.82 20 -0.15
  trening       0 35.09 32.60 37.58 20  0.15
 kontrola       4 36.12 34.22 38.03 20  3.85
  trening       4 36.45 33.90 39.01 20  4.15
 kontrola       8 35.50 33.43 37.57 20  7.85
  trening       8 37.89 35.37 40.42 20  8.15
    grupa     M    lo   hi  n
 kontrola -0.12 -1.27 1.03 20
  trening  2.80  1.35 4.26 20
Zapisano ../statystyka-sport-trening-pomiary-powtarzane.svg: w HTML width="1000" height="520" (25 KB)
             Opis     P1_skok_w_dal P2_rzetelnosc_CMJ        P3_trening
                4               100                30                40
     P4_aktywnosc
              200
creator: Metodolog.pl | lastModifiedBy: Metodolog.pl
rozmiar KB: 22
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje t.test(), wilcox.test(), cor.test(), lm() i power.t.test() z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- afex (wersja 1.5.1): Singmann, H., Bolker, B., Westfall, J., Aust, F., & Ben-Shachar, M. S. (2025). afex: Analysis of factorial experiments [R package]. https://doi.org/10.32614/CRAN.package.afex
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files (R package version 4.2.8.1) [Computer software]. https://doi.org/10.32614/CRAN.package.openxlsx
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy w analizach prac z WF i sportu
- Kilka prób jednego zawodnika jako osobne obserwacje. Do analizy wprowadź jeden wynik na osobę w pomiarze.
- Rzetelność opisana samą korelacją Pearsona albo ICC bez podania formy, bez 95% CI i bez typowego błędu w jednostkach testu.
- Pominięcie efektu uczenia się: brak sesji zapoznawczej i brak testu zmiany średniej między sesjami.
- Porównanie grup tylko w ostatnim pomiarze zamiast interakcji grupa × czas albo ANCOVA z pomiarem wyjściowym.
- ANOVA z powtarzanymi pomiarami bez poprawki na sferyczność przy trzech i więcej pomiarach.
- „Program poprawił sprawność” bez grupy kontrolnej; w sezonie wyniki rosną także bez nowego programu.
- Własne progi aktywności fizycznej zamiast zasad z podręcznika kwestionariusza.
- Wnioskowanie MBI („prawdopodobnie korzystny efekt”) zamiast efektu z 95% CI.
- Wnioski przyczynowe z porównania klas sportowych i ogólnych, do których uczniowie trafiają przez selekcję.
Najczęstsze pytania
Jak sprawdzić rzetelność testu sprawności fizycznej w pracy magisterskiej?
Zmierz tych samych zawodników w dwóch lub trzech sesjach w tych samych warunkach i podaj ICC(A,1) z 95% CI, typowy błąd pomiaru w jednostkach testu, współczynnik zmienności (CV), MDC95 i granice zgodności Blanda–Altmana. Sprawdź też testem t dla prób zależnych, czy średnia nie rośnie między sesjami z powodu efektu uczenia się.
Najlepsza próba czy średnia z prób – który wynik testu sprawności analizować?
Oba sposoby są stosowane. Średnia z kilku prób ma zwykle mniejszy błąd pomiaru, a najlepsza próba lepiej oddaje maksymalne możliwości zawodnika. Wybierz jeden sposób przed badaniem, stosuj go we wszystkich pomiarach i opisz w metodzie; do analizy wprowadź jeden wynik na zawodnika.
Jak przeanalizować trening z pomiarem przed, w trakcie i po programie?
Przy dwóch grupach i trzech pomiarach użyj ANOVA mieszanej z poprawką Greenhouse’a–Geissera i interpretuj interakcję grupa × czas, podając uogólnione eta kwadrat oraz zmianę w centymetrach lub sekundach z 95% CI. Wynik końcowy porównaj dodatkowo w ANCOVA z pomiarem wyjściowym, a przy brakach danych rozważ model mieszany.
Czy w pracy z nauk o sporcie można stosować wnioskowanie MBI?
Lepiej nie. Reanaliza Sainani (2018) wykazała, że przy małych i umiarkowanych próbach metoda magnitude-based inference kilkakrotnie zawyża błąd I rodzaju, i autorka zaleca, by jej nie stosować. Podaj efekt z 95% przedziałem ufności i porównaj go z ustaloną z góry najmniejszą ważną zmianą.
Jak sprawdzić, czy poprawa wyniku jednego zawodnika jest prawdziwa?
Porównaj zmianę zawodnika z minimalną wykrywalną zmianą MDC95 = 1.96 × √2 × SEM, wyznaczoną w badaniu rzetelności tego samego testu i protokołu. Zmiana mniejsza od MDC95 mieści się w błędzie pomiaru, a większa jest prawdopodobnie rzeczywista, choć nie musi wynikać z treningu.
Powiązane hasła
Przeczytaj też
Badanie rzetelności pomiaru klinicznego
Plan badania powtarzalności, forma ICC, SEM i MDC95, wykres Blanda–Altmana, zgodność dwóch urządzeń i raport według GRRAS – z przykładem w R.
Czytaj →PoradnikANOVA z powtarzanymi pomiarami krok po kroku
Cztery warunki, te same osoby: sferyczność i poprawka GG, η²G, porównania parami w emmeans, wykres z CI wewnątrzosobowymi, schemat mieszany i opis APA.
Czytaj →PoradnikANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →PoradnikKwestionariusz Godina (GLTEQ) – jak policzyć wynik
Wskaźnik LSI z wagami 9, 5 i 3, granica 24 dla aktywnych, mediana zamiast średniej i test–retest zamiast alfy – z przykładem w R i wzorem opisu.
Czytaj →Piszesz pracę z WF lub nauk o sporcie i masz wyniki testów, ale nie wiesz, jak je policzyć?
Pomożemy dobrać analizy do Twoich testów i schematu – od rzetelności testu po trening z kilkoma pomiarami – policzyć je z wielkością efektu i wyjaśnić tak, abyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Atkinson, G., & Nevill, A. M. (1998). Statistical methods for assessing measurement error (reliability) in variables relevant to sports medicine. Sports Medicine, 26(4), 217–238. https://doi.org/10.2165/00007256-199826040-00002
- Bakeman, R. (2005). Recommended effect size statistics for repeated measures designs. Behavior Research Methods, 37(3), 379–384. https://doi.org/10.3758/BF03192707 ● Otwarty dostęp
- Blanca, M. J., Arnau, J., García-Castro, F. J., Alarcón, R., & Bono, R. (2023). Repeated measures ANOVA and adjusted F-tests when sphericity is violated: Which procedure is best? Frontiers in Psychology, 14, Article 1192453. https://doi.org/10.3389/fpsyg.2023.1192453 ● Otwarty dostęp
- Bland, J. M., & Altman, D. G. (1986). Statistical methods for assessing agreement between two methods of clinical measurement. The Lancet, 327(8476), 307–310. https://doi.org/10.1016/s0140-6736(86)90837-8
- Currell, K., & Jeukendrup, A. E. (2008). Validity, reliability and sensitivity of measures of sporting performance. Sports Medicine, 38(4), 297–316. https://doi.org/10.2165/00007256-200838040-00003
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Hopkins, W. G. (2000). Measures of reliability in sports medicine and science. Sports Medicine, 30(1), 1–15. https://doi.org/10.2165/00007256-200030010-00001
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155–163. https://doi.org/10.1016/j.jcm.2016.02.012 ● Otwarty dostęp
- Sainani, K. L. (2018). The problem with “magnitude-based inference”. Medicine & Science in Sports & Exercise, 50(10), 2166–2176. https://doi.org/10.1249/mss.0000000000001645 ● Otwarty dostęp
- Shrout, P. E., & Fleiss, J. L. (1979). Intraclass correlations: Uses in assessing rater reliability. Psychological Bulletin, 86(2), 420–428. https://doi.org/10.1037/0033-2909.86.2.420
- Van Breukelen, G. J. P. (2006). ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies. Journal of Clinical Epidemiology, 59(9), 920–925. https://doi.org/10.1016/j.jclinepi.2006.02.007
- Walter, S. D., Eliasziw, M., & Donner, A. (1998). Sample size and optimal designs for reliability studies. Statistics in Medicine, 17(1), 101–110. https://doi.org/10.1002/(sici)1097-0258(19980115)17:1<101::aid-sim727>3.0.co;2-e
- Weir, J. P. (2005). Quantifying test-retest reliability using the intraclass correlation coefficient and the SEM. Journal of Strength and Conditioning Research, 19(1), 231–240. https://doi.org/10.1519/15184.1
Cytowania BibTeX
@article{atkinson1998statistical, author={Atkinson, Greg and Nevill, Alan M.}, title={{Statistical methods for assessing measurement error (reliability) in variables relevant to sports medicine}}, journal={Sports Medicine}, year={1998}, volume={26}, number={4}, pages={217--238}, doi={10.2165/00007256-199826040-00002}}@article{bakeman2005recommended, author={Bakeman, Roger}, title={{Recommended effect size statistics for repeated measures designs}}, journal={Behavior Research Methods}, year={2005}, volume={37}, number={3}, pages={379--384}, doi={10.3758/bf03192707}}@article{blanca2023repeated, author={Blanca, María J. and Arnau, Jaume and García-Castro, F. Javier and Alarcón, Rafael and Bono, Roser}, title={{Repeated measures ANOVA and adjusted F-tests when sphericity is violated: Which procedure is best?}}, journal={Frontiers in Psychology}, year={2023}, volume={14}, eid={1192453}, doi={10.3389/fpsyg.2023.1192453}}@article{bland1986statistical, author={Bland, J. Martin and Altman, Douglas G.}, title={{Statistical methods for assessing agreement between two methods of clinical measurement}}, journal={The Lancet}, year={1986}, volume={327}, number={8476}, pages={307--310}, doi={10.1016/s0140-6736(86)90837-8}}@article{currell2008validity, author={Currell, Kevin and Jeukendrup, Asker E.}, title={{Validity, reliability and sensitivity of measures of sporting performance}}, journal={Sports Medicine}, year={2008}, volume={38}, number={4}, pages={297--316}, doi={10.2165/00007256-200838040-00003}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{hopkins2000measures, author={Hopkins, Will G.}, title={{Measures of reliability in sports medicine and science}}, journal={Sports Medicine}, year={2000}, volume={30}, number={1}, pages={1--15}, doi={10.2165/00007256-200030010-00001}}@article{koo2016guideline, author={Koo, Terry K. and Li, Mae Y.}, title={{A guideline of selecting and reporting intraclass correlation coefficients for reliability research}}, journal={Journal of Chiropractic Medicine}, year={2016}, volume={15}, number={2}, pages={155--163}, doi={10.1016/j.jcm.2016.02.012}}@article{sainani2018problem, author={Sainani, Kristin L.}, title={{The problem with “magnitude-based inference”}}, journal={Medicine \& Science in Sports \& Exercise}, year={2018}, volume={50}, number={10}, pages={2166--2176}, doi={10.1249/mss.0000000000001645}}@article{shrout1979intraclass, author={Shrout, Patrick E. and Fleiss, Joseph L.}, title={{Intraclass correlations: Uses in assessing rater reliability}}, journal={Psychological Bulletin}, year={1979}, volume={86}, number={2}, pages={420--428}, doi={10.1037/0033-2909.86.2.420}}@article{vanbreukelen2006ancova, author={Van Breukelen, Gerard J. P.}, title={{ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies}}, journal={Journal of Clinical Epidemiology}, year={2006}, volume={59}, number={9}, pages={920--925}, doi={10.1016/j.jclinepi.2006.02.007}}@article{walter1998sample, author={Walter, S. D. and Eliasziw, M. and Donner, A.}, title={{Sample size and optimal designs for reliability studies}}, journal={Statistics in Medicine}, year={1998}, volume={17}, number={1}, pages={101--110}, doi={10.1002/(sici)1097-0258(19980115)17:1<101::aid-sim727>3.0.co;2-e}}@article{weir2005quantifying, author={Weir, Joseph P.}, title={{Quantifying test-retest reliability using the intraclass correlation coefficient and the SEM}}, journal={Journal of Strength and Conditioning Research}, year={2005}, volume={19}, number={1}, pages={231--240}, doi={10.1519/15184.1}}