Czym jest responsywność narzędzia
Narzędzie do oceny skuteczności terapii, programu czy szkolenia musi coś więcej niż rzetelnie odróżniać osoby od siebie w jednym pomiarze. Musi wychwycić zmianę u tej samej osoby, gdy ta zmiana naprawdę zaszła. Tę właściwość nazywamy responsywnością. W taksonomii COSMIN to zdolność narzędzia do wykrywania zmiany w czasie w mierzonym konstrukcie. Responsywność dotyczy trafności wyniku zmiany i wydzielono ją z trafności tylko dla przejrzystości (COSMIN, b.d.; Mokkink i in., 2010). Krótką definicję znajdziesz w haśle responsywność narzędzia.
Guyatt, Walter i Norman (1987) pokazali, że narzędzie może być rzetelne, a mało wrażliwe na zmianę, i odwrotnie. Dlatego responsywność wymaga osobnego badania. Nie wynika z wysokiej alfy ani z dobrego test–retest. Liang (2000) zauważył, że słowa „czułość” i „responsywność” bywają używane zamiennie. Sam rezerwuje responsywność dla zmian ważnych klinicznie, które warto mierzyć pytaniem o zmianę zadanym samemu badanemu.
Spór o to, czym responsywność jest, ma praktyczne skutki. Terwee i in. (2003) znaleźli w literaturze 25 definicji i 31 miar, które na tych samych danych dawały bardzo różne wyniki. Ich zdaniem źródłem zamieszania jest mieszanie dwóch rzeczy:
- wielkości zmiany (jak bardzo zmienił się wynik po interwencji), którą opisują wskaźniki rozkładowe, np. SRM;
- trafności zmiany (czy zmiana wyniku idzie w parze ze zmianą, która naprawdę zaszła), którą sprawdza się, porównując zmianę z kryterium zewnętrznym.
Husted i in. (2000) nazywają te dwa ujęcia responsywnością wewnętrzną i zewnętrzną. Za bardziej przydatną do interpretacji uznają tę drugą. W tym wpisie pokazujemy oba podejścia na jednym zbiorze danych i to, dlaczego mogą prowadzić do przeciwnych wniosków.
Nie powtarzamy tu progów dla pojedynczego pacjenta. RCI, MDC95 i wyznaczanie MCID opisuje poradnik RCI, MDC i MCID, a liczby dla własnej skali podstawisz w kalkulatorze RCI i MDC. Responsywność odpowiada na inne pytanie. Nie chodzi o to, czy zmiana jednej osoby przekracza próg, ale czy narzędzie jako całość dobrze oddaje zmianę w grupie.
Jak zaplanować badanie responsywności
Badanie responsywności to badanie podłużne. Potrzebujesz co najmniej dwóch pomiarów i okresu, w którym część osób zmieni się na pewno, a część raczej nie. Typowe są badania z interwencją o znanej skuteczności, ale bez grupy kontrolnej. Przed zebraniem danych ustal cztery rzeczy:
- Kotwicę. To zewnętrzne kryterium zmiany: pytanie do badanego o zmianę jego stanu (tzw. pytanie o przejście), ocena klinicysty albo zmiana w innym narzędziu o ustalonej trafności. Kotwica musi dotyczyć tego samego konstruktu. Pytanie o zmęczenie nie jest dobrą kotwicą dla skali lęku.
- Narzędzie porównawcze. Najwięcej mówi porównanie dwóch narzędzi mierzonych u tych samych osób, np. skali specyficznej i ogólnej.
- Hipotezy o kierunku i sile związków zmiany z kotwicą i z innymi narzędziami, zapisane przed analizą. Bez nich każdą korelację da się „dopasować” po fakcie.
- Odstęp czasu. Ma być dość długi, by zmiana mogła zajść, i dość krótki, by badany pamiętał stan wyjściowy, oceniając kotwicę.
Zwykle nie wystarcza więc samo badanie przed–po z jedną skalą. Bez kotwicy policzysz jedynie wielkość zmiany, a ta, jak zobaczysz niżej, nie mówi, czy narzędzie zmierzyło właściwą zmianę. Miejsce responsywności wśród innych dowodów trafności pokazuje wpis rodzaje trafności.
Przykład: dwie skale w programie dla osób z przewlekłym zmęczeniem
Dwieście osób z przewlekłym zmęczeniem uczestniczyło w 10-tygodniowym programie stopniowej aktywności. Przed programem i po nim wypełniły dwie skale. Obie są fikcyjne, dzięki czemu nie przypisujemy prawdziwym kwestionariuszom wartości, których nie sprawdziliśmy:
- SZ – specyficzna skala zmęczenia, 16 pozycji 0–3, wynik 0–48, wyższy wynik to silniejsze zmęczenie;
- OS – ogólna skala samopoczucia, wynik 0–100, wyższy wynik to lepsze samopoczucie.
Po programie każdy odpowiedział na pytanie-kotwicę „Jak zmieniło się Twoje zmęczenie od początku programu?” w pięciu kategoriach, od „wyraźnie gorzej” do „wyraźnie lepiej”. Zmianę liczymy tak, by w obu skalach wartość dodatnia oznaczała poprawę: dla SZ wynik przed minus wynik po, a dla OS odwrotnie. Dane są symulowane (set.seed(2731)). Możesz je pobrać jako plik CSV.
| Kotwica | n | Zmiana SZ: M (SD) | Zmiana OS: M (SD) |
|---|---|---|---|
| Wyraźnie gorzej | 14 | −3.86 (4.83) | 0.93 (4.78) |
| Trochę gorzej | 20 | −0.50 (5.03) | 2.50 (6.24) |
| Bez zmian | 44 | 1.41 (4.53) | 5.80 (7.27) |
| Trochę lepiej | 63 | 3.30 (3.85) | 6.40 (7.77) |
| Wyraźnie lepiej | 59 | 7.44 (4.67) | 9.37 (6.07) |
Już tabela coś podpowiada. Zmiana w SZ rośnie równo z kategorią kotwicy i zmienia znak przy „gorzej”. OS rośnie także u osób, które nie czują różnicy, a nawet u tych, którym się pogorszyło. W symulacji samopoczucie poprawiło się u wszystkich z powodu niezwiązanego ze zmęczeniem, np. pory roku albo samego udziału w programie.
Wskaźniki rozkładowe: ES, SRM i wskaźnik Guyatta
Wskaźniki rozkładowe dzielą średnią zmianę przez jakąś miarę rozproszenia. Najczęściej spotkasz trzy:
- ES (wielkość efektu zmiany) to średnia zmiana podzielona przez odchylenie standardowe wyniku, zwykle pomiaru wyjściowego. Kazis i in. (1989) zaproponowali ją jako sposób wyrażenia zmiany „przed i po” w jednej grupie w jednostkach standardowych.
- SRM (standaryzowana średnia odpowiedź) dzieli przez SD zmian. To ta sama wielkość co dz, opisana w haśle wielkość efektu dla prób zależnych. SRM jest więc wprost związana ze statystyką t dla prób zależnych: t = SRM × √n.
- Wskaźnik Guyatta dzieli zmianę przez SD zmian u osób, które się nie zmieniły. Guyatt i in. (1987) w liczniku umieścili minimalną istotną różnicę. Częsty wariant, użyty tutaj, bierze średnią zmianę w grupie z poprawą według kotwicy.
| Wskaźnik | SZ | OS |
|---|---|---|
| ES, cała próba (N = 200) | 0.49 | 0.59 |
| SRM, cała próba [95% CI bootstrap] | 0.59 [0.44, 0.74] | 0.88 [0.72, 1.06] |
| SRM, grupa „poprawa” (n = 122) | 1.12 | 1.10 |
| SRM, grupa „bez zmian” (n = 44) | 0.31 | 0.80 |
| Wskaźnik Guyatta | 1.17 | 1.08 |
Gdyby zatrzymać się na pierwszych dwóch wierszach, wniosek brzmiałby: OS jest bardziej responsywna, bo SRM wynosi 0.88 wobec 0.59. To wniosek błędny. SRM w grupie „bez zmian” pokazuje, że OS „wykrywa” dużą zmianę także u osób, które jej nie odczuły. Wskaźnik Guyatta, który bierze pod uwagę szum u osób stabilnych, odwraca kolejność. Na tym polega argument Terwee i in. (2003): wskaźniki ES i SRM mierzą wielkość efektu w danej próbie, a nie to, czy narzędzie mierzy właściwą zmianę. Te same skale dadzą inne SRM po skuteczniejszej albo słabszej terapii. CI dla SRM policzyliśmy metodą bootstrap, bo wzór na błąd standardowy zakłada normalność zmian.
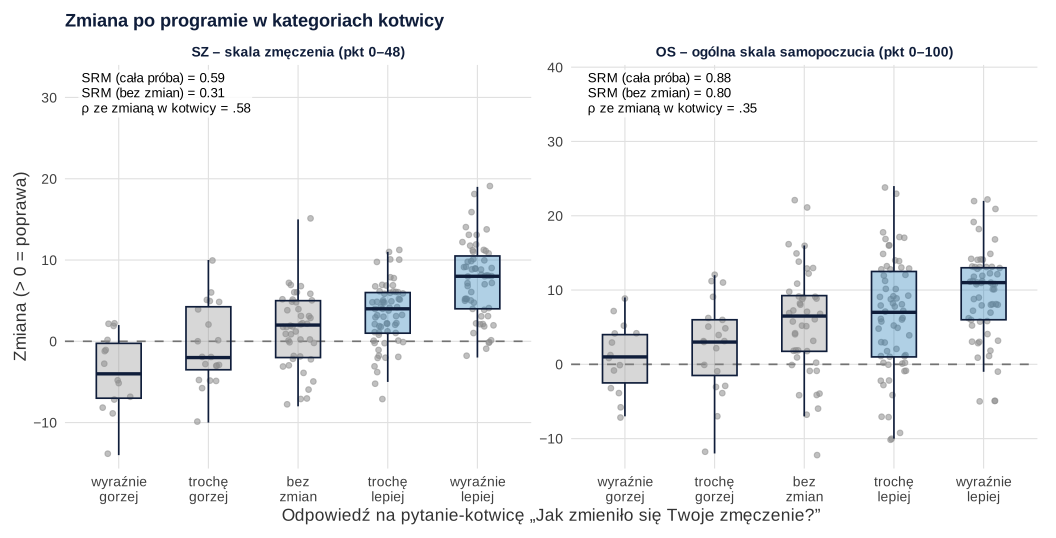
Wskaźniki rozkładowe mają też inne ograniczenia. Zależą od SD w próbie, więc w próbie jednorodnej wychodzą wyższe. Zaniża je efekt sufitu i podłogi, bo osoby przy granicy skali nie mają „dokąd” się zmienić. Zawyża je regresja do średniej, gdy do badania kwalifikuje się osoby ze skrajnymi wynikami. Zawyża je także efekt uczenia się. Traktuj je jako opis wielkości zmiany, a nie jako dowód responsywności.
Metody z kotwicą: korelacja i krzywa ROC
Metody z kotwicą sprawdzają, czy zmiana wyniku idzie w parze ze zmianą według kryterium zewnętrznego. To responsywność zewnętrzna w ujęciu Husteda i in. (2000) i trafność podłużna w ujęciu Terwee i in. (2003). Stosuje się dwa podejścia.
Podejście konstrukcyjne: korelacje. Kotwica ma pięć uporządkowanych kategorii, więc liczymy korelację Spearmana między zmianą a kotwicą. Dla SZ ρ = .58, p < .001, a dla OS ρ = .35. Zmiany obu skal korelują ze sobą słabo, ρ = .26, bo mierzą różne konstrukty. Tak samo jak w trafności teoretycznej, liczy się nie sama istotność korelacji, ale jej zgodność z przewidywaniem.
Podejście kryterialne: ROC. Kotwicę dzielimy na „poprawa” (trochę lub wyraźnie lepiej, n = 122) i „bez zmian” (n = 44). Osoby z pogorszeniem pomijamy, bo pytamy o wykrycie poprawy. Krzywa ROC dla wyniku zmiany pokazuje, jak dobrze zmiana odróżnia obie grupy. AUC to prawdopodobieństwo, że losowa osoba z poprawą ma większą zmianę niż losowa osoba bez zmian. Kotwica gra tu rolę „złotego standardu”, jak w trafności kryterialnej.
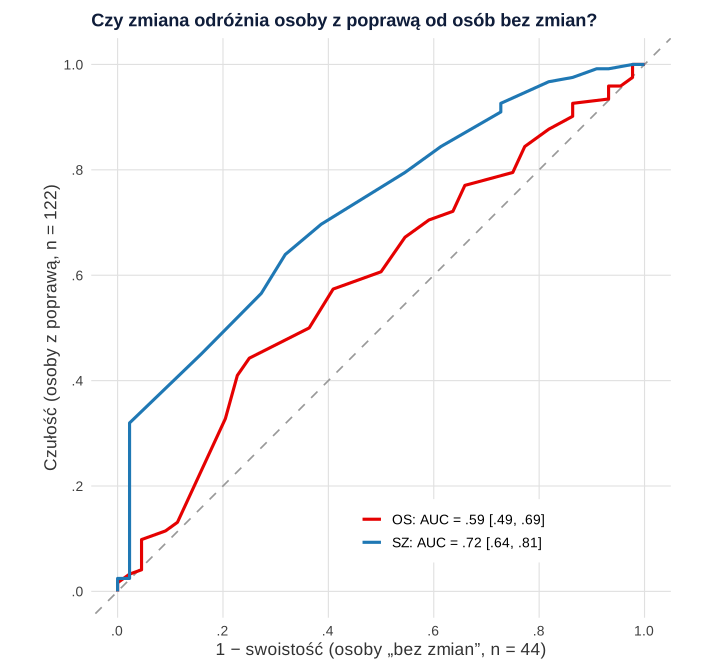
Dla SZ AUC = .72, 95% CI [.64, .81], a dla OS AUC = .59, 95% CI [.49, .69]. Przedział dla OS obejmuje .50, czyli poziom losowy. Obie krzywe pochodzą od tych samych osób, więc porównujemy je testem DeLonga dla krzywych skorelowanych: różnica AUC = .13, z = 2.11, p = .035. Mechanikę ROC, CI i wybór progu opisuje poradnik krzywa ROC i punkt odcięcia krok po kroku.
Uwaga na pomylenie dwóch zastosowań tej samej krzywej. W badaniu responsywności interesuje Cię AUC, czyli jak dobrze narzędzie odróżnia zmianę od jej braku. Punkt na krzywej wybrany np. indeksem Youdena to co innego: oszacowanie minimalnej istotnej zmiany. Jak je wyznaczać i dlaczego wynik zależy od definicji „poprawy” w kotwicy, wyjaśnia hasło MCID i poradnik o RCI i MCID. Z kolei MDC pochodzi z badania osób stabilnych i mówi o błędzie pomiaru, a nie o responsywności.
Hipotezy ustalone przed analizą
Pojedyncza korelacja czy AUC nie wystarcza. Silniejszym dowodem jest zestaw hipotez zapisanych przed analizą, z oczekiwanym kierunkiem i wielkością efektu, i odsetek hipotez, które się potwierdziły. Terwee i in. (2007) zaproponowali kryteria jakości oceny właściwości pomiarowych, w tym responsywności, z regułą oceny pozytywnej, negatywnej albo nieokreślonej. Progi poniżej przyjęliśmy dla przykładu. W swoim badaniu uzasadnij je wcześniejszymi badaniami i teorią.
| Hipoteza (zapisana przed analizą) | Wynik | Potwierdzona? |
|---|---|---|
| H1: zmiana SZ koreluje z kotwicą co najmniej na poziomie ρ = .50 | ρ = .58 | tak |
| H2: korelacja z kotwicą jest wyższa dla SZ niż dla OS | .58 wobec .35 | tak |
| H3: zmiany SZ i OS korelują umiarkowanie (ρ od .30 do .60) | ρ = .26 | nie |
| H4: AUC dla SZ wynosi co najmniej .70 | .72 [.64, .81] | tak |
| H5: AUC dla SZ jest wyższe niż dla OS | .72 wobec .59, p = .035 | tak |
Potwierdziły się cztery z pięciu hipotez. Niepotwierdzonej H3 nie ukrywaj. Opisz, co mogła oznaczać: tu słabszy niż zakładano związek samopoczucia ze zmęczeniem w tej populacji. Zwróć też uwagę, że dolna granica CI dla AUC (.64) leży poniżej .70. Przy 44 osobach „bez zmian” oszacowanie jest mało precyzyjne, więc planuj takie badanie z liczniejszą grupą stabilną.
Jak opisać badanie responsywności
W metodach podaj kotwicę (dokładne brzmienie pytania i kategorie), odstęp między pomiarami, sposób podziału kotwicy, hipotezy z progami oraz wskaźniki, które liczysz. W wynikach podaj tabelę zmian w kategoriach kotwicy, korelacje, AUC z CI i bilans hipotez. ES i SRM pokaż jako opis wielkości zmiany. Revicki i in. (2008), omawiając metody oceny responsywności i minimalnej istotnej różnicy, zalecają opierać tę różnicę przede wszystkim na kotwicach z oceny pacjenta lub klinicysty, a metody rozkładowe traktować jako wsparcie.
Responsywność to jeden z elementów walidacji obok rzetelności i trafności przekrojowej. Cały proces opisuje wpis jak zbudować i zwalidować skalę, a badanie przed–po od planu do raportu omawia przewodnik po badaniach klinicznych przed i po. Jeśli planujesz walidację narzędzia do oceny zmiany, możemy pomóc w doborze kotwicy, hipotez i analizy w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Jeden przepis tworzy dane, zapisuje plik responsywnosc-dane-przyklad.csv (możesz go pobrać tutaj) i liczy wszystkie wyniki z tekstu. Potrzebujesz pakietów pROC i boot.
Wskaźniki rozkładowe, korelacje z kotwicą, ROC i hipotezy
R
# B273 – responsywność narzędzia (dane symulowane, set.seed(2731))
# 200 osób z przewlekłym zmęczeniem w 10-tygodniowym programie aktywności. Przed i po programie wypełniają
# dwie fikcyjne skale: specyficzną skalę zmęczenia SZ (16 pozycji 0–3, wynik 0–48, wyższy = silniejsze zmęczenie)
# i ogólną skalę samopoczucia OS (0–100, wyższy = lepiej). Po programie odpowiadają na pytanie-kotwicę:
# „Jak zmieniło się Twoje zmęczenie od początku programu?” (5 kategorii od „wyraźnie gorzej” do „wyraźnie lepiej”).
suppressPackageStartupMessages({ library(pROC); library(boot) })
set.seed(2731)
n <- 200
poprawa_prawdziwa <- rnorm(n, 0.45, 0.75)                     # prawdziwa zmiana zmęczenia (w SD cechy)
ocena <- poprawa_prawdziwa + rnorm(n, 0, 0.45)                 # jak osoba postrzega zmianę
kotwica <- cut(ocena, c(-Inf, -0.75, -0.25, 0.30, 0.95, Inf),
               labels = c("wyraźnie gorzej", "trochę gorzej", "bez zmian", "trochę lepiej", "wyraźnie lepiej"))
cecha_przed <- rnorm(n)
sz_przed <- pmin(pmax(round(28 + 6.5 * cecha_przed + rnorm(n, 0, 2.5)), 0), 48)
sz_po    <- pmin(pmax(round(28 + 6.5 * (cecha_przed - poprawa_prawdziwa) + rnorm(n, 0, 2.5)), 0), 48)
# OS odzwierciedla zmianę zmęczenia słabiej, a po programie rośnie u wszystkich (np. lepsza pogoda, efekt uczestnictwa)
os_przed <- pmin(pmax(round(55 - 6 * cecha_przed + rnorm(n, 0, 10)), 0), 100)
os_po    <- pmin(pmax(round(os_przed + 3.5 * poprawa_prawdziwa + 4 + rnorm(n, 0, 6.5)), 0), 100)
dane <- data.frame(id = 1:n, sz_przed, sz_po, os_przed, os_po, kotwica)
write.csv(dane, "responsywnosc-dane-przyklad.csv", row.names = FALSE)

# Zmiana liczona tak, by wartość dodatnia oznaczała poprawę w obu skalach
dane$zm_sz <- dane$sz_przed - dane$sz_po
dane$zm_os <- dane$os_po - dane$os_przed
dane$grupa <- factor(ifelse(dane$kotwica %in% c("trochę lepiej", "wyraźnie lepiej"), "poprawa",
                     ifelse(dane$kotwica == "bez zmian", "bez zmian", "pogorszenie")),
                     levels = c("pogorszenie", "bez zmian", "poprawa"))

# Krok 1. Rozkład kotwicy i średnia zmiana w kategoriach kotwicy
table(dane$kotwica)
aggregate(cbind(zm_sz, zm_os) ~ kotwica, dane, function(x) round(c(M = mean(x), SD = sd(x)), 2))

# Krok 2. Wskaźniki rozkładowe: ES = M zmiany / SD przed, SRM = M zmiany / SD zmiany,
# wskaźnik Guyatta = M zmiany w grupie „poprawa” / SD zmiany w grupie „bez zmian”
wskazniki <- function(przed, zmiana, grupa) {
  c(ES_cala = mean(zmiana) / sd(przed), SRM_cala = mean(zmiana) / sd(zmiana),
    ES_poprawa = mean(zmiana[grupa == "poprawa"]) / sd(przed[grupa == "poprawa"]),
    SRM_poprawa = mean(zmiana[grupa == "poprawa"]) / sd(zmiana[grupa == "poprawa"]),
    SRM_bez_zmian = mean(zmiana[grupa == "bez zmian"]) / sd(zmiana[grupa == "bez zmian"]),
    Guyatt = mean(zmiana[grupa == "poprawa"]) / sd(zmiana[grupa == "bez zmian"]))
}
round(rbind(SZ = wskazniki(dane$sz_przed, dane$zm_sz, dane$grupa),
            OS = wskazniki(dane$os_przed, dane$zm_os, dane$grupa)), 2)

# 95% CI bootstrapowe (percentylowe) dla SRM w całej próbie
set.seed(27312)
srm_boot <- boot(dane, function(d, i) c(mean(d$zm_sz[i]) / sd(d$zm_sz[i]), mean(d$zm_os[i]) / sd(d$zm_os[i])), R = 2000)
round(rbind(SZ = boot.ci(srm_boot, type = "perc", index = 1)$percent[4:5],
            OS = boot.ci(srm_boot, type = "perc", index = 2)$percent[4:5]), 2)

# Krok 3. Podejście konstrukcyjne: korelacje zmiany z kotwicą (Spearman) i między skalami
kot_num <- as.integer(dane$kotwica)
round(c(SZ_kotwica = cor(dane$zm_sz, kot_num, method = "spearman"),
        OS_kotwica = cor(dane$zm_os, kot_num, method = "spearman"),
        SZ_OS = cor(dane$zm_sz, dane$zm_os, method = "spearman")), 2)
cor.test(dane$zm_sz, kot_num, method = "spearman", exact = FALSE)$p.value < .001

# Krok 4. Podejście kryterialne: ROC zmiany dla „poprawa” wobec „bez zmian” (pogorszenie wyłączone)
pb <- droplevels(subset(dane, grupa != "pogorszenie"))
table(pb$grupa)
roc_sz <- roc(pb$grupa, pb$zm_sz, levels = c("bez zmian", "poprawa"), direction = "<", quiet = TRUE)
roc_os <- roc(pb$grupa, pb$zm_os, levels = c("bez zmian", "poprawa"), direction = "<", quiet = TRUE)
round(rbind(SZ = ci.auc(roc_sz, method = "delong"), OS = ci.auc(roc_os, method = "delong")), 3)
rt <- roc.test(roc_sz, roc_os, method = "delong", paired = TRUE)
round(c(roznica_AUC = unname(rt$estimate[1] - rt$estimate[2]), z = unname(rt$statistic), p = rt$p.value), 3)

# Krok 5. Sprawdzenie hipotez ustalonych przed analizą
hipotezy <- data.frame(
  hipoteza = c("H1: rho(zmiana SZ, kotwica) >= .50", "H2: rho(zmiana SZ, kotwica) > rho(zmiana OS, kotwica)",
               "H3: .30 <= rho(zmiana SZ, zmiana OS) <= .60", "H4: AUC SZ >= .70", "H5: AUC SZ > AUC OS"),
  wynik = c(round(cor(dane$zm_sz, kot_num, method = "spearman"), 2),
            round(cor(dane$zm_sz, kot_num, method = "spearman") - cor(dane$zm_os, kot_num, method = "spearman"), 2),
            round(cor(dane$zm_sz, dane$zm_os, method = "spearman"), 2), round(auc(roc_sz), 2),
            round(auc(roc_sz) - auc(roc_os), 2)))
hipotezy$potwierdzona <- c(hipotezy$wynik[1] >= .50, hipotezy$wynik[2] > 0, hipotezy$wynik[3] >= .30 & hipotezy$wynik[3] <= .60,
                           hipotezy$wynik[4] >= .70, hipotezy$wynik[5] > 0)
print(hipotezy, row.names = FALSE)
Wynik w R
wyraźnie gorzej   trochę gorzej       bez zmian   trochę lepiej wyraźnie lepiej
             14              20              44              63              59
          kotwica zm_sz.M zm_sz.SD zm_os.M zm_os.SD
1 wyraźnie gorzej   -3.86     4.83    0.93     4.78
2   trochę gorzej   -0.50     5.03    2.50     6.24
3       bez zmian    1.41     4.53    5.80     7.27
4   trochę lepiej    3.30     3.85    6.40     7.77
5 wyraźnie lepiej    7.44     4.67    9.37     6.07
   ES_cala SRM_cala ES_poprawa SRM_poprawa SRM_bez_zmian Guyatt
SZ    0.49     0.59       0.80        1.12          0.31   1.17
OS    0.59     0.88       0.74        1.10          0.80   1.08
   [,1] [,2]
SZ 0.44 0.74
OS 0.72 1.06
SZ_kotwica OS_kotwica      SZ_OS
      0.58       0.35       0.26
[1] TRUE

bez zmian   poprawa
       44       122
    [,1]  [,2]  [,3]
SZ 0.640 0.723 0.807
OS 0.491 0.589 0.686
roznica_AUC           z           p
      0.135       2.105       0.035
                                              hipoteza wynik potwierdzona
                    H1: rho(zmiana SZ, kotwica) >= .50  0.58         TRUE
 H2: rho(zmiana SZ, kotwica) > rho(zmiana OS, kotwica)  0.23         TRUE
           H3: .30 <= rho(zmiana SZ, zmiana OS) <= .60  0.26        FALSE
                                     H4: AUC SZ >= .70  0.72         TRUE
                                   H5: AUC SZ > AUC OS  0.13         TRUE
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, 77. https://doi.org/10.1186/1471-2105-12-77
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions (R package version 1.3-32) [Computer software]. https://doi.org/10.32614/CRAN.package.boot
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Responsywność oceniona tylko przez ES lub SRM. Duża zmiana nie dowodzi, że narzędzie mierzy właściwą zmianę. Potrzebujesz kotwicy i hipotez.
- Porównywanie SRM z różnych badań albo z różnych terapii, jakby była to stała cecha skali.
- Kotwica z innego konstruktu albo zbyt odległa w czasie, by badany pamiętał stan wyjściowy.
- Hipotezy dopisane po analizie i pominięcie tych, które się nie potwierdziły.
- Mylenie AUC z MCID. AUC ocenia narzędzie, próg z krzywej ROC to oszacowanie minimalnej istotnej zmiany.
- Brak grupy stabilnej. Bez osób, które się nie zmieniły, nie sprawdzisz, czy skala nie „wykrywa” zmian, których nie było. Do porównania zmian między grupami przyda się też hasło wynik różnicowy.
Najczęstsze pytania
Czym różni się responsywność od rzetelności?
Rzetelność mówi, jak bardzo pomiar jest wolny od błędu, a responsywność – czy narzędzie wychwytuje zmianę, która naprawdę zaszła. Guyatt i in. (1987) pokazali, że skala może być rzetelna, a mało wrażliwa na zmianę, i odwrotnie. Dlatego responsywność wymaga osobnego badania podłużnego z kotwicą.
Czy wysokie SRM oznacza dobrą responsywność?
Nie. SRM to średnia zmiana podzielona przez SD zmian, więc opisuje wielkość efektu w tej próbie i zależy od skuteczności interwencji. W przykładzie ogólna skala miała wyższe SRM (0.88 wobec 0.59), choć słabiej odróżniała osoby z poprawą od osób bez zmian (AUC .59 wobec .72). Terwee i in. (2003) uznają takie wskaźniki za miary efektu, a nie oceny narzędzia.
Co może być kotwicą w badaniu responsywności?
Pytanie do badanego o zmianę jego stanu, ocena klinicysty albo zmiana w innym narzędziu o ustalonej trafności. Kotwica musi dotyczyć tego samego konstruktu, a odstęp czasu nie może być zbyt długi, by badany pamiętał stan wyjściowy. Podaj w pracy dokładne brzmienie pytania i kategorie odpowiedzi.
Jak interpretować AUC w badaniu responsywności?
AUC to prawdopodobieństwo, że losowa osoba z poprawą według kotwicy ma większą zmianę wyniku niż losowa osoba bez zmian. AUC = .50 oznacza poziom losowy. Podawaj 95% CI i próg zapisany w hipotezach przed analizą. Punkt na krzywej wybrany indeksem Youdena to już oszacowanie minimalnej istotnej zmiany, a nie miara responsywności.
Ile osób potrzeba do badania responsywności?
Na tyle dużo, by obie grupy kotwicy były liczne. Precyzję AUC ogranicza zwykle mniejsza grupa, często osoby bez zmian. W przykładzie przy 44 takich osobach 95% CI dla AUC miał szerokość około .17. Zaplanuj odstęp czasu i dobór tak, żeby w próbie była wyraźna grupa stabilna.
Powiązane hasła
Przeczytaj też
RCI, MDC i MCID
SEM, MDC95, RCI i kryteria Jacobsona–Truaxa, MCID z kotwicy i metod rozkładowych, analiza responderów z 95% CI i koszt dychotomizacji – z kodem R.
Czytaj →PoradnikBadanie rzetelności pomiaru klinicznego
Plan badania powtarzalności, forma ICC, SEM i MDC95, wykres Blanda–Altmana, zgodność dwóch urządzeń i raport według GRRAS – z przykładem w R.
Czytaj →PoradnikRodzaje trafności – mapa dowodów
Tradycyjne nazwy trafności na mapie pięciu źródeł dowodów (Standards, 2014): jak zebrać dowód, jaka analiza, jak opisać w pracy i które 2–3 rodzaje dowodów zaplanować.
Czytaj →Walidujesz narzędzie do oceny zmiany?
Pomożemy dobrać kotwicę, sformułować hipotezy, policzyć korelacje, AUC i wskaźniki rozkładowe oraz opisać responsywność tak, żeby recenzent nie miał wątpliwości.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- COSMIN. (b.d.). COSMIN taxonomy of measurement properties. Pobrano 1 listopada 2026 z https://www.cosmin.nl/tools/cosmin-taxonomy-measurement-properties/ ● Otwarty dostęp
- Guyatt, G., Walter, S., & Norman, G. (1987). Measuring change over time: Assessing the usefulness of evaluative instruments. Journal of Chronic Diseases, 40(2), 171–178. https://doi.org/10.1016/0021-9681(87)90069-5
- Husted, J. A., Cook, R. J., Farewell, V. T., & Gladman, D. D. (2000). Methods for assessing responsiveness: A critical review and recommendations. Journal of Clinical Epidemiology, 53(5), 459–468. https://doi.org/10.1016/s0895-4356(99)00206-1
- Kazis, L. E., Anderson, J. J., & Meenan, R. F. (1989). Effect sizes for interpreting changes in health status. Medical Care, 27(3 Suppl.), S178–S189. https://doi.org/10.1097/00005650-198903001-00015
- Liang, M. H. (2000). Longitudinal construct validity: Establishment of clinical meaning in patient evaluative instruments. Medical Care, 38(9 Suppl.), II–84–II–90. https://doi.org/10.1097/00005650-200009002-00013
- Mokkink, L. B., Terwee, C. B., Patrick, D. L., Alonso, J., Stratford, P. W., Knol, D. L., Bouter, L. M., & de Vet, H. C. W. (2010). The COSMIN study reached international consensus on taxonomy, terminology, and definitions of measurement properties for health-related patient-reported outcomes. Journal of Clinical Epidemiology, 63(7), 737–745. https://doi.org/10.1016/j.jclinepi.2010.02.006 ● Otwarty dostęp
- Revicki, D., Hays, R. D., Cella, D., & Sloan, J. (2008). Recommended methods for determining responsiveness and minimally important differences for patient-reported outcomes. Journal of Clinical Epidemiology, 61(2), 102–109. https://doi.org/10.1016/j.jclinepi.2007.03.012
- Terwee, C. B., Bot, S. D. M., de Boer, M. R., van der Windt, D. A. W. M., Knol, D. L., Dekker, J., Bouter, L. M., & de Vet, H. C. W. (2007). Quality criteria were proposed for measurement properties of health status questionnaires. Journal of Clinical Epidemiology, 60(1), 34–42. https://doi.org/10.1016/j.jclinepi.2006.03.012 ● Otwarty dostęp
- Terwee, C. B., Dekker, F. W., Wiersinga, W. M., Prummel, M. F., & Bossuyt, P. M. M. (2003). On assessing responsiveness of health-related quality of life instruments: Guidelines for instrument evaluation. Quality of Life Research, 12(4), 349–362. https://doi.org/10.1023/a:1023499322593
Cytowania BibTeX
@misc{cosminnd, author={{COSMIN}}, title={{COSMIN taxonomy of measurement properties}}, url={https://www.cosmin.nl/tools/cosmin-taxonomy-measurement-properties/}}@article{guyatt1987measuring, author={Guyatt, Gordon and Walter, Stephen and Norman, Geoff}, title={{Measuring change over time: Assessing the usefulness of evaluative instruments}}, journal={Journal of Chronic Diseases}, year={1987}, volume={40}, number={2}, pages={171--178}, doi={10.1016/0021-9681(87)90069-5}}@article{husted2000methods, author={Husted, Janice A. and Cook, Richard J. and Farewell, Vern T. and Gladman, Dafna D.}, title={{Methods for assessing responsiveness: A critical review and recommendations}}, journal={Journal of Clinical Epidemiology}, year={2000}, volume={53}, number={5}, pages={459--468}, doi={10.1016/s0895-4356(99)00206-1}}@article{kazis1989effect, author={Kazis, Lewis E. and Anderson, Jennifer J. and Meenan, Robert F.}, title={{Effect sizes for interpreting changes in health status}}, journal={Medical Care}, year={1989}, volume={27}, number={3 Suppl.}, pages={S178--S189}, doi={10.1097/00005650-198903001-00015}}@article{liang2000longitudinal, author={Liang, Matthew H.}, title={{Longitudinal construct validity: Establishment of clinical meaning in patient evaluative instruments}}, journal={Medical Care}, year={2000}, volume={38}, number={9 Suppl.}, pages={II--84--II--90}, doi={10.1097/00005650-200009002-00013}}@article{mokkink2010cosmin, author={Mokkink, Lidwine B. and Terwee, Caroline B. and Patrick, Donald L. and Alonso, Jordi and Stratford, Paul W. and Knol, Dirk L. and Bouter, Lex M. and de Vet, Henrica C. W.}, title={{The COSMIN study reached international consensus on taxonomy, terminology, and definitions of measurement properties for health-related patient-reported outcomes}}, journal={Journal of Clinical Epidemiology}, year={2010}, volume={63}, number={7}, pages={737--745}, doi={10.1016/j.jclinepi.2010.02.006}}@article{revicki2008recommended, author={Revicki, Dennis and Hays, Ron D. and Cella, David and Sloan, Jeff}, title={{Recommended methods for determining responsiveness and minimally important differences for patient-reported outcomes}}, journal={Journal of Clinical Epidemiology}, year={2008}, volume={61}, number={2}, pages={102--109}, doi={10.1016/j.jclinepi.2007.03.012}}@article{terwee2007quality, author={Terwee, Caroline B. and Bot, Sandra D. M. and de Boer, Michael R. and van der Windt, Daniëlle A. W. M. and Knol, Dirk L. and Dekker, Joost and Bouter, Lex M. and de Vet, Henrica C. W.}, title={{Quality criteria were proposed for measurement properties of health status questionnaires}}, journal={Journal of Clinical Epidemiology}, year={2007}, volume={60}, number={1}, pages={34--42}, doi={10.1016/j.jclinepi.2006.03.012}}@article{terwee2003assessing, author={Terwee, Caroline B. and Dekker, Friedo W. and Wiersinga, Wilmar M. and Prummel, Mark F. and Bossuyt, Patrick M. M.}, title={{On assessing responsiveness of health-related quality of life instruments: Guidelines for instrument evaluation}}, journal={Quality of Life Research}, year={2003}, volume={12}, number={4}, pages={349--362}, doi={10.1023/a:1023499322593}}