Czym jest RAND-36
RAND-36 (RAND 36-Item Health Survey 1.0) to ogólny kwestionariusz jakości życia związanej ze zdrowiem. Powstał w Medical Outcomes Study, a jego 36 pozycji opisuje osiem obszarów zdrowia: funkcjonowanie fizyczne, ograniczenia ról z powodu zdrowia fizycznego, ograniczenia ról z powodu problemów emocjonalnych, energię i zmęczenie, samopoczucie emocjonalne, funkcjonowanie społeczne, ból i ogólne postrzeganie zdrowia (Hays i Morales, 2001). Jedna dodatkowa pozycja pyta o zmianę zdrowia w ciągu roku i nie wchodzi do żadnej skali.
To typowy PROM, czyli wynik zgłaszany przez pacjenta. Spotkasz go w pracach z medycyny, pielęgniarstwa, zdrowia publicznego i fizjoterapii. Najczęściej porównuje się w nich grupy chorych albo stan przed i po leczeniu lub rehabilitacji. Warsztat tych kierunków opisują wpisy statystyka dla lekarza, statystyka w pracy z pielęgniarstwa, statystyka w pracy ze zdrowia publicznego i statystyka dla fizjoterapeuty. Jeśli wybierasz między narzędziami, porównaj RAND-36 z WHOQOL-BREF i EQ-5D.
RAND-36 a SF-36: te same pozycje, inna punktacja
To najważniejsza rzecz do zrozumienia przed liczeniem. Pozycje RAND-36 są identyczne z pozycjami MOS SF-36, opisanego przez Ware'a i Sherbourne (1992). Różni się sposób liczenia wyniku. Oficjalna strona RAND wyjaśnia, że jej procedura jest prostsza niż punktacja SF-36. Dlatego osoby, które liczą wynik metodą RAND, powinny nazywać narzędzie RAND 36-Item Health Survey 1.0 (RAND Corporation, b.d.-b).
| Cecha | RAND-36 1.0 | SF-36 (znak towarowy) |
|---|---|---|
| Pozycje | 36, te same co w MOS SF-36 | 36 |
| Dystrybucja | RAND, bezpłatnie do użytku niekomercyjnego | w 1993 r. MOS Trust; obecne warunki – u dystrybutora licencji |
| Wynik skali | średnia pozycji przekodowanych na 0–100 | własny algorytm punktacji SF-36 |
| Wyniki normowe i sumaryczne | nie są częścią klucza na stronie RAND | wyniki T i wyniki złożone zdrowia fizycznego i psychicznego wymagają wag i norm populacyjnych |
Hays, Sherbourne i Mazel (1993) podają, że pozycje i zasady punktacji SF-36 rozpowszechniał MOS Trust. Używanie znaku towarowego SF-36 wymagało ścisłego trzymania się brzmienia pozycji i zaleceń punktacji. Ten sam artykuł omawia różnice w punktacji obu wersji i przedstawia wyniki T oraz dwa wyniki złożone wyprowadzone z analizy czynnikowej. W tym wpisie nie podajemy wag ani norm potrzebnych do wyników T i wyników sumarycznych. Wymagają one średnich i odchyleń z populacji odniesienia (zob. normy testowe). Polskich norm też nie podajemy. Jeśli promotor oczekuje „PCS i MCS”, ustal najpierw, której wersji używasz i skąd weźmiesz wagi.
Klucz RAND: przekodowanie na 0–100
Klucz pochodzi z oficjalnej strony RAND z instrukcją punktacji (RAND Corporation, b.d.-b; stan na 1 listopada 2026 r.). Punktacja ma dwa kroki. W kroku pierwszym każdą odpowiedź zamieniasz na wartość 0–100. Wyższy wynik zawsze oznacza korzystniejszy stan zdrowia. Kody to liczby wydrukowane przy odpowiedziach w kwestionariuszu. Brzmienia pozycji nie przytaczamy – podajemy tylko numery.
| Numery pozycji | Liczba kodów | Kod → wartość |
|---|---|---|
| 1, 2, 20, 22, 34, 36 | 5 | 1 → 100, 2 → 75, 3 → 50, 4 → 25, 5 → 0 |
| 3–12 | 3 | 1 → 0, 2 → 50, 3 → 100 |
| 13–19 | 2 | 1 → 0, 2 → 100 |
| 21, 23, 26, 27, 30 | 6 | 1 → 100, 2 → 80, 3 → 60, 4 → 40, 5 → 20, 6 → 0 |
| 24, 25, 28, 29, 31 | 6 | 1 → 0, 2 → 20, 3 → 40, 4 → 60, 5 → 80, 6 → 100 |
| 32, 33, 35 | 5 | 1 → 0, 2 → 25, 3 → 50, 4 → 75, 5 → 100 |
W kroku drugim uśredniasz przekodowane pozycje tej samej skali. Pozycje „malejące” pełnią tu rolę pozycji odwróconych: ich kod 1 oznacza najlepszy stan, więc dostaje 100.
| Skala | Liczba pozycji | Numery pozycji |
|---|---|---|
| Funkcjonowanie fizyczne | 10 | 3–12 |
| Ograniczenia ról – zdrowie fizyczne | 4 | 13–16 |
| Ograniczenia ról – problemy emocjonalne | 3 | 17–19 |
| Energia/zmęczenie | 4 | 23, 27, 29, 31 |
| Samopoczucie emocjonalne | 5 | 24, 25, 26, 28, 30 |
| Funkcjonowanie społeczne | 2 | 20, 32 |
| Ból | 2 | 21, 22 |
| Zdrowie ogólne | 5 | 1, 33, 34, 35, 36 |
Pozycja 2 (zmiana zdrowia) zostaje poza skalami. Przekodowanie każdej pozycji da się zapisać jednym wzorem. Przy pozycji o k kodach, w której kod 1 oznacza najgorszy stan:
W kodzie R sprawdzamy, że wzór odtwarza tabelę RAND co do wartości.
Jak policzyć wynik krok po kroku
- Sprawdź kody. Każda pozycja może mieć tylko wartości od 1 do liczby kodów. Formularze online zapisują czasem 0–4 zamiast 1–5 albo tekst etykiety.
- Przekoduj na 0–100 według tabeli wyżej. Zapisz klucz w książce kodowej.
- Policz średnią w każdej skali. Według RAND brakujące pozycje się pomija. Wynik skali to średnia pozycji, na które osoba odpowiedziała (RAND Corporation, b.d.-b).
- Opisz braki. Reguła RAND nie podaje minimalnej liczby odpowiedzi. W skali dwupozycyjnej wynik może więc opierać się na jednej pozycji. Jeśli wprowadzasz własny próg, to jest decyzja badacza i trzeba ją opisać w pracy. Więcej o brakach przeczytasz we wpisie braki danych w ankiecie.
- Nie sumuj skal. RAND podaje osiem osobnych wyników. Wynik „ogólny” jako średnia ośmiu skal nie jest częścią klucza.
Ogólną logikę przekodowania i średnich pokazuje poradnik jak policzyć wynik kwestionariusza. Pojedynczy wynik sprawdzisz w kalkulatorze wyniku skali.
Interpretacja i licencja
Wynik 0–100 to nie procent populacji. Strona RAND opisuje go jako odsetek maksymalnej możliwej liczby punktów w skali. Wynik 70 nie znaczy więc, że ktoś jest „zdrowszy niż 70% ludzi”. Taka interpretacja wymagałaby norm, których klucz RAND nie zawiera. Tabela 3 na stronie RAND podaje średnie i alfy z badania Medical Outcomes Study (N = 2471). To opis tamtej próby pacjentów, a nie norma dla Twojej grupy.
Progów nie ma. Sprawdzone źródła nie podają punktów odcięcia „złej jakości życia”. Analizuj wyniki jako zmienne ciągłe i porównuj grupy albo pomiary. Hays i Morales (2001) omawiają, jaka różnica w skalach RAND-36 jest klinicznie istotna. Liczb z tego artykułu nie przytaczamy, bo znamy tylko jego streszczenie. Ogólne zasady opisuje wpis RCI, MDC i MCID.
Licencja. Według oficjalnej strony RAND ankiety opracowane w RAND Health są dostępne publicznie. RAND nie pobiera opłat i nie wymaga zgody przy użyciu niekomercyjnym, a w sprawie użycia komercyjnego trzeba się skontaktować z RAND. Na tłumaczenie zgoda nie jest potrzebna, a przy użyciu należy podać cytowanie (RAND Corporation, b.d.-a). Warunki dodają, że zmiany w ankiecie trzeba wyraźnie oznaczyć jako własne. Przy drukowaniu trzeba też podać, że narzędzie opracowano w RAND w ramach Medical Outcomes Study (RAND Corporation, b.d.-c). Praca dyplomowa to użycie niekomercyjne. Licencjonowany SF-36 ma osobne warunki u swojego dystrybutora. Ogólnie o zgodach piszemy w haśle licencja narzędzia badawczego.
Polskiej wersji językowej nie opisujemy, bo nie zweryfikowaliśmy jej publikacji. Sprawdź, czy używana przez Ciebie wersja to RAND-36, czy SF-36, i podaj jej źródło. O tłumaczeniu przeczytasz we wpisie adaptacja kulturowa kwestionariusza.
Przykład: 320 pacjentów POZ
Dane są symulowane i możesz je pobrać jako plik CSV. Kolumny q1–q36 zawierają kody odpowiedzi tak, jak są wydrukowane w kwestionariuszu. W połowie próby są osoby z chorobą przewlekłą. W 30 komórkach są pojedyncze braki, a dwie osoby pominęły całą skalę ograniczeń z powodu zdrowia fizycznego. Te dwie osoby nie mają wyniku tej skali, a niepełne odpowiedzi w innych skalach dotyczyły od 0 do 7 osób.
| Skala | M (SD) | Me | % wyników 0 | % wyników 100 | α [95% CI] | ω |
|---|---|---|---|---|---|---|
| Funkcjonowanie fizyczne | 65.3 (30.3) | 70.0 | 3.1 | 20.3 | .93 [.91, .94] | .93 |
| Ograniczenia – zdrowie fizyczne | 65.3 (36.1) | 75.0 | 14.5 | 38.7 | .75 [.70, .79] | .75 |
| Ograniczenia – problemy emocjonalne | 74.4 (34.6) | 100.0 | 10.0 | 58.1 | .71 [.65, .76] | .71 |
| Energia/zmęczenie | 66.6 (26.0) | 70.0 | 0.0 | 11.2 | .84 [.81, .86] | .84 |
| Samopoczucie emocjonalne | 69.9 (25.5) | 76.0 | 0.6 | 13.8 | .86 [.84, .88] | .86 |
| Funkcjonowanie społeczne | 70.1 (28.2) | 75.0 | 3.4 | 27.5 | .74 [.67, .79] | – |
| Ból | 67.5 (29.6) | 77.5 | 3.4 | 22.8 | .73 [.66, .78] | – |
| Zdrowie ogólne | 64.6 (27.8) | 70.0 | 1.6 | 10.6 | .88 [.86, .90] | .88 |
Rzetelność i efekt sufitu
Rzetelność liczymy osobno dla każdej skali. Omegę podajemy tylko dla skal z co najmniej trzema pozycjami, bo model jednoczynnikowy dla dwóch pozycji nie jest identyfikowany. Alfa zakłada równe ładunki (McNeish, 2018), więc w skalach z trzema i więcej pozycjami warto podać obie miary (omega McDonalda).
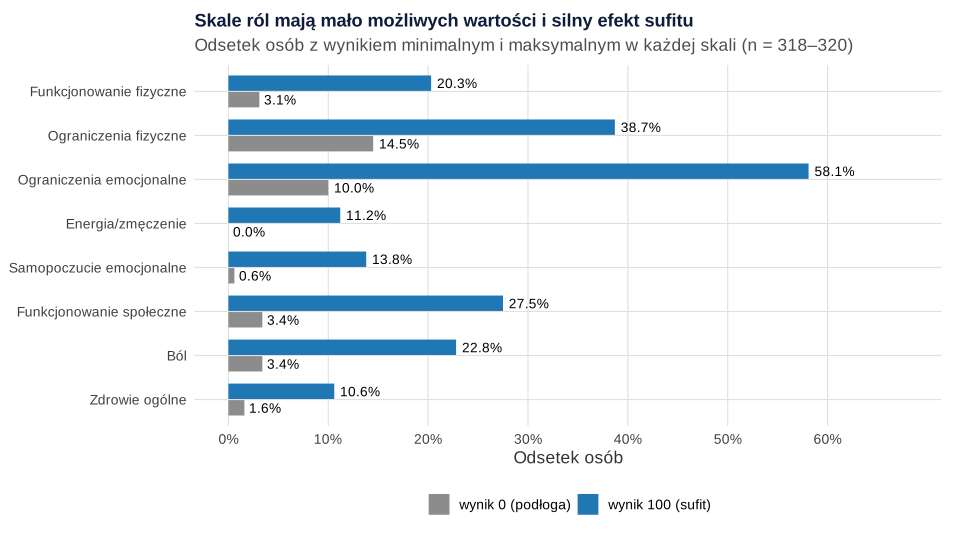
Skale ról mają tylko kilka możliwych wartości. Przy czterech pozycjach dwukategorialnych wynik może przyjąć pięć wartości. Ograniczenia z powodu problemów emocjonalnych miały aż 58.1% wyników 100 i medianę 100 (rysunek 1). To efekt sufitu: skala nie odróżnia osób w dobrym stanie, a rozkład jest daleki od normalnego. Opisuj wtedy także mediany i odsetki wyników skrajnych.
Choroba przewlekła a osiem skal
Każdą skalę porównaliśmy testem Welcha. Do d Cohena użyliśmy zbiorczego SD, a p skorygowaliśmy metodą Holma (1979) na osiem porównań.
| Skala | M bez | M z chorobą | Różnica [95% CI] | t (df) | d | p (Holm) |
|---|---|---|---|---|---|---|
| Funkcjonowanie fizyczne | 73.8 | 56.8 | −17.1 [−23.5, −10.7] | −5.25 (310.36) | −0.59 | < .001 |
| Ograniczenia – zdrowie fizyczne | 75.8 | 54.9 | −20.9 [−28.6, −13.3] | −5.39 (292.40) | −0.60 | < .001 |
| Ograniczenia – problemy emocjonalne | 81.9 | 67.0 | −14.9 [−22.3, −7.4] | −3.94 (306.14) | −0.44 | < .001 |
| Energia/zmęczenie | 72.9 | 60.4 | −12.5 [−18.1, −7.0] | −4.43 (303.15) | −0.50 | < .001 |
| Samopoczucie emocjonalne | 72.5 | 67.3 | −5.2 [−10.7, 0.4] | −1.82 (314.31) | −0.20 | .069 |
| Funkcjonowanie społeczne | 74.3 | 65.9 | −8.4 [−14.6, −2.3] | −2.71 (314.34) | −0.30 | .014 |
| Ból | 74.7 | 60.2 | −14.4 [−20.8, −8.1] | −4.48 (312.06) | −0.50 | < .001 |
| Zdrowie ogólne | 71.5 | 57.7 | −13.9 [−19.8, −7.9] | −4.60 (315.09) | −0.51 | < .001 |
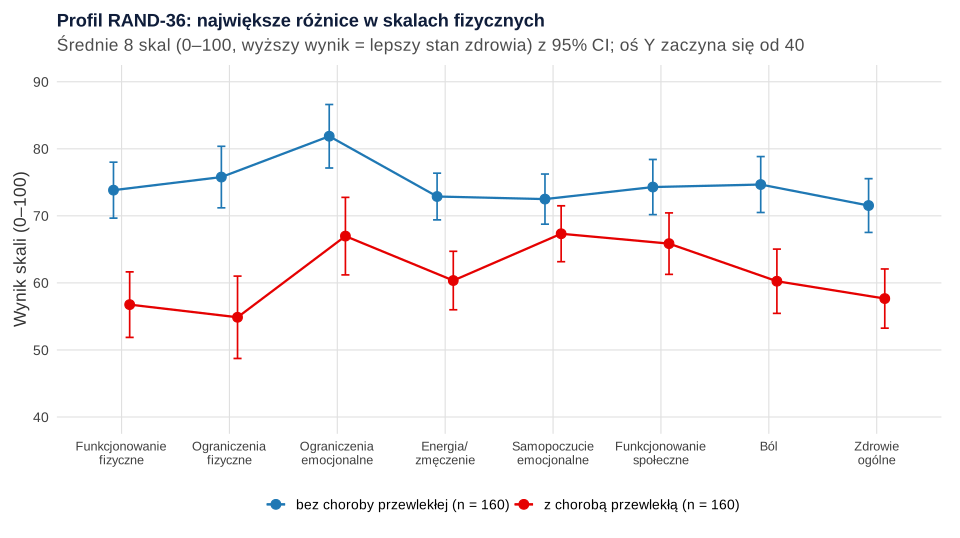
Osoby z chorobą przewlekłą miały niższe wyniki w siedmiu skalach. Największe różnice dotyczyły ograniczeń z powodu zdrowia fizycznego i funkcjonowania fizycznego, z d około −0.6 (rysunek 2). Samopoczucie emocjonalne różniło się najmniej i po korekcie Holma różnica nie była istotna. Pokazanie całego profilu mówi więcej niż jedna liczba. Widać, że choroba obniża głównie skale fizyczne, a wynik „średni ze wszystkich skal” by to ukrył. O poprawkach na wiele porównań przeczytasz we wpisie poprawki na wielokrotne porównania, a o wielkości efektu – w haśle d Cohena.
Pozycję 2 opisz osobno, jako rozkład odpowiedzi. W przykładzie najczęstszy był kod 3 (175 osób), a trzy osoby jej nie wypełniły.
Jak opisać RAND-36 w pracy
Wzory zawierają liczby z przykładu. W nawiasach kwadratowych uzupełnij dane swojej wersji.
Schemat opisu narzędzia znajdziesz w poradniku opis narzędzia badawczego – wzór, a zdania o testach przygotujesz w generatorze opisu wyników APA.
RAND-36 w R: klucz 0–100, osiem skal, rzetelność i porównanie grup
Kod odtwarza liczby z tekstu i zapisuje plik CSV. Klucz przekodowania i przydział pozycji do skal pochodzą z oficjalnej strony RAND. Wynik skali to średnia pozycji, na które odpowiedziano. Alfę z przedziałem Feldta liczy pakiet psych, a omegę – lavaan. Porównania grup korzystają z bazowego R.
Wynik krok po kroku
R
# B297 – RAND-36: przekodowanie 0–100 według klucza RAND, 8 skal, braki, rzetelność i porównanie grup
# (dane symulowane, set.seed(2971)). 320 dorosłych pacjentów poradni POZ: 160 z chorobą przewlekłą i 160 bez.
# Kolumny q1–q36 to odpowiedzi w kodach wydrukowanych w kwestionariuszu (1, 2, 3, …), numeracja pozycji jak
# w RAND 36-Item Health Survey 1.0. Klucz przekodowania i przydział pozycji do skal: tabele 1 i 2 z oficjalnej
# strony RAND (stan na 1 listopada 2026 r.). Treści pozycji nie podajemy. To NIE jest punktacja normowa SF-36
# (wyniki T) – nie liczymy też wyników sumarycznych zdrowia fizycznego i psychicznego.
suppressPackageStartupMessages({ library(psych); library(lavaan) })
set.seed(2971)
n <- 320
choroba <- rep(0:1, each = n / 2)                            # 1 = choroba przewlekła

# Klucz RAND (tabela 1): pozycje, liczba kategorii i kierunek (malejąco: kod 1 = 100; rosnąco: kod 1 = 0)
klucz <- data.frame(poz = 1:36, k = NA, malejaco = NA)
ustaw <- function(k, poz, kier, kl) { kl$k[poz] <- k; kl$malejaco[poz] <- kier; kl }
klucz <- ustaw(5, c(1, 2, 20, 22, 34, 36), TRUE, klucz)
klucz <- ustaw(3, 3:12, FALSE, klucz)
klucz <- ustaw(2, 13:19, FALSE, klucz)
klucz <- ustaw(6, c(21, 23, 26, 27, 30), TRUE, klucz)
klucz <- ustaw(6, c(24, 25, 28, 29, 31), FALSE, klucz)
klucz <- ustaw(5, c(32, 33, 35), FALSE, klucz)
# Skale (tabela 2); pozycja 2 (zmiana zdrowia w ciągu roku) nie wchodzi do żadnej skali
skale <- list(funkcjonowanie_fizyczne = 3:12, ograniczenia_fizyczne = 13:16, ograniczenia_emocjonalne = 17:19,
              energia_zmeczenie = c(23, 27, 29, 31), samopoczucie_emocjonalne = c(24, 25, 26, 28, 30),
              funkcjonowanie_spoleczne = c(20, 32), bol = c(21, 22), zdrowie_ogolne = c(1, 33, 34, 35, 36))

# Symulacja: dwie cechy ukryte (zdrowie fizyczne i psychiczne); choroba obniża głównie zdrowie fizyczne
fiz <- rnorm(n) - 0.80 * choroba
psy <- 0.35 * fiz + sqrt(1 - 0.35^2) * rnorm(n) + 0.05 * choroba
waga <- c(funkcjonowanie_fizyczne = 1, ograniczenia_fizyczne = .85, ograniczenia_emocjonalne = .25,
          energia_zmeczenie = .5, samopoczucie_emocjonalne = .15, funkcjonowanie_spoleczne = .45, bol = .8, zdrowie_ogolne = .75)
q <- matrix(NA, n, 36, dimnames = list(NULL, paste0("q", 1:36)))
for (s in names(skale)) {
  cecha <- waga[[s]] * fiz + (1 - waga[[s]]) * psy + rnorm(n, 0, .45)
  for (p in skale[[s]]) {
    k <- klucz$k[p]
    lepiej <- findInterval(0.8 * cecha + rnorm(n, 0, .6), qnorm(seq(0, 1, length.out = k + 1)[-c(1, k + 1)], -0.80, 1))
    q[, p] <- if (klucz$malejaco[p]) k - lepiej else lepiej + 1       # kod wydrukowany w kwestionariuszu
  }
}
q[, 2] <- sample(1:5, n, replace = TRUE, prob = c(.06, .17, .52, .19, .06))
braki <- cbind(sample(n, 30, replace = TRUE), sample(1:36, 30, replace = TRUE))
q[braki] <- NA
q[c(41, 207), 13:16] <- NA                                    # dwie osoby pominęły całą skalę
dane <- data.frame(id = 1:n, choroba, q)
write.csv(dane, "../rand-36-dane-przyklad.csv", row.names = FALSE, na = "")   # plik do pobrania

# Krok 1. Kontrola kodów: w każdej pozycji tylko 1…k albo brak
Q <- paste0("q", 1:36)
all(sapply(1:36, function(p) all(dane[[Q[p]]] %in% c(seq_len(klucz$k[p]), NA))))

# Krok 2. Przekodowanie na 0–100 (wyższy wynik = lepszy stan zdrowia) i porównanie z tabelą 1 RAND
przekoduj <- function(x, k, malejaco) if (malejaco) (k - x) / (k - 1) * 100 else (x - 1) / (k - 1) * 100
r100 <- sapply(1:36, function(p) przekoduj(dane[[Q[p]]], klucz$k[p], klucz$malejaco[p]))
colnames(r100) <- Q
rbind(kod = 1:6, k6_malejaco = przekoduj(1:6, 6, TRUE), k6_rosnaco = przekoduj(1:6, 6, FALSE))
rbind(kod = 1:5, k5_malejaco = przekoduj(1:5, 5, TRUE), k3_rosnaco = c(przekoduj(1:3, 3, FALSE), NA, NA))

# Krok 3. Wynik skali = średnia odpowiedzi, których udzielono (reguła RAND: braki pomijamy)
for (s in names(skale)) dane[[s]] <- rowMeans(r100[, skale[[s]], drop = FALSE], na.rm = TRUE)
dane[names(skale)][is.na(as.matrix(dane[names(skale)]))] <- NA   # NaN, gdy brak wszystkich pozycji skali
odp <- sapply(skale, function(p) rowSums(!is.na(r100[, p, drop = FALSE])))
rbind(brak_wyniku = colSums(odp == 0), niepelne = colSums(odp > 0 & sweep(odp, 2, lengths(skale), "<")),
      mniej_niz_polowa = colSums(odp > 0 & sweep(odp, 2, lengths(skale) / 2, "<")))

# Krok 4. Opis skal: średnia, SD, odsetek wyników 0 (podłoga) i 100 (sufit)
opis <- t(sapply(names(skale), function(s) { x <- na.omit(dane[[s]])
  round(c(n = length(x), M = mean(x), SD = sd(x), Me = median(x), proc_0 = 100 * mean(x == 0), proc_100 = 100 * mean(x == 100)), 1) }))
opis

# Krok 5. Rzetelność: alfa z 95% CI Feldta dla każdej skali; omega tylko dla skal z co najmniej 3 pozycjami
rzet <- t(sapply(names(skale), function(s) {
  d <- as.data.frame(r100[, skale[[s]]]); a <- psych::alpha(d, warnings = FALSE, check.keys = FALSE, max = 101)
  om <- NA
  if (ncol(d) >= 3) {
    f <- cfa(paste("F =~", paste(names(d), collapse = " + ")), data = d[rowSums(!is.na(d)) > 0, ], std.lv = TRUE, missing = "fiml")
    st <- standardizedSolution(f); lam <- st$est.std[st$op == "=~"]
    th <- st$est.std[st$op == "~~" & st$lhs == st$rhs & st$lhs %in% names(d)]
    om <- sum(lam)^2 / (sum(lam)^2 + sum(th))
  }
  round(c(pozycje = ncol(d), alfa = a$total$raw_alpha, lo = a$feldt$lower.ci[[1]], hi = a$feldt$upper.ci[[1]], omega = om), 2)
}))
rzet

# Krok 6. Choroba przewlekła a 8 skal: test Welcha, d Cohena i poprawka Holma na 8 porównań
porownanie <- t(sapply(names(skale), function(s) {
  x1 <- na.omit(dane[[s]][dane$choroba == 1]); x0 <- na.omit(dane[[s]][dane$choroba == 0])
  t <- t.test(x1, x0)
  sp <- sqrt(((length(x1) - 1) * var(x1) + (length(x0) - 1) * var(x0)) / (length(x1) + length(x0) - 2))
  c(M_bez = mean(x0), M_z = mean(x1), roznica = mean(x1) - mean(x0), lo = t$conf.int[1], hi = t$conf.int[2],
    t = unname(t$statistic), df = unname(t$parameter), d = (mean(x1) - mean(x0)) / sp, p = t$p.value)
}))
porownanie <- cbind(porownanie, p_Holm = p.adjust(porownanie[, "p"], "holm"))
round(porownanie[, c("M_bez", "M_z", "roznica", "lo", "hi")], 1)
round(porownanie[, c("t", "df", "d")], 2)
format.pval(porownanie[, "p_Holm"], digits = 2, eps = .001)

# Krok 7. Pozycja 2 (zmiana zdrowia w ciągu roku) – osobno, jako rozkład odpowiedzi w kodach 1–5
table(kod = dane$q2, useNA = "ifany")
Wynik w R
[1] TRUE
            [,1] [,2] [,3] [,4] [,5] [,6]
kod            1    2    3    4    5    6
k6_malejaco  100   80   60   40   20    0
k6_rosnaco     0   20   40   60   80  100
            [,1] [,2] [,3] [,4] [,5]
kod            1    2    3    4    5
k5_malejaco  100   75   50   25    0
k3_rosnaco     0   50  100   NA   NA
                 funkcjonowanie_fizyczne ograniczenia_fizyczne ograniczenia_emocjonalne
brak_wyniku                            0                     2                        0
niepelne                               6                     1                        2
mniej_niz_polowa                       0                     0                        0
                 energia_zmeczenie samopoczucie_emocjonalne funkcjonowanie_spoleczne bol
brak_wyniku                      0                        0                        0   0
niepelne                         7                        2                        0   5
mniej_niz_polowa                 0                        0                        0   0
                 zdrowie_ogolne
brak_wyniku                   0
niepelne                      4
mniej_niz_polowa              0
                           n    M   SD    Me proc_0 proc_100
funkcjonowanie_fizyczne  320 65.3 30.3  70.0    3.1     20.3
ograniczenia_fizyczne    318 65.3 36.1  75.0   14.5     38.7
ograniczenia_emocjonalne 320 74.4 34.6 100.0   10.0     58.1
energia_zmeczenie        320 66.6 26.0  70.0    0.0     11.2
samopoczucie_emocjonalne 320 69.9 25.5  76.0    0.6     13.8
funkcjonowanie_spoleczne 320 70.1 28.2  75.0    3.4     27.5
bol                      320 67.5 29.6  77.5    3.4     22.8
zdrowie_ogolne           320 64.6 27.8  70.0    1.6     10.6
                         pozycje alfa   lo   hi omega
funkcjonowanie_fizyczne       10 0.93 0.91 0.94  0.93
ograniczenia_fizyczne          4 0.75 0.70 0.79  0.75
ograniczenia_emocjonalne       3 0.71 0.65 0.76  0.71
energia_zmeczenie              4 0.84 0.81 0.86  0.84
samopoczucie_emocjonalne       5 0.86 0.84 0.88  0.86
funkcjonowanie_spoleczne       2 0.74 0.67 0.79    NA
bol                            2 0.73 0.66 0.78    NA
zdrowie_ogolne                 5 0.88 0.86 0.90  0.88
                         M_bez  M_z roznica    lo    hi
funkcjonowanie_fizyczne   73.8 56.8   -17.1 -23.5 -10.7
ograniczenia_fizyczne     75.8 54.9   -20.9 -28.6 -13.3
ograniczenia_emocjonalne  81.9 67.0   -14.9 -22.3  -7.4
energia_zmeczenie         72.9 60.4   -12.5 -18.1  -7.0
samopoczucie_emocjonalne  72.5 67.3    -5.2 -10.7   0.4
funkcjonowanie_spoleczne  74.3 65.9    -8.4 -14.6  -2.3
bol                       74.7 60.2   -14.4 -20.8  -8.1
zdrowie_ogolne            71.5 57.7   -13.9 -19.8  -7.9
                             t     df     d
funkcjonowanie_fizyczne  -5.25 310.36 -0.59
ograniczenia_fizyczne    -5.39 292.40 -0.60
ograniczenia_emocjonalne -3.94 306.14 -0.44
energia_zmeczenie        -4.43 303.15 -0.50
samopoczucie_emocjonalne -1.82 314.31 -0.20
funkcjonowanie_spoleczne -2.71 314.34 -0.30
bol                      -4.48 312.06 -0.50
zdrowie_ogolne           -4.60 315.09 -0.51
[1] "<0.001" "<0.001" "<0.001" "<0.001" "0.069"  "0.014"  "<0.001" "<0.001"
kod
   1    2    3    4    5 <NA>
  21   51  175   48   22    3
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy RAND-36
- Mieszanie punktacji. Wynik liczony kluczem RAND nazywaj RAND-36. Nie opisuj go jako „SF-36 z wynikami normowymi”.
- PCS i MCS z przypadkowych wag. Wyniki sumaryczne wymagają wag i norm z określonej populacji. Bez źródła ich nie licz.
- Sumowanie kodów zamiast przekodowania. Kody mają różną liczbę stopni i różny kierunek. Bez kroku 1 skale tracą sens.
- Pozycja 2 w skali zdrowia ogólnego. Zdrowie ogólne tworzą pozycje 1, 33, 34, 35 i 36. Pozycja o zmianie zdrowia stoi osobno.
- Jedna alfa dla 36 pozycji. Rzetelność podaj osobno dla każdej skali.
- Same średnie przy efekcie sufitu. W skalach ról podaj też mediany i odsetek wyników 100.
- Norma z tabeli MOS. Średnie z Medical Outcomes Study nie są normą dla Twojej próby.
Całą ścieżkę od kodowania po rzetelność porządkuje przewodnik po analizie kwestionariusza, a inne narzędzia znajdziesz w katalogu narzędzi badawczych. Jeśli chcesz, żeby ktoś sprawdził klucz i analizę RAND-36 w Twojej bazie, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Jak policzyć wynik RAND-36?
W dwóch krokach według klucza z oficjalnej strony RAND. Najpierw każdą odpowiedź przekoduj na wartość 0–100, tak aby wyższy wynik oznaczał lepszy stan zdrowia. Potem uśrednij przekodowane pozycje każdej z ośmiu skal. Brakujące pozycje pomija się, więc wynik skali to średnia odpowiedzi, których osoba udzieliła.
Czym RAND-36 różni się od SF-36?
Pozycje są te same, różni się punktacja. RAND-36 daje osiem skal 0–100 liczonych jako średnie przekodowanych pozycji. SF-36 jako znak towarowy ma własny algorytm, a w zastosowaniach normowych także wyniki T i wyniki sumaryczne zdrowia fizycznego i psychicznego, które wymagają wag i norm populacyjnych. Jeśli liczysz kluczem RAND, nazywaj narzędzie RAND-36.
Czy z RAND-36 można policzyć PCS i MCS?
Nie samym kluczem RAND. Wyniki sumaryczne zdrowia fizycznego i psychicznego wymagają wag z analizy czynnikowej oraz średnich i odchyleń z populacji odniesienia. Hays i Morales (2001) omawiają takie wyniki, ale w tym wpisie nie podajemy wag. Jeśli ich potrzebujesz, weź je z publikacji źródłowej i opisz wersję.
Czy RAND-36 wymaga licencji lub zgody autorów?
Według oficjalnej strony RAND ankiety RAND Health są dostępne publicznie, a RAND nie pobiera opłat i nie wymaga zgody przy użyciu niekomercyjnym (stan na 1 listopada 2026 r.). Przy użyciu komercyjnym trzeba się skontaktować z RAND. Zmiany w ankiecie trzeba wyraźnie oznaczyć, a przy druku podać, że narzędzie opracowano w RAND.
Jaki wynik RAND-36 oznacza złą jakość życia?
Klucz RAND nie podaje progów ani norm. Wynik 0–100 to odsetek maksymalnej liczby punktów w skali, a nie pozycja na tle populacji. Analizuj wyniki jako zmienne ciągłe, porównuj grupy lub pomiary i podawaj odsetek wyników skrajnych, bo skale ról mają silny efekt sufitu.
Powiązane hasła
Przeczytaj też
WHOQOL-BREF – jak policzyć wynik
Cztery domeny, pozycje odwrócone, średnia × 4, przeliczenie na 0–100 i reguły braków według WHO – z przykładem w R i wzorem opisu w pracy.
Czytaj →PoradnikEQ-5D – jak analizować wynik
Profil, EQ VAS i indeks z zestawu wartości, rejestracja w EuroQol, odsetki problemów, klasyfikacja Pareto i suma poziomów – z przykładem przed i po zabiegu w R.
Czytaj →PoradnikJak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikStatystyka w pracy ze zdrowia publicznego
Chorobowość z CI, iloraz szans a iloraz chorobowości, standaryzacja względem wieku, ważenie próby i trend z rejestrów: analizy, APA i kod R.
Czytaj →Liczysz RAND-36 i nie wiesz, czy klucz i analiza są poprawne?
Sprawdzimy kody odpowiedzi, przekodowanie na 0–100, braki danych, rzetelność skal i porównania grup, a potem wyjaśnimy analizę tak, żebyś umiał(a) samodzielnie ją opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Hays, R. D., & Morales, L. S. (2001). The RAND-36 measure of health-related quality of life. Annals of Medicine, 33(5), 350–357. https://doi.org/10.3109/07853890109002089 ● Otwarty dostęp
- Hays, R. D., Sherbourne, C. D., & Mazel, R. M. (1993). The RAND 36-Item Health Survey 1.0. Health Economics, 2(3), 217–227. https://doi.org/10.1002/hec.4730020305
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- RAND Corporation. (b.d.-a). 36-Item Short Form Survey (SF-36). RAND Health Care. https://www.rand.org/health-care/surveys_tools/mos/36-item-short-form.html ● Otwarty dostęp
- RAND Corporation. (b.d.-b). 36-Item Short Form Survey (SF-36) scoring instructions. RAND Health Care. https://www.rand.org/health-care/surveys_tools/mos/36-item-short-form/scoring.html ● Otwarty dostęp
- RAND Corporation. (b.d.-c). Terms and conditions for using the 36-Item Short Form Survey (SF-36). RAND Health Care. https://www.rand.org/health-care/surveys_tools/mos/36-item-short-form/terms.html ● Otwarty dostęp
- Ware, J. E., & Sherbourne, C. D. (1992). The MOS 36-item Short-Form Health Survey (SF-36): I. Conceptual framework and item selection. Medical Care, 30(6), 473–483. https://doi.org/10.1097/00005650-199206000-00002
Cytowania BibTeX
@article{hays2001rand, author={Hays, Ron D. and Morales, Leo S.}, title={{The RAND-36 measure of health-related quality of life}}, journal={Annals of Medicine}, year={2001}, volume={33}, number={5}, pages={350--357}, doi={10.3109/07853890109002089}}@article{hays1993rand, author={Hays, Ron D. and Sherbourne, Cathy Donald and Mazel, Rebecca M.}, title={{The RAND 36-Item Health Survey 1.0}}, journal={Health Economics}, year={1993}, volume={2}, number={3}, pages={217--227}, doi={10.1002/hec.4730020305}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@misc{randsf36web, author={{RAND Corporation}}, title={{36-Item Short Form Survey (SF-36)}}, howpublished={RAND Health Care}, year={b.d.-a}, publisher={RAND Corporation}, url={https://www.rand.org/health-care/surveys_tools/mos/36-item-short-form.html}}@misc{randsf36scoring, author={{RAND Corporation}}, title={{36-Item Short Form Survey (SF-36) scoring instructions}}, howpublished={RAND Health Care}, year={b.d.-b}, publisher={RAND Corporation}, url={https://www.rand.org/health-care/surveys_tools/mos/36-item-short-form/scoring.html}}@misc{randsf36terms, author={{RAND Corporation}}, title={{Terms and conditions for using the 36-Item Short Form Survey (SF-36)}}, howpublished={RAND Health Care}, year={b.d.-c}, publisher={RAND Corporation}, url={https://www.rand.org/health-care/surveys_tools/mos/36-item-short-form/terms.html}}@article{ware1992mos, author={Ware, John E. and Sherbourne, Cathy Donald}, title={{The MOS 36-item Short-Form Health Survey (SF-36): I. Conceptual framework and item selection}}, journal={Medical Care}, year={1992}, volume={30}, number={6}, pages={473--483}, doi={10.1097/00005650-199206000-00002}}