Trzy kolumny w pliku i kilka decyzji, których nikt nie zapisał
W pliku masz wzrost, masę ciała i wynik, który chcesz wyjaśnić. Dzielisz masę przez kwadrat wzrostu, tniesz wynik na „niedowagę, normę, nadwagę, otyłość” i robisz test chi-kwadrat. W kilka minut tracisz większość informacji, a promotor pyta, skąd masz progi, dlaczego w tabeli jest wzrost 1.72 i ile osób podało masę „na oko”.
Ten wpis dotyczy BMI i innych pomiarów ciała jako zmiennych w analizie: kiedy zostawić liczbę, kiedy użyć kategorii, jak pokazać zależność w kształcie litery J, co zmienia samoopis i co zrobić z brakami oraz wpisami niemożliwymi. Nie opisuje oceny stanu odżywienia pacjenta i nie daje zaleceń zdrowotnych. Przykłady projektów z dietetyki są we wpisie statystyka w pracy z dietetyki, a BMI jako składnik narzędzia przesiewowego opisuje wpis o skali MUST.
Przykład przewodni (dane symulowane). Badanie obejmuje 900 dorosłych w wieku 25–74 lat. Każda osoba podała wzrost i masę w ankiecie, a potem zmierzono ją, ankieter przepisał wyniki z karty i zmierzył obwód talii. Wynik to co najmniej jedna hospitalizacja w ciągu 3 lat (tak/nie). Kształt zależności i błędy wpisów ustawiliśmy w symulacji, więc liczby ilustrują metodę i nie mówią nic o żadnej populacji. Dane do ćwiczeń są w pliku bmi-pomiary-surowe.csv.
BMI to zmienna pochodna
BMI jest zmienną pochodną policzoną z dwóch pomiarów. Wynikają z tego trzy praktyczne konsekwencje. W bazie trzymaj wzrost i masę, a BMI licz skryptem, bo każdy błąd we wzroście wchodzi do BMI w kwadracie. Brak jednego składnika oznacza brak BMI. A ta sama wartość może opisywać osoby o bardzo różnej budowie ciała, bo wskaźnik nie rozróżnia, z czego składa się masa.
WHO podaje dla dorosłych progi 25 (nadwaga) i 30 (otyłość), a w swoich wskaźnikach zdrowotnych używa też granicy 18.5 dla niedowagi (World Health Organization, 2026, b.d.). W przykładzie używamy więc czterech grup:
| BMI (kg/m²) | Nazwa w przykładzie | n | % |
|---|---|---|---|
| < 18.5 | niedowaga | 11 | 1.3 |
| 18.5–< 25 | grupa odniesienia | 314 | 36.6 |
| 25–< 30 | nadwaga | 345 | 40.3 |
| ≥ 30 | otyłość | 187 | 21.8 |
Zapisz w metodach, czy granica należy do grupy wyższej. W kodzie służy do tego right = FALSE. Progi cytuj z konkretnego dokumentu, z którego je bierzesz. Jeśli promotor albo Twoja dziedzina używa innych progów lub dalszego podziału otyłości, podaj źródło tego podziału, a nie ogólne „według norm”.
Rozkład BMI: średnia, mediana czy obie
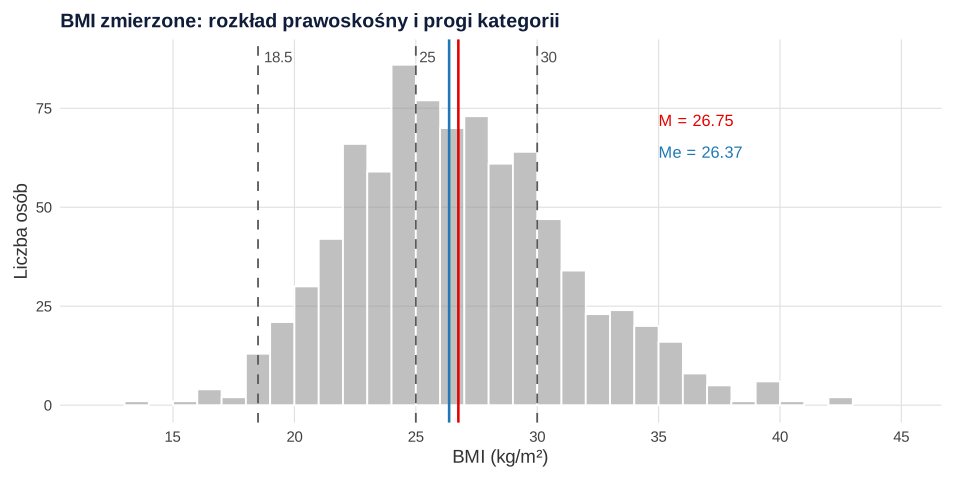
W tej próbie BMI ma M = 26.75, SD = 4.46, Me = 26.37, kwartyle 23.58 i 29.55, a skośność wynosi 0.41. Skośność jest wyraźniejsza u mężczyzn (0.51) niż u kobiet (0.29). To typowy obraz umiarkowanie prawoskośny: średnia jest tylko o 0.38 wyższa od mediany, a obie miary mówią niemal to samo.
Dlatego przy opisie BMI nie trzeba wybierać na siłę. Przy umiarkowanej skośności podaj M i SD oraz medianę z rozstępem ćwiartkowym. W próbie klinicznej z długim ogonem lub przy kilku skrajnych wartościach na pierwszym miejscu postaw medianę. Zawsze opisuj osobno kobiety i mężczyzn, jeśli płeć jest ważna dla pytania, a układ tabeli weź z wpisu o Tabeli 1. Skośność samego predyktora nie jest powodem do transformacji: w regresji znaczenie ma funkcyjna postać związku, a nie rozkład BMI.
Kategorie do opisu, liczba do analizy
Kategorie są potrzebne: czytelnik chce wiedzieć, jaki odsetek próby przekracza próg (tu BMI ≥ 30 ma 21.8% osób, 95% CI [19.2, 24.7], przedział Wilsona). Problem zaczyna się, gdy kategorie stają się jedyną postacią zmiennej w modelu.
Podział zmiennej ciągłej zakłada, że wszyscy w grupie mają to samo ryzyko, a na granicy następuje skok. BMI 24.9 i 25.1 trafiają do różnych grup, a 30 i 41 – do tej samej. To ten sam mechanizm, który opisuje hasło dzielenie medianą, tyle że progi są narzucone z zewnątrz. Bennette i Vickers (2012) krytykują dzielenie zmiennych ciągłych na grupy kwantylowe w epidemiologii i wskazują alternatywy. Progi WHO nie są kwantylami próby, ale nie usuwają utraty informacji.
Praktyczny podział ról: w Tabeli 1 podaj kategorie i BMI ciągłe, w modelu użyj BMI jako liczby, z elastycznym kształtem, jeśli związek może nie być prostą. Model kategorii zostaw jako analizę dodatkową, gdy pytanie badawcze dotyczy właśnie progów albo gdy czasopismo lub promotor tego oczekuje. Podział ustal przed analizą.
Zależność w kształcie J: linia, schodki czy splajn
Związek BMI z wynikami zdrowotnymi często nie jest prostą. Aune i in. (2016) w metaanalizie 230 badań kohortowych opisali zależność BMI ze śmiertelnością ogólną w kształcie litery J u osób nigdy niepalących, a w kształcie U w analizach bardziej narażonych na obciążenie, m.in. obejmujących palaczy lub z krótką obserwacją. Dwa wnioski dla pracy: kształt krzywej trzeba sprawdzać, a jego interpretacja zależy od zakłócaczy. Niskie BMI bywa skutkiem choroby, a nie jej przyczyną.
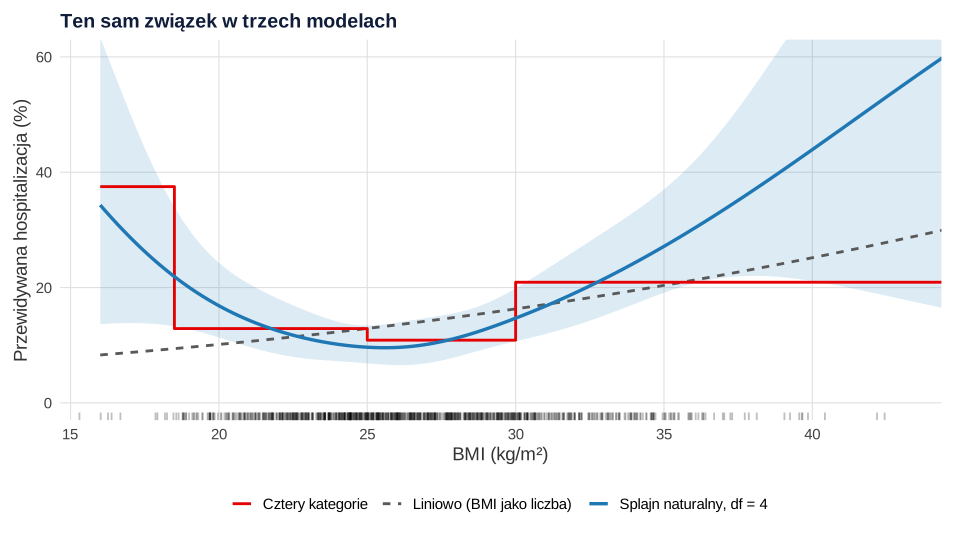
W przykładzie ten sam związek opisują trzy modele logistyczne skorygowane o płeć i wiek (N = 857, 128 hospitalizacji, 14.9%). Trzeci używa naturalnego splajnu sześciennego splines::ns(bmi, df = 4), czyli gładkiej krzywej złożonej z kawałków, z węzłami przy 23.6, 26.4 i 29.5 kg/m² i liniowymi końcami. Więcej o splajnach i modelach GAM jest we wpisie o zależnościach nieliniowych. Prostszą alternatywą są wielomian i wielomiany ułamkowe.
| BMI | Liniowo (%) | Kategorie (%) | Splajn (%) | 95% CI splajnu |
|---|---|---|---|---|
| 17 | 8.7 | 37.5 | 28.7 | [13.8, 50.3] |
| 24 | 12.3 | 12.9 | 10.2 | [7.2, 14.1] |
| 30 | 16.3 | 20.9 | 14.7 | [10.7, 19.9] |
| 34 | 19.5 | 20.9 | 24.2 | [17.1, 33.1] |
| 38 | 23.2 | 20.9 | 36.8 | [22.0, 54.6] |
| 42 | 27.3 | 20.9 | 51.2 | [19.1, 82.3] |
Model liniowy daje poprawnie wyglądający wynik: OR na 5 kg/m² = 1.31, 95% CI [1.06, 1.62], p = .011. Przeczytany dosłownie mówi jednak, że najniższe BMI wiąże się z najmniejszym ryzykiem, a tego w danych nie ma. Model kategorii widzi wzrost po obu stronach, ale grupa niedowagi liczy 11 osób (OR = 4.06, 95% CI [1.17, 14.13]). Otyłość to jedna liczba (OR = 1.79, 95% CI [1.10, 2.91]), choć według splajnu różnica między BMI 38 a 31 sięga OR = 2.89, 95% CI [1.31, 6.41]. Po stronie niskich wartości BMI 18 względem 24 daje OR = 2.79, 95% CI [1.28, 6.08].
Do porównania modeli służą AIC (706.6 dla modelu liniowego, 703.0 dla kategorii, 695.4 dla splajnu) i test ilorazu wiarygodności splajnu względem prostej: χ²(3) = 17.16, p < .001. Splajny pozwalają opisać kształt zależności, sprawdzić założenie liniowości i ograniczyć resztkowe zakłócenie przy korygowaniu o zmienną ciągłą (Desquilbet i Mariotti, 2010).
Dwie przestrogi. Liczbę stopni swobody ustal z góry i pokaż wrażliwość: przy df = 3, 4 i 5 AIC wyniosło 693.6, 695.4 i 696.6, więc wniosek się nie zmienia. Wynik może jednak zależeć od tych ustawień bardziej niż od rodzaju funkcji (Perperoglou i in., 2019). Nie interpretuj też minimum krzywej jak progu: tutaj wypadło przy 25.6, choć w symulacji ustawiliśmy je na 24, a przy BMI 42 przedział 95% CI to [19.1, 82.3]%.
Pomiar czy deklaracja
Connor Gorber i in. (2007) w przeglądzie systematycznym 64 prac porównujących dane deklarowane ze zmierzonymi opisują tendencję do zaniżania masy i BMI oraz zawyżania wzrostu. Skala tego zjawiska różni się między kobietami i mężczyznami oraz zależy od badanej populacji, a zmienność indywidualna jest duża. W ankiecie internetowej samoopis jest zwykle jedyną opcją, więc to nie błąd, ale ograniczenie, które trzeba nazwać.
W przykładzie mamy obie wersje u 794 osób. Deklarowany wzrost jest średnio o 0.89 cm wyższy, masa o 1.22 kg niższa, a BMI o 0.69 kg/m² niższe (SD różnic 0.93). Korelacja BMI deklarowanego i zmierzonego wynosi r = .978, ale wysoka korelacja nie oznacza zgodności, dlatego potrzebny jest wykres Blanda–Altmana.
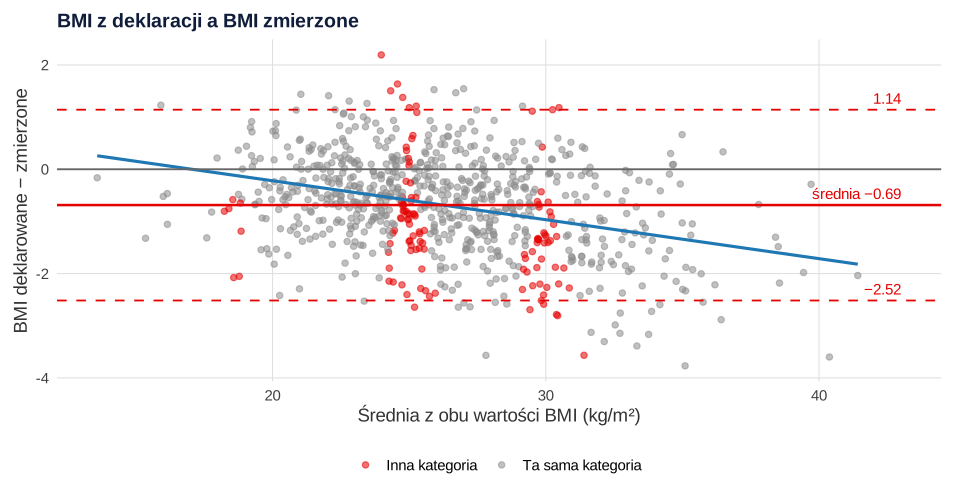
Granice zgodności to −2.52 i 1.14 kg/m². Różnica rośnie wraz z BMI (−0.30 w dolnej tercji, −0.61 w środkowej, −1.15 w górnej), co w tym przykładzie jest założeniem symulacji. Masa kończy się na 0 lub 5 w 43.2% deklaracji i w 19.3% pomiarów po zaokrągleniu. Dla analizy ważne jest przesunięcie między kategoriami:
| Zmierzone \ deklarowane | < 18.5 | 18.5–< 25 | 25–< 30 | ≥ 30 |
|---|---|---|---|---|
| < 18.5 | 9 | 0 | 0 | 0 |
| 18.5–< 25 | 7 | 281 | 14 | 0 |
| 25–< 30 | 0 | 52 | 262 | 4 |
| ≥ 30 | 0 | 0 | 42 | 123 |
W tej samej kategorii pozostaje 85.0% osób. Spośród 165 osób z BMI zmierzonym ≥ 30 aż 42 deklarują wartość poniżej progu, więc odsetek spada z 20.8% do 16.0%. OR dla BMI ≥ 30 względem grupy odniesienia wynosi 1.53, 95% CI [0.91, 2.56] dla pomiaru i 1.81, 95% CI [1.05, 3.13] dla deklaracji. Różnica między nimi nie jest regułą, ale pokazuje, że kategorie z samoopisu mogą zmienić wniosek. Jeśli możesz, zmierz podpróbę i pokaż zgodność. Ogólnie o skutkach błędu pomiaru w regresji piszemy osobno.
Także pomiar ma błąd. Ulijaszek i Kerr (1999) omawiają jego ocenę na podstawie pomiarów powtórzonych, m.in. przez techniczny błąd pomiaru i współczynnik rzetelności. W pracy podaj, kto mierzył, jakim sprzętem, w jakim ubraniu i czy powtarzano pomiar.
Brak wzrostu albo masy
Pomiar nie powiódł się u 14 osób dla wzrostu i 30 dla masy, a u jednej dla obu parametrów, więc BMI ma braki u 43 osób. Podawaj braki składników, a nie tylko braki BMI, bo osoba bez wzrostu nie ma BMI, choć jej masa jest znana.
Deklarowanej masy nie podało 46 osób (5.1%). Dzięki pomiarom widać, kim są: mają BMI średnio 29.79, a pozostałe 26.58, różnica 3.20 kg/m², 95% CI [1.72, 4.68], p < .001. W prawdziwej ankiecie tego nie zobaczysz, więc nie zakładaj, że odmowa podania masy jest losowa (patrz mechanizmy braków danych). Tu odsetek BMI ≥ 30 wśród podających masę wynosi 20.7%, a wśród wszystkich z pomiarem 21.8%.
Porównaj osoby z brakiem i bez braku pod względem wieku, płci i wyniku. Gdy braków jest więcej, rozważ imputację wielokrotną, ustalając przed analizą, czy imputujesz wzrost i masę, a BMI liczysz po imputacji, czy imputujesz BMI wprost. Nie wstawiaj średniej próby w miejsce brakującej masy.
Wartości niemożliwe
Wzrost i masa to pola, w których błędy są przewidywalne. Reguły zapisz przed otwarciem danych i prowadź dziennik zmian, jak we wpisie reguły kontroli danych. W przykładzie zakresy to 130–210 cm i 30–200 kg. To reguły kontroli przyjęte dla tego zbioru, a nie normy medyczne.
- Jednostka: 9 wzrostów w metrach (1.72). Korekta jest jednoznaczna: mnożysz przez 100.
- Zapis: 6 wpisów z przecinkiem dziesiętnym, które R czytałby jako tekst.
- Zamiana kolumn: 3 wiersze, np. wzrost 54.6 i masa 152.9. Sprawdź kartę, jeśli ją masz; w skrypcie zamiana jest regułą, którą trzeba odnotować.
- Poza zakresem: 2 masy (699 i 846) i 1 wzrost (17). Nie zgaduj, gdzie brakuje kropki: wróć do karty albo wpisz brak.
Po czyszczeniu BMI mieści się w zakresie 13.7–42.4 kg/m². Skrajne, ale możliwe wartości zostawiasz, a ich wpływ sprawdzasz analizą wrażliwości, zgodnie z zasadami z wpisu o wartościach odstających.
Obwód talii i WHtR
WHO zaznacza, że nadwagę lub otyłość można oceniać także innymi miarami, np. obwodem talii (World Health Organization, 2026). Talia daje informację, której BMI nie ma. W przykładzie u osób z BMI 24–< 26 (n = 157) obwód waha się od 69.0 do 109.4 cm, a średnia to 83.9 cm u kobiet i 93.2 cm u mężczyzn. Dlatego talię zawsze analizuj z uwzględnieniem płci. Opisz też miejsce pomiaru, bo różne protokoły używają różnych punktów na ciele.
WHtR to obwód talii podzielony przez wzrost (tu średnio 0.530 u kobiet i 0.557 u mężczyzn). Ashwell i in. (2012) w metaanalizie 31 prac opartych na krzywych ROC raportują lepszą dyskryminację czynników ryzyka kardiometabolicznego przez WHtR niż przez BMI i obwód talii. To wynik dotyczący przesiewu, a nie dowód, że WHtR będzie lepszym predyktorem w Twoim badaniu.
BMI i talia silnie się ze sobą wiążą (r = .861 u kobiet i .876 u mężczyzn; BMI z WHtR: .827 i .848). Wpisane razem do modelu dają współliniowość (VIF dla BMI 4.42) i współczynniki trudne do interpretacji, bo pytają o różnicę BMI przy stałej talii. Wybierz miarę przed analizą, zgodnie z pytaniem badawczym. Jeśli porównujesz kilka miar, potraktuj to jako analizę drugorzędną.
Dzieci i młodzież
Progów dla dorosłych nie stosuje się u dzieci. WHO opisuje dla 5–19 lat BMI względem wieku, odniesione do mediany referencyjnej, a poniżej 5 lat masę względem wzrostu (World Health Organization, 2026). Stosuje się tu siatki centylowe, czyli percentyle liczone dla wieku i płci. W pracy o dzieciach podaj, jakiej siatki użyto i jak przeliczono wynik.
Jak opisać to w pracy
Opis do metod:
Opis wyniku:
Model obserwacyjny nie uprawnia do wniosku, że BMI powoduje hospitalizację. Pamiętaj też o zdaniu o źródle danych: „BMI obliczono na podstawie wzrostu i masy deklarowanych przez uczestników, co mogło prowadzić do zaniżenia odsetka osób z BMI ≥ 30”.
Najczęstsze błędy
- Kategorie jako jedyna postać BMI w testach, gdy pytanie nie dotyczy progów.
- Prosta linia bez sprawdzenia kształtu, czyli wniosek „im wyższe, tym gorzej” przy zależności w kształcie J.
- Interpretowanie minimum krzywej jako progu albo końców krzywej, gdzie jest po kilka obserwacji.
- Bardzo mała grupa niedowagi jako osobna kategoria w modelu, bez pokazania n i szerokości przedziału.
- Deklaracje opisane jak pomiar i brak zdania o możliwym zaniżeniu masy.
- Progi „według norm” bez źródła; progi dla dorosłych użyte u dzieci.
- BMI wpisane ręcznie w arkuszu zamiast liczone z oryginalnych wzrostu i masy.
- Korelacja jako dowód zgodności samoopisu z pomiarem.
- BMI i talia razem w modelu z interpretacją współczynników, jakby były niezależne.
BMI, kategorie i splajn w R: kod i wynik
Jeden skrypt liczy wszystkie liczby z tekstu. Tworzy surowe dane z błędami, zapisuje je w folderze nadrzędnym (../), czyści wzrost i masę, opisuje rozkład, dopasowuje trzy modele, porównuje deklaracje z pomiarem, sprawdza braki i liczy miary talii. Rysunki powstały w osobnym skrypcie z tych samych danych. Dane do pobrania: bmi-pomiary-surowe.csv.
Od surowych wpisów do krzywej BMI
R
# B453 – BMI i pomiary antropometryczne jako zmienne
# Dane symulowane: 900 dorosłych, wzrost i masa deklarowane oraz zmierzone,
# obwód talii i hospitalizacja w ciągu 3 lat (tak/nie).
# Kształt związku BMI z wynikiem i błędy wpisów są założeniami symulacji.
library(splines)
pv <- function(p) if (p < .001) "p < .001" else paste0("p = ", sub("^0", "", sprintf("%.3f", p)))

# ---- 1. Symulacja i zapis surowego pliku ----
set.seed(453)
n <- 900
plec <- ifelse(runif(n) < .58, "K", "M")
wiek <- round(runif(n, 25, 74))
wzrost <- ifelse(plec == "K", rnorm(n, 164, 6.3), rnorm(n, 177.5, 6.8))
bmi_p <- exp(rnorm(n, log(26.2) + .02 * (plec == "M"), .17))      # rozkład prawoskośny
masa <- bmi_p * (wzrost / 100)^2
talia <- 26 + 2.3 * bmi_p + 10 * (plec == "M") + .1 * (wiek - 50) + rnorm(n, 0, 5.5)

krzywa <- ifelse(bmi_p < 24, .035 * (24 - bmi_p)^2, .0065 * (bmi_p - 24)^2)
hosp <- rbinom(n, 1, plogis(-2.0 + krzywa + .025 * (wiek - 50) + .1 * (plec == "M")))

# deklaracje: wzrost lekko zawyżany, masa zaniżana tym bardziej, im wyższe BMI; zaokrąglanie
wzrost_d <- round(wzrost + rnorm(n, .9, 1.5))
masa_d <- masa * (1 - .01 - .0025 * (bmi_p - 25)) + rnorm(n, 0, 1.8)
masa_d <- ifelse(runif(n) < .30, 5 * round(masa_d / 5), round(masa_d))

# braki: masę częściej pomijają osoby z wyższym BMI
masa_d[runif(n) < plogis(-3.2 + .12 * (bmi_p - 26))] <- NA
wzrost_d[runif(n) < .02] <- NA
wz_txt <- sprintf("%.1f", wzrost); ma_txt <- sprintf("%.1f", masa)
ta_txt <- sprintf("%.1f", talia)
wz_txt[runif(n) < .02] <- ""; ma_txt[runif(n) < .03] <- ""; ta_txt[runif(n) < .04] <- ""

# błędy przepisywania z kart pomiarowych
wybrane <- sample(which(wz_txt != "" & ma_txt != ""), 21)
metry <- wybrane[1:9];  przecinek <- wybrane[10:15]
zamiana <- wybrane[16:18]; bez_kropki <- wybrane[19:20]; literowka <- wybrane[21]
wz_txt[metry] <- sprintf("%.2f", wzrost[metry] / 100)
wz_txt[przecinek] <- sub(".", ",", wz_txt[przecinek], fixed = TRUE)
tmp <- wz_txt[zamiana]; wz_txt[zamiana] <- ma_txt[zamiana]; ma_txt[zamiana] <- tmp
ma_txt[bez_kropki] <- sprintf("%.0f", masa[bez_kropki] * 10)
wz_txt[literowka] <- sprintf("%.0f", wzrost[literowka] / 10)

surowe <- data.frame(id = sprintf("R%03d", 1:n), plec, wiek,
                     wzrost_zm = wz_txt, masa_zm = ma_txt, talia_zm = ta_txt,
                     wzrost_dekl = wzrost_d, masa_dekl = masa_d,
                     hospitalizacja = hosp)
write.csv(surowe, "../bmi-pomiary-surowe.csv", row.names = FALSE, na = "")

# ---- 2. Czyszczenie wzrostu i masy ----
d <- read.csv("../bmi-pomiary-surowe.csv", colClasses = c(wzrost_zm = "character",
              masa_zm = "character", talia_zm = "character"))
liczba <- function(x) as.numeric(sub(",", ".", x, fixed = TRUE))
d$wz <- liczba(d$wzrost_zm); d$ma <- liczba(d$masa_zm); d$talia <- liczba(d$talia_zm)
cat("Wpisy z przecinkiem we wzroście:", sum(grepl(",", d$wzrost_zm)), "\n")

r_metry <- which(d$wz < 3)                       # 1.72 zamiast 172
d$wz[r_metry] <- d$wz[r_metry] * 100
r_zamiana <- which(d$wz >= 30 & d$wz < 130 & d$ma >= 130 & d$ma <= 210)  # wzrost i masa zamienione
pom <- d$wz[r_zamiana]; d$wz[r_zamiana] <- d$ma[r_zamiana]; d$ma[r_zamiana] <- pom
r_wz <- which(d$wz < 130 | d$wz > 210)           # poza zakresem: brak, nie zgadujemy
r_ma <- which(d$ma < 30 | d$ma > 200)
d$wz[r_wz] <- NA; d$ma[r_ma] <- NA
cat("Wzrost w metrach:", length(r_metry), "| zamiana wzrost/masa:", length(r_zamiana),
    "| wzrost poza zakresem:", length(r_wz), "| masa poza zakresem:", length(r_ma), "\n")

d$bmi <- d$ma / (d$wz / 100)^2
d$bmi_d <- d$masa_dekl / (d$wzrost_dekl / 100)^2
cat("Zakres BMI po czyszczeniu:", round(range(d$bmi, na.rm = TRUE), 1), "\n")
cat("Braki: wzrost", sum(is.na(d$wz)), "| masa", sum(is.na(d$ma)),
    "| oba", sum(is.na(d$wz) & is.na(d$ma)), "| BMI", sum(is.na(d$bmi)),
    "| osoby z BMI", sum(!is.na(d$bmi)), "\n")

# ---- 3. Rozkład i kategorie ----
opis <- function(x) { x <- x[!is.na(x)]
  c(n = length(x), M = mean(x), SD = sd(x), Me = median(x), Q1 = quantile(x, .25, names = FALSE),
    Q3 = quantile(x, .75, names = FALSE), min = min(x), max = max(x),
    skosnosc = mean((x - mean(x))^3) / sd(x)^3) }
cat("\nBMI zmierzone:\n"); print(round(opis(d$bmi), 2))
cat("Kobiety:\n"); print(round(opis(d$bmi[d$plec == "K"]), 2))
cat("Mężczyźni:\n"); print(round(opis(d$bmi[d$plec == "M"]), 2))

etyk <- c("<18.5", "18.5-<25", "25-<30", ">=30")
kat <- function(x) factor(cut(x, c(-Inf, 18.5, 25, 30, Inf), right = FALSE, labels = etyk),
                          levels = c("18.5-<25", "<18.5", "25-<30", ">=30"))
d$kat <- kat(d$bmi); d$kat_d <- kat(d$bmi_d)
tab <- table(factor(d$kat, levels = etyk))
print(cbind(n = tab, proc = round(100 * prop.table(tab), 1)))
ci <- prop.test(tab[">=30"], sum(tab), correct = FALSE)$conf.int
cat("Odsetek BMI >= 30: 95% CI [", round(100 * ci, 1), "]\n")

# ---- 4. Trzy modele tego samego związku ----
a <- d[complete.cases(d[, c("bmi", "plec", "wiek", "hospitalizacja")]), ]
cat("\nN w modelach:", nrow(a), "| hospitalizacje:", sum(a$hospitalizacja),
    "(", round(100 * mean(a$hospitalizacja), 1), "%)\n")
m_lin <- glm(hospitalizacja ~ bmi + plec + wiek, binomial, a)
m_kat <- glm(hospitalizacja ~ kat + plec + wiek, binomial, a)
m_ns  <- glm(hospitalizacja ~ ns(bmi, df = 4) + plec + wiek, binomial, a)
print(round(c(AIC_liniowy = AIC(m_lin), AIC_kategorie = AIC(m_kat), AIC_splajn = AIC(m_ns)), 1))

or_ci <- function(m, wiersze, mnoz = 1) {
  b <- coef(m)[wiersze]; se <- sqrt(diag(vcov(m)))[wiersze]
  round(cbind(OR = exp(mnoz * b), dolna = exp(mnoz * (b - 1.96 * se)),
              gorna = exp(mnoz * (b + 1.96 * se))), 2) }
cat("OR na 5 kg/m2 (model liniowy):\n"); print(or_ci(m_lin, "bmi", 5))
cat("BMI liniowo:", pv(summary(m_lin)$coef["bmi", 4]), "\n")
cat("OR kategorii względem 18.5-<25:\n"); print(or_ci(m_kat, 2:4))

test <- anova(m_lin, m_ns, test = "LRT")
cat("Test nieliniowości: chi2 =", round(test$Deviance[2], 2), "df =", test$Df[2],
    pv(test$`Pr(>Chi)`[2]), "\n")
test2 <- anova(glm(hospitalizacja ~ plec + wiek, binomial, a), m_ns, test = "LRT")
cat("Test całego splajnu: chi2 =", round(test2$Deviance[2], 2), "df =", test2$Df[2],
    pv(test2$`Pr(>Chi)`[2]), "\n")
cat("Węzły ns(df = 4):", round(attr(ns(a$bmi, df = 4), "knots"), 1), "\n")
for (k in 3:5) cat("AIC ns df =", k, ":",
  round(AIC(glm(hospitalizacja ~ ns(bmi, df = k) + plec + wiek, binomial, a)), 1), "\n")

siatka <- data.frame(bmi = seq(16, 45, .1), plec = "K", wiek = 50)
siatka$kat <- kat(siatka$bmi)
przewid <- function(m, nowe) { p <- predict(m, nowe, se.fit = TRUE)
  data.frame(p = plogis(p$fit), dol = plogis(p$fit - 1.96 * p$se.fit),
             gor = plogis(p$fit + 1.96 * p$se.fit)) }
wybor <- data.frame(bmi = c(17, 20, 24, 27, 30, 34, 38, 42), plec = "K", wiek = 50)
wybor$kat <- kat(wybor$bmi)
cat("\nPrzewidywane % (kobieta, 50 lat):\n")
print(data.frame(BMI = wybor$bmi, liniowy = round(100 * przewid(m_lin, wybor)$p, 1),
                 kategorie = round(100 * przewid(m_kat, wybor)$p, 1),
                 splajn = round(100 * przewid(m_ns, wybor)$p, 1),
                 dolna = round(100 * przewid(m_ns, wybor)$dol, 1),
                 gorna = round(100 * przewid(m_ns, wybor)$gor, 1)))
cat("Minimum krzywej splajnu przy BMI =", siatka$bmi[which.min(przewid(m_ns, siatka)$p)], "\n")

kontrast <- function(m, b1, b0) {          # OR dla BMI b1 względem b0 ze splajnu
  nowe <- data.frame(bmi = c(b1, b0), plec = "K", wiek = 50)
  X <- model.matrix(delete.response(terms(m)), nowe, xlev = m$xlevels)
  r <- X[1, ] - X[2, ]; est <- sum(r * coef(m)); se <- sqrt(drop(t(r) %*% vcov(m) %*% r))
  round(c(OR = exp(est), dolna = exp(est - 1.96 * se), gorna = exp(est + 1.96 * se)), 2) }
cat("OR splajn 38 vs 31:", kontrast(m_ns, 38, 31), "\n")
cat("OR splajn 18 vs 24:", kontrast(m_ns, 18, 24), "\n")

# ---- 5. Pomiar a deklaracja ----
b <- d[!is.na(d$bmi) & !is.na(d$bmi_d), ]
roz <- b$bmi_d - b$bmi
cat("\nOsoby z obiema wartościami:", nrow(b), "\n")
cat("Deklarowane minus zmierzone: wzrost", round(mean(b$wzrost_dekl - b$wz, na.rm = TRUE), 2),
    "cm | masa", round(mean(b$masa_dekl - b$ma, na.rm = TRUE), 2), "kg | BMI", round(mean(roz), 2),
    "(SD", round(sd(roz), 2), ")\n")
cat("Granice zgodności BMI:", round(mean(roz) + c(-1.96, 1.96) * sd(roz), 2), "\n")
cat("r pomiar-deklaracja:", round(cor(b$bmi, b$bmi_d), 3), "\n")
cat("Różnica BMI wg tercji BMI zmierzonego:\n")
print(round(tapply(roz, cut(b$bmi, quantile(b$bmi, 0:3 / 3), include.lowest = TRUE,
                            labels = c("dolna", "srodkowa", "gorna")), mean), 2))
cat("Masa kończy się na 0 lub 5: deklarowana",
    round(100 * mean(b$masa_dekl %% 5 == 0), 1), "% | zmierzona (po zaokrągleniu)",
    round(100 * mean(round(b$ma) %% 5 == 0), 1), "%\n")
kt <- table(zmierzone = factor(b$kat, levels = etyk), deklarowane = factor(b$kat_d, levels = etyk))
print(kt)
cat("Ta sama kategoria:", round(100 * sum(diag(kt)) / sum(kt), 1), "%\n")
cat("BMI >= 30: zmierzone", round(100 * mean(b$bmi >= 30), 1), "% | deklarowane",
    round(100 * mean(b$bmi_d >= 30), 1), "%\n")
mz <- glm(hospitalizacja ~ kat + plec + wiek, binomial, b)
md <- glm(hospitalizacja ~ kat_d + plec + wiek, binomial, b)
cat("OR >=30 względem 18.5-<25, pomiar:\n"); print(or_ci(mz, "kat>=30"))
cat("OR >=30 względem 18.5-<25, deklaracja:\n"); print(or_ci(md, "kat_d>=30"))

# ---- 6. Braki deklarowanej masy ----
d$brak_masy <- is.na(d$masa_dekl)
cat("\nBrak deklarowanej masy:", sum(d$brak_masy), "(", round(100 * mean(d$brak_masy), 1), "%)\n")
print(round(tapply(d$bmi, d$brak_masy, mean, na.rm = TRUE), 2))
t1 <- t.test(bmi ~ brak_masy, d)
cat("Różnica (brak minus podana): ", round(diff(t1$estimate), 2), " 95% CI [",
    round(-rev(t1$conf.int), 2), "],", pv(t1$p.value), "\n")
cat("BMI >= 30 wśród podających masę:", round(100 * mean(d$bmi[!d$brak_masy] >= 30, na.rm = TRUE), 1),
    "% | wśród wszystkich z pomiarem:", round(100 * mean(d$bmi >= 30, na.rm = TRUE), 1), "%\n")

# ---- 7. Obwód talii i WHtR ----
d$whtr <- d$talia / d$wz
w <- d[!is.na(d$talia) & !is.na(d$bmi), ]
cat("\nN z talią i BMI:", nrow(w), "\n")
print(round(sapply(split(w, w$plec), function(x) c(BMI = mean(x$bmi), talia = mean(x$talia),
      WHtR = mean(x$whtr), r_BMI_talia = cor(x$bmi, x$talia), r_BMI_WHtR = cor(x$bmi, x$whtr))), 3))
waska <- w[w$bmi >= 24 & w$bmi < 26, ]
cat("BMI 24-<26: n =", nrow(waska), "| talia min-max:", round(range(waska$talia), 1),
    "| średnia K/M:", round(tapply(waska$talia, waska$plec, mean), 1), "\n")
r2 <- summary(lm(bmi ~ talia + plec + wiek, w))$r.squared
cat("VIF BMI przy talii, płci i wieku w modelu:", round(1 / (1 - r2), 2), "\n")
Wynik w R
Wpisy z przecinkiem we wzroście: 6
Wzrost w metrach: 9 | zamiana wzrost/masa: 3 | wzrost poza zakresem: 1 | masa poza zakresem: 2
Zakres BMI po czyszczeniu: 13.7 42.4
Braki: wzrost 14 | masa 30 | oba 1 | BMI 43 | osoby z BMI 857

BMI zmierzone:
       n        M       SD       Me       Q1       Q3      min      max
  857.00    26.75     4.46    26.37    23.58    29.55    13.67    42.44
skosnosc
    0.41
Kobiety:
       n        M       SD       Me       Q1       Q3      min      max
  468.00    26.38     4.35    26.17    23.35    29.18    13.67    39.85
skosnosc
    0.29
Mężczyźni:
       n        M       SD       Me       Q1       Q3      min      max
  389.00    27.20     4.56    26.55    24.16    30.04    17.86    42.44
skosnosc
    0.51
           n proc
<18.5     11  1.3
18.5-<25 314 36.6
25-<30   345 40.3
>=30     187 21.8
Odsetek BMI >= 30: 95% CI [ 19.2 24.7 ]

N w modelach: 857 | hospitalizacje: 128 ( 14.9 %)
  AIC_liniowy AIC_kategorie    AIC_splajn
        706.6         703.0         695.4
OR na 5 kg/m2 (model liniowy):
      OR dolna gorna
bmi 1.31  1.06  1.62
BMI liniowo: p = .011
OR kategorii względem 18.5-<25:
            OR dolna gorna
kat<18.5  4.06  1.17 14.13
kat25-<30 0.82  0.52  1.31
kat>=30   1.79  1.10  2.91
Test nieliniowości: chi2 = 17.16 df = 3 p < .001
Test całego splajnu: chi2 = 23.55 df = 4 p < .001
Węzły ns(df = 4): 23.6 26.4 29.5
AIC ns df = 3 : 693.6
AIC ns df = 4 : 695.4
AIC ns df = 5 : 696.6

Przewidywane % (kobieta, 50 lat):
  BMI liniowy kategorie splajn dolna gorna
1  17     8.7      37.5   28.7  13.8  50.3
2  20    10.1      12.9   16.8  11.3  24.3
3  24    12.3      12.9   10.2   7.2  14.1
4  27    14.2      10.9   10.1   6.9  14.7
5  30    16.3      20.9   14.7  10.7  19.9
6  34    19.5      20.9   24.2  17.1  33.1
7  38    23.2      20.9   36.8  22.0  54.6
8  42    27.3      20.9   51.2  19.1  82.3
Minimum krzywej splajnu przy BMI = 25.6
OR splajn 38 vs 31: 2.89 1.31 6.41
OR splajn 18 vs 24: 2.79 1.28 6.08

Osoby z obiema wartościami: 794
Deklarowane minus zmierzone: wzrost 0.89 cm | masa -1.22 kg | BMI -0.69 (SD 0.93 )
Granice zgodności BMI: -2.52 1.14
r pomiar-deklaracja: 0.978
Różnica BMI wg tercji BMI zmierzonego:
   dolna srodkowa    gorna
   -0.30    -0.61    -1.15
Masa kończy się na 0 lub 5: deklarowana 43.2 % | zmierzona (po zaokrągleniu) 19.3 %
          deklarowane
zmierzone  <18.5 18.5-<25 25-<30 >=30
  <18.5        9        0      0    0
  18.5-<25     7      281     14    0
  25-<30       0       52    262    4
  >=30         0        0     42  123
Ta sama kategoria: 85 %
BMI >= 30: zmierzone 20.8 % | deklarowane 16 %
OR >=30 względem 18.5-<25, pomiar:
          OR dolna gorna
kat>=30 1.53  0.91  2.56
OR >=30 względem 18.5-<25, deklaracja:
            OR dolna gorna
kat_d>=30 1.81  1.05  3.13

Brak deklarowanej masy: 46 ( 5.1 %)
FALSE  TRUE
26.58 29.79
Różnica (brak minus podana):  3.2  95% CI [ 1.72 4.68 ], p < .001
BMI >= 30 wśród podających masę: 20.7 % | wśród wszystkich z pomiarem: 21.8 %

N z talią i BMI: 831
                 K      M
BMI         26.358 27.222
talia       86.695 98.746
WHtR         0.530  0.557
r_BMI_talia  0.861  0.876
r_BMI_WHtR   0.827  0.848
BMI 24-<26: n = 157 | talia min-max: 69 109.4 | średnia K/M: 83.9 93.2
VIF BMI przy talii, płci i wieku w modelu: 4.42
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base, stats i splines); rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych programów (sessionInfo()).
- R (w tym pakiet splines): R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Zanim oddasz analizę BMI, sprawdź…
- Czy masz w bazie wzrost i masę, a BMI liczysz skryptem?
- Czy wiesz i piszesz, które dane są zmierzone, a które deklarowane?
- Czy reguły zakresów i poprawek powstały przed analizą i są w dzienniku zmian?
- Czy podałeś(-aś) braki wzrostu, masy i BMI osobno?
- Czy progi kategorii mają źródło, a granice są jednoznaczne?
- Czy w modelu BMI jest liczbą, a kształt związku został sprawdzony?
- Czy pokazałeś(-aś) wykres z przedziałem ufności, zamiast samego OR?
- Czy obwód talii analizujesz z uwzględnieniem płci i z opisem miejsca pomiaru?
- Czy w pracy o dzieciach używasz siatek centylowych, a nie progów dla dorosłych?
Najczęstsze pytania
Czy BMI w analizie powinno być liczbą, czy kategoriami?
Do opisu próby podaj oba: BMI jako liczbę i odsetki w kategoriach ze źródłem progów. W modelu używaj BMI jako zmiennej ciągłej, bo kategorie zakładają skok na granicy i jednakowe ryzyko w grupie. Kategorie zostaw jako analizę dodatkową albo gdy pytanie dotyczy właśnie progów.
Jak sprawdzić, czy związek BMI z wynikiem jest nieliniowy?
Porównaj model z BMI liniowo z modelem z naturalnym splajnem, np. ns(bmi, df = 4), testem ilorazu wiarygodności i AIC, a krzywą pokaż na wykresie z przedziałem ufności. Liczbę stopni swobody ustal przed analizą i sprawdź wrażliwość wyniku na jej zmianę.
Czy można liczyć BMI z deklarowanego wzrostu i masy?
Można, ale napisz to wprost w metodach i ograniczeniach. W przeglądzie systematycznym stwierdzono tendencję do zaniżania masy i BMI oraz zawyżania wzrostu w samoopisie, różną w zależności od płci i populacji. Jeśli to możliwe, zmierz podpróbę i pokaż zgodność deklaracji z pomiarem.
Co zrobić, gdy respondent nie podał masy ciała lub wzrostu?
BMI jest wtedy brakiem, więc raportuj osobno braki wzrostu, masy i BMI. Porównaj osoby z brakiem i bez niego i nie zastępuj braków średnią. Przy większej liczbie braków rozważ imputację wielokrotną, a przed analizą ustal, czy imputujesz składniki, czy samo BMI.
Czy BMI dzieci można analizować według progów dla dorosłych?
Nie. U dzieci i młodzieży stosuje się wartości odniesione do wieku i płci, czyli siatki centylowe lub referencje WHO zależne od grupy wieku. W pracy podaj, jakiej siatki użyto i jak przeliczono wyniki.
Powiązane hasła
Przeczytaj też
Nieliniowe zależności: splajny i GAM
Podział na grupy, parabola, splajn i GAM na jednym zbiorze: edf, REML, wybór k, diagnostyka, wykres krzywej i wzór opisu w R.
Czytaj →PoradnikReguły kontroli danych i dziennik zmian
Zakresy, logika pytań i sumy kontrolne zapisane z góry, tabela naruszeń w R, decyzje i dziennik zmian odtwarzający czysty zbiór.
Czytaj →PoradnikStatystyka w pracy z dietetyki
Sposób żywienia, BMI, FFQ a zapis spożycia, interwencja przed i po i błąd pomiaru: plan analiz, testy, wielkość efektu, APA i kod R.
Czytaj →Masz w pracy BMI i nie wiesz, czy liczyć je jako liczbę, czy jako kategorie?
Sprawdzimy dane wzrostu i masy, dobierzemy postać BMI do pytania badawczego, policzymy model w R lub SPSS i wyjaśnimy decyzje tak, żebyś umiał(a) je samodzielnie opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Ashwell, M., Gunn, P., & Gibson, S. (2012). Waist-to-height ratio is a better screening tool than waist circumference and BMI for adult cardiometabolic risk factors: Systematic review and meta-analysis. Obesity Reviews, 13(3), 275–286. https://doi.org/10.1111/j.1467-789x.2011.00952.x
- Aune, D., Sen, A., Prasad, M., Norat, T., Janszky, I., Tonstad, S., Romundstad, P., & Vatten, L. J. (2016). BMI and all cause mortality: Systematic review and non-linear dose-response meta-analysis of 230 cohort studies with 3.74 million deaths among 30.3 million participants. BMJ, 353, Article i2156. https://doi.org/10.1136/bmj.i2156 ● Otwarty dostęp
- Bennette, C., & Vickers, A. (2012). Against quantiles: Categorization of continuous variables in epidemiologic research, and its discontents. BMC Medical Research Methodology, 12(1), Article 21. https://doi.org/10.1186/1471-2288-12-21 ● Otwarty dostęp
- Connor Gorber, S., Tremblay, M., Moher, D., & Gorber, B. (2007). A comparison of direct vs. self-report measures for assessing height, weight and body mass index: A systematic review. Obesity Reviews, 8(4), 307–326. https://doi.org/10.1111/j.1467-789x.2007.00347.x
- Desquilbet, L., & Mariotti, F. (2010). Dose-response analyses using restricted cubic spline functions in public health research. Statistics in Medicine, 29(9), 1037–1057. https://doi.org/10.1002/sim.3841
- Perperoglou, A., Sauerbrei, W., Abrahamowicz, M., & Schmid, M. (2019). A review of spline function procedures in R. BMC Medical Research Methodology, 19(1), Article 46. https://doi.org/10.1186/s12874-019-0666-3 ● Otwarty dostęp
- Ulijaszek, S. J., & Kerr, D. A. (1999). Anthropometric measurement error and the assessment of nutritional status. British Journal of Nutrition, 82(3), 165–177. https://doi.org/10.1017/s0007114599001348 ● Otwarty dostęp
- World Health Organization. (2026). Obesity and overweight. https://www.who.int/news-room/fact-sheets/detail/obesity-and-overweight ● Otwarty dostęp
- World Health Organization. (b.d.). Body mass index (BMI). https://www.who.int/data/gho/data/themes/topics/topic-details/GHO/body-mass-index ● Otwarty dostęp
Cytowania BibTeX
@article{ashwell2012waist, author={Ashwell, Margaret and Gunn, Pippa and Gibson, Sigrid}, title={{Waist-to-height ratio is a better screening tool than waist circumference and BMI for adult cardiometabolic risk factors: Systematic review and meta-analysis}}, journal={Obesity Reviews}, year={2012}, volume={13}, number={3}, pages={275--286}, doi={10.1111/j.1467-789x.2011.00952.x}}@article{aune2016bmi, author={Aune, Dagfinn and Sen, Abhijit and Prasad, Manya and Norat, Teresa and Janszky, Imre and Tonstad, Serena and Romundstad, P{\aa}l and Vatten, Lars J.}, title={{BMI and all cause mortality: Systematic review and non-linear dose-response meta-analysis of 230 cohort studies with 3.74 million deaths among 30.3 million participants}}, journal={BMJ}, year={2016}, volume={353}, eid={i2156}, doi={10.1136/bmj.i2156}}@article{bennette2012against, author={Bennette, Caroline and Vickers, Andrew}, title={{Against quantiles: Categorization of continuous variables in epidemiologic research, and its discontents}}, journal={BMC Medical Research Methodology}, year={2012}, volume={12}, number={1}, eid={21}, doi={10.1186/1471-2288-12-21}}@article{gorber2007comparison, author={Connor Gorber, Sarah and Tremblay, Mark and Moher, David and Gorber, B.}, title={{A comparison of direct vs. self-report measures for assessing height, weight and body mass index: A systematic review}}, journal={Obesity Reviews}, year={2007}, volume={8}, number={4}, pages={307--326}, doi={10.1111/j.1467-789x.2007.00347.x}}@article{desquilbet2010dose, author={Desquilbet, Loïc and Mariotti, François}, title={{Dose-response analyses using restricted cubic spline functions in public health research}}, journal={Statistics in Medicine}, year={2010}, volume={29}, number={9}, pages={1037--1057}, doi={10.1002/sim.3841}}@article{perperoglou2019review, author={Perperoglou, Aris and Sauerbrei, Willi and Abrahamowicz, Michal and Schmid, Matthias}, title={{A review of spline function procedures in R}}, journal={BMC Medical Research Methodology}, year={2019}, volume={19}, number={1}, eid={46}, doi={10.1186/s12874-019-0666-3}}@article{ulijaszek1999anthropometric, author={Ulijaszek, Stanley J. and Kerr, Deborah A.}, title={{Anthropometric measurement error and the assessment of nutritional status}}, journal={British Journal of Nutrition}, year={1999}, volume={82}, number={3}, pages={165--177}, doi={10.1017/s0007114599001348}}@misc{who2026obesity, author={{World Health Organization}}, title={{Obesity and overweight}}, year={2026}, publisher={World Health Organization}, url={https://www.who.int/news-room/fact-sheets/detail/obesity-and-overweight}}@misc{whondbmi, author={{World Health Organization}}, title={{Body mass index (BMI)}}, year={b.d.}, publisher={World Health Organization}, url={https://www.who.int/data/gho/data/themes/topics/topic-details/GHO/body-mass-index}}