Czym jest MLQ
Kwestionariusz poczucia sensu życia MLQ (Meaning in Life Questionnaire) opublikowali Steger, Frazier, Oishi i Kaler (2006). To krótka miara samoopisowa, która daje dwa osobne wyniki. Obecność sensu (presence) opisuje, na ile ktoś odczuwa swoje życie jako sensowne. Poszukiwanie sensu (search) opisuje, na ile ktoś jest zaangażowany w szukanie albo pogłębianie tego sensu. MLQ pojawia się przede wszystkim w pracach z psychologii: zdrowia, klinicznej, rozwojowej i pozytywnej. Bywa też zmienną w badaniach pacjentów, studentów i seniorów. Ogólny warsztat analityczny tego kierunku opisuje wpis statystyka dla psychologa.
Steger i in. (2006) w trzech badaniach sprawdzili spójność wewnętrzną, stabilność w czasie, strukturę czynnikową i trafność narzędzia. Macierz wielu cech i wielu metod pokazała trafność zbieżną i różnicową obu podskal w porównaniu z dwiema innymi skalami sensu. Autorzy podkreślają, że pozycje MLQ nie pokrywają się treściowo z miarami dystresu. To ważne, gdy w tej samej pracy badasz depresję albo lęk. W badaniach dobrostanu MLQ często stoi obok skali SWLS albo Flourishing Scale. Tamte narzędzia dają jeden wynik ogólny, a MLQ daje dwa.
Budowa i stan weryfikacji klucza
Treści pozycji nie przytaczamy. Artykuł z 2006 r. jest płatny, a oficjalna strona autora nie podaje klucza. Dlatego tabela rozdziela to, co potwierdziliśmy w publikacjach z udziałem twórcy narzędzia, od tego, co musisz sprawdzić sam(a).
| Element | Co potwierdziliśmy | Źródło |
|---|---|---|
| Liczba pozycji | 10 pozycji | Steger i in. (2006); oficjalna strona autora (Steger, b.d.) |
| Wymiary | dwie podskale: obecność sensu i poszukiwanie sensu | Steger i in. (2006) |
| Skala odpowiedzi | 7 stopni, od 1 (całkowicie nieprawdziwe) do 7 (całkowicie prawdziwe) | Mijalevich-Soker i in. (2025), praca ze współautorstwem Stegera |
| Wynik | średnia pozycji każdej podskali; wyższy wynik = większa obecność albo silniejsze poszukiwanie | Mijalevich-Soker i in. (2025) |
| Przydział numerów pozycji do podskal i pozycje odwrócone | nie podajemy – tych informacji nie ma w źródłach, które mogliśmy sprawdzić | weź je z artykułu Stegera i in. (2006) albo z formularza od autora |
| Wynik ogólny, normy, progi | żadne ze sprawdzonych źródeł ich nie podaje | – |
W sieci krążą arkusze z „kluczem MLQ” i opisem przedziałów wyników. Nie przepisuj ich bez sprawdzenia, skąd pochodzą. Do pracy weź klucz z oryginalnego artykułu albo z formularza pobranego od autora i zacytuj to źródło.
Jak policzyć wynik krok po kroku
- Sprawdź kodowanie. Odpowiedzi muszą mieć wartości 1–7. Formularze online zapisują je czasem jako 0–6 albo jako tekst etykiety. Wtedy najpierw przekoduj zmienne.
- Przypisz pozycje do podskal. Użyj przydziału z artykułu Stegera i in. (2006) albo z formularza od autora. Podziel kolumny na dwie grupy i zapisz to w książce kodowej.
- Odwróć pozycje, jeśli klucz tego wymaga. Przy odpowiedziach 1–7 wartość odwrócona to 8 − x. Odwracaj tylko pozycje wskazane w źródle.
- Policz średnią w każdej podskali. Wynik obecności i wynik poszukiwania mieszczą się w zakresie 1–7. Średnią liczyli Mijalevich-Soker i in. (2025). Plusy i minusy sumy oraz średniej omawia hasło wynik skali: średnia czy suma.
- Ustal regułę dla braków. Sprawdzone źródła jej nie podają. W przykładzie liczymy średnią, gdy w podskali brakuje najwyżej jednej odpowiedzi. To decyzja badacza i trzeba ją opisać w pracy.
Przekodowanie i średnie w różnych programach pokazuje poradnik jak policzyć wynik kwestionariusza. Pojedynczy wynik możesz też policzyć w kalkulatorze wyniku skali.
Interpretacja: dwa wyniki, bez sumy i bez progów
Nie dodawaj obecności i poszukiwania. To dwa różne konstrukty, a nie dwie połowy jednej skali. Steger, Kashdan, Sullivan i Lorentz (2008) zauważyli, że osoby, którym brakuje sensu, częściej go szukają. Samo poszukiwanie nie prowadziło jednak do większej obecności sensu. Wysoki wynik „ogólny” mógłby więc oznaczać zarówno kogoś, kto sens ma, jak i kogoś, kto go intensywnie szuka.
Nie dziel wyników na „niski” i „wysoki” bez źródła. Oficjalna strona autora nie podaje norm ani progów, a abstrakt artykułu z 2006 r. też ich nie wymienia. Wynik analizuj jako zmienną ciągłą. Jeśli promotor chce grup, wskaż publikację, z której pochodzi punkt odcięcia. Dlaczego nie warto tworzyć własnych przedziałów, wyjaśnia wpis niski, przeciętny, wysoki wynik.
Uwzględnij wiek. Steger, Oishi i Kashdan (2009) zbadali 8756 osób w czterech okresach dorosłości. Osoby starsze zwykle deklarowały większą obecność sensu, a młodsze – silniejsze poszukiwanie. Poszukiwanie silniej wiązało się z niższym dobrostanem w późniejszych okresach życia. Porównując grupy wieku, pamiętaj o inwariancji pomiaru. Autorzy potwierdzili niezmienność strukturalną w swojej próbie, ale w Twojej trzeba ją sprawdzić.
Pytaj o oba wymiary naraz. W wielu pracach ciekawe jest to, czy znaczenie poszukiwania zależy od poziomu obecności sensu. To pytanie o moderację, czyli o efekt interakcji dwóch podskal. Pokazujemy je w przykładzie. Pełną procedurę opisuje wpis analiza moderacji krok po kroku.
Licencja i polska wersja
Według oficjalnej strony autora MLQ jest bezpłatny do celów edukacyjnych, terapeutycznych i akademickich badań naukowych. Użycie komercyjne wymaga wcześniejszej pisemnej zgody, a narzędzia nie wolno sprzedawać ani rozpowszechniać w płatnej ofercie bez zgody autora (Steger, b.d.; stan na 1 listopada 2026 r.). Praca dyplomowa to użycie akademickie. Warunki mogą się jednak zmienić, więc przeczytaj je przy pobieraniu formularza. W pracy zacytuj artykuł Stegera i in. (2006).
Polską adaptację opisali Kossakowska, Kwiatek i Stefaniak (2014). Ten wpis nie podaje polskich norm ani wyników tej adaptacji. Jeśli z niej korzystasz, weź z publikacji wersję językową i zacytuj ją. Adaptacje powstają też w innych językach. Przykładem jest wersja francuska zbadana u pacjentów ośrodka interwencji kryzysowej, z udziałem Stegera jako współautora (Le Vaou i in., 2026). Potwierdzono w niej dwa wymiary, a alfa wyniosła .90 i .82. O tłumaczeniu i adaptacji przeczytasz we wpisie adaptacja kulturowa kwestionariusza, a o szukaniu narzędzi – w poradniku gdzie znaleźć kwestionariusze psychologiczne.
Przykład: 300 osób studiujących
Dane są symulowane i możesz je pobrać jako plik CSV. Kolumny ob1–ob5 i po1–po5 są już przypisane do podskal i przekodowane. Liczba kolumn na podskalę to założenie symulacji, a nie numeracja formularza. Plik zawiera też wiek i satysfakcję z życia jako średnią 1–7. Jedna osoba miała dwa braki w podskali poszukiwania, więc do analizy weszło 299 osób.
| Podskala | M (SD) | Me | Skośność | α [95% CI] | ω |
|---|---|---|---|---|---|
| Obecność sensu | 4.72 (1.15) | 4.8 | −0.56 | .86 [.83, .88] | .86 |
| Poszukiwanie sensu | 4.90 (1.11) | 5.0 | −0.38 | .83 [.80, .86] | .83 |
Rzetelność i struktura
Rzetelność liczymy osobno dla każdej podskali. Alfa dla wszystkich dziesięciu pozycji naraz nie ma sensu, bo podskale mierzą różne rzeczy. Korelacje pozycji z resztą podskali wyniosły .62–.72 dla obecności i .60–.68 dla poszukiwania. Alfa zakłada równe ładunki pozycji (McNeish, 2018), dlatego obok niej podajemy omegę McDonalda. Zdania o rzetelności do pracy znajdziesz we wzorze raportowania alfy Cronbacha.
W CFA model dwóch skorelowanych czynników pasował dobrze: χ²(34) = 37.52, CFI = .997, RMSEA = .018, SRMR = .031. Model jednego czynnika pasował źle: χ²(35) = 506.64, CFI = .617, RMSEA = .205, SRMR = .164. Korelacja czynników wyniosła −.32. To argument z danych, że wyniku ogólnego się nie liczy.
Obecność a poszukiwanie
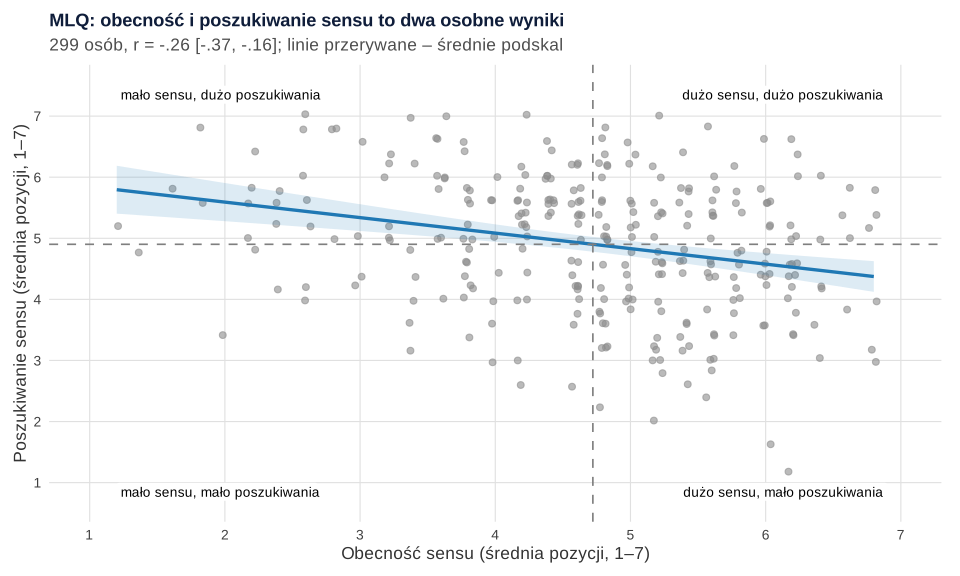
Korelacja Pearsona wyników podskal wyniosła r = −.26, 95% CI [−.37, −.16], p < .001. Związek jest słaby, więc w próbie są wszystkie kombinacje: osoby, które sens mają i dalej go szukają, oraz osoby, które go nie mają i nie szukają (rysunek 1). Kierunek związku zgadza się z obserwacją Stegera i in. (2008), choć liczby pochodzą z symulacji.
Związek z satysfakcją z życia
W regresji wielorakiej z wycentrowanymi predyktorami obecność sensu wiązała się z wyższą satysfakcją (b = 0.57, p < .001). Poszukiwanie przy przeciętnej obecności wiązało się z niższą satysfakcją (b = −0.18, p < .001). Dodanie interakcji podniosło R² z .430 do .474, ΔR² = .044, F(1, 295) = 24.90, p < .001. Współczynnik interakcji wyniósł b = 0.20, 95% CI [0.12, 0.28].
Efekty proste pokazują, co to znaczy. Przy obecności o 1 SD poniżej średniej nachylenie poszukiwania wyniosło −0.41, 95% CI [−0.55, −0.27]. Przy obecności przeciętnej wyniosło −0.18 [−0.27, −0.09], a przy obecności o 1 SD powyżej średniej 0.06 [−0.06, 0.18], p = .346 (rysunek 2). Nachylenia dla dowolnej wartości moderatora policzysz w kalkulatorze efektów prostych i Johnsona–Neymana.
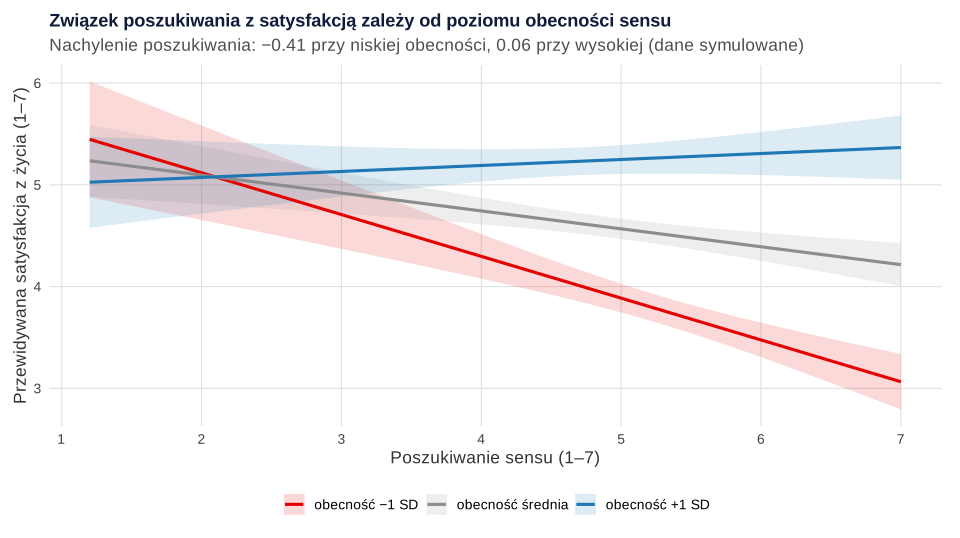
Wzór interakcji wpisaliśmy w symulację. Nie jest to wynik z literatury, tylko ilustracja analizy.
Jak opisać MLQ w pracy
Wzory zawierają liczby z przykładu. W nawiasach kwadratowych uzupełnij dane swojej wersji.
Ogólny schemat opisu narzędzia znajdziesz w poradniku opis narzędzia badawczego – wzór, a zdania o wynikach regresji przygotujesz w generatorze opisu wyników APA.
MLQ w R: dwie podskale, rzetelność, CFA i interakcja
Kod odtwarza liczby z tekstu i zapisuje plik CSV. Wynik każdej podskali to średnia jej pozycji przy najwyżej jednym braku. Alfę z przedziałem Feldta liczy pakiet psych, a omegę i modele CFA – lavaan. Regresja z interakcją i efekty proste korzystają z bazowego R.
Wynik MLQ krok po kroku
R
# B279 – MLQ: dwa osobne wyniki (obecność i poszukiwanie sensu), braki, rzetelność, CFA, związek z dobrostanem
# (dane symulowane, set.seed(2791)). Treści pozycji ani numerów pozycji z formularza nie podajemy.
# 300 osób studiujących; odpowiedzi 1–7 (1 = całkowicie nieprawdziwe … 7 = całkowicie prawdziwe).
# Kolumny ob1–ob5 (obecność) i po1–po5 (poszukiwanie) są JUŻ przypisane do podskal i ewentualnie przekodowane
# według klucza z artykułu Stegera i in. (2006) / formularza od autora. Liczba kolumn to założenie symulacji,
# a nie numeracja formularza. Wynik podskali = średnia jej pozycji (zakres 1–7); wyniku ogólnego nie liczymy.
suppressPackageStartupMessages({ library(psych); library(lavaan) })
set.seed(2791)
n <- 300
wiek <- round(runif(n, 19, 30))
ob_lat <- rnorm(n)                                          # obecność sensu (cecha latentna)
po_lat <- -0.30 * ob_lat + sqrt(1 - 0.30^2) * rnorm(n)      # poszukiwanie sensu, ujemnie związane z obecnością
pozycje <- function(F, lam, progi) sapply(lam, function(l) 1 + findInterval(l * F + rnorm(n, 0, sqrt(1 - l^2)), progi))
ob <- pozycje(ob_lat, c(.80, .76, .72, .78, .66), c(-2.0, -1.4, -0.8, -0.2, 0.5, 1.3))
po <- pozycje(po_lat, c(.74, .80, .70, .77, .68), c(-2.2, -1.6, -1.0, -0.4, 0.3, 1.1))
colnames(ob) <- paste0("ob", 1:5); colnames(po) <- paste0("po", 1:5)
swl <- round(pmin(7, pmax(1, 4.4 + 0.75 * ob_lat - 0.20 * po_lat + 0.18 * ob_lat * po_lat + rnorm(n, 0, 0.85))), 1)
dane <- data.frame(id = 1:n, wiek, ob, po, satysfakcja = swl)       # satysfakcja z życia: średnia 1–7
dane$ob3[c(17, 140, 233)] <- NA; dane$po2[c(58, 140)] <- NA; dane$po5[c(140, 271)] <- NA   # braki
write.csv(dane, "../mlq-dane-przyklad.csv", row.names = FALSE, na = "")   # plik do pobrania
O <- paste0("ob", 1:5); P <- paste0("po", 1:5)

# Krok 1. Kontrola kodowania: tylko 1–7 albo brak; liczba braków w każdej podskali
all(as.matrix(dane[, c(O, P)]) %in% c(1:7, NA))
table(obecnosc = rowSums(is.na(dane[, O])), poszukiwanie = rowSums(is.na(dane[, P])))

# Krok 2. Wynik każdej podskali = średnia pozycji; tu przy co najwyżej 1 braku na podskalę (decyzja badacza)
srednia_n <- function(x, min_odp) ifelse(rowSums(!is.na(x)) >= min_odp, rowMeans(x, na.rm = TRUE), NA)
dane$obecnosc <- srednia_n(dane[, O], 4)
dane$poszukiwanie <- srednia_n(dane[, P], 4)
colSums(is.na(dane[, c("obecnosc", "poszukiwanie")]))
d <- dane[complete.cases(dane[, c("obecnosc", "poszukiwanie")]), ]
nrow(d)
opis <- function(x) round(c(M = mean(x), SD = sd(x), Me = median(x), min = min(x), max = max(x),
  skosnosc = skew(x), proc_max = 100 * mean(x == 7)), 2)
rbind(obecnosc = opis(d$obecnosc), poszukiwanie = opis(d$poszukiwanie))

# Krok 3. Rzetelność osobno dla podskal: alfa z 95% CI Feldta i omega z modelu jednoczynnikowego
rzet <- function(v) {
  a <- psych::alpha(d[, v], warnings = FALSE)
  f <- cfa(paste("F =~", paste(v, collapse = " + ")), data = d, std.lv = TRUE)
  st <- standardizedSolution(f); lam <- st$est.std[st$op == "=~"]
  th <- st$est.std[st$op == "~~" & st$lhs %in% v & st$lhs == st$rhs]
  round(c(alfa = a$total$raw_alpha, lo = a$feldt$lower.ci[[1]], hi = a$feldt$upper.ci[[1]],
          omega = sum(lam)^2 / (sum(lam)^2 + sum(th)), r_drop_min = min(a$item.stats$r.drop),
          r_drop_max = max(a$item.stats$r.drop)), 2)
}
rbind(obecnosc = rzet(O), poszukiwanie = rzet(P))

# Krok 4. Struktura: dwa skorelowane czynniki a jeden czynnik (estymator MLR, pełne dane pozycji)
m2 <- "OB =~ ob1 + ob2 + ob3 + ob4 + ob5\n PO =~ po1 + po2 + po3 + po4 + po5"
m1 <- "SENS =~ ob1 + ob2 + ob3 + ob4 + ob5 + po1 + po2 + po3 + po4 + po5"
g2 <- cfa(m2, data = d, estimator = "MLR", std.lv = TRUE, missing = "fiml")
g1 <- cfa(m1, data = d, estimator = "MLR", std.lv = TRUE, missing = "fiml")
ind <- c("chisq.scaled", "df.scaled", "cfi.robust", "rmsea.robust", "srmr")
round(rbind(dwa_czynniki = fitMeasures(g2, ind), jeden_czynnik = fitMeasures(g1, ind)), 3)
round(lavInspect(g2, "std")$psi["OB", "PO"], 2)               # korelacja czynników

# Krok 5. Obecność a poszukiwanie: korelacja Pearsona wyników podskal
ct <- cor.test(d$obecnosc, d$poszukiwanie)
round(c(r = unname(ct$estimate), lo = ct$conf.int[1], hi = ct$conf.int[2]), 2); format.pval(ct$p.value, digits = 3)

# Krok 6. Satysfakcja z życia: obie podskale i ich interakcja (predyktory wycentrowane)
d$ob_c <- d$obecnosc - mean(d$obecnosc); d$po_c <- d$poszukiwanie - mean(d$poszukiwanie)
r1 <- lm(satysfakcja ~ ob_c + po_c, d)
r2 <- lm(satysfakcja ~ ob_c * po_c, d)
round(summary(r1)$coefficients, 3); round(summary(r2)$coefficients, 3)
round(c(R2_bez = summary(r1)$r.squared, R2_z_interakcja = summary(r2)$r.squared,
        delta_R2 = summary(r2)$r.squared - summary(r1)$r.squared), 3)
an <- anova(r1, r2); round(c(F = an$F[2], df1 = an$Df[2], df2 = an$Res.Df[2]), 2); format.pval(an$`Pr(>F)`[2], digits = 3)
round(confint(r2)["ob_c:po_c", ], 3)
# Efekty proste: nachylenie poszukiwania przy obecności o 1 SD niższej, średniej i o 1 SD wyższej
s_ob <- sd(d$obecnosc); b <- coef(r2); V <- vcov(r2)
proste <- t(sapply(c(-1, 0, 1) * s_ob, function(z) {
  est <- b["po_c"] + z * b["ob_c:po_c"]
  se <- sqrt(V["po_c", "po_c"] + z^2 * V["ob_c:po_c", "ob_c:po_c"] + 2 * z * V["po_c", "ob_c:po_c"])
  c(b = unname(est), lo = unname(est - qt(.975, r2$df.residual) * se), hi = unname(est + qt(.975, r2$df.residual) * se),
    p = unname(2 * pt(-abs(est / se), r2$df.residual)))
}))
rownames(proste) <- c("obecnosc_-1SD", "obecnosc_srednia", "obecnosc_+1SD"); round(proste, 3)
Wynik w R
[1] TRUE
        poszukiwanie
obecnosc   0   1   2
       0 295   2   0
       1   2   0   1
    obecnosc poszukiwanie
           0            1
[1] 299
                M   SD  Me min max skosnosc proc_max
obecnosc     4.72 1.15 4.8 1.2 6.8    -0.56     0.00
poszukiwanie 4.90 1.11 5.0 1.2 7.0    -0.38     1.67
             alfa   lo   hi omega r_drop_min r_drop_max
obecnosc     0.86 0.83 0.88  0.86       0.62       0.72
poszukiwanie 0.83 0.80 0.86  0.83       0.60       0.68
              chisq.scaled df.scaled cfi.robust rmsea.robust  srmr
dwa_czynniki        37.521        34      0.997        0.018 0.031
jeden_czynnik      506.635        35      0.617        0.205 0.164
[1] -0.32
    r    lo    hi
-0.26 -0.37 -0.16
[1] "3.65e-06"
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    4.516      0.051  89.071    0.000
ob_c           0.605      0.046  13.225    0.000
po_c          -0.152      0.048  -3.189    0.002
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    4.585      0.051  90.499        0
ob_c           0.571      0.044  12.844        0
po_c          -0.176      0.046  -3.821        0
ob_c:po_c      0.204      0.041   4.990        0
         R2_bez R2_z_interakcja        delta_R2
          0.430           0.474           0.044
    F   df1   df2
 24.9   1.0 295.0
[1] "1.03e-06"
 2.5 % 97.5 %
 0.123  0.284
                      b     lo     hi     p
obecnosc_-1SD    -0.411 -0.547 -0.274 0.000
obecnosc_srednia -0.176 -0.267 -0.085 0.000
obecnosc_+1SD     0.059 -0.064  0.181 0.346
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy MLQ
- Suma obu podskal. Obecność i poszukiwanie to dwa konstrukty o ujemnej korelacji. Wynik „ogólny” zaciera różnicę między osobą, która sens ma, a osobą, która go szuka.
- Jedna alfa dla dziesięciu pozycji. Rzetelność podaj osobno dla każdej podskali.
- Klucz z nieznanego arkusza. Przydział pozycji i pozycje odwrócone bierz z artykułu Stegera i in. (2006) albo z formularza od autora.
- Kodowanie 0–6 zamiast 1–7. Średnia przesuwa się wtedy o cały punkt, a porównania z literaturą tracą sens.
- Progi „wysokiego sensu” bez źródła. Oficjalna strona autora ich nie podaje. Analizuj wyniki ciągłe.
- Analiza tylko jednej podskali. Bez drugiej trudno zinterpretować wynik, bo znaczenie poszukiwania zależy od obecności sensu.
Całą ścieżkę od kodowania po rzetelność porządkuje przewodnik po analizie kwestionariusza. Jeśli chcesz, żeby ktoś sprawdził liczenie MLQ w Twojej bazie, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Czy w MLQ liczy się wynik ogólny z obu podskal?
Nie. Źródła, które sprawdziliśmy, podają dwa osobne wyniki: obecność i poszukiwanie sensu. Te wymiary korelują zwykle słabo i ujemnie, a Steger i in. (2008) pokazali, że osoby bez poczucia sensu częściej go szukają. Suma zatarłaby więc różnicę między kimś, kto sens ma, a kimś, kto go szuka.
Skąd wziąć klucz MLQ, czyli przydział pozycji i pozycje odwrócone?
Z artykułu Stegera i in. (2006) w Journal of Counseling Psychology albo z formularza pobranego od autora lub z publikacji polskiej adaptacji, której używasz. Na oficjalnej stronie autora klucza nie ma, a artykuł jest płatny, więc w tym wpisie go nie przepisujemy. Po przekodowaniu sprawdź korelacje pozycji z resztą podskali: wartość ujemna zwykle oznacza błąd w kluczu.
Od jakiego wyniku poczucie sensu w MLQ jest wysokie?
Autor nie podaje progów ani norm na oficjalnej stronie, a abstrakt artykułu z 2006 r. też ich nie wymienia. Traktuj obie średnie jako zmienne ciągłe. Jeśli promotor wymaga grup, wskaż publikację, z której pochodzi próg, i nazwij grupy opisowo.
Czy MLQ można bez opłat użyć w pracy magisterskiej?
Według oficjalnej strony autora MLQ jest bezpłatny do celów edukacyjnych, terapeutycznych i akademickich badań naukowych, a użycie komercyjne wymaga pisemnej zgody (stan na 1 listopada 2026 r.). Praca dyplomowa to użycie akademickie. Zacytuj artykuł Stegera i in. (2006), a przy polskiej wersji także jej adaptację.
Czy można porównać wynik obecności z wynikiem poszukiwania sensu u tych samych osób?
Technicznie da się policzyć test dla prób zależnych, ale wniosek „ludzie bardziej szukają sensu, niż go mają” jest wątpliwy. Podskale mierzą różne konstrukty innymi pozycjami, więc ich średnie nie leżą na wspólnej skali. Ciekawsze pytania dotyczą związku między podskalami, różnic między grupami w każdej podskali osobno albo interakcji obu wymiarów.
Powiązane hasła
Przeczytaj też
Jak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikSkala SWLS – jak policzyć wynik
Pięć pozycji 1–7 i suma 5–35, braki, interpretacja bez progów diagnostycznych, alfa, omega i jednoczynnikowa CFA w R z opisem do pracy.
Czytaj →PoradnikStatystyka dla psychologa
Analizy w pracy dyplomowej z psychologii: typowe projekty, wynik kwestionariusza, alfa i omega, normy i steny, eksperyment i raport APA – z danymi i kodem R.
Czytaj →PoradnikLOT-R – test orientacji życiowej: jak policzyć wynik
Pozycje wypełniające, odwracanie, suma 0–24, podwyniki optymizmu i pesymizmu, rzetelność i CFA – z przykładem w R i wzorem opisu w pracy.
Czytaj →Badasz poczucie sensu życia i nie wiesz, jak policzyć MLQ?
Sprawdzimy przydział pozycji, kodowanie i braki, rzetelność obu podskal oraz dobór analiz i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Kossakowska, M., Kwiatek, P., & Stefaniak, T. (2014). Sens w życiu. Polska wersja kwestionariusza MLQ (Meaning in Life Questionnaire). Psychologia Jakości Życia, 12(2), 111–131. https://doi.org/10.5604/16441796.1090786
- Le Vaou, P., Goetz, C., Bernaud, J.-L., Evrard, R., Bougteu Timmamo, H., Cacciamani, R., Guitter, M., Valero, B., & Steger, M. F. (2026). Validation of the French version of the Meaning of Life Questionnaire (MLQ) in patients admitted for crisis hospitalization in a psychiatric emergency service (crisis center). L'Encéphale, 52(3), 241–249. https://doi.org/10.1016/j.encep.2025.09.001 ● Otwarty dostęp
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Mijalevich-Soker, E., Ring, L., Joffe, E., Awad-Yaseen, M., Steger, M. F., & Taubman-Ben-Ari, O. (2025). Personal growth among pregnant women during war: The role of optimism and meaning in life. International Journal of Psychology, 60(4), Article e70087. https://doi.org/10.1002/ijop.70087 ● Otwarty dostęp
- Steger, M. F. (b.d.). Michael F. Steger – Meaning in Life Questionnaire, WAMI and 3DM (free tools). Michael F. Steger. Pobrano 1 listopada 2026 z https://michaelfsteger.com/ ● Otwarty dostęp
- Steger, M. F., Frazier, P., Oishi, S., & Kaler, M. (2006). The Meaning in Life Questionnaire: Assessing the presence of and search for meaning in life. Journal of Counseling Psychology, 53(1), 80–93. https://doi.org/10.1037/0022-0167.53.1.80
- Steger, M. F., Kashdan, T. B., Sullivan, B. A., & Lorentz, D. (2008). Understanding the search for meaning in life: Personality, cognitive style, and the dynamic between seeking and experiencing meaning. Journal of Personality, 76(2), 199–228. https://doi.org/10.1111/j.1467-6494.2007.00484.x
- Steger, M. F., Oishi, S., & Kashdan, T. B. (2009). Meaning in life across the life span: Levels and correlates of meaning in life from emerging adulthood to older adulthood. The Journal of Positive Psychology, 4(1), 43–52. https://doi.org/10.1080/17439760802303127
Cytowania BibTeX
@article{kossakowska2014sens, author={Kossakowska, Marlena and Kwiatek, Piotr and Stefaniak, Tomasz}, title={{Sens w życiu. Polska wersja kwestionariusza MLQ (Meaning in Life Questionnaire)}}, journal={Psychologia Jakości Życia}, year={2014}, volume={12}, number={2}, pages={111--131}, doi={10.5604/16441796.1090786}}@article{levaou2026validation, author={Le Vaou, Pascal and Goetz, Christophe and Bernaud, Jean-Luc and Evrard, Renaud and Bougteu Timmamo, Hermine and Cacciamani, Roberta and Guitter, Marie and Valero, Bertrand and Steger, Michael F.}, title={{Validation of the French version of the Meaning of Life Questionnaire (MLQ) in patients admitted for crisis hospitalization in a psychiatric emergency service (crisis center)}}, journal={L'Encéphale}, year={2026}, volume={52}, number={3}, pages={241--249}, doi={10.1016/j.encep.2025.09.001}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{mijalevichsoker2025personal, author={Mijalevich-Soker, Elad and Ring, Lia and Joffe, Esther and Awad-Yaseen, Maram and Steger, Michael F. and Taubman-Ben-Ari, Orit}, title={{Personal growth among pregnant women during war: The role of optimism and meaning in life}}, journal={International Journal of Psychology}, year={2025}, volume={60}, number={4}, eid={e70087}, doi={10.1002/ijop.70087}}@misc{stegermlqweb, author={Steger, Michael F.}, title={{Michael F. Steger – Meaning in Life Questionnaire, WAMI and 3DM (free tools)}}, publisher={Michael F. Steger}, url={https://michaelfsteger.com/}}@article{steger2006meaning, author={Steger, Michael F. and Frazier, Patricia and Oishi, Shigehiro and Kaler, Matthew}, title={{The Meaning in Life Questionnaire: Assessing the presence of and search for meaning in life}}, journal={Journal of Counseling Psychology}, year={2006}, volume={53}, number={1}, pages={80--93}, doi={10.1037/0022-0167.53.1.80}}@article{steger2008understanding, author={Steger, Michael F. and Kashdan, Todd B. and Sullivan, Brandon A. and Lorentz, Danielle}, title={{Understanding the search for meaning in life: Personality, cognitive style, and the dynamic between seeking and experiencing meaning}}, journal={Journal of Personality}, year={2008}, volume={76}, number={2}, pages={199--228}, doi={10.1111/j.1467-6494.2007.00484.x}}@article{steger2009meaning, author={Steger, Michael F. and Oishi, Shigehiro and Kashdan, Todd B.}, title={{Meaning in life across the life span: Levels and correlates of meaning in life from emerging adulthood to older adulthood}}, journal={The Journal of Positive Psychology}, year={2009}, volume={4}, number={1}, pages={43--52}, doi={10.1080/17439760802303127}}