Czym jest Flourishing Scale
Flourishing Scale (FS) to krótka skala samoopisowa, którą Diener i in. (2010) opisali razem ze skalą uczuć pozytywnych i negatywnych SPANE. Autorzy przedstawiają FS jako 8-pozycyjną, zbiorczą miarę tego, jak badany ocenia swoje powodzenie w ważnych obszarach życia: w relacjach, w poczuciu własnej wartości, w poczuciu celu i w optymizmie. Skala daje jeden wynik dobrostanu psychicznego. Właściwości obu skal sprawdzono w próbie 689 studentów z sześciu ośrodków. FS miała dobre właściwości psychometryczne i silnie wiązała się z innymi skalami dobrostanu psychicznego (Diener i in., 2010).
W pracach dyplomowych FS pojawia się najczęściej w psychologii (dobrostan a stres, wsparcie społeczne, cele życiowe) i w pedagogice (dobrostan uczniów, studentów i nauczycieli, ewaluacja programów profilaktycznych). Typowe analizy w tych dziedzinach opisują poradniki statystyka dla psychologa i statystyka w pracy z pedagogiki. Ten wpis należy do serii o liczeniu wyników kwestionariuszy. FS często stoi w jednej baterii ze skalą SWLS tego samego autora. SWLS mierzy jednak ogólny sąd o zadowoleniu z życia, a FS – samoocenę funkcjonowania w kilku obszarach. Inną popularną miarę dobrostanu psychicznego opisuje wpis o WEMWBS i SWEMWBS.
Budowa: 8 pozycji, jeden wynik
Instrukcja, skala odpowiedzi i klucz są w aneksie oryginalnego artykułu (Diener i in., 2010). Każda pozycja jest stwierdzeniem o sobie, a badany zaznacza stopień zgody na skali od 1 (zdecydowany brak zgody) do 7 (zdecydowana zgoda), ze środkiem 4. Treści pozycji nie przytaczamy. Formularz i tłumaczenia znajdziesz na oficjalnej stronie autora (Diener, b.d.).
| Cecha | Flourishing Scale |
|---|---|
| Liczba pozycji | 8 |
| Skala odpowiedzi | 1–7 (stopień zgody) |
| Wynik | suma wszystkich pozycji |
| Zakres wyniku | 8–56 |
| Kierunek | wyższy wynik = więcej zasobów i mocnych stron psychicznych |
| Pozycje odwrócone | brak |
| Podskale | brak |
| Progi w publikacji i na stronie autora | brak |
Hone i in. (2014) sprawdzili FS na reprezentatywnej próbie ponad 10 tysięcy mieszkańców Nowej Zelandii. Analiza eksploracyjna i konfirmacyjna potwierdziły jeden czynnik. To ważne dla liczenia wyniku: skoro skala jest jednowymiarowa, sensowne jest sumowanie wszystkich ośmiu pozycji. Nie ma podstaw, żeby wydzielać z niej podskale „relacji” czy „celu”.
Jak policzyć wynik Flourishing Scale krok po kroku
Krok 1. Sprawdź kodowanie 1–7
W danych powinny być tylko liczby od 1 do 7, gdzie 7 oznacza najsilniejszą zgodę. Formularze online potrafią zapisać odpowiedzi jako 0–6 albo w odwrotnej kolejności, jeśli na ekranie skala zaczynała się od „zgadzam się”. Zrób test z kilkoma odpowiedziami i porównaj eksport z tym, co klikałeś (klikałaś). Przekodowanie w różnych programach opisuje poradnik jak policzyć wynik kwestionariusza.
Krok 2. Nie odwracaj żadnej pozycji
Wszystkie pozycje FS są sformułowane w kierunku dobrostanu. Klucz w aneksie każe po prostu dodać odpowiedzi ze wszystkich ośmiu pozycji (Diener i in., 2010). Ogólne zasady pracy z pozycjami odwróconymi tu więc nie mają zastosowania. Jeśli Twoja wersja językowa zawiera pozycje sformułowane negatywnie, to nie jest wersja oryginalna i klucz musisz wziąć od jej autorów.
Krok 3. Policz sumę z 8 pozycji
Autorzy podają wynik jako sumę i w tej formie warto go raportować, bo tylko wtedy porównasz się z innymi badaniami. Jeśli potrzebujesz wyniku na skali odpowiedzi, podziel sumę przez 8. Do porównań z innymi skalami przydaje się też POMP, czyli procent maksymalnego możliwego wyniku: (suma − 8) / 48 × 100. Pojedynczy wynik sprawdzisz w kalkulatorze wyniku skali.
Krok 4. Ustal regułę dla braków przed analizą
Ani artykuł, ani strona autora nie podają reguły dla brakujących odpowiedzi. Musisz ją ustalić sam(a) przed analizą i opisać w pracy. Przy ośmiu pozycjach rozsądne jest dopuszczenie najwyżej jednego braku: liczysz średnią z siedmiu odpowiedzi i mnożysz ją przez 8, żeby wynik pozostał na skali 8–56. Takie uzupełnianie zakłada, że brakująca pozycja zachowuje się jak pozostałe. Mazza i in. (2015) pokazali, że może ono obciążać wyniki nawet przy brakach całkowicie losowych. Przy pojedynczych brakach to zwykle akceptowalne uproszczenie. Więcej o decyzjach dotyczących braków piszemy we wpisie braki danych w ankiecie.
Interpretacja: bez progów i bez polskich norm
Wyższy wynik oznacza, że osoba ocenia swoje funkcjonowanie w ważnych obszarach życia korzystniej. Według aneksu do artykułu wysoki wynik opisuje osobę z wieloma zasobami i mocnymi stronami psychicznymi (Diener i in., 2010). Ani publikacja, ani strona autora nie podają punktów odcięcia. Nie ma więc oficjalnego „niskiego dobrostanu” ani grupy ryzyka. Analizuj wynik jako zmienną ciągłą: w korelacjach, regresji albo porównaniu grup. Nie dziel próby na „rozkwitających” i „nierozkwitających” medianą własnej próby. Dlaczego, wyjaśniamy w poradniku niski, przeciętny, wysoki wynik i w haśle o podziale medianą.
Hone i in. (2014) opublikowali normy populacyjne, ale dotyczą one mieszkańców Nowej Zelandii. Nie są normami testowymi dla Polski i nie służą do klasyfikowania osób z Twojej próby. Średnią z artykułu zagranicznego możesz najwyżej przytoczyć jako tło w dyskusji, z nazwą kraju i rodzajem próby.
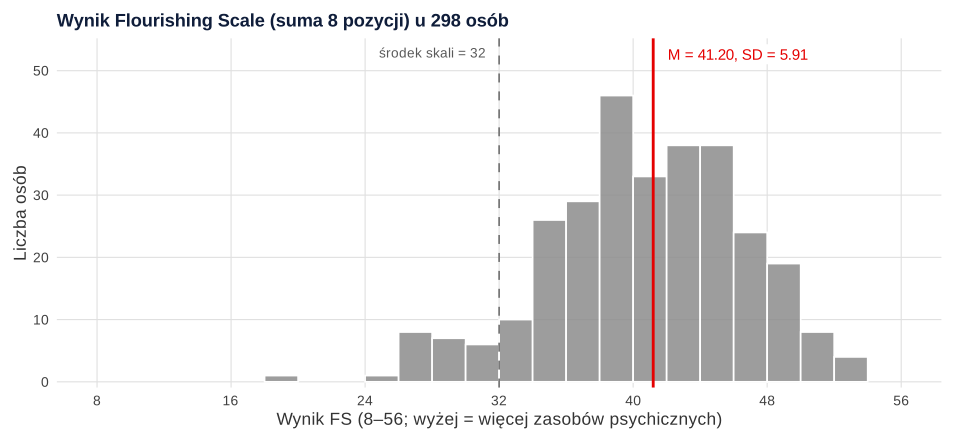
Jeśli odpowiedzi skupiają się powyżej środka skali, rozkład będzie lewoskośny – tak było w naszym przykładzie. Zanim wybierzesz test, obejrzyj histogram i sprawdź, czy nie ma efektu sufitu. Duża część osób z wynikiem bliskim 56 zaniża wariancję i osłabia korelacje.
Przykład: Flourishing Scale u 300 osób studiujących
Dane są symulowane i możesz je pobrać jako plik CSV. Zawierają odpowiedzi 1–7 na 8 pozycji (f1–f8) i wynik SWLS (suma 5–35). Pięć osób pominęło jedną pozycję, więc ich wynik policzyliśmy ze średniej siedmiu odpowiedzi pomnożonej przez 8. Dwie osoby pominęły po trzy pozycje i nie dostały wyniku. Wynik FS ma więc 298 osób.
| Statystyka | Wartość |
|---|---|
| n z wynikiem | 298 |
| M (SD) | 41.20 (5.91) |
| Me [min, max] | 42 [19, 54] |
| Średnia na pozycję / POMP | 5.15 / 69.2% |
| Skośność | −0.47 |
| α Cronbacha [95% CI] (n = 293) | .83 [.80, .86] |
| ω total (CFA, jeden czynnik) | .83 |
| Korelacje pozycja–całość (skorygowane) | .48–.66 |
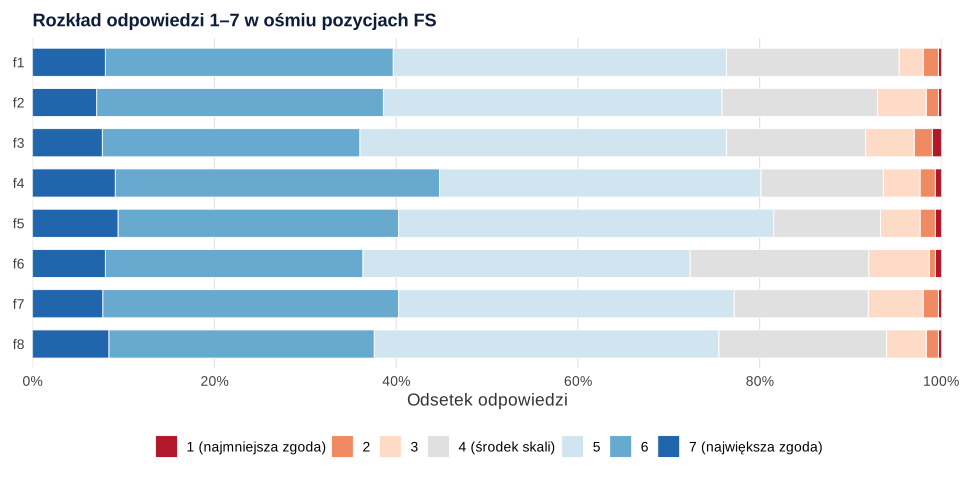
Średnia 41.20 leży wyraźnie powyżej środka skali (32), a rozkład jest lekko lewoskośny (rysunek 1). Nikt nie uzyskał maksymalnych 56 punktów, a 13.8% osób miało co najmniej 48 punktów. Efekt sufitu jest więc umiarkowany. W każdej pozycji od 36.0% do 44.8% odpowiedzi to 6 albo 7 (rysunek 2).
Rzetelność i struktura
Alfa Cronbacha wyniosła .83, a omega McDonalda .83. Omegę policzyliśmy z ładunków jednoczynnikowej CFA z estymatorem MLR. Ładunki standaryzowane wyniosły od .52 do .74, a model pasował do danych bardzo dobrze: χ²(20) = 16.03, CFI = 1.000, RMSEA = .000, SRMR = .026. Alfa zakłada równe ładunki pozycji, dlatego obok niej warto podać omegę (McNeish, 2018). Tu obie wartości są równe, bo ładunki różnią się niewiele. Omegę z własnych ładunków policzysz w kalkulatorze alfy i omegi. Przy skośnych odpowiedziach na skali 7-punktowej możesz też rozważyć CFA dla zmiennych porządkowych (WLSMV w lavaan).
Związek z zadowoleniem z życia
Wynik FS korelował dodatnio z wynikiem SWLS: r = .58, 95% CI [.50, .65], p < .001, n = 298. Korelacja Spearmana była podobna (ρ = .55), więc wynik nie zależy od kilku skrajnych obserwacji. Dwie miary dobrostanu są wyraźnie powiązane, ale nie zamienne. Korelacja .58 oznacza około jednej trzeciej wspólnej wariancji. Taki wynik możesz opisać jako dowód trafności zbieżnej, ale nie jako dowód, że to jedna i ta sama cecha. Diener i in. (1985) zbudowali SWLS jako wąską miarę globalnego zadowolenia z życia, a FS obejmuje kilka obszarów funkcjonowania.
Jak opisać Flourishing Scale w pracy
Wzór zawiera liczby z przykładu. W nawiasach kwadratowych uzupełnij dane wersji, której używasz.
Ogólny schemat opisu narzędzia znajdziesz w poradniku opis narzędzia badawczego – wzór, a zdania o rzetelności we wzorze raportowania alfy Cronbacha.
Licencja i polska wersja
Aneks oryginalnego artykułu mówi, że FS i SPANE są chronione prawem autorskim, ale można ich używać bez proszenia o zgodę, pod warunkiem właściwego podania źródła. Autorzy nie odpowiadają na indywidualne prośby o zgodę, bo zgoda jest udzielona w samym artykule. Jako źródło skali należy cytować ten artykuł (Diener i in., 2010). Oficjalna strona autora dodaje jedno ograniczenie: skala jest dostępna wyłącznie do celów niekomercyjnych (Diener, b.d.; odczyt 1 listopada 2026). Praca dyplomowa jest użyciem niekomercyjnym. Badanie zlecone przez firmę już nie musi nim być, więc w takim przypadku sprawdź warunki u źródła.
Uwaga na opis bibliograficzny na stronie autora. Podaje on DOI artykułu z 2010 roku, ale rok, tom i strony pochodzą z innej publikacji z 2009 roku. W bibliografii użyj danych artykułu z czasopisma Social Indicators Research (tom 97, strony 143–156).
Strona autora udostępnia tłumaczenia FS, w tym polskie. Nie zweryfikowaliśmy publikacji walidacyjnej polskiej wersji, więc nie podajemy jej właściwości ani norm. Jeśli z niej korzystasz, zacytuj źródło, z którego ją wziąłeś (wzięłaś). Nie przypisuj jej rzetelności z badań zagranicznych. Własny przekład wymaga procedury opisanej we wpisie adaptacja kulturowa kwestionariusza. Gdzie szukać innych narzędzi, podpowiada poradnik gdzie znaleźć kwestionariusze psychologiczne.
Flourishing Scale w R: wynik, braki, rzetelność i trafność zbieżna
Kod odtwarza liczby z tekstu i zapisuje plik CSV z danymi. Wynik to suma ośmiu pozycji; przy jednym braku – średnia dostępnych pozycji pomnożona przez 8. Alfę z przedziałem Feldta liczy pakiet psych, a model jednoczynnikowy – lavaan.
Wynik Flourishing Scale krok po kroku
R
# B277 – Flourishing Scale: suma 8–56, braki, rozkład, rzetelność (alfa, omega), CFA, związek z SWLS (dane symulowane, set.seed(27701)).
# 300 osób studiujących; odpowiedzi 1–7 na 8 pozycji (f1–f8). Treści pozycji nie podajemy.
# Klucz z aneksu oryginalnej publikacji (Diener i in., 2010): suma odpowiedzi 1–7 na 8 pozycjach, zakres 8–56,
# wyższy wynik = więcej zasobów psychicznych; brak pozycji odwróconych i brak progów.
# Reguła braków (najwyżej 1 brak z 8, wynik = średnia dostępnych pozycji × 8) jest decyzją badacza, nie autorów.
suppressPackageStartupMessages({ library(psych); library(lavaan) })
set.seed(27701)
n <- 300
eta <- rnorm(n)                                            # rozkwit (cecha latentna)
lam <- c(.72, .63, .70, .58, .66, .61, .69, .55)
progi <- c(-2.7, -2.1, -1.5, -0.8, 0.2, 1.3)               # przesunięte w dół: odpowiedzi skupiają się na 5–6
odp <- sapply(lam, function(l) 1 + findInterval(l * eta + rnorm(n, 0, sqrt(1 - l^2)), progi))
colnames(odp) <- paste0("f", 1:8)
# SWLS (5 pozycji 1–7, suma 5–35) – symulowana miara zadowolenia z życia do sprawdzenia trafności zbieżnej
swls <- round(pmin(35, pmax(5, 24 + 4.2 * (.65 * eta + rnorm(n, 0, sqrt(1 - .65^2))))))
dane <- data.frame(id = 1:n, odp, swls = swls)
dane$f4[c(15, 102, 188)] <- NA; dane$f8[c(61, 240)] <- NA          # pojedyncze braki
dane[c(133, 271), c("f2", "f5", "f7")] <- NA                       # 3 braki u 2 osób
write.csv(dane, "../flourishing-dane-przyklad.csv", row.names = FALSE, na = "")   # plik do pobrania
poz <- paste0("f", 1:8)

# Krok 1. Kontrola kodowania (tylko 1–7 albo brak) i liczba braków na osobę
all(sapply(dane[, poz], function(x) all(x %in% c(1:7, NA))))
table(rowSums(is.na(dane[, poz])))

# Krok 2. Wynik FS: suma 8 pozycji; przy 1 braku – średnia dostępnych pozycji × 8 (reguła tego przykładu)
k <- rowSums(is.na(dane[, poz]))
dane$FS <- ifelse(k == 0, rowSums(dane[, poz]), ifelse(k == 1, 8 * rowMeans(dane[, poz], na.rm = TRUE), NA))
sum(is.na(dane$FS))
x <- na.omit(dane$FS)
round(c(n = length(x), M = mean(x), SD = sd(x), Me = median(x), min = min(x), max = max(x),
        skosnosc = skew(x), proc_56 = 100 * mean(x == 56), proc_od_48 = 100 * mean(x >= 48),
        M_pozycji = mean(x) / 8, POMP = 100 * (mean(x) - 8) / 48), 2)

# Krok 3. Rozkład odpowiedzi: odsetek odpowiedzi 6 i 7 w każdej pozycji
round(100 * colMeans(dane[, poz] >= 6, na.rm = TRUE), 1)

# Krok 4. Rzetelność: alfa z 95% CI Feldta i skorygowane korelacje pozycja–całość (komplet odpowiedzi)
pel <- dane[complete.cases(dane[, poz]), ]
nrow(pel)
a <- alpha(pel[, poz], warnings = FALSE)
round(c(alfa = a$total$raw_alpha, lo = a$feldt$lower.ci[[1]], hi = a$feldt$upper.ci[[1]]), 3)
round(range(a$item.stats$r.drop), 2)

# Krok 5. Jeden czynnik w CFA (MLR) i omega total z ładunków standaryzowanych
f1 <- cfa(paste("Rozkwit =~", paste(poz, collapse = " + ")), data = pel, estimator = "MLR", std.lv = TRUE)
round(fitMeasures(f1, c("chisq.scaled", "df.scaled", "cfi.robust", "rmsea.robust", "srmr")), 3)
st <- standardizedSolution(f1); L <- st$est.std[st$op == "=~"]
round(range(L), 2)
round(c(omega = sum(L)^2 / (sum(L)^2 + sum(1 - L^2))), 3)

# Krok 6. Trafność zbieżna: korelacja Pearsona i Spearmana z wynikiem SWLS
d6 <- dane[!is.na(dane$FS), ]
ct <- cor.test(d6$FS, d6$swls)
c(pearson = round(unname(ct$estimate), 2), lo = round(ct$conf.int[1], 2), hi = round(ct$conf.int[2], 2), n = nrow(d6))
ct$p.value < .001
round(cor(d6$FS, d6$swls, method = "spearman"), 2)
Wynik w R
[1] TRUE

  0   1   3
293   5   2
[1] 2
         n          M         SD         Me        min        max   skosnosc    proc_56 proc_od_48
    298.00      41.20       5.91      42.00      19.00      54.00      -0.47       0.00      13.76
 M_pozycji       POMP
      5.15      69.16
  f1   f2   f3   f4   f5   f6   f7   f8
39.7 38.6 36.0 44.8 40.3 36.3 40.3 37.6
[1] 293
 alfa    lo    hi
0.831 0.800 0.859
[1] 0.48 0.66
chisq.scaled    df.scaled   cfi.robust rmsea.robust         srmr
      16.028       20.000        1.000        0.000        0.026
[1] 0.52 0.74
omega
0.833
pearson      lo      hi       n
   0.58    0.50    0.65  298.00
[1] TRUE
[1] 0.55
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy Flourishing Scale
- Odwracanie pozycji „na wszelki wypadek”. W oryginalnej wersji nie ma pozycji odwróconych. Klucz to suma wszystkich ośmiu odpowiedzi.
- Średnia zamiast sumy bez słowa wyjaśnienia. Średnia 1–7 nie jest błędem, ale autorzy podają sumę 8–56. Jeśli raportujesz średnią, napisz to wprost.
- Wymyślone progi. Publikacja i strona autora nie podają kategorii. Kwartyle albo „powyżej 40” z własnej próby nie są normą.
- Normy z innego kraju. Normy nowozelandzkie nie mówią, czy wynik studenta w Polsce jest wysoki.
- Podskale z ośmiu pozycji. Skala jest jednowymiarowa. Pojedynczych pozycji nie interpretuj jako osobnych wymiarów.
- Pominięcie skośności. Przy dużym skupieniu wyników przy górnej granicy sprawdź rozkład i rozważ metody odporne.
Pełną ścieżkę analizy kwestionariusza, od kodowania po rzetelność, porządkuje przewodnik po analizie kwestionariusza. Jeśli chcesz, żeby ktoś sprawdził liczenie wyniku FS w Twojej bazie, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Czy we Flourishing Scale są pozycje odwrócone?
Nie. Wszystkie osiem pozycji jest sformułowanych w kierunku dobrostanu, a klucz z aneksu oryginalnego artykułu to suma wszystkich odpowiedzi (Diener i in., 2010). Sprawdź tylko, czy eksport z ankiety online zapisuje odpowiedzi jako 1–7, gdzie 7 oznacza najsilniejszą zgodę.
Jaki wynik Flourishing Scale oznacza niski dobrostan?
Autorzy nie podają punktów odcięcia, więc nie ma oficjalnej granicy niskiego dobrostanu. Opisuj wynik jako sumę 8–56 i analizuj go jako zmienną ciągłą. Normy z Nowej Zelandii (Hone i in., 2014) nie są normami dla Polski.
Czy wynik Flourishing Scale to suma czy średnia?
W oryginalnej publikacji wynik to suma (8–56). Średnia (suma podzielona przez 8, zakres 1–7) zawiera tę samą informację, ale trudniej ją porównać z literaturą. Jeśli podajesz średnią, napisz to wyraźnie w opisie narzędzia.
Czy na użycie Flourishing Scale w pracy magisterskiej potrzebna jest zgoda?
Nie. Aneks do artykułu Dienera i in. (2010) udziela zgody na użycie pod warunkiem podania źródła, a autorzy nie odpowiadają na indywidualne prośby. Oficjalna strona autora zastrzega, że skala jest do celów niekomercyjnych, a praca dyplomowa się w nich mieści.
Czym Flourishing Scale różni się od SWLS?
SWLS mierzy jeden ogólny sąd o zadowoleniu z życia, a Flourishing Scale – samoocenę funkcjonowania w kilku obszarach, takich jak relacje, poczucie celu i optymizm. Obie skale zwykle wyraźnie korelują, ale nie są zamienne. Jeśli używasz obu, raportuj je jako osobne zmienne.
Powiązane hasła
Przeczytaj też
Jak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikSkala SWLS – jak policzyć wynik
Pięć pozycji 1–7 i suma 5–35, braki, interpretacja bez progów diagnostycznych, alfa, omega i jednoczynnikowa CFA w R z opisem do pracy.
Czytaj →PoradnikWEMWBS i SWEMWBS – jak policzyć wynik
Suma 14–70, przeliczenie SWEMWBS na wynik metryczny, progi ze strony autorów, licencja i minimalna zmiana – z przykładem w R i wzorem opisu.
Czytaj →PoradnikLOT-R – test orientacji życiowej: jak policzyć wynik
Pozycje wypełniające, odwracanie, suma 0–24, podwyniki optymizmu i pesymizmu, rzetelność i CFA – z przykładem w R i wzorem opisu w pracy.
Czytaj →PoradnikMLQ – poczucie sensu życia: jak policzyć wynik
Obecność i poszukiwanie sensu jako dwie średnie 1–7, skąd wziąć klucz, brak progów, rzetelność, CFA i interakcja – z przykładem w R i wzorem opisu.
Czytaj →PoradnikMSLQ – jak policzyć wynik
Motywacja i strategie uczenia się: 15 podskal bez wyniku ogólnego, wybór podskal, średnie pozycji i klucz z podręcznika – z przykładem w R i wzorem opisu.
Czytaj →Masz wyniki Flourishing Scale i nie wiesz, jak je opisać?
Sprawdzimy kodowanie odpowiedzi, wynik i rzetelność skali w Twojej próbie oraz wyjaśnimy analizy tak, żebyś umiał(a) samodzielnie opisać i obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Diener, E. (b.d.). Flourishing Scale (FS). Ed Diener. https://eddiener.com/flourishing-scale-fs/ ● Otwarty dostęp
- Diener, E., Emmons, R. A., Larsen, R. J., & Griffin, S. (1985). The Satisfaction With Life Scale. Journal of Personality Assessment, 49(1), 71–75. https://doi.org/10.1207/s15327752jpa4901_13
- Diener, E., Wirtz, D., Tov, W., Kim-Prieto, C., Choi, D., Oishi, S., & Biswas-Diener, R. (2010). New well-being measures: Short scales to assess flourishing and positive and negative feelings. Social Indicators Research, 97(2), 143–156. https://doi.org/10.1007/s11205-009-9493-y
- Hone, L., Jarden, A., & Schofield, G. (2014). Psychometric properties of the Flourishing Scale in a New Zealand sample. Social Indicators Research, 119(2), 1031–1045. https://doi.org/10.1007/s11205-013-0501-x
- Mazza, G. L., Enders, C. K., & Ruehlman, L. S. (2015). Addressing item-level missing data: A comparison of proration and full information maximum likelihood estimation. Multivariate Behavioral Research, 50(5), 504–519. https://doi.org/10.1080/00273171.2015.1068157 ● Otwarty dostęp: pełny tekst
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
Cytowania BibTeX
@misc{dienerndfs, author={Diener, Ed}, title={{Flourishing Scale (FS)}}, howpublished={Ed Diener}, year={b.d.}, url={https://eddiener.com/flourishing-scale-fs/}}@article{diener1985satisfaction, author={Diener, Ed and Emmons, Robert A. and Larsen, Randy J. and Griffin, Sharon}, title={{The Satisfaction With Life Scale}}, journal={Journal of Personality Assessment}, year={1985}, volume={49}, number={1}, pages={71--75}, doi={10.1207/s15327752jpa4901_13}}@article{diener2010new, author={Diener, Ed and Wirtz, Derrick and Tov, William and Kim-Prieto, Chu and Choi, Dong-won and Oishi, Shigehiro and Biswas-Diener, Robert}, title={{New well-being measures: Short scales to assess flourishing and positive and negative feelings}}, journal={Social Indicators Research}, year={2010}, volume={97}, number={2}, pages={143--156}, doi={10.1007/s11205-009-9493-y}}@article{hone2014psychometric, author={Hone, Lucy and Jarden, Aaron and Schofield, Grant}, title={{Psychometric properties of the Flourishing Scale in a New Zealand sample}}, journal={Social Indicators Research}, year={2014}, volume={119}, number={2}, pages={1031--1045}, doi={10.1007/s11205-013-0501-x}}@article{mazza2015addressing, author={Mazza, Gina L. and Enders, Craig K. and Ruehlman, Linda S.}, title={{Addressing item-level missing data: A comparison of proration and full information maximum likelihood estimation}}, journal={Multivariate Behavioral Research}, year={2015}, volume={50}, number={5}, pages={504--519}, doi={10.1080/00273171.2015.1068157}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}