Pięć typowych projektów w pracy z farmacji
Prace dyplomowe z farmacji z częścią ilościową najczęściej powstają w aptece ogólnodostępnej albo wśród jej pacjentów. Pytasz pacjentów, co wiedzą o swoich lekach, mierzysz, czy przyjmują je zgodnie z zaleceniami, sprawdzasz efekt konsultacji z farmaceutą albo porównujesz sposób obsługi w różnych aptekach. Każdy z tych projektów ma inną jednostkę analizy i inny typ zmiennej zależnej, dlatego wymaga innego testu. Tabela porządkuje pięć projektów omówionych w tym poradniku. Wszystkie liczby pochodzą z danych symulowanych, które możesz pobrać jako plik XLSX z pięcioma arkuszami.
| Projekt | Typowe pytanie | Zmienne | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Wiedza pacjentów o lekach | Czego pacjenci nie wiedzą o swoich lekach i od czego to zależy? | 10 pytań poprawna/błędna, wynik 0–10, wiek, wykształcenie | odsetki z 95% CI, test Manna–Whitneya, regresja logistyczna dla liczby poprawnych odpowiedzi | korelacja rangowo-dwuseryjna, OR |
| 2. Adherencja deklarowana | Co wiąże się z przestrzeganiem zaleceń? | przestrzega tak/nie, liczba leków, przypomnienia | regresja logistyczna | OR z 95% CI |
| 3. Konsultacja farmaceutyczna przed i po | Czy po konsultacji wzrosła wiedza i odsetek przestrzegających? | wiedza 0–10 i adherencja u tych samych osób dwa razy | test t dla prób zależnych, test McNemara | dz, różnica odsetków z 95% CI |
| 4. Porównanie aptek (pacjent symulowany) | Czy w aptekach niezależnych częściej pytają o inne leki? | wizyty zagnieżdżone w aptekach, wynik tak/nie | analiza na poziomie apteki albo wielopoziomowa regresja logistyczna | OR, ICC |
| 5. Samoleczenie (ankieta) | Czy młodsi częściej sięgają po leki bez recepty bez porady? | grupa wieku, odpowiedź tak/nie, pytanie wielokrotnego wyboru | test chi-kwadrat, odsetki z 95% CI | V Craméra |
Jeśli Twój projekt wygląda inaczej, zacznij od kreatora doboru testu statystycznego: odpowiadasz na kilka pytań o zmienne i schemat, a kreator wskazuje test. Ogólny plan pracy, od hipotez do rozdziału wyników, opisuje przewodnik po statystyce w pracy dyplomowej.
Zanim zaczniesz: jednostka analizy, narzędzie i zgody
Ustal, kto lub co jest jednostką analizy. W ankiecie jest nią pacjent. W badaniu przed i po także pacjent, ale mierzony dwukrotnie, więc pomiary są zależne. W porównaniu aptek obserwacją jest wizyta, ale wizyty w tej samej aptece są do siebie podobne. Od tej decyzji zależy wybór testu, a błąd w tym miejscu najczęściej zmienia wnioski.
Narzędzie opisz tak, aby dało się je powtórzyć. Test wiedzy o lekach zwykle układasz sam. Podaj więc liczbę pytań, format odpowiedzi, sposób punktowania i źródło treści (np. charakterystyki produktów leczniczych albo ulotki), a przed badaniem właściwym przeprowadź pilotaż. Jak policzyć wynik testu wiedzy i ocenić trudność pytań, pokazujemy w poradniku o analizie ankiety wiedzy. Jeśli korzystasz z gotowej skali adherencji, sprawdź warunki licencji, bo część narzędzi jest chroniona prawami autorskimi i wymaga zgody autorów.
Statystyka nie zastępuje wiedzy farmaceutycznej. Ten poradnik dotyczy analizy danych. Nie zawiera zaleceń dotyczących stosowania leków, a pytania w przykładach są uproszczone. Treść testu wiedzy, kryteria problemów lekowych i zakres konsultacji ustal z promotorem na podstawie aktualnych źródeł farmaceutycznych.
Formalności załatw przed zbieraniem danych. Badanie pacjentów, a także badanie personelu aptek metodą pacjenta symulowanego, wymaga zwykle opinii komisji bioetycznej. Zasady zależą od uczelni, więc sprawdź je wcześniej. Nie zapisuj nazw aptek ani danych pozwalających zidentyfikować pracowników, a w pracy podawaj tylko wyniki zbiorcze.
Projekt 1. Wiedza pacjentów o lekach
Przykład: 180 pacjentów aptek odpowiada na 10 pytań typu prawda/fałsz o lekach, np. czy ta sama substancja czynna może występować pod różnymi nazwami handlowymi i czy leki bez recepty mogą wchodzić w interakcje z lekami na receptę. Każda poprawna odpowiedź to 1 punkt, więc wynik mieści się w zakresie 0–10. Pytania badawcze są dwa: czego pacjenci nie wiedzą i od czego zależy poziom wiedzy.
Najpierw pytania, potem wynik ogólny
W pracy farmaceutycznej najcenniejsza jest często informacja, której wiedzy brakuje. Sam wynik ogólny jej nie pokaże. Podaj więc odsetek poprawnych odpowiedzi w każdym pytaniu z 95% przedziałem ufności. Brown i in. (2001) pokazali, że zwykły przedział Walda dla proporcji bywa zawodny także przy dość dużych próbach, i zalecają m.in. przedział Wilsona (zob. przedział ufności dla proporcji). W przykładzie prawie wszyscy wiedzieli, na co przyjmują swój lek (88.9%, 95% CI [83.5, 92.7]). Najmniej osób wiedziało, że leki bez recepty mogą wchodzić w interakcje z lekami na receptę (32.2%, 95% CI [25.8, 39.4]). Taki ranking to gotowy materiał do dyskusji i rekomendacji dla opieki farmaceutycznej.
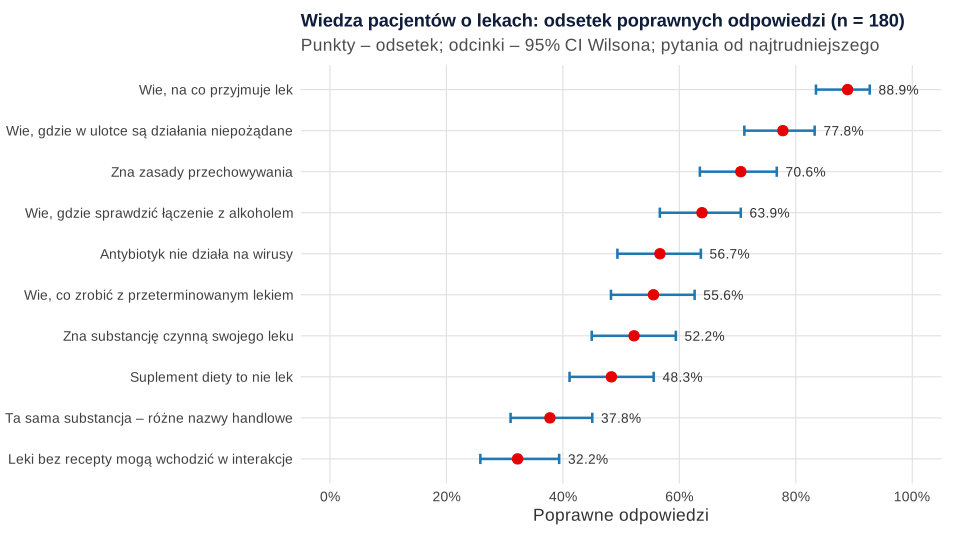
Wynik ogólny wynosił średnio 5.84 punktu (SD = 2.16, Me = 6, IQR 4–8), a komplet punktów zdobyło 2.2% osób. Rzetelność testu (KR-20, czyli alfa Cronbacha dla pozycji 0/1) wyniosła .60. Przy teście wiedzy to wynik częsty i nie musi dyskwalifikować narzędzia, bo pytania dotyczą różnych tematów i nie mierzą jednej cechy tak jak skala postaw. Podaj go jednak i skomentuj w ograniczeniach.
Porównanie grup i model dla liczby poprawnych odpowiedzi
Wynik 0–10 jest dyskretny i ograniczony, dlatego do porównania dwóch grup dobrze pasuje test Manna–Whitneya. Osoby przyjmujące 5 i więcej leków (n = 31) miały medianę 5 (IQR 4–7), a pozostałe (n = 149) medianę 6 (IQR 5–8), U = 2711, p = .125. Jako wielkość efektu podaj korelację rangowo-dwuseryjną: rrb = .17, 95% CI [−.05, .38]. Przedział obejmuje zero, ale też umiarkowane różnice, więc to wynik niejednoznaczny, a nie dowód braku różnicy.
Polipragmazja wiąże się z wiekiem, dlatego warto ocenić kilka czynników naraz. Liczbę poprawnych odpowiedzi z 10 możesz modelować regresją logistyczną dla danych dwumianowych. Model szacuje iloraz szans poprawnej odpowiedzi na pojedyncze pytanie. Sprawdź nadmierną dyspersję: stosunek statystyki Pearsona do liczby stopni swobody wyniósł 1.74, więc zamiast zwykłego modelu dwumianowego użyto wersji quasi-dwumianowej, która poszerza przedziały ufności. Po uwzględnieniu wieku i wykształcenia polipragmazja nie wiązała się z wiedzą (OR = 0.88, 95% CI [0.63, 1.24], p = .473). Każde 10 lat wieku wiązało się z mniejszymi szansami poprawnej odpowiedzi (OR = 0.89, 95% CI [0.82, 0.97], p = .009), a wykształcenie wyższe w porównaniu z podstawowym lub zawodowym – z większymi (OR = 1.95, 95% CI [1.42, 2.69], p < .001). Na licencjacie wystarczą odsetki i test Manna–Whitneya, a model jest dobrym rozszerzeniem w pracy magisterskiej.
Projekt 2. Adherencja: co dokładnie mierzysz?
Adherencja to ogólnie stopień, w jakim pacjent przestrzega ustalonego planu leczenia; w badaniach klinicznych to samo pojęcie dotyczy przestrzegania protokołu (zob. hasło adherencja). Zanim zaczniesz liczyć, nazwij, który jej aspekt mierzysz. Vrijens i in. (2012) proponują taksonomię, w której adherencja do leków ma trzy mierzalne fazy: rozpoczęcie leczenia, jego realizację zgodnie z zaleceniem i zakończenie. Pytanie „czy zdarza się Panu zapomnieć o leku” dotyczy realizacji, a pytanie o wykupienie nowej recepty – rozpoczęcia. W pracy podaj definicję i przypisz do niej narzędzie.
W pracach dyplomowych adherencję mierzy się zwykle kwestionariuszem samoopisowym. Stirratt i in. (2015) w przeglądzie takich miar piszą, że zwykle zawyżają one adherencję w porównaniu z innymi metodami: mają wysoką swoistość i niską czułość. Innymi słowy, osoba, która przyznaje się do pomijania leków, zwykle rzeczywiście je pomija, ale część osób deklarujących pełną adherencję jej nie przestrzega. Dochodzi do tego aprobata społeczna, szczególnie gdy ankietę wypełnia się przy farmaceucie. Anonimowość i pytania o konkretny, krótki okres przypominania zmniejszają ten problem.
Regresja logistyczna dla przestrzegania tak/nie
Przykład: 220 pacjentów leczonych przewlekle, z których 125 (56.8%, 95% CI [50.2, 63.2]) uzyskało w kwestionariuszu wynik oznaczający przestrzeganie zaleceń według progu przyjętego przez autorów narzędzia. Predyktory to liczba przyjmowanych leków, wiek, korzystanie z przypomnień (np. w telefonie) i wynik testu wiedzy. Przy zmiennej zależnej tak/nie właściwa jest regresja logistyczna, a wynikiem jest OR z 95% CI.
| Predyktor | OR | 95% CI | z | p |
|---|---|---|---|---|
| Liczba leków (o 1 więcej) | 0.80 | [0.67, 0.95] | −2.53 | .011 |
| Wiek (o 10 lat) | 1.25 | [0.96, 1.65] | 1.65 | .098 |
| Przypomnienia (tak vs nie) | 2.12 | [1.19, 3.84] | 2.51 | .012 |
| Wiedza o lekach (o 1 punkt) | 1.07 | [0.92, 1.24] | 0.88 | .377 |
Każdy dodatkowy lek wiązał się z mniejszymi szansami przestrzegania zaleceń, a korzystanie z przypomnień – z ponad dwukrotnie większymi. To związki, a nie efekty przyczynowe: osoby korzystające z przypomnień mogą różnić się od pozostałych także motywacją. Zadbaj o wystarczającą liczbę zdarzeń w mniej licznej kategorii: tu 95 osób nieprzestrzegających na 4 predyktory, czyli 23.8 na predyktor. Nie dziel też ciągłego wyniku kwestionariusza na „przestrzega/nie” własnym progiem, bo tracisz informację. Jeśli narzędzie nie ma progu, analizuj wynik jako liczbę.
Projekt 3. Konsultacja farmaceutyczna: pomiar przed i po
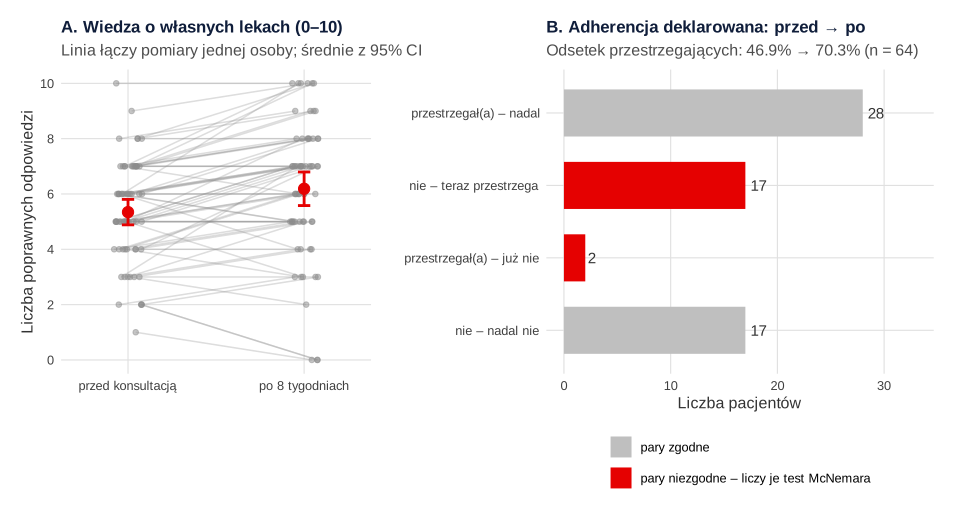
Opieka farmaceutyczna to według definicji Pharmaceutical Care Network Europe wkład farmaceuty w opiekę nad pacjentem, którego celem jest optymalizacja stosowania leków i poprawa wyników zdrowotnych (Allemann i in., 2014). W pracy dyplomowej ma zwykle postać konkretnej usługi, np. konsultacji z przeglądem przyjmowanych leków i edukacją. Najczęstszy schemat to pomiar u tych samych osób przed konsultacją i kilka tygodni po niej. Przykład: 64 pacjentów, wiedza o własnych lekach (0–10) i adherencja deklarowana (tak/nie) przed konsultacją i po 8 tygodniach. To pełny przykład w R w przepisie 2.
Wiedza: test t dla prób zależnych i dz
Każdy pacjent ma dwa wyniki, więc analizujesz różnice „po − przed” testem t dla prób zależnych. Wiedza wzrosła z 5.34 (SD = 1.84) do 6.19 punktu (SD = 2.43), średnio o 0.84 punktu, 95% CI [0.50, 1.19], t(63) = 4.92, p < .001. Wynik poprawił się u 64.1% pacjentów, a pogorszył u 15.6%. Wielkość efektu podaj jako dz, czyli średnią zmianę podzieloną przez odchylenie standardowe zmian: dz = 0.62, 95% CI [0.35, 0.88]. Lakens (2013) przypomina, że w schematach wewnątrzosobniczych istnieje kilka wersji d, a dz zależy od korelacji pomiarów (tu r = .83), więc w pracy nazwij miarę wprost. Test Wilcoxona dla par dał ten sam wniosek (p < .001).
Adherencja: test McNemara i różnica odsetków
Odsetek przestrzegających wzrósł z 46.9% do 70.3%. Te same osoby odpowiadały dwa razy, więc nie porównuj odsetków zwykłym testem chi-kwadrat. Właściwy jest test McNemara, który korzysta tylko z par niezgodnych: 17 osób zaczęło przestrzegać zaleceń, a 2 przestały. Fagerland i in. (2013) porównali warianty testu i odradzają zarówno test dokładny warunkowy, jak i wersję asymptotyczną z poprawką na ciągłość. Zalecają test mid-p albo wersję asymptotyczną bez poprawki. Tutaj χ²(1) = 11.84, p < .001. Obok podaj różnicę odsetków z 95% CI. Newcombe (1998) wykazał, że zwykły przedział Walda dla danych sparowanych działa źle, i zaproponował metodę opartą na przedziałach Wilsona. Różnica wyniosła 23.4 punktu procentowego, 95% CI [11.1, 34.6]. Wszystkie te liczby policzysz w kalkulatorze kappy i testu McNemara, a szerzej opisujemy je w poradniku test McNemara przed i po.
Czego ten schemat nie udowodni
Bez grupy porównawczej nie oddzielisz efektu konsultacji od samego faktu udziału w badaniu, powtórnego wypełniania tego samego testu i regresji do średniej. Barnett i in. (2005) opisują, że gdy do badania kwalifikuje się osoby z nietypowo złym wynikiem wyjściowym, kolejny pomiar wypada zwykle bliżej średniej nawet bez interwencji. W projekcie farmaceutycznym to realne ryzyko, bo na konsultację często kieruje się właśnie pacjentów z problemami z przyjmowaniem leków. Pisz więc „po konsultacji odsetek przestrzegających był wyższy”, a nie „konsultacja poprawia adherencję”. Schematy z grupą kontrolną i ich analizę omawia przewodnik po badaniach klinicznych i pomiarze przed i po.
Projekt 4. Porównanie aptek metodą pacjenta symulowanego
Pacjent symulowany to osoba przeszkolona do odegrania w aptece określonego scenariusza, np. prośby o lek bez recepty na ból głowy. Po wizycie zapisuje na liście kontrolnej, czy personel zadał konkretne pytania. Watson i in. (2006) w przeglądzie 46 badań uznali tę metodę za rzetelny sposób pomiaru praktyki aptecznej, o ile stosuje się ją właściwie. Przykład: 30 aptek (15 sieciowych i 15 niezależnych), w każdej 3 wizyty, razem 90 wizyt. Wynik wizyty to odpowiedź na pytanie, czy personel zapytał o inne przyjmowane leki.
Pułapka: 90 wizyt to nie 90 niezależnych obserwacji
W aptekach niezależnych zapytano w 64.4% wizyt, a w sieciowych w 40.0%. Zwykły test chi-kwadrat na 90 wizytach daje χ²(1) = 5.39, p = .020. Ten test zakłada jednak, że wizyty są niezależne, a w tej samej aptece pracuje ten sam personel. Killip i in. (2004) wyjaśniają, że podobieństwo obserwacji w grupie, mierzone współczynnikiem korelacji wewnątrzklasowej (ICC), zmniejsza efektywną liczebność próby. W przykładzie ICC wyniosło .49: wizyty w tej samej aptece były do siebie bardzo podobne.
Masz dwa poprawne rozwiązania. Prostsze to analiza na poziomie apteki: dla każdej apteki liczysz odsetek wizyt z pytaniem i porównujesz 15 i 15 aptek testem Manna–Whitneya. Średni odsetek wyniósł .40 w aptekach sieciowych i .64 w niezależnych, U = 72.5, p = .090, rrb = −.36, 95% CI [−.66, .05]. Drugie rozwiązanie to wielopoziomowa regresja logistyczna z efektem losowym apteki: OR = 5.05, 95% CI [0.81, 31.31], p = .082. Obie analizy prowadzą do tego samego wniosku: różnica może być duża, ale przy 30 aptekach oszacowanie jest bardzo niepewne. Błędny test na wizytach dawał fałszywie mocny wynik. Planując takie badanie, zwiększaj raczej liczbę aptek niż liczbę wizyt w jednej aptece.
Projekt 5. Ankieta o samoleczeniu
Przykład: 300 dorosłych w ankiecie internetowej odpowiada, czy w ostatnim miesiącu zastosowali lek bez recepty bez porady farmaceuty lub lekarza. Zaznaczają też wszystkie źródła, z których czerpią informacje o lekach bez recepty. Pierwsze pytanie analizujesz tabelą krzyżową, drugie jako pytanie wielokrotnego wyboru.
Bez porady sięgało po lek 59.3% osób w wieku 18–29 lat, 51.9% w wieku 30–49 lat i 26.9% osób w wieku 50 lat i więcej, χ²(2) = 20.56, p < .001, V Craméra = .26, 95% CI [.16, 1.00]. Górna granica 1.00 wynika z jednostronnego przedziału, który podaje pakiet effectsize. Która komórka odpowiada za wynik, pokazują reszty standaryzowane: w najstarszej grupie odpowiedzi „tak” było wyraźnie mniej, niż wynikałoby z niezależności (−4.40). Szczegóły testu znajdziesz w poradniku test chi-kwadrat krok po kroku, a dla dwóch grup możesz od razu użyć kalkulatora tabeli 2×2.
W pytaniu o źródła informacji każde źródło jest osobną zmienną tak/nie. Najczęściej wskazywano ulotkę (59.7%, 95% CI [54.0, 65.1]), farmaceutę (50.3%, 95% CI [44.7, 56.0]) i lekarza (46.3%), a najrzadziej reklamę (14.0%). Odsetki sumują się do 230.3%, bo respondent zaznaczał średnio 2.3 źródła. Napisz o tym pod tabelą, bo promotorzy często pytają, dlaczego suma przekracza 100%. Więcej o takich pytaniach przeczytasz w haśle analiza pytań wielokrotnego wyboru. Pamiętaj też, że ankieta rozesłana w internecie nie jest próbą losową, więc odsetków nie uogólniaj na wszystkich dorosłych.
Jak opisać analizę statystyczną w pracy
Rozdział o metodach powinien pozwolić innej osobie powtórzyć analizę. W pracy z farmacji opisz przede wszystkim jednostkę analizy, narzędzia (test wiedzy, kwestionariusz adherencji, listę kontrolną pacjenta symulowanego), sposób punktowania i rodzaj testów. Poniżej wzór akapitu dla projektów 1 i 3. Gotowe zdania z wynikami dla innych testów przygotujesz w generatorze opisu wyników APA, a podobny układ rozdziału dla pracy pielęgniarskiej pokazujemy we wpisie statystyka w pracy z pielęgniarstwa.
Jeśli potrzebujesz pomocy w doborze analiz do swojego projektu albo w odpowiedzi na uwagi promotora, możesz skonsultować je ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Analizy z pięciu projektów w R
Kod odtwarza wszystkie liczby z tego wpisu, a ostatni przepis – rysunki i plik XLSX do pobrania. Każdy przepis tworzy własne dane symulowane, więc możesz go uruchomić osobno. Najważniejszy jest przepis 2 z pełną analizą badania przed i po. Wielkości efektu liczy pakiet effectsize, rzetelność – pakiet psych, a model wielopoziomowy – pakiet lme4.
1. Projekty 1 i 2: wiedza o lekach i adherencja deklarowana
R
# Projekt 1: wiedza pacjentów o lekach (ankieta w aptekach) i projekt 2: adherencja deklarowana (dane symulowane).
# Projekt 1: 180 pacjentów odpowiada na 10 autorskich pytań prawda/fałsz o lekach (1 = poprawna odpowiedź).
suppressPackageStartupMessages(library(effectsize))
set.seed(22301)
n <- 180
wiek <- round(pmin(88, pmax(19, rnorm(n, 58, 15))))
polipragmazja <- factor(ifelse(runif(n) < plogis(-2.2 + 0.04 * (wiek - 40)), "5 i więcej leków", "mniej niż 5 leków"),
                        levels = c("mniej niż 5 leków", "5 i więcej leków"))
wyksztalcenie <- factor(sample(c("podstawowe/zawodowe", "średnie", "wyższe"), n, TRUE, prob = c(.30, .40, .30)),
                        levels = c("podstawowe/zawodowe", "średnie", "wyższe"))
umiejetnosc <- rnorm(n, 0.35 * (as.integer(wyksztalcenie) - 2) - 0.012 * (wiek - 58) + 0.30 * (polipragmazja == "5 i więcej leków"), 0.8)
trudnosc <- c(substancja = 0.2, wskazanie = -1.8, nazwy_handlowe = 0.6, alkohol = -0.4, przechowywanie = -0.9,
              przeterminowane = -0.2, interakcje_otc = 0.9, suplement = 0.4, ulotka = -1.2, antybiotyk = -0.3)
wiedza <- sapply(trudnosc, function(b) rbinom(n, 1, plogis(1.1 * umiejetnosc - b)))
p1 <- data.frame(id = 1:n, wiek, polipragmazja, wyksztalcenie, wiedza)
p1$wynik <- rowSums(wiedza)

# Odsetek poprawnych odpowiedzi w każdym pytaniu z 95% CI Wilsona
wilson <- function(k, n) { z <- qnorm(.975); p <- k / n; c0 <- p + z^2 / (2 * n); h <- z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2))
  c(proc = 100 * p, lo = 100 * (c0 - h) / (1 + z^2 / n), hi = 100 * (c0 + h) / (1 + z^2 / n)) }
pyt <- t(sapply(names(trudnosc), function(v) wilson(sum(p1[[v]]), n)))
round(pyt[order(pyt[, "proc"]), ], 1)
# Wynik ogólny 0–10
round(c(M = mean(p1$wynik), SD = sd(p1$wynik), Me = median(p1$wynik), Q1 = unname(quantile(p1$wynik, .25)),
        Q3 = unname(quantile(p1$wynik, .75)), proc_10 = 100 * mean(p1$wynik == 10)), 2)
# Rzetelność testu wiedzy (KR-20 = alfa dla pozycji 0/1)
round(psych::alpha(wiedza, warnings = FALSE)$total$raw_alpha, 2)
# Polipragmazja a wynik: test Manna–Whitneya i korelacja rangowo-dwuseryjna
table(p1$polipragmazja)
aggregate(wynik ~ polipragmazja, p1, function(x) round(c(Me = median(x), Q1 = unname(quantile(x, .25)), Q3 = unname(quantile(x, .75)), M = mean(x)), 2))
suppressWarnings(wilcox.test(wynik ~ polipragmazja, data = p1, exact = FALSE))
rank_biserial(wynik ~ polipragmazja, data = p1)
# Model dla liczby poprawnych odpowiedzi z 10: regresja logistyczna dwumianowa (OR poprawnej odpowiedzi)
m1 <- glm(cbind(wynik, 10 - wynik) ~ I(wiek / 10) + polipragmazja + wyksztalcenie, family = binomial, data = p1)
# Nadmierna dyspersja: stosunek statystyki Pearsona do liczby stopni swobody (wyraźnie > 1 – użyj quasibinomial)
round(sum(residuals(m1, type = "pearson")^2) / df.residual(m1), 2)
m1q <- update(m1, family = quasibinomial)
round(cbind(OR = exp(coef(m1q)), exp(suppressMessages(confint(m1q))), t = summary(m1q)$coefficients[, 3],
            p = summary(m1q)$coefficients[, 4]), 3)
summary(m1q)$df[2]

# Projekt 2: adherencja deklarowana u 220 pacjentów leczonych przewlekle.
# „przestrzega” = wynik kwestionariusza samoopisowego powyżej progu przyjętego przez autorów narzędzia.
set.seed(22302)
n2 <- 220
liczba_lekow <- pmin(12, 1 + rpois(n2, 3.2))
wiek2 <- round(pmin(90, pmax(30, rnorm(n2, 64, 11))))
przypomnienia <- factor(ifelse(runif(n2) < .38, "tak", "nie"), levels = c("nie", "tak"))
wiedza2 <- pmin(10, pmax(0, round(rnorm(n2, 6.4, 1.9))))
eta <- -0.2 - 0.16 * (liczba_lekow - 4) + 0.15 * (wiek2 - 64) / 10 + 0.75 * (przypomnienia == "tak") + 0.12 * (wiedza2 - 6.4)
przestrzega <- rbinom(n2, 1, plogis(eta))
p2 <- data.frame(id = 1:n2, liczba_lekow, wiek = wiek2, przypomnienia, wiedza = wiedza2, przestrzega)
c(przestrzega = sum(p2$przestrzega), nie_przestrzega = sum(1 - p2$przestrzega))
round(wilson(sum(p2$przestrzega), n2), 1)
m2 <- glm(przestrzega ~ liczba_lekow + I(wiek / 10) + przypomnienia + wiedza, family = binomial, data = p2)
round(cbind(OR = exp(coef(m2)), exp(suppressMessages(confint(m2))), z = summary(m2)$coefficients[, 3],
            p = summary(m2)$coefficients[, 4]), 3)
# Liczba zdarzeń w mniej licznej kategorii na jeden parametr modelu (bez wyrazu wolnego)
round(min(table(p2$przestrzega)) / (length(coef(m2)) - 1), 1)
Wynik w R
                proc   lo   hi
interakcje_otc  32.2 25.8 39.4
nazwy_handlowe  37.8 31.0 45.0
suplement       48.3 41.1 55.6
substancja      52.2 45.0 59.4
przeterminowane 55.6 48.3 62.6
antybiotyk      56.7 49.4 63.7
alkohol         63.9 56.6 70.5
przechowywanie  70.6 63.5 76.7
ulotka          77.8 71.2 83.2
wskazanie       88.9 83.5 92.7
      M      SD      Me      Q1      Q3 proc_10
   5.84    2.16    6.00    4.00    8.00    2.22
[1] 0.6

mniej niż 5 leków  5 i więcej leków
              149                31
      polipragmazja wynik.Me wynik.Q1 wynik.Q3 wynik.M
1 mniej niż 5 leków     6.00     5.00     8.00    5.96
2  5 i więcej leków     5.00     4.00     7.00    5.26

	Wilcoxon rank sum test with continuity correction

data:  wynik by polipragmazja
W = 2711, p-value = 0.1252
alternative hypothesis: true location shift is not equal to 0

r (rank biserial) |        95% CI
---------------------------------
0.17              | [-0.05, 0.38]
[1] 1.74
                                 OR 2.5 % 97.5 %      t     p
(Intercept)                   2.019 1.204  3.399  2.655 0.009
I(wiek/10)                    0.893 0.820  0.971 -2.624 0.009
polipragmazja5 i więcej leków 0.882 0.627  1.244 -0.719 0.473
wyksztalcenieśrednie          1.403 1.044  1.888  2.243 0.026
wyksztalceniewyższe           1.950 1.422  2.685  4.121 0.000
[1] 175
    przestrzega nie_przestrzega
            125              95
proc   lo   hi
56.8 50.2 63.2
                    OR 2.5 % 97.5 %      z     p
(Intercept)      0.376 0.042  3.209 -0.889 0.374
liczba_lekow     0.799 0.669  0.948 -2.532 0.011
I(wiek/10)       1.254 0.961  1.647  1.654 0.098
przypomnieniatak 2.116 1.187  3.835  2.511 0.012
wiedza           1.068 0.923  1.239  0.884 0.377
[1] 23.8
2. Projekt 3: pełna analiza konsultacji farmaceutycznej przed i po
R
# Projekt 3: konsultacja farmaceutyczna (przegląd leków z edukacją) – pomiar przed i po 8 tygodniach (dane symulowane).
# 64 pacjentów; wiedza o własnych lekach 0–10 i adherencja deklarowana (1 = przestrzega) przed konsultacją i po niej.
suppressPackageStartupMessages(library(effectsize))
set.seed(22303)
n <- 64
osoba <- rnorm(n)
wiedza_przed <- pmin(10, pmax(0, round(5.2 + 1.7 * osoba + rnorm(n, 0, 0.9))))
wiedza_po    <- pmin(10, pmax(0, round(wiedza_przed + 1.1 + 0.3 * osoba + rnorm(n, 0, 1.4))))
adh_przed <- rbinom(n, 1, plogis(-0.1 + 0.8 * osoba))
adh_po    <- ifelse(adh_przed == 1, rbinom(n, 1, .88), rbinom(n, 1, .42))
p3 <- data.frame(id = 1:n, wiedza_przed, wiedza_po, adh_przed, adh_po)

# Wiedza: opis, test t dla prób zależnych, d_z i test Wilcoxona dla par
round(c(M_przed = mean(wiedza_przed), SD_przed = sd(wiedza_przed), M_po = mean(wiedza_po), SD_po = sd(wiedza_po),
        r_przed_po = cor(wiedza_przed, wiedza_po), proc_wzrost = 100 * mean(wiedza_po > wiedza_przed),
        proc_spadek = 100 * mean(wiedza_po < wiedza_przed)), 2)
t.test(wiedza_po, wiedza_przed, paired = TRUE)
repeated_measures_d(wiedza_po, wiedza_przed, method = "z", adjust = FALSE)
suppressWarnings(wilcox.test(wiedza_po, wiedza_przed, paired = TRUE, exact = FALSE))

# Adherencja: tabela par, odsetki przed i po, test McNemara bez poprawki na ciągłość
tab <- table(przed = factor(adh_przed, 1:0, c("przestrzega", "nie")), po = factor(adh_po, 1:0, c("przestrzega", "nie")))
tab
round(100 * c(przed = mean(adh_przed), po = mean(adh_po)), 1)
mcnemar.test(tab, correct = FALSE)
# Różnica odsetków dla par (po − przed) z 95% CI Newcombe'a (metoda 10, „square-and-add” z przedziałami Wilsona)
newcombe_par <- function(a, b, c, d) {          # a = tak/tak, b = tak/nie, c = nie/tak, d = nie/nie (przed/po)
  n <- a + b + c + d; z <- qnorm(.975)
  wilson <- function(k) { p <- k / n; c0 <- p + z^2 / (2 * n); h <- z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2))
    c((c0 - h) / (1 + z^2 / n), (c0 + h) / (1 + z^2 / n)) }
  p1 <- (a + b) / n; p2 <- (a + c) / n; l1 <- wilson(a + b); l2 <- wilson(a + c)
  mian <- sqrt((a + b) * (c + d) * (a + c) * (b + d))
  phi <- if (mian == 0) 0 else (a * d - b * c) / mian       # korelacja pomiarów przed i po
  D <- p2 - p1
  dl <- sqrt((p2 - l2[1])^2 - 2 * phi * (p2 - l2[1]) * (l1[2] - p1) + (l1[2] - p1)^2)
  gr <- sqrt((l2[2] - p2)^2 - 2 * phi * (l2[2] - p2) * (p1 - l1[1]) + (p1 - l1[1])^2)
  round(100 * c(roznica = D, lo = D - dl, hi = D + gr), 1)
}
newcombe_par(a = tab[1, 1], b = tab[1, 2], c = tab[2, 1], d = tab[2, 2])
# Iloraz szans dla par (pary niezgodne): poprawa / pogorszenie
round(c(poprawa = tab[2, 1], pogorszenie = tab[1, 2], OR_par = tab[2, 1] / tab[1, 2]), 2)
# Błąd dla porównania: test chi-kwadrat, jakby przed i po były dwiema niezależnymi grupami
chisq.test(rbind(przed = table(factor(adh_przed, 1:0)), po = table(factor(adh_po, 1:0))), correct = FALSE)
Wynik w R
    M_przed    SD_przed        M_po       SD_po  r_przed_po proc_wzrost proc_spadek
       5.34        1.84        6.19        2.43        0.83       64.06       15.62

	Paired t-test

data:  wiedza_po and wiedza_przed
t = 4.923, df = 63, p-value = 6.457e-06
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 0.5012553 1.1862447
sample estimates:
mean difference
        0.84375

d (z) |       95% CI
--------------------
0.62  | [0.35, 0.88]

	Wilcoxon signed rank test with continuity correction

data:  wiedza_po and wiedza_przed
V = 1091, p-value = 3.964e-05
alternative hypothesis: true location shift is not equal to 0

             po
przed         przestrzega nie
  przestrzega          28   2
  nie                  17  17
przed    po
 46.9  70.3

	McNemar's Chi-squared test

data:  tab
McNemar's chi-squared = 11.842, df = 1, p-value = 0.0005791

roznica      lo      hi
   23.4    11.1    34.6
    poprawa pogorszenie      OR_par
       17.0         2.0         8.5

	Pearson's Chi-squared test

data:  rbind(przed = table(factor(adh_przed, 1:0)), po = table(factor(adh_po,     1:0)))
X-squared = 7.2453, df = 1, p-value = 0.007109
3. Projekty 4 i 5: apteki i pacjent symulowany, samoleczenie
R
# Projekt 4: badanie metodą pacjenta symulowanego w aptekach; projekt 5: ankieta o samoleczeniu (dane symulowane).
# Projekt 4: 30 aptek (15 sieciowych, 15 niezależnych), w każdej 3 wizyty pacjenta symulowanego (90 wizyt).
# Wynik wizyty: czy personel zapytał o inne przyjmowane leki (1 = tak).
suppressPackageStartupMessages({ library(lme4); library(effectsize) })
set.seed(22309)
apteki <- data.frame(apteka = sprintf("A%02d", 1:30), typ = factor(rep(c("sieciowa", "niezależna"), each = 15), levels = c("sieciowa", "niezależna")))
apteki$u <- rnorm(30, 0, 1.5)                       # „styl pracy” apteki – wspólny dla jej wizyt
p4 <- apteki[rep(1:30, each = 3), c("apteka", "typ")]
p4$wizyta <- rep(1:3, 30)
p4$pytanie <- rbinom(90, 1, plogis(-0.5 + 0.9 * (p4$typ == "niezależna") + apteki$u[rep(1:30, each = 3)]))
rownames(p4) <- NULL
tab4 <- table(p4$typ, factor(p4$pytanie, 1:0, c("zapytano", "nie zapytano"))); tab4
round(100 * prop.table(tab4, 1), 1)
# Błąd: 90 wizyt traktowanych jak 90 niezależnych obserwacji
chisq.test(tab4, correct = FALSE)
# Analiza 1: na poziomie apteki (odsetek wizyt z pytaniem w każdej aptece), test Manna–Whitneya
ap <- aggregate(pytanie ~ apteka + typ, p4, mean)
aggregate(pytanie ~ typ, ap, function(x) round(c(M = mean(x), Me = median(x), n = length(x)), 2))
suppressWarnings(wilcox.test(pytanie ~ typ, data = ap, exact = FALSE))
rank_biserial(pytanie ~ typ, data = ap)
# Analiza 2: wielopoziomowa regresja logistyczna z efektem losowym apteki
m4 <- glmer(pytanie ~ typ + (1 | apteka), family = binomial, data = p4)
round(cbind(OR = exp(fixef(m4)), exp(confint(m4, parm = "beta_", method = "Wald")), p = summary(m4)$coefficients[, 4]), 3)
s2 <- as.numeric(VarCorr(m4)$apteka); round(c(wariancja_apteki = s2, ICC = s2 / (s2 + pi^2 / 3)), 2)
# Dla porównania: zwykła regresja logistyczna bez apteki (te same błędne założenia co chi-kwadrat)
round(summary(glm(pytanie ~ typ, family = binomial, data = p4))$coefficients, 3)

# Projekt 5: samoleczenie – ankieta internetowa, N = 300 dorosłych.
set.seed(22305)
n5 <- 300
wiek5 <- factor(sample(c("18–29", "30–49", "50 i więcej"), n5, TRUE, prob = c(.40, .35, .25)), levels = c("18–29", "30–49", "50 i więcej"))
bez_porady <- factor(ifelse(runif(n5) < c(.62, .50, .38)[as.integer(wiek5)], "tak", "nie"), levels = c("tak", "nie"))
p5 <- data.frame(id = 1:n5, wiek = wiek5, bez_porady)
# Pytanie wielokrotnego wyboru: skąd czerpie informacje o lekach bez recepty (można zaznaczyć kilka odpowiedzi)
zrodla <- c(farmaceuta = .48, ulotka = .55, lekarz = .41, internet = .37, rodzina = .22, reklama = .15)
for (z in names(zrodla)) p5[[z]] <- rbinom(n5, 1, zrodla[[z]])
tab5 <- table(p5$wiek, p5$bez_porady); tab5
round(100 * prop.table(tab5, 1), 1)
ch5 <- chisq.test(tab5); ch5
round(ch5$stdres, 2)
cramers_v(tab5, adjust = FALSE)
# Odsetek respondentów, którzy zaznaczyli każde źródło (suma > 100%, bo odpowiedzi się nie wykluczają)
wilson <- function(k, n) { z <- qnorm(.975); p <- k / n; c0 <- p + z^2 / (2 * n); h <- z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2))
  c(proc = 100 * p, lo = 100 * (c0 - h) / (1 + z^2 / n), hi = 100 * (c0 + h) / (1 + z^2 / n)) }
zr <- t(sapply(names(zrodla), function(z) wilson(sum(p5[[z]]), n5))); round(zr[order(-zr[, "proc"]), ], 1)
round(c(suma_proc = sum(zr[, "proc"]), srednio_zaznaczen = mean(rowSums(p5[names(zrodla)]))), 1)
Wynik w R
             zapytano nie zapytano
  sieciowa         18           27
  niezależna       29           16

             zapytano nie zapytano
  sieciowa       40.0         60.0
  niezależna     64.4         35.6

	Pearson's Chi-squared test

data:  tab4
X-squared = 5.3884, df = 1, p-value = 0.02027

         typ pytanie.M pytanie.Me pytanie.n
1   sieciowa      0.40       0.33     15.00
2 niezależna      0.64       0.67     15.00

	Wilcoxon rank sum test with continuity correction

data:  pytanie by typ
W = 72.5, p-value = 0.09009
alternative hypothesis: true location shift is not equal to 0

r (rank biserial) |        95% CI
---------------------------------
-0.36             | [-0.66, 0.05]
                 OR 2.5 % 97.5 %     p
(Intercept)   0.525 0.156  1.772 0.299
typniezależna 5.048 0.814 31.310 0.082
wariancja_apteki              ICC
            3.18             0.49
              Estimate Std. Error z value Pr(>|z|)
(Intercept)     -0.405      0.304  -1.332    0.183
typniezależna    1.000      0.435   2.297    0.022

              tak nie
  18–29        70  48
  30–49        54  50
  50 i więcej  21  57

               tak  nie
  18–29       59.3 40.7
  30–49       51.9 48.1
  50 i więcej 26.9 73.1

	Pearson's Chi-squared test

data:  tab5
X-squared = 20.56, df = 2, p-value = 3.431e-05


                tak   nie
  18–29        3.07 -3.07
  30–49        0.91 -0.91
  50 i więcej -4.40  4.40
Cramer's V |       95% CI
-------------------------
0.26       | [0.16, 1.00]

- One-sided CIs: upper bound fixed at [1.00].           proc   lo   hi
ulotka     59.7 54.0 65.1
farmaceuta 50.3 44.7 56.0
lekarz     46.3 40.8 52.0
internet   38.7 33.3 44.3
rodzina    21.3 17.1 26.3
reklama    14.0 10.5 18.4
        suma_proc srednio_zaznaczen
            230.3               2.3
4. Rysunki i plik XLSX
R
# Rysunki i plik XLSX do wpisu (uruchom z folderu kod/): LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b223-rysunki.R > b223-rysunki-wynik.txt
suppressPackageStartupMessages({ library(ggplot2); library(svglite); library(patchwork); library(openxlsx) })
pdf(NULL)
# Motyw i zapis rysunków zdefiniowane lokalnie
KOLORY <- c(akcent = "#e50101", drugi = "#1f78b4", dane = "grey55", neutralny = "#8C8C8C", granat = "#0f1d3a")
theme_metodolog <- function(base_size = 13) {
  theme_minimal(base_size = base_size) +
    theme(plot.title = element_text(face = "bold", colour = KOLORY[["granat"]], size = rel(1.05), margin = margin(b = 6)),
          plot.subtitle = element_text(colour = "grey30", margin = margin(b = 8)),
          panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
          axis.title = element_text(colour = "grey20"), axis.text = element_text(colour = "grey25"),
          legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
          plot.margin = margin(10, 14, 10, 10))
}
zapisz_svg <- function(wykres, plik, szer = 10, wys = 5.6) {
  svglite::svglite(plik, width = szer, height = wys, bg = "white"); print(wykres); invisible(dev.off())
  cat(sprintf("Zapisano %s: w HTML width=\"%d\" height=\"%d\" (%d KB)\n", plik, round(szer * 100), round(wys * 100), round(file.info(plik)$size / 1024)))
}
invisible(capture.output({ for (f in c("b223-1-wiedza-adherencja.R", "b223-2-opieka-przed-po.R", "b223-3-apteki-samoleczenie.R")) source(f) }))

# Rysunek 1: odsetek poprawnych odpowiedzi w 10 pytaniach o leki (projekt 1)
et <- c(substancja = "Zna substancję czynną swojego leku", wskazanie = "Wie, na co przyjmuje lek",
        nazwy_handlowe = "Ta sama substancja – różne nazwy handlowe", alkohol = "Wie, gdzie sprawdzić łączenie z alkoholem",
        przechowywanie = "Zna zasady przechowywania", przeterminowane = "Wie, co zrobić z przeterminowanym lekiem",
        interakcje_otc = "Leki bez recepty mogą wchodzić w interakcje", suplement = "Suplement diety to nie lek",
        ulotka = "Wie, gdzie w ulotce są działania niepożądane", antybiotyk = "Antybiotyk nie działa na wirusy")
d1 <- data.frame(pytanie = et[rownames(pyt)], pyt); d1 <- d1[order(d1$proc), ]
d1$pytanie <- factor(d1$pytanie, levels = d1$pytanie); print(d1[, -1], digits = 3)
r1 <- ggplot(d1, aes(proc, pytanie)) +
  geom_errorbar(aes(xmin = lo, xmax = hi), width = .25, orientation = "y", colour = KOLORY[["drugi"]], linewidth = .9) +
  geom_point(colour = KOLORY[["akcent"]], size = 3.2) +
  geom_text(aes(x = hi + 1.5, label = sprintf("%.1f%%", proc)), hjust = 0, size = 3.6, colour = "grey20") +
  scale_x_continuous(limits = c(0, 100), breaks = seq(0, 100, 20), labels = function(x) paste0(x, "%")) +
  labs(title = "Wiedza pacjentów o lekach: odsetek poprawnych odpowiedzi (n = 180)",
       subtitle = "Punkty – odsetek; odcinki – 95% CI Wilsona; pytania od najtrudniejszego", x = "Poprawne odpowiedzi", y = NULL) +
  theme_metodolog(13)
zapisz_svg(r1, "../statystyka-farmacja-wiedza-o-lekach.svg", szer = 10, wys = 5.6)

# Rysunek 2: konsultacja farmaceutyczna – wiedza przed i po oraz przejścia w adherencji (projekt 3)
set.seed(7)
d2 <- data.frame(id = rep(p3$id, 2), czas = rep(c("przed", "po 8 tyg."), each = nrow(p3)),
                 x = rep(1:2, each = nrow(p3)) + rep(runif(nrow(p3), -.08, .08), 2), wiedza = c(p3$wiedza_przed, p3$wiedza_po))
s2 <- data.frame(x = 1:2, M = c(mean(p3$wiedza_przed), mean(p3$wiedza_po)),
                 lo = c(t.test(p3$wiedza_przed)$conf.int[1], t.test(p3$wiedza_po)$conf.int[1]),
                 hi = c(t.test(p3$wiedza_przed)$conf.int[2], t.test(p3$wiedza_po)$conf.int[2])); print(s2, digits = 3)
rA <- ggplot(d2, aes(x, wiedza)) + geom_line(aes(group = id), colour = KOLORY[["dane"]], alpha = .3) +
  geom_point(colour = KOLORY[["dane"]], alpha = .5, size = 1.6) +
  geom_errorbar(data = s2, aes(x = x, ymin = lo, ymax = hi), inherit.aes = FALSE, width = .07, colour = KOLORY[["akcent"]], linewidth = 1) +
  geom_point(data = s2, aes(x, M), inherit.aes = FALSE, colour = KOLORY[["akcent"]], size = 3.6) +
  scale_x_continuous(breaks = 1:2, labels = c("przed konsultacją", "po 8 tygodniach"), limits = c(.7, 2.3)) +
  scale_y_continuous(breaks = seq(0, 10, 2), limits = c(0, 10)) +
  labs(title = "A. Wiedza o własnych lekach (0–10)", subtitle = "Linia łączy pomiary jednej osoby; średnie z 95% CI", x = NULL, y = "Liczba poprawnych odpowiedzi") +
  theme_metodolog(12)
d3 <- data.frame(przejscie = factor(c("przestrzegał(a) – nadal", "nie – teraz przestrzega", "przestrzegał(a) – już nie", "nie – nadal nie"),
                                    levels = rev(c("przestrzegał(a) – nadal", "nie – teraz przestrzega", "przestrzegał(a) – już nie", "nie – nadal nie"))),
                 n = c(tab[1, 1], tab[2, 1], tab[1, 2], tab[2, 2]), niezgodna = c(FALSE, TRUE, TRUE, FALSE)); print(d3)
rB <- ggplot(d3, aes(n, przejscie, fill = niezgodna)) + geom_col(width = .65) +
  geom_text(aes(label = n), hjust = -.3, size = 4, colour = "grey20") +
  scale_fill_manual(values = c(`TRUE` = KOLORY[["akcent"]], `FALSE` = "grey75"), labels = c(`TRUE` = "pary niezgodne – liczy je test McNemara", `FALSE` = "pary zgodne"), name = NULL) +
  scale_x_continuous(limits = c(0, 33), breaks = seq(0, 30, 10)) +
  labs(title = "B. Adherencja deklarowana: przed → po", subtitle = sprintf("Odsetek przestrzegających: %.1f%% → %.1f%% (n = %d)", 100 * mean(p3$adh_przed), 100 * mean(p3$adh_po), nrow(p3)),
       x = "Liczba pacjentów", y = NULL) + theme_metodolog(12) + guides(fill = guide_legend(nrow = 2))
zapisz_svg(rA + rB + plot_layout(widths = c(1, 1.25)), "../statystyka-farmacja-konsultacja-przed-po.svg", szer = 10, wys = 5.4)

# Plik XLSX z danymi do pobrania
wb <- createWorkbook(creator = "Metodolog.pl", title = "Statystyka w pracy z farmacji – dane przykładowe")
setLastModifiedBy(wb, "Metodolog.pl")
opis <- data.frame(arkusz = c("P1_wiedza", "P2_adherencja", "P3_konsultacja", "P4_apteki", "P5_samoleczenie"),
  zawartosc = c("180 pacjentów: wiek, polipragmazja, wykształcenie, 10 pytań o leki (1 = poprawna odpowiedź) i wynik 0–10",
                "220 pacjentów leczonych przewlekle: liczba leków, wiek, przypomnienia, wiedza 0–10, adherencja deklarowana (1 = przestrzega)",
                "64 pacjentów: wiedza 0–10 i adherencja deklarowana przed konsultacją farmaceutyczną i po 8 tygodniach",
                "90 wizyt pacjenta symulowanego w 30 aptekach: typ apteki, numer wizyty, czy zapytano o inne leki (1 = tak)",
                "300 respondentów: grupa wieku, lek bez recepty bez porady, źródła informacji o lekach (pytanie wielokrotnego wyboru)"),
  uwaga = "Dane symulowane do nauki analizy; nie pochodzą z prawdziwego badania.")
for (ark in list(list("Opis", opis), list("P1_wiedza", p1), list("P2_adherencja", p2), list("P3_konsultacja", p3),
                 list("P4_apteki", p4), list("P5_samoleczenie", p5))) {
  addWorksheet(wb, ark[[1]]); writeData(wb, ark[[1]], ark[[2]]); setColWidths(wb, ark[[1]], 1:ncol(ark[[2]]), "auto") }
saveWorkbook(wb, "../statystyka-farmacja-dane-przyklad.xlsx", overwrite = TRUE)
# Kontrola pliku: arkusze, liczba wierszy i metadane autora
sapply(getSheetNames("../statystyka-farmacja-dane-przyklad.xlsx"), function(s) nrow(read.xlsx("../statystyka-farmacja-dane-przyklad.xlsx", s)))
tmp <- tempfile(); unzip("../statystyka-farmacja-dane-przyklad.xlsx", exdir = tmp)
core <- paste(readLines(file.path(tmp, "docProps", "core.xml"), warn = FALSE, encoding = "UTF-8"), collapse = "")
cat("creator:", sub(".*<dc:creator>(.*?)</dc:creator>.*", "\\1", core), "| lastModifiedBy:",
    sub(".*<cp:lastModifiedBy>(.*?)</cp:lastModifiedBy>.*", "\\1", core), "\n")
cat("rozmiar KB:", round(file.info("../statystyka-farmacja-dane-przyklad.xlsx")$size / 1024), "\n")
Wynik w R
                proc   lo   hi
interakcje_otc  32.2 25.8 39.4
nazwy_handlowe  37.8 31.0 45.0
suplement       48.3 41.1 55.6
substancja      52.2 45.0 59.4
przeterminowane 55.6 48.3 62.6
antybiotyk      56.7 49.4 63.7
alkohol         63.9 56.6 70.5
przechowywanie  70.6 63.5 76.7
ulotka          77.8 71.2 83.2
wskazanie       88.9 83.5 92.7
Zapisano ../statystyka-farmacja-wiedza-o-lekach.svg: w HTML width="1000" height="560" (13 KB)
  x    M   lo   hi
1 1 5.34 4.88 5.80
2 2 6.19 5.58 6.79
                  przejscie  n niezgodna
1   przestrzegał(a) – nadal 28     FALSE
2   nie – teraz przestrzega 17      TRUE
3 przestrzegał(a) – już nie  2      TRUE
4           nie – nadal nie 17     FALSE
Zapisano ../statystyka-farmacja-konsultacja-przed-po.svg: w HTML width="1000" height="540" (38 KB)
           Opis       P1_wiedza   P2_adherencja  P3_konsultacja       P4_apteki
              5             180             220              64              90
P5_samoleczenie
            300
creator: Metodolog.pl | lastModifiedBy: Metodolog.pl
rozmiar KB: 41
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje t.test(), wilcox.test(), mcnemar.test(), chisq.test() i glm() z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files (R package version 4.2.8.1) [Computer software]. https://doi.org/10.32614/CRAN.package.openxlsx
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w analizach prac z farmacji
- Wizyty w tej samej aptece analizowane jak niezależne obserwacje. W przykładzie zmieniło to wynik z p = .020 na p = .082.
- Pomiar przed i po porównany testem dla grup niezależnych (chi-kwadrat zamiast McNemara, test t dla prób niezależnych zamiast zależnych).
- „Konsultacja poprawia adherencję” na podstawie schematu bez grupy kontrolnej, zwłaszcza gdy do badania wybrano pacjentów z problemami z przyjmowaniem leków.
- Brak definicji adherencji: nie wiadomo, czy chodzi o rozpoczęcie leczenia, regularne przyjmowanie leków czy jego przerwanie.
- Adherencja deklarowana opisana jak rzeczywista, bez wzmianki, że samoopis zwykle ją zawyża.
- Własny próg „przestrzega/nie” nałożony na ciągły wynik kwestionariusza zamiast analizy wyniku jako liczby.
- Tylko wynik ogólny testu wiedzy, bez odsetków w poszczególnych pytaniach, które pokazują, czego pacjenci nie wiedzą.
- Odsetki bez przedziałów ufności i wnioski o „większości pacjentów” na podstawie ankiety internetowej.
- Brak wielkości efektu: samo p bez dz, OR, różnicy odsetków albo V Craméra.
Najczęstsze pytania
Jakie testy statystyczne wybrać do pracy magisterskiej z farmacji?
To zależy od jednostki analizy i typu zmiennej. Dwie grupy pacjentów porównasz testem Manna–Whitneya albo t, odsetki – testem chi-kwadrat, pomiar przed i po u tych samych osób – testem t dla prób zależnych albo testem McNemara, a związek kilku czynników z odpowiedzią tak/nie – regresją logistyczną. Do każdego testu dodaj wielkość efektu z 95% CI.
Jak przeanalizować adherencję pacjentów w pracy dyplomowej?
Najpierw zdefiniuj, który aspekt mierzysz: rozpoczęcie leczenia, regularne przyjmowanie leków czy jego przerwanie. Jeśli kwestionariusz ma ustalony przez autorów próg, analizuj przestrzeganie tak/nie regresją logistyczną i podaj OR z 95% CI; jeśli progu nie ma, analizuj wynik jako liczbę. Pamiętaj, że samoopis zwykle zawyża adherencję.
Jak sprawdzić, czy konsultacja farmaceutyczna poprawiła adherencję?
Gdy ci sami pacjenci odpowiadali przed konsultacją i po niej, porównaj odsetki testem McNemara, który korzysta z par niezgodnych, i podaj różnicę odsetków z 95% CI Newcombe’a. Bez grupy kontrolnej pisz o zmianie po konsultacji, a nie o jej skuteczności, bo wzrost mogą wyjaśniać regresja do średniej i sam udział w badaniu.
Jak porównać apteki w badaniu z pacjentem symulowanym?
Wizyty w tej samej aptece są do siebie podobne, więc nie licz testu chi-kwadrat na wszystkich wizytach. Policz odsetek dla każdej apteki i porównaj apteki (np. testem Manna–Whitneya) albo użyj wielopoziomowej regresji logistycznej z efektem losowym apteki. Podaj ICC i planuj raczej więcej aptek niż więcej wizyt w jednej aptece.
Dlaczego odsetki w pytaniu wielokrotnego wyboru sumują się do ponad 100%?
Bo jeden respondent może zaznaczyć kilka odpowiedzi, a każda z nich jest osobną zmienną tak/nie. Odsetek liczysz względem wszystkich respondentów, nie wszystkich zaznaczeń. Napisz to pod tabelą i podaj średnią liczbę zaznaczonych odpowiedzi; przy porównaniach grup testuj każdą odpowiedź osobno.
Powiązane hasła
Przeczytaj też
Test McNemara – przed i po dla tak/nie
Tabela par, wybór wersji testu (asymptotyczna, dokładna, mid-p) i 95% CI dla sparowanej różnicy odsetków – z przykładem w R i wzorem opisu.
Czytaj →PoradnikAnkieta wiedzy – analiza krok po kroku
Punktacja z „nie wiem”, poziomy wiedzy, KR-20, analiza pozycji, testy rangowe i źródła wiedzy – na danych do pobrania, z kodem R i opisem APA.
Czytaj →PoradnikRegresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →Piszesz pracę z farmacji i nie wiesz, jak przeanalizować dane?
Pomożemy dobrać analizy do ankiety pacjentów, pomiaru przed i po albo badania w aptekach, policzyć wyniki z wielkością efektu i wyjaśnić je tak, abyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Allemann, S. S., van Mil, J. W. F., Botermann, L., Berger, K., Griese, N., & Hersberger, K. E. (2014). Pharmaceutical care: The PCNE definition 2013. International Journal of Clinical Pharmacy, 36(3), 544–555. https://doi.org/10.1007/s11096-014-9933-x
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Fagerland, M. W., Lydersen, S., & Laake, P. (2013). The McNemar test for binary matched-pairs data: Mid-p and asymptotic are better than exact conditional. BMC Medical Research Methodology, 13(1), Article 91. https://doi.org/10.1186/1471-2288-13-91 ● Otwarty dostęp
- Killip, S., Mahfoud, Z., & Pearce, K. (2004). What is an intracluster correlation coefficient? Crucial concepts for primary care researchers. Annals of Family Medicine, 2(3), 204–208. https://doi.org/10.1370/afm.141 ● Otwarty dostęp
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Newcombe, R. G. (1998). Improved confidence intervals for the difference between binomial proportions based on paired data. Statistics in Medicine, 17(22), 2635–2650. https://doi.org/10.1002/(sici)1097-0258(19981130)17:22<2635::aid-sim954>3.0.co;2-c
- Stirratt, M. J., Dunbar-Jacob, J., Crane, H. M., Simoni, J. M., Czajkowski, S., Hilliard, M. E., Aikens, J. E., Hunter, C. M., Velligan, D. I., Huntley, K., Ogedegbe, G., Rand, C. S., Schron, E., & Nilsen, W. J. (2015). Self-report measures of medication adherence behavior: Recommendations on optimal use. Translational Behavioral Medicine, 5(4), 470–482. https://doi.org/10.1007/s13142-015-0315-2
- Vrijens, B., De Geest, S., Hughes, D. A., Kardas, P., Demonceau, J., Ruppar, T., Dobbels, F., Fargher, E., Morrison, V., Lewek, P., Matyjaszczyk, M., Mshelia, C., Clyne, W., Aronson, J. K., Urquhart, J., & ABC Project Team. (2012). A new taxonomy for describing and defining adherence to medications. British Journal of Clinical Pharmacology, 73(5), 691–705. https://doi.org/10.1111/j.1365-2125.2012.04167.x ● Otwarty dostęp
- Watson, M. C., Norris, P., & Granas, A. G. (2006). A systematic review of the use of simulated patients and pharmacy practice research. International Journal of Pharmacy Practice, 14(2), 83–93. https://doi.org/10.1211/ijpp.14.2.0002
Cytowania BibTeX
@article{allemann2014pharmaceutical, author={Allemann, Samuel S. and van Mil, J. W. Foppe and Botermann, Lea and Berger, Karin and Griese, Nina and Hersberger, Kurt E.}, title={{Pharmaceutical care: The PCNE definition 2013}}, journal={International Journal of Clinical Pharmacy}, year={2014}, volume={36}, number={3}, pages={544--555}, doi={10.1007/s11096-014-9933-x}}@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{fagerland2013mcnemar, author={Fagerland, Morten W. and Lydersen, Stian and Laake, Petter}, title={{The McNemar test for binary matched-pairs data: Mid-p and asymptotic are better than exact conditional}}, journal={BMC Medical Research Methodology}, year={2013}, volume={13}, number={1}, eid={91}, doi={10.1186/1471-2288-13-91}}@article{killip2004what, author={Killip, Shersten and Mahfoud, Ziyad and Pearce, Kevin}, title={{What is an intracluster correlation coefficient? Crucial concepts for primary care researchers}}, journal={Annals of Family Medicine}, year={2004}, volume={2}, number={3}, pages={204--208}, doi={10.1370/afm.141}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{newcombe1998improved, author={Newcombe, Robert G.}, title={{Improved confidence intervals for the difference between binomial proportions based on paired data}}, journal={Statistics in Medicine}, year={1998}, volume={17}, number={22}, pages={2635--2650}, doi={10.1002/(sici)1097-0258(19981130)17:22<2635::aid-sim954>3.0.co;2-c}}@article{stirratt2015self, author={Stirratt, Michael J. and Dunbar-Jacob, Jacqueline and Crane, Heidi M. and Simoni, Jane M. and Czajkowski, Susan and Hilliard, Marisa E. and Aikens, James E. and Hunter, Christine M. and Velligan, Dawn I. and Huntley, Kristen and Ogedegbe, Gbenga and Rand, Cynthia S. and Schron, Eleanor and Nilsen, Wendy J.}, title={{Self-report measures of medication adherence behavior: Recommendations on optimal use}}, journal={Translational Behavioral Medicine}, year={2015}, volume={5}, number={4}, pages={470--482}, doi={10.1007/s13142-015-0315-2}}@article{vrijens2012new, author={Vrijens, Bernard and De Geest, Sabina and Hughes, Dyfrig A. and Kardas, Przemyslaw and Demonceau, Jenny and Ruppar, Todd and Dobbels, Fabienne and Fargher, Emily and Morrison, Valerie and Lewek, Pawel and Matyjaszczyk, Michal and Mshelia, Comfort and Clyne, Wendy and Aronson, Jeffrey K. and Urquhart, J. and {ABC Project Team}}, title={{A new taxonomy for describing and defining adherence to medications}}, journal={British Journal of Clinical Pharmacology}, year={2012}, volume={73}, number={5}, pages={691--705}, doi={10.1111/j.1365-2125.2012.04167.x}}@article{watson2006systematic, author={Watson, M. C. and Norris, P. and Granas, A. G.}, title={{A systematic review of the use of simulated patients and pharmacy practice research}}, journal={International Journal of Pharmacy Practice}, year={2006}, volume={14}, number={2}, pages={83--93}, doi={10.1211/ijpp.14.2.0002}}