Czym jest PSWQ
Kwestionariusz zamartwiania się PSWQ (Penn State Worry Questionnaire) opublikowali Meyer, Miller, Metzger i Borkovec (1990). Mierzy zamartwianie się jako cechę, czyli skłonność do częstego, trudnego do opanowania martwienia się. Ma 16 pozycji wyłonionych w analizie czynnikowej dużej puli pytań. Autorzy podali wysoką spójność wewnętrzną, dobrą rzetelność test–retest i brak związku z aprobatą społeczną. Wynik odróżniał osoby spełniające kryteria uogólnionego zaburzenia lękowego (GAD) od pozostałych i spadał po terapii poznawczo-behawioralnej.
PSWQ pojawia się najczęściej w pracach z psychologii (klinicznej, zdrowia, osobowości) i psychiatrii, zwykle obok miar lęku i depresji. Ogólne wskazówki analityczne znajdziesz we wpisach statystyka dla psychologa i statystyka dla lekarza. PSWQ nie jest tym samym co GAD-7. GAD-7 to krótki przesiew objawów z ostatnich tygodni, który opisuje wpis GAD-7 i PHQ-9 – jak policzyć wynik. PSWQ dotyczy stałej skłonności do zamartwiania się.
Budowa i stan weryfikacji klucza
Treści pozycji nie przytaczamy. Artykuł Meyera i in. (1990) jest płatny i go nie czytaliśmy. Autorzy nie prowadzą oficjalnej strony z kluczem. Dlatego tabela rozdziela to, co potwierdziliśmy, od tego, co musisz sprawdzić sam(a).
| Element | Co potwierdziliśmy | Źródło |
|---|---|---|
| Liczba pozycji | 16 | Meyer i in. (1990), abstrakt |
| Wynik | wynik łączny z 16 pozycji; w próbie z badania współautorstwa Borkovca zakres wyniósł 16–80 | Behar i in. (2012), praca ze współautorstwem twórcy |
| Pozycje sformułowane odwrotnie | są w skali; Brown (2003) opisał model z efektami metody pięciu takich pozycji | Brown (2003); Hazlett-Stevens i in. (2004), abstrakty |
| Format odpowiedzi i numery pozycji odwróconych | nie podajemy – nie potwierdziliśmy ich w źródle autorów | weź je z artykułu Meyera i in. (1990) albo z formularza z tej publikacji |
| Punkty odcięcia | nie podajemy – analizę ROC z udziałem Borkovca opisali Behar i in. (2003), ale abstrakt nie podaje progów | pełny tekst Behar i in. (2003) |
| Polskie normy | nie podajemy | – |
Zakres 16–80 pasuje do 16 odpowiedzi ocenianych od 1 do 5, ale format sprawdź w formularzu, którego używasz. W sieci krążą arkusze z „kluczem PSWQ”. Nie przepisuj ich bez sprawdzenia, skąd pochodzą. Numery pozycji odwróconych weź z artykułu źródłowego i zacytuj go.
Jak policzyć wynik krok po kroku
- Sprawdź kodowanie. Wszystkie odpowiedzi muszą mieć ten sam zakres co formularz. Formularze online zapisują je czasem jako 0–4 albo jako tekst etykiety. Wtedy najpierw przekoduj zmienne.
- Zaznacz pozycje odwrócone według źródła. Zapisz w książce kodowej, z jakiej publikacji pochodzi lista.
- Sprawdź kierunek przed odwróceniem. Surowe pozycje sformułowane odwrotnie powinny korelować ujemnie z resztą skali. Jeśli któraś koreluje dodatnio, lista pozycji jest zła albo dane zakodowano inaczej.
- Odwróć wskazane pozycje. Przy odpowiedziach 1–5 wartość odwrócona to 6 − x.
- Zsumuj 16 pozycji. Wyższy wynik oznacza silniejszą skłonność do zamartwiania się.
- Ustal regułę dla braków. Sprawdzone źródła jej nie podają. W przykładzie przy jednym braku liczymy średnią z 15 pozycji i mnożymy ją przez 16. To decyzja badacza i trzeba ją opisać w pracy.
Przekodowanie w różnych programach pokazuje poradnik jak policzyć wynik kwestionariusza. Sumę i średnią porównuje hasło wynik skali: średnia czy suma. Pojedynczy wynik policzysz w kalkulatorze wyniku skali.
Jeden czynnik czy efekt metody
PSWQ zaprojektowano jako miarę jednego konstruktu. W kolejnych badaniach pozycje sformułowane odwrotnie zachowywały się jednak inaczej niż pozostałe. Ten spór dobrze pokazuje, czym jest jednowymiarowość skali i dlaczego zła struktura czynnikowa nie zawsze oznacza dwa konstrukty.
- Dwa czynniki. Fresco, Heimberg, Mennin i Turk (2002) przebadali 788 studentów. Model dwuczynnikowy pasował lepiej niż jednoczynnikowy. Pierwszy czynnik nazwali zaangażowaniem w zamartwianie się (Worry Engagement), a drugi brakiem zamartwiania się (Absence of Worry). Znaleźli też czynnik wyższego rzędu. Drugi czynnik słabo korelował z depresją i lękiem.
- Jeden czynnik i efekt metody. Brown (2003) przebadał 1200 pacjentów z zaburzeniami lękowymi i nastroju. Model jednego czynnika z efektami metody pięciu pozycji sformułowanych odwrotnie okazał się lepszy niż model dwuczynnikowy. Wynik powtórzył się w dwóch połowach próby, a pomiar był niezmienny u kobiet i mężczyzn.
- Równie dobre dopasowanie. U studentów model z czynnikiem metody pasował tak samo dobrze jak model dwuczynnikowy. Sam czynnik metody nie przewidywał rozpoznania GAD. Autorzy wnioskują, że PSWQ mierzy jeden konstrukt, a różni się tylko sposób odpowiadania na pozycje odwrócone (Hazlett-Stevens i in., 2004).
- Wersje skrócone. Hazlett-Stevens i in. (2004) sprawdzili skalę złożoną tylko z pozycji sformułowanych w kierunku zamartwiania się. Hopko i in. (2003) zaproponowali dla starszych dorosłych z GAD model po usunięciu 8 pozycji i zaznaczyli, że wymaga on dalszych badań. Jeśli używasz takiej wersji, opisz ją jako osobne narzędzie.
Efekty metody przy pozycjach negatywnych są znane także z innych skal. DiStefano i Motl (2006) traktują je jako styl odpowiadania, związany z cechami osobowości. Pokrewne zjawiska opisują hasła tendencja do zgadzania się i wspólna wariancja metody. Technikę modelowania czynnika ogólnego z czynnikiem dodatkowym pokazuje wpis model bifactor i ESEM.
Co z tego wynika dla pracy? Liczy się suma 16 pozycji, bo tak zaprojektowano narzędzie, a modele z efektem metody tego nie podważają. Jeśli sprawdzasz strukturę w CFA, porównaj model jednoczynnikowy z modelem z czynnikiem metody. Nie traktuj dwóch czynników jako dwóch wyników PSWQ bez źródła, które takie wyniki uzasadnia.
Licencja i polska wersja
Nie znaleźliśmy oficjalnej strony autorów PSWQ z warunkami użycia (stan na 1 listopada 2026 r.). Narzędzie opublikowano w artykule w czasopiśmie, którego tekst jest płatny. W katalogu narzędzi badawczych oznaczamy to jako brak jasnych warunków. W praktyce zacytuj artykuł Meyera i in. (1990), weź formularz ze źródła, które możesz wskazać, i nie przedrukowuj pozycji w aneksie bez sprawdzenia praw. Ogólne zasady opisuje hasło licencja narzędzia badawczego. Ten wpis nie jest poradą prawną.
Polskiej adaptacji PSWQ nie weryfikowaliśmy, dlatego jej nie opisujemy. Jeśli z niej korzystasz, podaj w pracy autorów i rok publikacji, z której pochodzi wersja językowa. Wskazówki o szukaniu narzędzi znajdziesz w poradniku gdzie znaleźć kwestionariusze psychologiczne, a o przekładzie – w haśle tłumaczenie zwrotne i adaptacja kulturowa.
Przykład: 380 osób studiujących
Dane są symulowane i możesz je pobrać jako plik CSV. Kolumny z1–z11 to pozycje sformułowane w kierunku zamartwiania się. Kolumny o1–o5 to pozycje sformułowane odwrotnie, w surowej postaci. Ten podział to założenie symulacji, a nie numeracja formularza. Odpowiedzi zapisano jako 1–5. Plik zawiera też wynik GAD-7 jako drugą miarę lęku. Jedna osoba miała trzy braki i nie dostała wyniku, a cztery osoby miały po jednym braku. Do analizy weszło 379 osób.
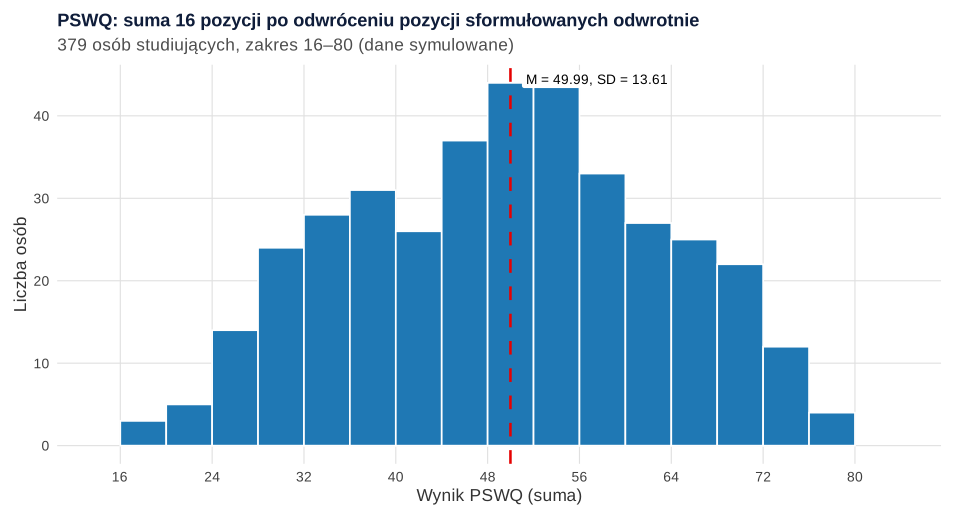
Przed odwróceniem pięć surowych pozycji odwrotnych korelowało z sumą pozostałych pozycji od −.49 do −.60. Tak powinno być. Po odwróceniu średni wynik wyniósł M = 49.99 (SD = 13.61, Me = 51) przy zakresie od 16 do 80 i skośności −0.07 (rysunek 1). Alfa wyniosła .94, 95% CI [.93, .95]. Korelacje pozycja–reszta skali wyniosły .64–.75 dla pozycji zgodnych i .56–.67 dla odwróconych.
Trzy modele struktury
W danych zapisaliśmy jeden czynnik zamartwiania się i dodatkową wspólną wariancję pozycji odwróconych. Porównaliśmy trzy modele CFA (estymator MLR).
| Model | χ² (df) | CFI | RMSEA | SRMR | BIC |
|---|---|---|---|---|---|
| Jeden czynnik | 266.24 (104) | .949 | .065 | .044 | 16327.57 |
| Dwa skorelowane czynniki | 87.94 (103) | 1.000 | .000 | .021 | 16150.37 |
| Jeden czynnik + czynnik metody | 83.75 (99) | 1.000 | .000 | .019 | 16170.02 |
Model jednoczynnikowy pasował wyraźnie gorzej. Dwa pozostałe pasowały równie dobrze, a BIC lekko faworyzował model dwuczynnikowy. To ten sam impas, który opisali Hazlett-Stevens i in. (2004). Korelacja dwóch czynników wyniosła .80, więc „brak zamartwiania się” to w dużej mierze ten sam konstrukt widziany przez odwrotne sformułowanie. Między tymi modelami nie rozstrzyga samo dopasowanie, tylko teoria. Wskaźniki opisują hasła CFI i RMSEA.
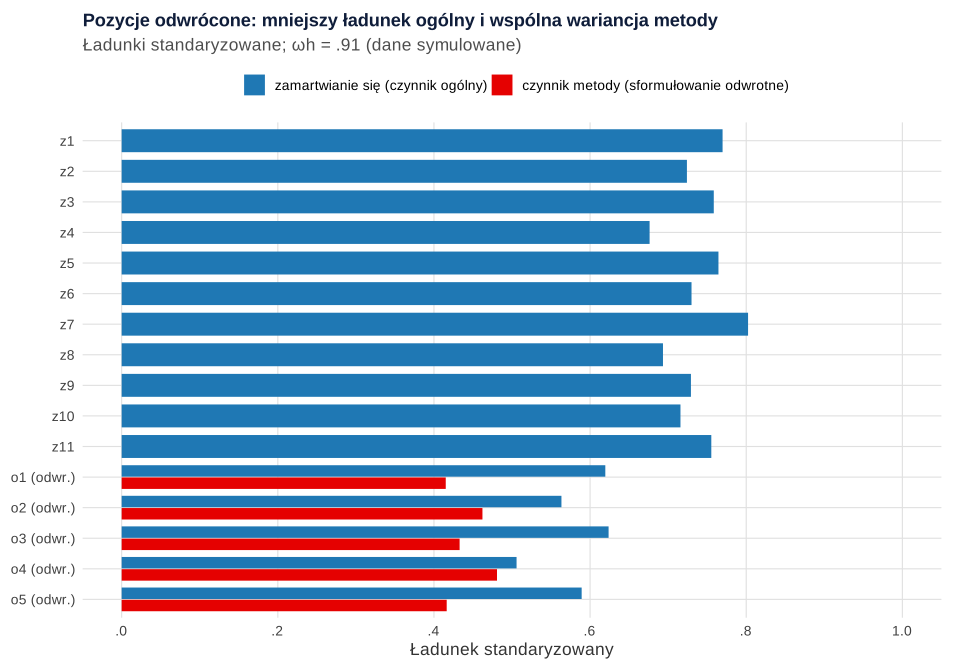
W modelu z czynnikiem metody pozycje odwrócone miały ładunki ogólne .51–.62 i ładunki czynnika metody .42–.48 (rysunek 2). Omega całkowita wyniosła .95, a omega hierarchiczna, czyli udział samego czynnika ogólnego, .91. Ta wartość mówi, że suma 16 pozycji odzwierciedla głównie jeden konstrukt. Interpretację omegi hierarchicznej opisują Rodriguez, Reise i Haviland (2016), a podstawy – hasło omega McDonalda.
Suma 16 a suma 11 pozycji
Suma wszystkich pozycji korelowała z GAD-7 na poziomie r = .73, 95% CI [.68, .78]. Suma samych 11 pozycji zgodnych dała ten sam wynik, a obie sumy korelowały ze sobą na poziomie .97. W tych danych pozycje odwrócone nie zmieniają więc wniosków o trafności. Tak wynika jednak z naszej symulacji. W Twojej próbie może być inaczej, dlatego taką analizę warto pokazać.
Jak opisać PSWQ w pracy
Wzory zawierają liczby z przykładu. W nawiasach kwadratowych uzupełnij dane swojej wersji.
Ogólny schemat opisu znajdziesz w poradniku opis narzędzia badawczego – wzór, a zdania o wynikach przygotujesz w generatorze opisu wyników APA.
PSWQ w R: odwrócenie, suma, rzetelność i efekt metody
Kod odtwarza liczby z tekstu i zapisuje plik CSV. Pozycje odwrotne są w osobnych kolumnach, więc kod nie zawiera numerów pozycji z formularza. Alfę liczy pakiet psych, a modele CFA i omegi – lavaan. Korelacje z drugą miarą lęku liczy bazowe R.
Wynik PSWQ krok po kroku
R
# B302 – PSWQ: odwracanie pozycji, suma 16 pozycji, braki, rzetelność, jeden czynnik a efekt metody
# (dane symulowane, set.seed(3021)). Treści pozycji ani numerów pozycji z formularza nie podajemy.
# 380 osób studiujących; odpowiedzi zapisane jako 1–5 (sprawdź format w swojej wersji formularza).
# Kolumny z1–z11 to pozycje sformułowane w kierunku zamartwiania się, o1–o5 – pozycje sformułowane odwrotnie,
# w surowej postaci (jeszcze NIE odwrócone). Które numery formularza są odwrócone, sprawdź w Meyer i in. (1990);
# liczba pięciu takich pozycji pochodzi z opisu modelu u Browna (2003), a podział kolumn to założenie symulacji.
suppressPackageStartupMessages({ library(psych); library(lavaan) })
set.seed(3021)
n <- 380
W <- rnorm(n)                                                      # skłonność do zamartwiania się (cecha latentna)
M <- rnorm(n)                                                      # czynnik metody: reakcja na odwrotne sformułowanie
progi <- c(-1.3, -0.45, 0.35, 1.15)
z <- sapply(c(.78, .74, .80, .70, .76, .72, .79, .68, .75, .73, .77),
            function(l) 1 + findInterval(l * W + rnorm(n, 0, sqrt(1 - l^2)), progi))
o <- sapply(c(.58, .55, .60, .52, .56),                            # surowo: wysoka odpowiedź = MAŁO zamartwiania się
            function(l) 1 + findInterval(-l * W + 0.45 * M + rnorm(n, 0, sqrt(1 - l^2 - 0.45^2)), -rev(progi)))
colnames(z) <- paste0("z", 1:11); colnames(o) <- paste0("o", 1:5)
gad7 <- pmin(21, pmax(0, round(6 + 3.6 * W + rnorm(n, 0, 3))))    # inna miara lęku jako kryterium (suma 0–21)
dane <- data.frame(id = 1:n, z, o, gad7)
dane$z4[c(23, 181)] <- NA; dane$o2[c(97, 181, 305)] <- NA; dane$z9[c(181, 266)] <- NA   # braki
write.csv(dane, "../pswq-dane-przyklad.csv", row.names = FALSE, na = "")   # plik do pobrania
Z <- paste0("z", 1:11); O <- paste0("o", 1:5)

# Krok 1. Kontrola kodowania: tylko 1–5 albo brak; braki na osobę
all(as.matrix(dane[, c(Z, O)]) %in% c(1:5, NA))
table(braki = rowSums(is.na(dane[, c(Z, O)])))

# Krok 2. Przed odwróceniem: pozycje odwrotne korelują ujemnie z resztą skali
round(cor(rowSums(dane[, Z], na.rm = TRUE), dane[, O], use = "pairwise"), 2)

# Krok 3. Odwrócenie na skali 1–5: 6 − x (tylko pozycje wskazane w kluczu)
odwroc <- function(x, min, max) min + max - x
dane[, paste0(O, "_odw")] <- lapply(dane[, O], odwroc, min = 1, max = 5)
OO <- paste0(O, "_odw"); V <- c(Z, OO)

# Krok 4. Wynik = suma 16 pozycji (16–80); przy 1 braku – średnia z 15 pozycji × 16 (decyzja badacza)
suma_16 <- function(x) ifelse(rowSums(is.na(x)) <= 1, rowMeans(x, na.rm = TRUE) * 16, NA)
dane$pswq <- suma_16(dane[, V])
sum(is.na(dane$pswq))
d <- dane[!is.na(dane$pswq), ]
round(c(n = nrow(d), M = mean(d$pswq), SD = sd(d$pswq), Me = median(d$pswq), min = min(d$pswq),
        max = max(d$pswq), skosnosc = skew(d$pswq)), 2)

# Krok 5. Rzetelność: alfa z 95% CI Feldta, korelacje pozycja–reszta w dwóch grupach pozycji
a <- psych::alpha(d[, V], warnings = FALSE)
round(c(alfa = a$total$raw_alpha, lo = a$feldt$lower.ci[[1]], hi = a$feldt$upper.ci[[1]]), 2)
round(rbind(zgodne = range(a$item.stats[Z, "r.drop"]), odwrocone = range(a$item.stats[OO, "r.drop"])), 2)

# Krok 6. Struktura (estymator MLR, FIML dla braków): jeden czynnik, dwa czynniki, jeden czynnik + czynnik metody
m1 <- paste("ZM =~", paste(V, collapse = " + "))
m2 <- paste("ZG =~", paste(Z, collapse = " + "), "\n BRAK =~", paste(OO, collapse = " + "))
m3 <- paste(m1, "\n METODA =~", paste(OO, collapse = " + "), "\n ZM ~~ 0*METODA")
g <- lapply(list(jeden_czynnik = m1, dwa_czynniki = m2, czynnik_plus_metoda = m3), cfa, data = d,
            estimator = "MLR", std.lv = TRUE, missing = "fiml")
ind <- c("chisq.scaled", "df.scaled", "cfi.robust", "rmsea.robust", "srmr", "bic")
round(t(sapply(g, fitMeasures, fit.measures = ind)), 3)
round(lavInspect(g$dwa_czynniki, "std")$psi["ZG", "BRAK"], 2)    # korelacja dwóch czynników

# Krok 7. Omega: całkowita i hierarchiczna (tylko czynnik ogólny) z modelu z czynnikiem metody
st <- standardizedSolution(g$czynnik_plus_metoda)
lg <- st$est.std[st$op == "=~" & st$lhs == "ZM"]; lm_ <- st$est.std[st$op == "=~" & st$lhs == "METODA"]
th <- st$est.std[st$op == "~~" & st$lhs %in% V & st$lhs == st$rhs]
calosc <- sum(lg)^2 + sum(lm_)^2 + sum(th)
round(c(omega_calkowita = (sum(lg)^2 + sum(lm_)^2) / calosc, omega_h = sum(lg)^2 / calosc), 2)
round(rbind(ogolny_odwrocone = lg[12:16], metoda = lm_), 2)

# Krok 8. Trafność: suma 16 pozycji i suma 11 pozycji zgodnych a inna miara lęku (r Pearsona)
d$suma_11 <- ifelse(rowSums(is.na(d[, Z])) == 0, rowSums(d[, Z]), NA)
ct16 <- cor.test(d$pswq, d$gad7); ct11 <- cor.test(d$suma_11, d$gad7)
wsp <- function(ct) c(r = unname(ct$estimate), lo = ct$conf.int[1], hi = ct$conf.int[2])
round(rbind(suma_16 = wsp(ct16), suma_11 = wsp(ct11)), 2)
round(cor(d$pswq, d$suma_11, use = "complete.obs"), 2)
Wynik w R
[1] TRUE
braki
  0   1   3
375   4   1
       o1    o2   o3    o4    o5
[1,] -0.6 -0.54 -0.6 -0.49 -0.57
[1] 1
       n        M       SD       Me      min      max skosnosc
  379.00    49.99    13.61    51.00    16.00    80.00    -0.07
alfa   lo   hi
0.94 0.93 0.95
          [,1] [,2]
zgodne    0.64 0.75
odwrocone 0.56 0.67
                    chisq.scaled df.scaled cfi.robust rmsea.robust  srmr      bic
jeden_czynnik            266.241       104      0.949        0.065 0.044 16327.57
dwa_czynniki              87.935       103      1.000        0.000 0.021 16150.37
czynnik_plus_metoda       83.746        99      1.000        0.000 0.019 16170.02
[1] 0.8
omega_calkowita         omega_h
           0.95            0.91
                 [,1] [,2] [,3] [,4] [,5]
ogolny_odwrocone 0.62 0.56 0.62 0.51 0.59
metoda           0.42 0.46 0.43 0.48 0.42
           r   lo   hi
suma_16 0.73 0.68 0.78
suma_11 0.73 0.68 0.78
[1] 0.97
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy PSWQ
- Brak odwrócenia pozycji. Surowe pozycje odwrotne obniżają alfę i zaniżają sumę. Ujemna korelacja pozycji z resztą skali to typowy sygnał tego błędu.
- Lista pozycji odwróconych z nieznanego arkusza. Weź ją z artykułu Meyera i in. (1990) i zacytuj źródło.
- Dwa wyniki zamiast jednego. Dwa czynniki w CFA nie dają automatycznie dwóch podskal. Brown (2003) i Hazlett-Stevens i in. (2004) tłumaczą je efektem metody.
- Próg „patologicznego zamartwiania się” bez źródła. Analizuj sumę jako zmienną ciągłą. Jeśli potrzebujesz progu, zacytuj publikację z analizą ROC i opisz jej próbę (zob. krzywa ROC i punkt odcięcia).
- Wersja skrócona opisana jako PSWQ. Wersja z 8 albo 11 pozycjami to inne narzędzie o innym zakresie wyniku.
Całą ścieżkę od kodowania po rzetelność porządkuje przewodnik po analizie kwestionariusza. Jeśli chcesz, żeby ktoś sprawdził liczenie PSWQ w Twojej bazie, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Które pozycje PSWQ są odwrócone?
Numery pozycji odwróconych podaje artykuł Meyera i in. (1990), który jest płatny i którego nie czytaliśmy. Dlatego ich tu nie wymieniamy. Brown (2003) opisał model z efektami metody pięciu pozycji sformułowanych odwrotnie. Po odwróceniu sprawdź korelacje pozycji z resztą skali: wartość ujemna zwykle oznacza błąd w kluczu.
Czy PSWQ ma dwie podskale?
Nie w wersji autorów, która daje jeden wynik. Fresco i in. (2002) uzyskali lepsze dopasowanie modelu dwuczynnikowego, ale Brown (2003) pokazał, że lepszy jest jeden czynnik z efektem metody pozycji odwróconych, a Hazlett-Stevens i in. (2004) – że oba modele pasują równie dobrze. Drugi czynnik odzwierciedla raczej sposób sformułowania pozycji niż osobny konstrukt.
Od ilu punktów PSWQ wskazuje na patologiczne zamartwianie się?
Ten wpis nie podaje progu. Behar i in. (2003), w pracy z udziałem twórcy PSWQ, badali przesiewową trafność narzędzia analizą ROC, ale abstrakt nie podaje wartości. Analizuj sumę jako zmienną ciągłą, a jeśli potrzebujesz progu, zacytuj publikację, z której go bierzesz, i opisz jej próbę.
Czy PSWQ można bez opłat użyć w pracy magisterskiej?
Nie znaleźliśmy oficjalnej strony autorów z warunkami użycia (stan na 1 listopada 2026 r.). Narzędzie opublikowano w płatnym artykule w czasopiśmie. Zacytuj Meyera i in. (1990), weź formularz ze źródła, które możesz wskazać, a przed przedrukiem pozycji w aneksie sprawdź prawa albo zapytaj promotora.
Czy wersję PSWQ bez pozycji odwróconych można porównywać z pełną?
Nie wprost. Skale złożone tylko z pozycji sformułowanych w kierunku zamartwiania się badali Hazlett-Stevens i in. (2004), a 8-pozycyjny model dla starszych dorosłych Hopko i in. (2003). To inne narzędzia o innym zakresie wyniku. W pracy opisz dokładnie, której wersji użyłeś(-aś), i nie porównuj sum z wynikami pełnej skali.
Powiązane hasła
Przeczytaj też
Jak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikGAD-7 i PHQ-9 – jak policzyć wynik
Suma 0–21 i 0–27, braki, progi 5/10/15/20 ze źródłami, próg przesiewowy 10, pozycja 9 PHQ-9 i przykład w R z opisem do pracy.
Czytaj →PoradnikModel bifactor i ESEM
Od CFA do bifactor-ESEM na jednym kwestionariuszu: ładunki krzyżowe, czynnik ogólny, omega H, ECV, trafność podskal, tabela APA i kod lavaan.
Czytaj →PoradnikKategorialna CFA: WLSMV w lavaan
Kiedy pozycje Likerta są porządkowe, jak czytać progi, ML, MLR i WLSMV na tych samych danych, indeksy robust, rzadkie kategorie i opis APA.
Czytaj →Badasz zamartwianie się i nie wiesz, jak policzyć PSWQ?
Sprawdzimy kodowanie, odwrócenie pozycji i braki, rzetelność i strukturę czynnikową oraz dobór analiz i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Behar, E., Alcaine, O., Zuellig, A. R., & Borkovec, T. D. (2003). Screening for generalized anxiety disorder using the Penn State Worry Questionnaire: A receiver operating characteristic analysis. Journal of Behavior Therapy and Experimental Psychiatry, 34(1), 25–43. https://doi.org/10.1016/s0005-7916(03)00004-1
- Behar, E., McGowan, S. K., McLaughlin, K. A., Borkovec, T. D., Goldwin, M., & Bjorkquist, O. (2012). Concreteness of positive, negative, and neutral repetitive thinking about the future. Behavior Therapy, 43(2), 300–312. https://doi.org/10.1016/j.beth.2011.07.002 ● Otwarty dostęp: pełny tekst
- Brown, T. A. (2003). Confirmatory factor analysis of the Penn State Worry Questionnaire: Multiple factors or method effects? Behaviour Research and Therapy, 41(12), 1411–1426. https://doi.org/10.1016/s0005-7967(03)00059-7
- DiStefano, C., & Motl, R. W. (2006). Further investigating method effects associated with negatively worded items on self-report surveys. Structural Equation Modeling: A Multidisciplinary Journal, 13(3), 440–464. https://doi.org/10.1207/s15328007sem1303_6
- Fresco, D. M., Heimberg, R. G., Mennin, D. S., & Turk, C. L. (2002). Confirmatory factor analysis of the Penn State Worry Questionnaire. Behaviour Research and Therapy, 40(3), 313–323. https://doi.org/10.1016/s0005-7967(00)00113-3
- Hazlett-Stevens, H., Ullman, J. B., & Craske, M. G. (2004). Factor structure of the Penn State Worry Questionnaire. Assessment, 11(4), 361–370. https://doi.org/10.1177/1073191104269872
- Hopko, D. R., Reas, D. L., Beck, J. G., Stanley, M. A., Wetherell, J. L., Novy, D. M., & Averill, P. M. (2003). Assessing worry in older adults: Confirmatory factor analysis of the Penn State Worry Questionnaire and psychometric properties of an abbreviated model. Psychological Assessment, 15(2), 173–183. https://doi.org/10.1037/1040-3590.15.2.173
- Meyer, T. J., Miller, M. L., Metzger, R. L., & Borkovec, T. D. (1990). Development and validation of the Penn State Worry Questionnaire. Behaviour Research and Therapy, 28(6), 487–495. https://doi.org/10.1016/0005-7967(90)90135-6
- Rodriguez, A., Reise, S. P., & Haviland, M. G. (2016). Evaluating bifactor models: Calculating and interpreting statistical indices. Psychological Methods, 21(2), 137–150. https://doi.org/10.1037/met0000045
Cytowania BibTeX
@article{behar2003screening, author={Behar, Evelyn and Alcaine, Oscar and Zuellig, Andrea R. and Borkovec, T. D.}, title={{Screening for generalized anxiety disorder using the Penn State Worry Questionnaire: A receiver operating characteristic analysis}}, journal={Journal of Behavior Therapy and Experimental Psychiatry}, year={2003}, volume={34}, number={1}, pages={25--43}, doi={10.1016/s0005-7916(03)00004-1}}@article{behar2012concreteness, author={Behar, Evelyn and McGowan, Sarah Kate and McLaughlin, Katie A. and Borkovec, T. D. and Goldwin, Michelle and Bjorkquist, Olivia}, title={{Concreteness of positive, negative, and neutral repetitive thinking about the future}}, journal={Behavior Therapy}, year={2012}, volume={43}, number={2}, pages={300--312}, doi={10.1016/j.beth.2011.07.002}}@article{brown2003confirmatory, author={Brown, Timothy A.}, title={{Confirmatory factor analysis of the Penn State Worry Questionnaire: Multiple factors or method effects?}}, journal={Behaviour Research and Therapy}, year={2003}, volume={41}, number={12}, pages={1411--1426}, doi={10.1016/s0005-7967(03)00059-7}}@article{distefano2006further, author={DiStefano, Christine and Motl, Robert W.}, title={{Further investigating method effects associated with negatively worded items on self-report surveys}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2006}, volume={13}, number={3}, pages={440--464}, doi={10.1207/s15328007sem1303_6}}@article{fresco2002confirmatory, author={Fresco, David M. and Heimberg, Richard G. and Mennin, Douglas S. and Turk, Cynthia L.}, title={{Confirmatory factor analysis of the Penn State Worry Questionnaire}}, journal={Behaviour Research and Therapy}, year={2002}, volume={40}, number={3}, pages={313--323}, doi={10.1016/s0005-7967(00)00113-3}}@article{hazlettstevens2004factor, author={Hazlett-Stevens, Holly and Ullman, Jodie B. and Craske, Michelle G.}, title={{Factor structure of the Penn State Worry Questionnaire}}, journal={Assessment}, year={2004}, volume={11}, number={4}, pages={361--370}, doi={10.1177/1073191104269872}}@article{hopko2003assessing, author={Hopko, Derek R. and Reas, Deborah L. and Beck, J. Gayle and Stanley, Melinda A. and Wetherell, Julie Loebach and Novy, Diane M. and Averill, Patricia M.}, title={{Assessing worry in older adults: Confirmatory factor analysis of the Penn State Worry Questionnaire and psychometric properties of an abbreviated model}}, journal={Psychological Assessment}, year={2003}, volume={15}, number={2}, pages={173--183}, doi={10.1037/1040-3590.15.2.173}}@article{meyer1990development, author={Meyer, T. J. and Miller, M. L. and Metzger, R. L. and Borkovec, Thomas D.}, title={{Development and validation of the Penn State Worry Questionnaire}}, journal={Behaviour Research and Therapy}, year={1990}, volume={28}, number={6}, pages={487--495}, doi={10.1016/0005-7967(90)90135-6}}@article{rodriguez2016evaluating, author={Rodriguez, Anthony and Reise, Steven P. and Haviland, Mark G.}, title={{Evaluating bifactor models: Calculating and interpreting statistical indices}}, journal={Psychological Methods}, year={2016}, volume={21}, number={2}, pages={137--150}, doi={10.1037/met0000045}}