Czym jest PANAS
PANAS (Positive and Negative Affect Schedule) to samoopisowa lista przymiotników opisujących uczucia i emocje. Opracowali ją Watson, Clark i Tellegen (1988), żeby mierzyć dwa wymiary, które w badaniach nad strukturą afektu pojawiały się najczęściej: afekt pozytywny (PA) i afekt negatywny (NA). Autorzy chcieli mieć dwie krótkie, rzetelne skale i zbudowali je po 10 pozycji. W ich danych obie podskale były wysoce spójne wewnętrznie i w dużej mierze nieskorelowane.
Najważniejsza informacja dla osoby, która liczy wyniki: PANAS daje dwa osobne wyniki, a nie jeden. Wysoki PA oznacza energię, entuzjazm i zaangażowanie. Wysoki NA oznacza różne nieprzyjemne stany, np. zdenerwowanie, lęk czy poczucie winy. Niski NA nie oznacza jednak wysokiego PA. Ten wpis należy do serii o liczeniu wyników kwestionariuszy. Podobnie opisaliśmy m.in. PSS-10 i WHO-5.
Budowa: 20 pozycji, dwie podskale, skala 1–5
PANAS ma 20 pozycji, po 10 w każdej podskali. Osoba badana ocenia, w jakim stopniu odczuwała dany stan, na pięciostopniowej skali od 1 (very slightly or not at all) do 5 (extremely) (Díaz-García i in., 2020). Pozycje to pojedyncze słowa. Treści nie przytaczamy, a przydział numerów pozycji do podskal weź z klucza w oryginalnej publikacji albo z materiałów wersji, której używasz.
| Cecha | PANAS | Źródło |
|---|---|---|
| Liczba pozycji | 20: 10 PA i 10 NA | Watson i in. (1988) |
| Skala odpowiedzi | 1–5, od very slightly or not at all do extremely | Díaz-García i in. (2020) |
| Pozycje odwrócone | brak; kierunek każdej podskali jest jednolity | wynika z budowy dwóch skal |
| Wyniki | suma 10 pozycji PA i osobno suma 10 pozycji NA; każda w zakresie 10–50 | wynika ze skali 1–5 |
| Wynik ogólny | brak; narzędzie składa się z dwóch skal | Watson i in. (1988) |
| Instrukcja czasowa | różna w zależności od badania, np. ostatni tydzień albo afekt „zazwyczaj” | Tuccitto i in. (2010); Leue i Beauducel (2011) |
| Wersja krótka | I-PANAS-SF, 10 pozycji | Thompson (2007) |
PANAS nie ma pozycji odwróconych. Przymiotniki NA nie są „odwróconymi” pozycjami PA, tylko należą do drugiej skali. Jeśli przekodujesz je jak pozycje odwrócone i dodasz do PA, stworzysz wynik, którego nikt nie walidował.
Instrukcja czasowa zmienia znaczenie wyniku
Ten sam zestaw pozycji może pytać o różne okresy. Tuccitto i in. (2010) pytali sportowców o emocje w ostatnim tygodniu. Leue i Beauducel (2011) porównali instrukcję dotyczącą cech (jak zwykle się czujesz) i stanów. Díaz-García i in. (2020) użyli wersji cechowej. Wynik z instrukcją dotyczącą ostatnich dni opisuje stan, a z instrukcją „zazwyczaj” bliżej mu do cechy. W opisie narzędzia zawsze podaj więc dokładne brzmienie okresu i nie porównuj wprost średnich uzyskanych przy różnych instrukcjach.
Jak policzyć wynik PANAS krok po kroku
Krok 1. Sprawdź kodowanie 1–5
Formularze online często zapisują odpowiedzi jako 0–4 albo jako tekst. Sprawdź, czy w danych są tylko wartości 1–5 i czy 5 oznacza „bardzo silnie”. Jak przekodować odpowiedzi w różnych programach, pokazuje poradnik jak policzyć wynik kwestionariusza.
Krok 2. Przypisz pozycje do podskal
Utwórz dwie listy kolumn według klucza: 10 pozycji PA i 10 pozycji NA. Najlepiej nazwij kolumny tak, żeby przynależność była widoczna, np. pa1–pa10 i na1–na10. Błąd w przydziale jednej pozycji nie wywoła komunikatu, ale obniży korelację tej pozycji z resztą podskali, więc sprawdzisz go w kroku rzetelności.
Krok 3. Zsumuj każdą podskalę osobno
Możesz też podać średnią z pozycji (1–5). Wnioski się nie zmienią, ale porównanie z literaturą wymaga tej samej metryki. Różnice opisuje hasło wynik skali: średnia czy suma.
Krok 4. Ustal regułę dla braków
Oryginalna publikacja nie podaje reguły dla braków, którą moglibyśmy tu przytoczyć. Najprostsze rozwiązanie to brak wyniku podskali, gdy brakuje w niej choćby jednej odpowiedzi. Jeśli wybierzesz inną regułę, np. średnią z dziewięciu pozycji pomnożoną przez 10, zapisz ją przed analizą i podaj jako własną decyzję. Mechanizmy braków omawia hasło braki danych MCAR, MAR i MNAR.
Przykład: PANAS u 300 osób studiujących
Dane są symulowane. Możesz je pobrać jako plik CSV: kolumny pa1–pa10 i na1–na10 (odpowiedzi 1–5) oraz stres, czyli wynik PSS-10 jako miara do sprawdzenia trafności. Dwie osoby pominęły jedną pozycję PA, a dwie inne jedną pozycję NA, więc każdy wynik ma 298 osób.
| Podskala | M (SD) | Me [IQR] | Zakres | Skośność | α [95% CI] | ω |
|---|---|---|---|---|---|---|
| Afekt pozytywny (PA) | 31.63 (7.18) | 31 [27, 37] | 14–49 | −0.05 | .88 [.86, .90] | .88 |
| Afekt negatywny (NA) | 21.22 (7.20) | 21 [15, 25.75] | 10–43 | 0.61 | .86 [.83, .88] | .86 |
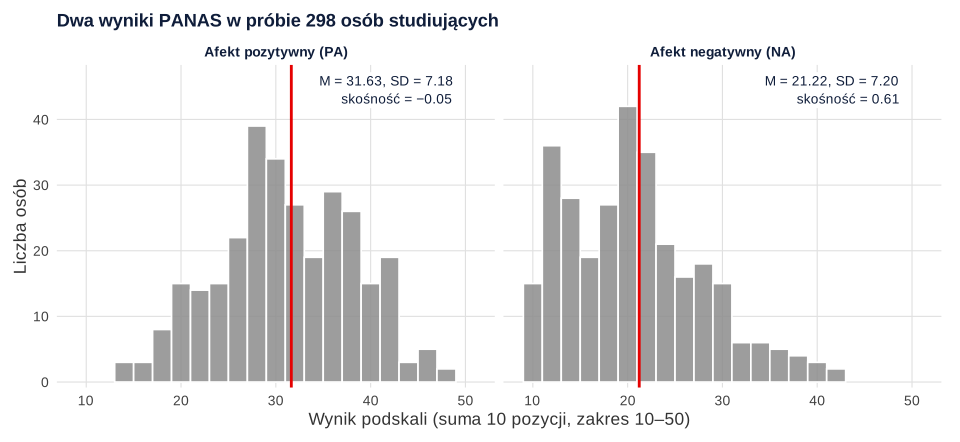
Rozkłady obu wyników różnią się kształtem (rysunek 1). PA jest prawie symetryczny i leży blisko środka skali. NA przesuwa się ku dolnej granicy: w nieklinicznej grupie większość osób rzadko przeżywa silne negatywne emocje. Minimalny wynik 10 miało 2.01% osób, więc efekt podłogi jest niewielki, ale prawostronna skośność wynosi 0.61. Przy takich danych obok średniej podaj medianę i IQR.
Rzetelność: osobno dla PA i NA
Alfa Cronbacha wyniosła .88 dla PA i .86 dla NA. Skorygowane korelacje pozycja–reszta mieściły się w przedziale .52–.72 w PA i .41–.72 w NA. Dla porównania Díaz-García i in. (2020) w próbie klinicznej uzyskali .91 i .87. Ponieważ alfa wymaga restrykcyjnych założeń, obok niej podaj omegę McDonalda (McNeish, 2018). Z modelu dwuczynnikowego wyniosła ona .88 dla PA i .86 dla NA. Rzetelność licz zawsze dla każdej podskali osobno. Alfa dla wszystkich 20 pozycji wyniosła w przykładzie .73 i nic nie znaczy, bo dotyczy mieszaniny dwóch konstruktów. Gotowe zdania o spójności wewnętrznej znajdziesz we wzorze raportowania alfy Cronbacha.
PA i NA to nie dwa końce jednej skali
Watson i in. (1988) opisali PA i NA jako wymiary w dużej mierze nieskorelowane. Późniejsze badania pokazują związek umiarkowany i ujemny. Crawford i Henry (2004) w próbie 1003 dorosłych z Wielkiej Brytanii odrzucili hipotezę całkowitej niezależności PA i NA. Díaz-García i in. (2020) w grupie klinicznej uzyskali r = −.30. W przykładzie korelacja wyniosła r = −.29, 95% CI [−.39, −.19], p < .001. Wspólna wariancja to więc około 9%, a osoba może mieć jednocześnie wysoki PA i wysoki NA.
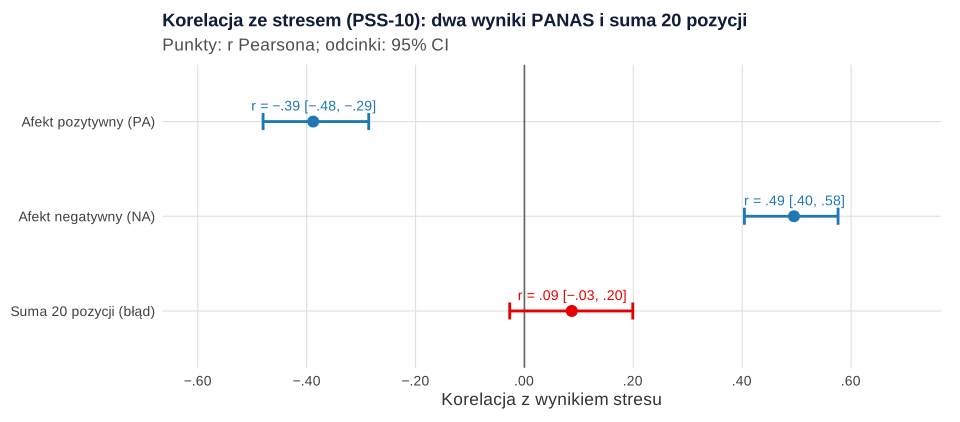
Z tego wynika praktyczna różnica. Wynik stresu korelował z PA ujemnie, r = −.39, 95% CI [−.48, −.29], a z NA dodatnio, r = .49, 95% CI [.40, .58]. Gdyby zsumować wszystkie 20 pozycji, oba związki by się znosiły. Taka „suma” korelowała ze stresem tylko na poziomie r = .09, 95% CI [−.03, .20], p = .136 (rysunek 2). To typowy objaw złego wyniku ogólnego, który łączy podskale o przeciwnych związkach z kryterium. Dwie odrębne korelacje to zarazem dowód trafności zbieżnej i różnicowej.
Struktura czynnikowa w CFA
Jeśli praca wymaga sprawdzenia struktury, porównaj w CFA trzy modele: jeden czynnik, dwa czynniki skorelowane i dwa czynniki ortogonalne. Odpowiedzi 1–5 są porządkowe, więc w przykładzie użyliśmy estymatora WLSMV (n = 296 osób bez braków).
| Model | χ²(df) | CFI | TLI | RMSEA | SRMR |
|---|---|---|---|---|---|
| Jeden czynnik | 1178.92 (170) | .683 | .646 | .142 | .149 |
| Dwa czynniki skorelowane | 158.68 (169) | 1.000 | 1.004 | .000 | .041 |
| Dwa czynniki ortogonalne | 440.77 (170) | .915 | .905 | .073 | .110 |
Model jednoczynnikowy był wyraźnie źle dopasowany. Model ortogonalny był gorszy od modelu z korelacją czynników, Δχ²(1) = 28.17, p < .001. Korelacja czynników wyniosła −.33, 95% CI [−.45, −.22], a ładunki mieściły się w przedziale .59–.81 dla PA i .47–.81 dla NA. Tak dobre dopasowanie wynika z symulacji. Prawdziwe dane wypadają zwykle gorzej. Díaz-García i in. (2020) uzyskali CFI = .917 i RMSEA = .112.
Literatura nie daje jednej odpowiedzi o strukturze PANAS. Crawford i Henry (2004) najlepsze dopasowanie uzyskali dla dwóch skorelowanych czynników z dopuszczonymi korelacjami błędów pozycji z tych samych kategorii nastroju. Tuccitto i in. (2010) wskazali model ortogonalny z takimi korelacjami błędów i zwrócili uwagę na kilka powtarzalnie problematycznych pozycji. Leue i Beauducel (2011) zaproponowali model bifactor z dodatkowym czynnikiem ogólnym. Jeśli dodajesz korelacje błędów, uzasadnij je treścią pozycji, a nie samymi indeksami modyfikacji. Przy porównaniach grup najpierw sprawdź inwariancję pomiaru. Szerzej o wyborze między EFA i CFA piszemy w poradniku analiza czynnikowa EFA i CFA.
Interpretacja i normy
PANAS nie ma progów diagnostycznych. Wynik interpretuj jako zmienną ciągłą: wyższy PA to więcej pozytywnego afektu, wyższy NA to więcej negatywnego afektu, w okresie wskazanym w instrukcji. Watson i in. (1988) oraz Crawford i Henry (2004) opublikowali dane normatywne. Dotyczą one jednak prób amerykańskich i brytyjskich oraz konkretnych instrukcji czasowych, więc nie przenoś ich na polskie osoby badane. Jeśli promotor prosi o podział na wynik niski, przeciętny i wysoki, przeczytaj najpierw poradnik niski, przeciętny, wysoki wynik.
Jak opisać PANAS w pracy
Wzór zawiera liczby z przykładu. Uzupełnij informację o wersji językowej i instrukcji.
Ogólny schemat opisu narzędzia znajdziesz w poradniku opis narzędzia badawczego – wzór, a całą ścieżkę analizy kwestionariusza – w przewodniku analiza kwestionariusza.
Prawa autorskie i warunki użycia
Według karty narzędzia w bazie ePROVIDE prawa autorskie do PANAS od 1988 roku należą do American Psychological Association (APA). Do użycia wersji oryginalnej w badaniach niekomercyjnych nie trzeba kontaktować się z działem zezwoleń APA. Użytkownicy komercyjni muszą zwrócić się do APA. Tak samo w sprawie przekładów i elektronicznej wersji kwestionariusza karta odsyła bezpośrednio do APA (Mapi Research Trust, 2026). Mapi Research Trust dystrybuuje tylko trzy własne przekłady (francuski, niemiecki i szwedzki), a za ich użycie mogą obowiązywać opłaty.
Przed badaniem przeczytaj aktualne warunki na karcie narzędzia, zwłaszcza jeśli zbierasz dane w formularzu online. Jeśli korzystasz z polskiej wersji, zacytuj publikację jej adaptacji, którą przeczytałeś (przeczytałaś), i sprawdź warunki jej udostępnienia. Treści pozycji nie wklejaj do aneksu bez zgody właściciela praw. Stanowisko International Test Commission (2014) wyjaśnia, że pozycje testu są chronione prawem autorskim. Gdzie szukać narzędzi, opisuje poradnik gdzie znaleźć kwestionariusze psychologiczne.
PANAS w R: dwa wyniki, rzetelność i CFA
Kod odtwarza liczby z tekstu i zapisuje plik CSV. Wyniki to dwie linie rowSums(), alfę z przedziałem Feldta liczy pakiet psych, CFA – lavaan, a omegę – compRelSEM() z pakietu semTools. Czynniki w modelu nazwano Poz i Neg, bo NA jest w R słowem zarezerwowanym.
Wynik PANAS krok po kroku
R
# B133 – PANAS: dwa wyniki (PA i NA), rzetelność, korelacja PA–NA, struktura czynnikowa (dane symulowane, set.seed(13301)).
# 300 osób studiujących; 20 pozycji ocenianych od 1 do 5: pa1–pa10 (afekt pozytywny) i na1–na10 (afekt negatywny).
# Nazwy pa/na są umowne: przydział numerów pozycji do podskal weź z klucza w oryginalnej publikacji. Treści pozycji nie podajemy.
suppressPackageStartupMessages({ library(psych); library(lavaan); library(semTools) })
set.seed(13301)
n <- 300
f <- MASS::mvrnorm(n, c(0, 0), matrix(c(1, -.25, -.25, 1), 2))       # dwa czynniki, korelacja −.25
stres_lat <- -.35 * f[, 1] + .55 * f[, 2] + rnorm(n, 0, .75)
lam_pa <- c(.78, .72, .70, .66, .74, .62, .68, .71, .60, .65)
lam_na <- c(.70, .74, .64, .60, .72, .58, .66, .69, .62, .55)
progi_pa <- c(-1.6, -0.65, 0.25, 1.25)                               # odpowiedzi PA blisko środka skali
progi_na <- c(-0.35, 0.45, 1.20, 1.95)                               # odpowiedzi NA częściej przy 1 (podłoga)
gen <- function(lat, lam, progi) 1 + findInterval(lam * lat + rnorm(n, 0, sqrt(1 - lam^2)), progi)
pa <- sapply(lam_pa, function(l) gen(f[, 1], l, progi_pa)); colnames(pa) <- paste0("pa", 1:10)
na <- sapply(lam_na, function(l) gen(f[, 2], l, progi_na)); colnames(na) <- paste0("na", 1:10)
dane <- data.frame(id = 1:n, pa, na)
dane$stres <- round(pmin(40, pmax(0, 18 + 6.5 * stres_lat)))          # wynik PSS-10 (0–40) jako miara kryterialna
dane$na6[c(17, 142)] <- NA; dane$pa3[c(88, 251)] <- NA                # cztery pojedyncze braki
write.csv(dane, "../panas-dane-przyklad.csv", row.names = FALSE)     # plik do pobrania

# Krok 1. Kontrola zakresu: tylko 1–5 albo brak
pozycje <- c(paste0("pa", 1:10), paste0("na", 1:10))
all(sapply(dane[pozycje], function(x) all(x %in% c(1:5, NA))))
colSums(is.na(dane[pozycje]))[colSums(is.na(dane[pozycje])) > 0]

# Krok 2. Dwa wyniki: suma 10 pozycji PA i suma 10 pozycji NA (każdy 10–50); bez wyniku ogólnego
dane$PA_wynik <- rowSums(dane[paste0("pa", 1:10)])
dane$NA_wynik <- rowSums(dane[paste0("na", 1:10)])
c(PA_z_wynikiem = sum(!is.na(dane$PA_wynik)), NA_z_wynikiem = sum(!is.na(dane$NA_wynik)))
opis <- function(x) { x <- na.omit(x); round(c(M = mean(x), SD = sd(x), Me = median(x), Q1 = unname(quantile(x, .25)),
  Q3 = unname(quantile(x, .75)), min = min(x), max = max(x), skosnosc = psych::skew(x), proc_10 = 100 * mean(x == 10)), 2) }
rbind(PA = opis(dane$PA_wynik), "NA" = opis(dane$NA_wynik))

# Krok 3. Rzetelność każdej podskali osobno: alfa (95% CI Feldta) i zakres korelacji pozycja–reszta
rz <- function(v) { a <- alpha(na.omit(dane[v]), warnings = FALSE)
  round(c(alfa = a$total$raw_alpha, lo = a$feldt$lower.ci[[1]], hi = a$feldt$upper.ci[[1]],
          r_min = min(a$item.stats$r.drop), r_max = max(a$item.stats$r.drop)), 3) }
rbind(PA = rz(paste0("pa", 1:10)), "NA" = rz(paste0("na", 1:10)))
# Błąd: alfa „całego PANAS” z 20 pozycji
round(alpha(na.omit(dane[pozycje]), warnings = FALSE, check.keys = FALSE)$total$raw_alpha, 3)

# Krok 4. Związek PA z NA i z miarą kryterialną (stres)
kor <- function(x, y) { t <- cor.test(x, y); c(round(c(r = unname(t$estimate), lo = t$conf.int[1], hi = t$conf.int[2]), 3), p = signif(t$p.value, 3)) }
rbind(PA_NA = kor(dane$PA_wynik, dane$NA_wynik), PA_stres = kor(dane$PA_wynik, dane$stres), NA_stres = kor(dane$NA_wynik, dane$stres))
# Błąd: suma 20 pozycji jako „wynik ogólny” – z czym koreluje?
dane$suma20 <- dane$PA_wynik + dane$NA_wynik
rbind(suma20_PA = kor(dane$suma20, dane$PA_wynik), suma20_NA = kor(dane$suma20, dane$NA_wynik), suma20_stres = kor(dane$suma20, dane$stres))

# Krok 5. Struktura: jeden czynnik vs dwa skorelowane vs dwa ortogonalne (WLSMV, odpowiedzi porządkowe)
pelne <- na.omit(dane[pozycje])
m_pa <- paste("Poz =~", paste0("pa", 1:10, collapse = " + "))
m_na <- paste("Neg =~", paste0("na", 1:10, collapse = " + "))
m1 <- cfa(paste("G =~", paste(pozycje, collapse = " + ")), data = pelne, ordered = TRUE, estimator = "WLSMV", std.lv = TRUE)
m2 <- cfa(paste(m_pa, m_na, sep = "\n"), data = pelne, ordered = TRUE, estimator = "WLSMV", std.lv = TRUE)
m2o <- cfa(paste(m_pa, m_na, sep = "\n"), data = pelne, ordered = TRUE, estimator = "WLSMV", std.lv = TRUE, orthogonal = TRUE)
miary <- c("chisq.scaled", "df.scaled", "cfi.scaled", "tli.scaled", "rmsea.scaled", "srmr")
round(rbind(jeden = fitMeasures(m1, miary), dwa_skorelowane = fitMeasures(m2, miary), dwa_ortogonalne = fitMeasures(m2o, miary)), 3)
lavTestLRT(m2, m2o)[2, c("Chisq diff", "Df diff", "Pr(>Chisq)")]
std <- standardizedSolution(m2)
round(rbind(PA = range(std$est.std[std$op == "=~" & std$lhs == "Poz"]), "NA" = range(std$est.std[std$op == "=~" & std$lhs == "Neg"])), 2)
round(std[std$op == "~~" & std$lhs == "Poz" & std$rhs == "Neg", c("est.std", "ci.lower", "ci.upper")], 3)
# Omega każdej podskali z modelu dwuczynnikowego (zmienne traktowane jako ciągłe)
m2c <- cfa(paste(m_pa, m_na, sep = "\n"), data = pelne, std.lv = TRUE)
round(unlist(compRelSEM(m2c)), 3)
Wynik w R
[1] TRUE
pa3 na6
  2   2
PA_z_wynikiem NA_z_wynikiem
          298           298
       M   SD Me Q1    Q3 min max skosnosc proc_10
PA 31.63 7.18 31 27 37.00  14  49    -0.05    0.00
NA 21.22 7.20 21 15 25.75  10  43     0.61    2.01
    alfa    lo    hi r_min r_max
PA 0.878 0.856 0.897 0.523 0.716
NA 0.856 0.830 0.879 0.409 0.723
[1] 0.725
              r     lo     hi        p
PA_NA    -0.293 -0.394 -0.185 2.79e-07
PA_stres -0.388 -0.480 -0.286 4.09e-12
NA_stres  0.495  0.404  0.576 7.71e-20
                 r     lo    hi        p
suma20_PA    0.598  0.519 0.666 4.82e-30
suma20_NA    0.591  0.512 0.661 2.67e-29
suma20_stres 0.087 -0.027 0.199 1.36e-01
                chisq.scaled df.scaled cfi.scaled tli.scaled rmsea.scaled  srmr
jeden               1178.918       170      0.683      0.646        0.142 0.149
dwa_skorelowane      158.676       169      1.000      1.004        0.000 0.041
dwa_ortogonalne      440.769       170      0.915      0.905        0.073 0.110
    Chisq diff Df diff Pr(>Chisq)
m2o     28.171       1  1.111e-07 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
   [,1] [,2]
PA 0.59 0.81
NA 0.47 0.81
    est.std ci.lower ci.upper
123  -0.334    -0.45   -0.219
  Poz   Neg
0.880 0.858
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5.8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (R package version 0.5-8) [Computer software]. https://CRAN.R-project.org/package=semTools
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy PANAS
- Jeden wynik z 20 pozycji. W przykładzie taka suma prawie nie korelowała ze stresem, choć obie podskale korelowały z nim wyraźnie.
- Odwracanie pozycji NA. NA to osobna skala, a nie odwrócone pozycje PA.
- Wynik „PA minus NA” bez uzasadnienia. Jeśli chcesz liczyć różnicę, potrzebujesz źródła, które ją uzasadnia. Bez niego analizuj dwa wyniki.
- Brak informacji o instrukcji czasowej. Afekt w ostatnim tygodniu i afekt „zazwyczaj” to różne zmienne.
- Kodowanie 0–4. Zakres przesuwa się wtedy do 0–40 i nie da się porównać średnich z literaturą.
- Normy z innego kraju jako punkt odniesienia. Nie podawaj „normy” bez zacytowania źródła, populacji i instrukcji.
- Alfa dla całego kwestionariusza. Licz rzetelność dla PA i NA osobno.
Jeśli chcesz sprawdzić liczenie wyników PANAS i analizy w swojej pracy, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Czy PANAS ma wynik ogólny?
Nie. PANAS składa się z dwóch skal po 10 pozycji: afektu pozytywnego i afektu negatywnego (Watson i in., 1988). Suma 20 pozycji łączy wymiary o przeciwnych związkach z innymi zmiennymi, więc analizuj dwa wyniki osobno.
Jaki jest zakres wyniku PA i NA w PANAS?
Każdą z 10 pozycji ocenia się od 1 do 5, więc suma podskali mieści się w zakresie 10–50. Jeśli wolisz średnią z pozycji, zakres wynosi 1–5. Podaj w pracy, którą metrykę wybrałeś (wybrałaś).
Czy afekt pozytywny i negatywny to przeciwieństwa?
Nie. To dwa odrębne wymiary, zwykle umiarkowanie i ujemnie skorelowane, np. r = −.30 w próbie klinicznej (Díaz-García i in., 2020). Ta sama osoba może mieć wysoki afekt pozytywny i wysoki negatywny.
Czy do pracy magisterskiej potrzebna jest zgoda na użycie PANAS?
Według karty narzędzia w bazie ePROVIDE do badań niekomercyjnych nie trzeba kontaktować się z działem zezwoleń APA, która ma prawa autorskie. W sprawie użycia komercyjnego, przekładów i wersji elektronicznej karta odsyła do APA. Przed badaniem sprawdź aktualne warunki.
Jaką instrukcję czasową wybrać w PANAS?
Zależy od pytania badawczego: krótki okres (np. ostatni tydzień) opisuje stan, a instrukcja „zazwyczaj” – raczej cechę. Wybierz jedną przed badaniem, podaj jej brzmienie w opisie narzędzia i porównuj się z badaniami, które użyły tej samej instrukcji.
Powiązane hasła
Przeczytaj też
Jak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikPSS-10 – jak policzyć wynik
Skala 0–4, pozycje odwrócone 4, 5, 7 i 8, suma 0–40, brak punktów odcięcia, rzetelność i struktura – z przykładem w R i wzorem opisu w pracy.
Czytaj →PoradnikOpis narzędzia badawczego – wzór
Dziesięć elementów opisu i cztery wzory: kwestionariusz z adaptacją, ankieta własna, test wiedzy i skala kliniczna – z rzetelnością z własnej próby.
Czytaj →Masz wyniki PANAS i nie wiesz, jak je przeanalizować?
Sprawdzimy liczenie wyników PA i NA, rzetelność i strukturę w Twojej próbie oraz wyjaśnimy analizy tak, żebyś umiał(a) samodzielnie opisać i obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Crawford, J. R., & Henry, J. D. (2004). The Positive and Negative Affect Schedule (PANAS): Construct validity, measurement properties and normative data in a large non-clinical sample. British Journal of Clinical Psychology, 43(3), 245–265. https://doi.org/10.1348/0144665031752934 ● Otwarty dostęp
- Díaz-García, A., González-Robles, A., Mor, S., Mira, A., Quero, S., García-Palacios, A., Baños, R. M., & Botella, C. (2020). Positive and Negative Affect Schedule (PANAS): Psychometric properties of the online Spanish version in a clinical sample with emotional disorders. BMC Psychiatry, 20(1), Article 56. https://doi.org/10.1186/s12888-020-2472-1 ● Otwarty dostęp
- International Test Commission. (2014). ITC statement on the use of tests and other assessment instruments for research purposes (Version 1.2). https://www.intestcom.org/files/statement_using_tests_for_research.pdf ● Otwarty dostęp
- Leue, A., & Beauducel, A. (2011). The PANAS structure revisited: On the validity of a bifactor model in community and forensic samples. Psychological Assessment, 23(1), 215–225. https://doi.org/10.1037/a0021400
- Mapi Research Trust. (2026). Positive and Negative Affect Schedule (PANAS). ePROVIDE. https://eprovide.mapi-trust.org/instruments/positive-and-negative-affect-schedule ● Otwarty dostęp
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Thompson, E. R. (2007). Development and validation of an internationally reliable short-form of the Positive and Negative Affect Schedule (PANAS). Journal of Cross-Cultural Psychology, 38(2), 227–242. https://doi.org/10.1177/0022022106297301
- Tuccitto, D. E., Giacobbi, P. R., & Leite, W. L. (2010). The internal structure of positive and negative affect: A confirmatory factor analysis of the PANAS. Educational and Psychological Measurement, 70(1), 125–141. https://doi.org/10.1177/0013164409344522
- Watson, D., Clark, L. A., & Tellegen, A. (1988). Development and validation of brief measures of positive and negative affect: The PANAS scales. Journal of Personality and Social Psychology, 54(6), 1063–1070. https://doi.org/10.1037/0022-3514.54.6.1063
Cytowania BibTeX
@article{crawford2004panas, author={Crawford, John R. and Henry, Julie D.}, title={{The Positive and Negative Affect Schedule (PANAS): Construct validity, measurement properties and normative data in a large non-clinical sample}}, journal={British Journal of Clinical Psychology}, year={2004}, volume={43}, number={3}, pages={245--265}, doi={10.1348/0144665031752934}}@article{diazgarcia2020panas, author={Díaz-García, Amanda and González-Robles, Alberto and Mor, Sonia and Mira, Adriana and Quero, Soledad and García-Palacios, Azucena and Baños, Rosa María and Botella, Cristina}, title={{Positive and Negative Affect Schedule (PANAS): Psychometric properties of the online Spanish version in a clinical sample with emotional disorders}}, journal={BMC Psychiatry}, year={2020}, volume={20}, number={1}, eid={56}, doi={10.1186/s12888-020-2472-1}}@techreport{itc2014statement, author={{International Test Commission}}, title={{ITC statement on the use of tests and other assessment instruments for research purposes}}, year={2014}, institution={International Test Commission}, url={https://www.intestcom.org/files/statement_using_tests_for_research.pdf}}@article{leue2011panas, author={Leue, Anja and Beauducel, André}, title={{The PANAS structure revisited: On the validity of a bifactor model in community and forensic samples}}, journal={Psychological Assessment}, year={2011}, volume={23}, number={1}, pages={215--225}, doi={10.1037/a0021400}}@misc{mapi2026panas, author={{Mapi Research Trust}}, title={{Positive and Negative Affect Schedule (PANAS)}}, howpublished={ePROVIDE}, year={2026}, publisher={Mapi Research Trust}, url={https://eprovide.mapi-trust.org/instruments/positive-and-negative-affect-schedule}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{thompson2007development, author={Thompson, Edmund R.}, title={{Development and validation of an internationally reliable short-form of the Positive and Negative Affect Schedule (PANAS)}}, journal={Journal of Cross-Cultural Psychology}, year={2007}, volume={38}, number={2}, pages={227--242}, doi={10.1177/0022022106297301}}@article{tuccitto2010internal, author={Tuccitto, Daniel E. and Giacobbi, Peter R. and Leite, Walter L.}, title={{The internal structure of positive and negative affect: A confirmatory factor analysis of the PANAS}}, journal={Educational and Psychological Measurement}, year={2010}, volume={70}, number={1}, pages={125--141}, doi={10.1177/0013164409344522}}@article{watson1988development, author={Watson, David and Clark, Lee Anna and Tellegen, Auke}, title={{Development and validation of brief measures of positive and negative affect: The PANAS scales}}, journal={Journal of Personality and Social Psychology}, year={1988}, volume={54}, number={6}, pages={1063--1070}, doi={10.1037/0022-3514.54.6.1063}}