Czym są MMSE i MoCA
MMSE (Mini-Mental State Examination) i MoCA (Montreal Cognitive Assessment) to krótkie testy przesiewowe funkcji poznawczych. Oba wykonuje się w bezpośrednim kontakcie z badanym i oba dają wynik ogólny od 0 do 30 punktów. MMSE opisali Folstein, Folstein i McHugh (1975), a dziś wydaje go PAR (PAR, b.d.-a). MoCA opracowali Nasreddine i in. (2005) jako 10-minutowe narzędzie, które ma pomóc lekarzom pierwszego kontaktu wykrywać łagodne zaburzenia poznawcze (MCI).
Testy te często pojawiają się w pracach z pielęgniarstwa, geriatrii, neuropsychologii i fizjoterapii. Zwykle jako zmienna opisująca grupę, kryterium włączenia albo wynik porównywany z innymi pomiarami. Ogólny warsztat tych kierunków opisują wpisy statystyka w pracy z pielęgniarstwa, statystyka dla psychologa, statystyka dla fizjoterapeuty i statystyka dla lekarza. W badaniach osób starszych MMSE lub MoCA często stoją obok GDS-15, indeksu Barthel i skali Lawtona.
Czego tu nie ma. Nie podajemy treści zadań, instrukcji badania ani zasad punktowania poszczególnych części. Oba testy są chronione prawem autorskim, a MoCA wymaga szkolenia. Nie piszemy też, jak interpretować wynik konkretnej osoby. To zadanie dla specjalisty, a nie dla analizy statystycznej. Wpis dotyczy licencji, tego, co wiadomo o progach z publikacji źródłowych, i analizy danych w pracy dyplomowej.
Licencje: MMSE i MoCA
To najważniejsza część dla studenta. Bez zgody możesz nie mieć prawa użyć testu w badaniu ani dołączyć go do pracy.
| Kwestia | MMSE | MoCA |
|---|---|---|
| Kto ma prawa | wydawca PAR (PAR, b.d.-a) | MoCA Test Inc. (MoCA Test Inc., b.d.-b) |
| Użycie w badaniu naukowym | oryginalne formularze od wydawcy; powielanie materiałów wymaga pisemnej zgody PAR (PAR, b.d.-b) | wymaga zgody (formularz na stronie MoCA); podmioty komercyjne i farmaceutyczne – zgoda i umowa licencyjna (MoCA Test Inc., b.d.-a) |
| Użycie kliniczne i edukacyjne przez uczelnie i placówki | jak wyżej – formularze od wydawcy | bez zgody, test ma być bezpłatny dla pacjentów (MoCA Test Inc., b.d.-a) |
| Szkolenie | strona produktu podaje poziom kwalifikacji użytkownika „S” | strona o zgodach: szkolenie i certyfikacja obowiązkowe od 1 września 2019 r.; FAQ: certyfikacja wymagana przy interpretacji zadań i domen, a opcjonalna przy przesiewie z samego wyniku ogólnego |
| Test w aneksie pracy | PAR nie zgadza się na cały test w pracy dyplomowej; kilka przykładowych pozycji – tylko za zgodą | druk testu wymaga zgody; nie wolno zamieszczać testu ani instrukcji na innych stronach |
| Tłumaczenie, zmiana formatu, wersja elektroniczna | wymaga wcześniejszej pisemnej zgody; PAR wymienia autoryzowane tłumaczenia | tworzenie wersji elektronicznych jest zabronione |
Co z tego wynika dla pracy dyplomowej. Przy MoCA złóż prośbę o zgodę na użycie w badaniu naukowym i sprawdź wymagania szkoleniowe. Strony MoCA opisują certyfikację różnie, więc trzymaj się wymogu, który obowiązuje w chwili Twojego badania. Przy MMSE korzystaj z oryginalnych formularzy wydawcy, a nie z kopii z internetu. Każde powielenie, tłumaczenie czy przeniesienie do ankiety online wymaga zgody PAR. W żadnym przypadku nie dołączaj testu do aneksu. W metodologii opisz wersję, źródło formularzy i uzyskane zgody. Kwot nie podajemy. Ogólnie o licencjach pisze hasło licencja narzędzia badawczego.
Wynik i progi: co mówią źródła
MMSE. Maksymalny wynik to 30 punktów (PAR, b.d.-a). Artykuł Folsteina i in. (1975) jest płatny, a bazy nie mają jego abstraktu, więc nie podajemy z niego progów. Wydawca na stronie produktu też nie podaje progu. W literaturze krąży kilka punktów odcięcia. Jeśli promotor wymaga podziału, zacytuj publikację, z której pochodzi próg, i opisz go jako przyjęty za tym źródłem. Crum, Anthony, Bassett i Folstein (1993), z udziałem twórcy testu, pokazali w dużej próbie z USA, że wynik MMSE zależy od wieku i wykształcenia. Mediana wynosiła 29 przy co najmniej 9 latach nauki i 22 przy 0–4 latach. Autorzy piszą, że MMSE służy do wykrywania bieżących trudności poznawczych, a nie do formalnego rozpoznania.
MoCA. Wynik ogólny też ma zakres 0–30. Nasreddine i in. (2005) porównali MoCA i MMSE u 94 osób z MCI, 93 z łagodną chorobą Alzheimera i 90 zdrowych osób starszych, przyjmując punkt odcięcia 26 dla obu testów. MoCA wykryła 90% osób z MCI, a MMSE 18%. W łagodnej chorobie Alzheimera czułość wyniosła 100% i 78%. Swoistość była wyższa dla MMSE (100%) niż dla MoCA (87%). Pełnego tekstu nie czytaliśmy. Korektę za wykształcenie podajemy więc za oficjalną stroną MoCA: przy 12 latach nauki lub mniej dodaje się 1 punkt, ale nie przy wyniku 30 (MoCA Test Inc., b.d.-b). Strona zaznacza, że niektóre wersje mają inne korekty. Inne przedziały opisane na stronie pomijamy, bo nie pochodzą z artykułu z 2005 r.
Oba testy to badania przesiewowe. Wynik poniżej progu oznacza „wynik dodatni w przesiewie”, a nie rozpoznanie. W pracy pisz o odsetku wyników poniżej progu, a nie o „odsetku osób z otępieniem”.
Przykład: 300 osób w wieku 60+
Dane są symulowane i możesz je pobrać jako plik CSV. Plik zawiera tylko wyniki ogólne obu testów, wiek, lata nauki i rozpoznanie referencyjne: norma (130 osób), MCI (100) i łagodne otępienie (70). Rozpoznanie referencyjne to w prawdziwym badaniu ocena kliniczna niezależna od obu testów. Bez niej nie policzysz czułości ani swoistości.
Rozkład wyników i efekt sufitu
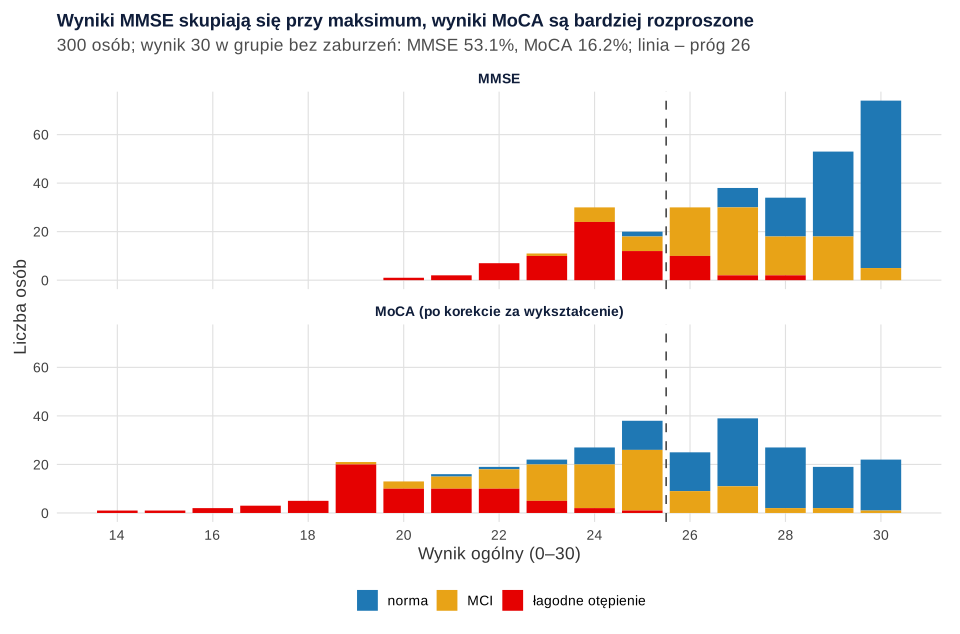
Wyniki obu testów są ograniczone do 30 punktów i silnie skośne. W grupie bez zaburzeń mediana MMSE wyniosła 30, a 53.1% osób uzyskało wynik maksymalny. W MoCA mediana wyniosła 27, a wynik 30 miało 10.8% osób przed korektą i 16.2% po korekcie. Taki efekt sufitu oznacza, że MMSE nie różnicuje osób o dobrym funkcjonowaniu (rysunek 1). Dlatego nie porównuj grup średnią i testem t bez zastanowienia. Podaj medianę, kwartyle i odsetek wyników 30. Do porównań użyj testu Manna–Whitneya albo regresji porządkowej. Przy wynikach zmiany pamiętaj, że osoba z wynikiem 30 nie może się „poprawić”.
Wykształcenie jako współzmienna
Korekta +1 punkt to prosta poprawka wbudowana w wynik. W analizie warto dodatkowo traktować wykształcenie jako zmienną kontrolną. W regresji wielorakiej z rozpoznaniem i wiekiem każdy rok nauki wiązał się z wyższym wynikiem MoCA o 0.36 punktu, 95% CI [0.28, 0.43], i MMSE o 0.22 punktu [0.18, 0.27]. W grupie bez zaburzeń korelacja Spearmana MoCA z latami nauki spadła po korekcie z .41 do .21, ale nie zniknęła. Dla MMSE wyniosła .51. Korekta zmniejsza więc związek z wykształceniem, ale go nie usuwa. Gdy porównujesz grupy o różnym wykształceniu, podaj wynik skorygowany zgodnie ze źródłem i dodaj wykształcenie do modelu. Kiedy taka kontrola ma sens, wyjaśnia wpis czy kontrolować wiek i płeć.
Trafność diagnostyczna: ROC względem rozpoznania
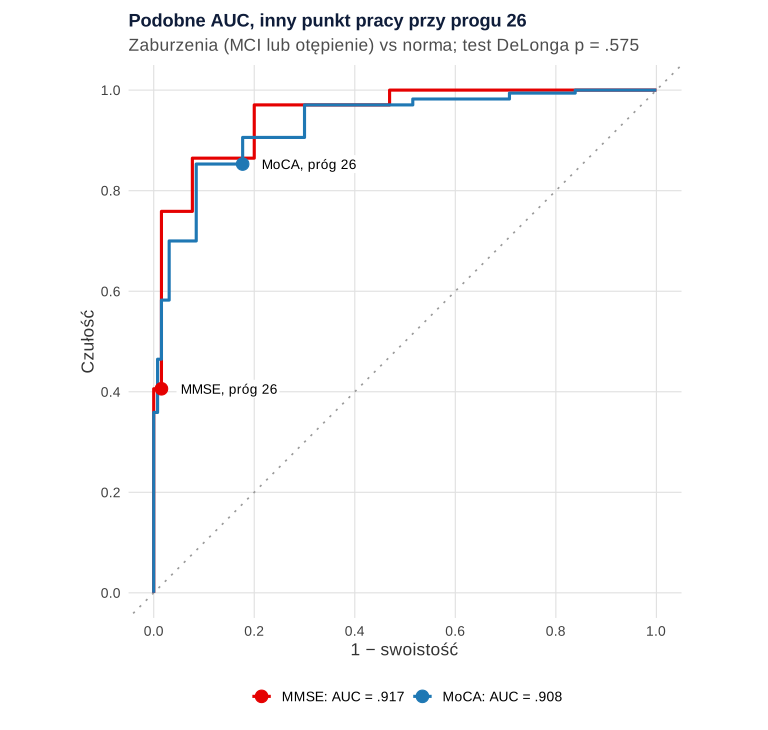
Zdolność testu do odróżniania osób z zaburzeniami (MCI lub otępienie) od osób bez nich sprawdzasz krzywą ROC względem rozpoznania referencyjnego. Pełną procedurę opisuje wpis krzywa ROC i punkt odcięcia krok po kroku. W przykładzie (pakiet pROC; Robin i in., 2011) AUC wyniosło .917, 95% CI [.887, .947] dla MMSE i .908 [.876, .940] dla MoCA. Krzywe pochodzą od tych samych osób, więc porównaliśmy je testem DeLonga (DeLong i in., 1988): Z = 0.56, p = .575.
Przy progu 26 obraz jest inny niż przy AUC. MoCA miała czułość .853 [.792, .898] i swoistość .823 [.748, .879]. MMSE przy tym samym progu, jak w porównaniu Nasreddine i in. (2005), miała czułość .406 [.335, .481] i swoistość .985 [.946, .996]. Wśród osób z MCI wynik poniżej 26 w MoCA miało 75%, a w MMSE 13%. Podobne AUC nie znaczy więc, że testy działają tak samo przy przyjętym progu (rysunek 2). Kierunek różnic zgadza się z wynikami Nasreddine i in. (2005), ale liczby pochodzą z symulacji. Nie wyznaczaj „najlepszego” progu na własnej małej próbie. Jeśli to robisz, opisz go jako eksploracyjny.
Zgodność obu testów
Jeśli te same osoby wykonały oba testy, możesz zapytać, na ile się zgadzają. Korelacja Spearmana wyników wyniosła ρ = .84, czyli osoby są podobnie uporządkowane. Klasyfikacje przy progu 26 zgadzały się jednak tylko u 66.3% osób, kappa Cohena = .367. U 99 osób wynik MoCA był poniżej progu, a MMSE nie, odwrotnie tylko u 2. Test McNemara potwierdził tę asymetrię, χ²(1) = 91.25, p < .001 (zob. kalkulator kappy i testu McNemara). Wysoka korelacja nie oznacza więc wymienności testów.
Nie licz metody Blanda–Altmana na surowych punktach. MMSE i MoCA mierzą na różnych skalach i mają inny poziom trudności, więc różnica punktów nie jest błędem pomiaru. W literaturze istnieją tabele przeliczeń między testami. Jeśli z nich korzystasz, zacytuj źródło i opisz to jako przybliżenie.
Jak opisać MMSE i MoCA w pracy
Wzory zawierają liczby z przykładu. W nawiasach kwadratowych uzupełnij dane swojej wersji i zgód.
Ogólny schemat opisu narzędzia znajdziesz w poradniku opis narzędzia badawczego – wzór, a inne narzędzia – w katalogu narzędzi badawczych.
MMSE i MoCA w R: sufit, wykształcenie, ROC i zgodność
Kod odtwarza liczby z tekstu i zapisuje plik CSV z wynikami ogólnymi (bez pozycji testów). Krzywe ROC, przedziały AUC i test DeLonga liczy pakiet pROC; pozostałe analizy korzystają z bazowego R.
Analiza wyników MMSE i MoCA krok po kroku
R
# B304 – MMSE i MoCA: analiza wyników ogólnych (dane symulowane, set.seed(3041)).
# Plik zawiera tylko wyniki ogólne 0–30, bez pozycji i bez instrukcji badania.
# Korekta MoCA (+1 punkt przy wykształceniu ≤ 12 lat, bez dodawania przy wyniku 30) i próg 26 –
# według oficjalnej strony MoCA i artykułu Nasreddine i in. (2005); inne progi nie są tu używane.
# 300 osób w wieku 60+ z rozpoznaniem referencyjnym: norma, MCI (łagodne zaburzenia poznawcze), łagodne otępienie.
suppressPackageStartupMessages(library(pROC))
set.seed(3041)
n <- 300
rozpoznanie <- factor(rep(c("norma", "MCI", "otepienie"), c(130, 100, 70)), levels = c("norma", "MCI", "otepienie"))
wiek <- round(runif(n, 60, 88))
wyksztalcenie <- pmin(20, pmax(6, round(rnorm(n, 12.5, 3))))         # lata nauki
pozn <- c(norma = 0, MCI = -1.1, otepienie = -2.4)[as.character(rozpoznanie)] +
  0.10 * (wyksztalcenie - 12) - 0.02 * (wiek - 72) + rnorm(n, 0, 0.45)
ogr <- function(x) pmin(30, pmax(0, round(x)))
mmse <- ogr(29.4 + 2.2 * pozn + rnorm(n, 0, 1.0))
moca <- ogr(26.6 + 3.0 * pozn + 0.12 * (wyksztalcenie - 12) + rnorm(n, 0, 1.3))
dane <- data.frame(id = 1:n, wiek, wyksztalcenie, rozpoznanie, mmse, moca)
write.csv(dane, "../mmse-moca-dane-przyklad.csv", row.names = FALSE)   # plik do pobrania
d <- dane

# Krok 1. Rozkład wyników: mediana, kwartyle i odsetek wyników maksymalnych (30) w każdej grupie
opis <- function(x) c(Me = median(x), Q1 = unname(quantile(x, .25)), Q3 = unname(quantile(x, .75)),
                      proc_30 = round(100 * mean(x == 30), 1))
do.call(rbind, lapply(split(d, d$rozpoznanie), function(g) c(MMSE = opis(g$mmse), MoCA = opis(g$moca))))
round(c(MMSE_30_cala = 100 * mean(d$mmse == 30), MoCA_30_cala = 100 * mean(d$moca == 30)), 1)

# Krok 2. Korekta MoCA za wykształcenie: +1 przy ≤ 12 latach nauki, gdy wynik < 30
d$moca_kor <- ifelse(d$wyksztalcenie <= 12 & d$moca < 30, d$moca + 1, d$moca)
table(korekta = d$moca_kor - d$moca)
round(100 * tapply(d$moca_kor == 30, d$rozpoznanie, mean), 1)   # odsetek wyników 30 po korekcie

# Krok 3. Wykształcenie jako współzmienna: regresja wyniku na rozpoznanie, lata nauki i wiek
m_moca <- lm(moca ~ rozpoznanie + wyksztalcenie + wiek, data = d)
m_mmse <- lm(mmse ~ rozpoznanie + wyksztalcenie + wiek, data = d)
round(cbind(b = coef(m_moca), confint(m_moca))["wyksztalcenie", ], 2)
round(cbind(b = coef(m_mmse), confint(m_mmse))["wyksztalcenie", ], 2)
# Czy po korekcie +1 zostaje związek z wykształceniem? Korelacja Spearmana w grupie bez zaburzeń
nor <- d[d$rozpoznanie == "norma", ]
sapply(list(MoCA_surowy = nor$moca, MoCA_po_korekcie = nor$moca_kor, MMSE = nor$mmse),
       function(x) round(cor(x, nor$wyksztalcenie, method = "spearman"), 2))

# Krok 4. ROC względem rozpoznania referencyjnego: zaburzenia (MCI lub otępienie) vs norma
d$zaburzenia <- as.integer(d$rozpoznanie != "norma")
r_mmse <- roc(d$zaburzenia, d$mmse, levels = c(0, 1), direction = ">", quiet = TRUE)
r_moca <- roc(d$zaburzenia, d$moca_kor, levels = c(0, 1), direction = ">", quiet = TRUE)
round(rbind(MMSE = as.numeric(ci.auc(r_mmse, method = "delong")),
            MoCA = as.numeric(ci.auc(r_moca, method = "delong"))), 3)    # dolna granica, AUC, górna granica
dl <- roc.test(r_mmse, r_moca, method = "delong", paired = TRUE)
round(c(Z = unname(dl$statistic), p = dl$p.value), 4)

# Krok 5. Czułość i swoistość przy progu 26 (wynik < 26 = wynik dodatni) z 95% CI Wilsona
wilson <- function(x, n) { z <- qnorm(.975); p <- x / n
  c(p = p, lo = (p + z^2 / (2 * n) - z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2))) / (1 + z^2 / n),
    hi = (p + z^2 / (2 * n) + z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2))) / (1 + z^2 / n)) }
cs <- function(wynik) { dod <- wynik < 26
  rbind(czulosc = wilson(sum(dod & d$zaburzenia == 1), sum(d$zaburzenia == 1)),
        swoistosc = wilson(sum(!dod & d$zaburzenia == 0), sum(d$zaburzenia == 0))) }
round(cs(d$moca_kor), 3)
round(cs(d$mmse), 3)       # ten sam próg 26 dla MMSE – tak jak w porównaniu Nasreddine i in. (2005)
# Czułość osobno dla MCI i dla otępienia
round(sapply(c("MCI", "otepienie"), function(g) c(MoCA = mean(d$moca_kor[d$rozpoznanie == g] < 26),
                                                  MMSE = mean(d$mmse[d$rozpoznanie == g] < 26))), 3)

# Krok 6. Zgodność obu testów: korelacja Spearmana, tabela klasyfikacji, kappa Cohena i test McNemara
round(cor(d$mmse, d$moca_kor, method = "spearman"), 2)
tab <- table(MMSE_ponizej_26 = d$mmse < 26, MoCA_ponizej_26 = d$moca_kor < 26); tab
po <- sum(diag(tab)) / sum(tab); pe <- sum(rowSums(tab) * colSums(tab)) / sum(tab)^2
round(c(zgodnosc = po, kappa = (po - pe) / (1 - pe)), 3)
mc <- mcnemar.test(tab); round(c(chi2 = unname(mc$statistic), p = mc$p.value), 4)
Wynik w R
          MMSE.Me MMSE.Q1 MMSE.Q3 MMSE.proc_30 MoCA.Me MoCA.Q1 MoCA.Q3 MoCA.proc_30
norma          30      29      30         53.1      27      26      28         10.8
MCI            27      26      28          5.0      24      22      25          1.0
otepienie      24      23      25          0.0      19      18      21          0.0
MMSE_30_cala MoCA_30_cala
        24.7          5.0
korekta
  0   1
149 151
    norma       MCI otepienie
     16.2       1.0       0.0
     b  2.5 % 97.5 %
  0.36   0.28   0.43
     b  2.5 % 97.5 %
  0.22   0.18   0.27
     MoCA_surowy MoCA_po_korekcie             MMSE
            0.41             0.21             0.51
      [,1]  [,2]  [,3]
MMSE 0.887 0.917 0.947
MoCA 0.876 0.908 0.940
     Z      p
0.5611 0.5747
              p    lo    hi
czulosc   0.853 0.792 0.898
swoistosc 0.823 0.748 0.879
              p    lo    hi
czulosc   0.406 0.335 0.481
swoistosc 0.985 0.946 0.996
      MCI otepienie
MoCA 0.75       1.0
MMSE 0.13       0.8
[1] 0.84
               MoCA_ponizej_26
MMSE_ponizej_26 FALSE TRUE
          FALSE   130   99
          TRUE      2   69
zgodnosc    kappa
   0.663    0.367
   chi2       p
91.2475  0.0000
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, 77. https://doi.org/10.1186/1471-2105-12-77
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy MMSE i MoCA
- Test z internetu bez zgody. Formularze MMSE pochodzą od wydawcy, a MoCA wymaga zgody na badania naukowe i szkolenia.
- Test w aneksie pracy. PAR nie zgadza się na cały test w pracy dyplomowej, a MoCA wymaga zgody na druk.
- Próg bez źródła. Każdy punkt odcięcia zacytuj. Próg 26 w MoCA pochodzi z pracy Nasreddine i in. (2005).
- Wynik poniżej progu jako rozpoznanie. To wynik przesiewu. Rozpoznanie stawia specjalista.
- Średnia i test t przy efekcie sufitu. Podaj medianę i odsetek wyników 30. Użyj metod nieparametrycznych lub porządkowych.
- Pominięcie wykształcenia. Zastosuj korektę ze źródła i kontroluj wykształcenie w modelu.
- Korelacja jako dowód zgodności. Przy porównaniu testów pokaż też zgodność klasyfikacji (kappa) i jej asymetrię.
Jeśli chcesz, żeby ktoś sprawdził analizę wyników MMSE lub MoCA w Twojej bazie, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Czy do pracy magisterskiej potrzebna jest zgoda na MMSE?
Tak, jeśli powielasz formularz, tłumaczysz go albo przenosisz do innej formy. Materiały MMSE są chronione prawem autorskim, a ich powielanie wymaga pisemnej zgody PAR (stan na 1 listopada 2026 r.). Korzystaj z oryginalnych formularzy wydawcy. PAR nie zgadza się na zamieszczenie całego testu w pracy dyplomowej.
Czy MoCA można używać w badaniach za darmo?
Według oficjalnej strony użycie kliniczne i edukacyjne przez uczelnie i placówki nie wymaga zgody, ale użycie w badaniach naukowych wymaga zgody (formularz na stronie). Strona wymaga też szkolenia i certyfikacji, a FAQ opisuje ten wymóg węziej. Sprawdź warunki aktualne w dniu badania.
Jaki jest punkt odcięcia w MoCA?
Nasreddine i in. (2005) przyjęli próg 26: przy nim MoCA wykryła 90% osób z MCI i 100% z łagodną chorobą Alzheimera, przy swoistości 87%. Oficjalna strona MoCA dodaje 1 punkt przy wykształceniu 12 lat lub mniej, poza wynikiem 30. Wynik poniżej progu to wynik dodatni w przesiewie, nie rozpoznanie.
Jaki jest punkt odcięcia w MMSE?
Artykuł Folsteina i in. (1975) jest płatny i nie ma abstraktu w bazach, a wydawca nie podaje progu na stronie produktu. W literaturze krąży kilka progów. Jeśli go potrzebujesz, zacytuj publikację, z której pochodzi. Pamiętaj, że wynik MMSE zależy od wieku i wykształcenia (Crum i in., 1993).
Jak porównać MMSE i MoCA u tych samych osób?
Trafność obu testów sprawdź krzywymi ROC względem rozpoznania referencyjnego i porównaj AUC testem DeLonga dla prób zależnych. Zgodność klasyfikacji przy progu opisz kappą Cohena i testem McNemara. Sama korelacja wyników nie wystarczy, a metody Blanda–Altmana nie stosuj do surowych punktów dwóch różnych testów.
Powiązane hasła
Przeczytaj też
Krzywa ROC i punkt odcięcia krok po kroku
AUC z 95% CI, tabela progów, trzy reguły wyboru progu, czułość i swoistość z przedziałami oraz test DeLonga dla dwóch skal – w R z pakietem pROC.
Czytaj →PoradnikGDS-15 – jak policzyć wynik
Klucz tak/nie, pozycje punktowane za „nie”, progi powyżej 5 i 10, braki, KR-20 oraz czułość i swoistość – z przykładem w R i wzorem opisu.
Czytaj →PoradnikStatystyka w pracy z pielęgniarstwa
Wiedza pacjentów, skale kliniczne, satysfakcja, edukacja przed i po i wypalenie personelu: plan analiz, testy, wielkość efektu, APA i kod R.
Czytaj →PoradnikRegresja porządkowa krok po kroku
Model proporcjonalnych szans w R: progi, ilorazy szans, prawdopodobieństwa przewidywane, test Branta i tabela APA – na danych do pobrania.
Czytaj →Masz w pracy wyniki MMSE lub MoCA i nie wiesz, jak je przeanalizować?
Sprawdzimy dobór analiz przy efekcie sufitu, kontrolę wykształcenia, analizę ROC i zgodność testów, a potem wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Crum, R. M., Anthony, J. C., Bassett, S. S., & Folstein, M. F. (1993). Population-based norms for the Mini-Mental State Examination by age and educational level. JAMA, 269(18), 2386–2391. https://doi.org/10.1001/jama.1993.03500180078038
- DeLong, E. R., DeLong, D. M., & Clarke-Pearson, D. L. (1988). Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach. Biometrics, 44(3), 837–845. https://doi.org/10.2307/2531595
- Folstein, M. F., Folstein, S. E., & McHugh, P. R. (1975). “Mini-mental state”: A practical method for grading the cognitive state of patients for the clinician. Journal of Psychiatric Research, 12(3), 189–198. https://doi.org/10.1016/0022-3956(75)90026-6
- MoCA Test Inc. (b.d.-a). Permission. MoCA Cognition. https://mocacognition.com/permission/ ● Otwarty dostęp
- MoCA Test Inc. (b.d.-b). FAQ. MoCA Cognition. https://mocacognition.com/faq/ ● Otwarty dostęp
- Nasreddine, Z. S., Phillips, N. A., Bédirian, V., Charbonneau, S., Whitehead, V., Collin, I., Cummings, J. L., & Chertkow, H. (2005). The Montreal Cognitive Assessment, MoCA: A brief screening tool for mild cognitive impairment. Journal of the American Geriatrics Society, 53(4), 695–699. https://doi.org/10.1111/j.1532-5415.2005.53221.x
- PAR, Inc. (b.d.-a). MMSE: Mini-Mental State Examination. https://www.parinc.com/products/MMSE ● Otwarty dostęp
- PAR, Inc. (b.d.-b). Permissions and licensing. https://www.parinc.com/programs-partnerships/permissions-and-licensing ● Otwarty dostęp
- Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12(1), Article 77. https://doi.org/10.1186/1471-2105-12-77 ● Otwarty dostęp
Cytowania BibTeX
@article{crum1993population, author={Crum, Rosa M. and Anthony, James C. and Bassett, Susan S. and Folstein, Marshal F.}, title={{Population-based norms for the Mini-Mental State Examination by age and educational level}}, journal={JAMA}, year={1993}, volume={269}, number={18}, pages={2386--2391}, doi={10.1001/jama.1993.03500180078038}}@article{delong1988comparing, author={DeLong, Elizabeth R. and DeLong, David M. and Clarke-Pearson, Daniel L.}, title={{Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach}}, journal={Biometrics}, year={1988}, volume={44}, number={3}, pages={837--845}, doi={10.2307/2531595}}@article{folstein1975mini, author={Folstein, Marshal F. and Folstein, Susan E. and McHugh, Paul R.}, title={{“Mini-mental state”: A practical method for grading the cognitive state of patients for the clinician}}, journal={Journal of Psychiatric Research}, year={1975}, volume={12}, number={3}, pages={189--198}, doi={10.1016/0022-3956(75)90026-6}}@misc{mocapermissionnd, author={{MoCA Test Inc.}}, title={{Permission}}, howpublished={MoCA Cognition}, year={b.d.-a}, url={https://mocacognition.com/permission/}}@misc{mocafaqnd, author={{MoCA Test Inc.}}, title={{FAQ}}, howpublished={MoCA Cognition}, year={b.d.-b}, url={https://mocacognition.com/faq/}}@article{nasreddine2005montreal, author={Nasreddine, Ziad S. and Phillips, Natalie A. and Bédirian, Valérie and Charbonneau, Simon and Whitehead, Victor and Collin, Isabelle and Cummings, Jeffrey L. and Chertkow, Howard}, title={{The Montreal Cognitive Assessment, MoCA: A brief screening tool for mild cognitive impairment}}, journal={Journal of the American Geriatrics Society}, year={2005}, volume={53}, number={4}, pages={695--699}, doi={10.1111/j.1532-5415.2005.53221.x}}@misc{parmmsend, author={{PAR, Inc.}}, title={{MMSE: Mini-Mental State Examination}}, howpublished={PAR}, year={b.d.-a}, url={https://www.parinc.com/products/MMSE}}@misc{parpermissionsnd, author={{PAR, Inc.}}, title={{Permissions and licensing}}, howpublished={PAR}, year={b.d.-b}, url={https://www.parinc.com/programs-partnerships/permissions-and-licensing}}@article{robin2011proc, author={Robin, Xavier and Turck, Natacha and Hainard, Alexandre and Tiberti, Natalia and Lisacek, Frédérique and Sanchez, Jean-Charles and Müller, Markus}, title={{pROC: An open-source package for R and S+ to analyze and compare ROC curves}}, journal={BMC Bioinformatics}, year={2011}, volume={12}, number={1}, eid={77}, doi={10.1186/1471-2105-12-77}}