Kim jest Peter J. Huber?
Peter J. Huber (ur. 1934) to statystyk urodzony w Wohlen w Szwajcarii, twórca estymatorów M i jeden z ojców statystyki odpornej. W 1958 r. uzyskał dyplom z matematyki, a w 1961 r. doktorat na Politechnice Federalnej w Zurychu (ETH). Doktorat dotyczył matematyki czystej: teorii kategorii i analogii między topologią a algebrą. Promotor, topolog Beno Eckmann, chciał go zatrzymać w topologii (Buja i Künsch, 2008).
Pod koniec 1960 r. ETH szukał statystyka i dwaj profesorowie, Walter Saxer i Eduard Stiefel, zaproponowali to Huberowi. Uznał, że statystyka matematyczna jest bliska analizie funkcjonalnej, przeczytał podręcznik B. L. van der Waerdena oraz książki Walda i Dooba i w 1961 r. wyjechał na staż do Berkeley. Tam, w wydziale, którego siłą napędową był wtedy Jerzy Neyman, napisał swoją najsłynniejszą pracę – o odpornej estymacji parametru położenia (Huber, 1964). Rad, jak ją opublikować, udzielił mu Erich Lehmann.
Po roku w Cornell wrócił w 1964 r. na ETH i pracował tam do 1978 r. Potem był profesorem na Harvardzie (1978–1988), w MIT (1988–1992) i na Uniwersytecie w Bayreuth (1992–1999, do emerytury). W 1972 r. wygłosił wykłady Walda, w 1988 r. otrzymał nagrodę Humboldta, a w 1994 r. doktorat honorowy Uniwersytetu w Neuchâtel. Opublikował cztery książki i ponad 70 prac ze statystyki (Buja i Künsch, 2008).
Najważniejsze pomysły
- Estymatory M (1964). Huber założył, że dane pochodzą z rozkładu normalnego z niewielką domieszką ε grubych błędów, i szukał estymatora położenia najlepszego w najgorszym takim przypadku. Wyszedł mu estymator pośredni między średnią a medianą: funkcja straty jest kwadratowa dla małych odchyleń i liniowa dla dużych (Huber, 1964). Zainspirowała go praca Johna Tukeya z 1960 r. o próbkowaniu z rozkładów zanieczyszczonych (Buja i Künsch, 2008).
- Wnioskowanie, gdy model jest zły (1967). Pokazał, że estymatory największej wiarygodności i ogólniej estymatory M są zgodne i asymptotycznie normalne także wtedy, gdy prawdziwy rozkład nie należy do zakładanej rodziny (Huber, 1967). Z tego wyniku wyrasta „kanapkowy” wzór wariancji, z którego korzysta się do dziś.
- Monografia „Robust Statistics” (1981) – pierwszy podręcznik całej teorii (Huber, 1981).
- Analiza danych i grafika. Po roku poświęconym metodom odpornym w Princeton (1970/71) przeszedł do analizy danych: grafiki interaktywnej, metody projection pursuit (z Davidem Donoho) i strategii analizy (Buja i Künsch, 2008).
Ciekawostka
Huber jest także badaczem pisma klinowego. Jako szesnastolatek w gimnazjum uczył się go z książek kantonalnej biblioteki Argowii; poznał język akadyjski, trochę hetyckiego, a w czasie doktoratu pisał rozdziały o astronomii babilońskiej do książki van der Waerdena. Napisał o tym ponad tuzin prac i dwie książki (Buja i Künsch, 2008).
Analizował babilońskie obserwacje Wenus, używane do datowania dynastii Hammurabiego. W 1973 r. van der Waerden poprosił go, by zastąpił go w dyskusji o hipotezach Immanuela Velikovsky’ego, według których Wenus jeszcze w czasach historycznych zmieniała orbitę. Panel odbył się 25 lutego 1974 r. na zjeździe AAAS w San Francisco, z udziałem Velikovsky’ego i Carla Sagana. Huber argumentował na podstawie tabliczek, że w pierwszej połowie II tysiąclecia p.n.e. Wenus była już na obecnej orbicie. „New York Times” przedstawił go wtedy jako „Professor of ancient history”. Sam ocenił po latach, że w takich sporach dowody ważą mniej niż opinie (Buja i Künsch, 2008).
Przykład: miedź w mące i cena ubezpieczenia
Zbiór chem z pakietu MASS to – według pliku pomocy – 24 oznaczenia zawartości miedzi w mące pełnoziarnistej (ppm). Dwadzieścia dwa wyniki leżą między 2.20 a 3.77; odstają 5.28 i 28.95. Średnia wynosi 4.280, mediana 3.385, a estymator Hubera (stała k = 1.345, skala MAD = 0.526) – 3.216.
Estymator Hubera liczymy ręcznie jako iteracyjnie ważoną średnią: start od mediany, potem 3.247, 3.223, 3.218… – po 15 krokach wynik jest stały i zgodny z funkcją MASS::huber(). Wynik 28.95 dostaje wagę 0.028, wynik 5.28 – 0.343, a 17 z 24 oznaczeń ma pełną wagę 1. Dla porównania: po usunięciu wyniku 28.95 średnia spada do 3.208, czyli bardzo blisko wartości Hubera z pełnych danych.
Odporność ma cenę. Przy czystym rozkładzie normalnym sprawność asymptotyczna estymatora Hubera z k = 1.345 wynosi 0.950, a mediany – tylko 0.637 (zob. efektywność estymatora). W symulacji (set.seed(1964), 20 000 prób po 24 obserwacje z rozkładu normalnego z domieszką ε obserwacji o trzykrotnie większym odchyleniu standardowym; parametry dobrane przez nas) n·MSE przy ε = 0 wyniosło 0.990 dla średniej, 1.051 dla Hubera i 1.479 dla mediany. Przy ε = 5% było to już 1.394, 1.177 i 1.581, a przy ε = 25% – 3.012, 1.925 i 2.194. Ze średnią Huber przegrał tylko przy ε = 0 i 1%.
Na rysunku
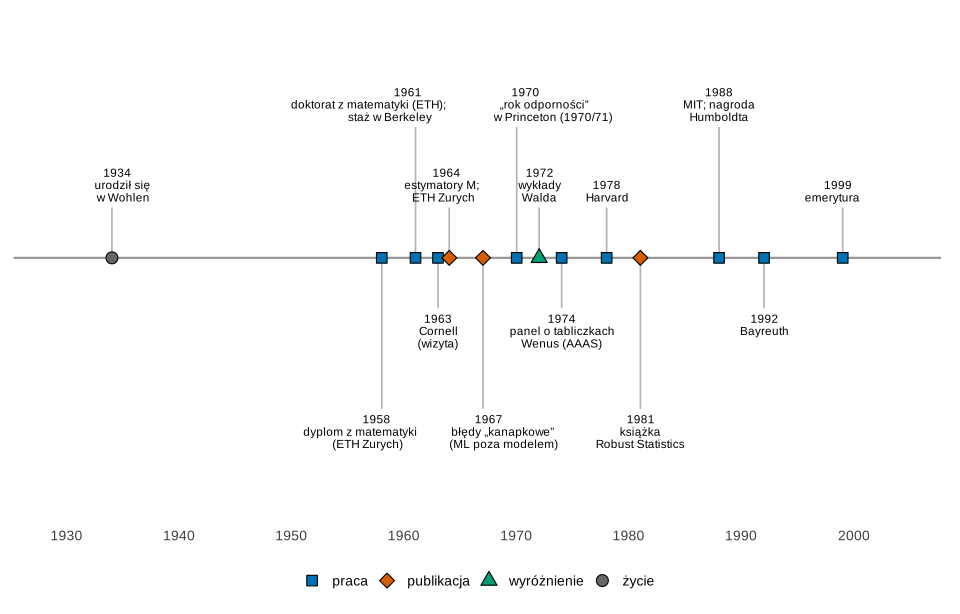
Co widać. Przejście od topologii do statystyki w 1961 r., najważniejsze prace o odporności w latach 1964–1981, a potem kolejne uczelnie w USA i w Niemczech.
Na co uważać. Wybór zdarzeń jest nasz; oś pomija m.in. prace o testach odpornych.
Podpis do pracy:
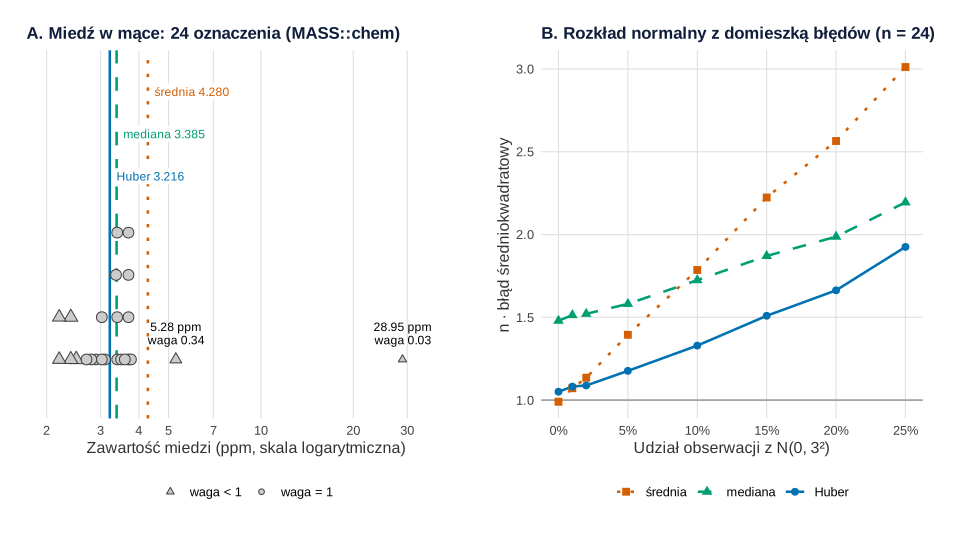
MASS::chem (A) i błąd średniokwadratowy średniej, mediany i estymatora Hubera przy rozkładzie normalnym z domieszką grubych błędów (B). Obliczenia i rysunek: R, pakiety MASS, ggplot2 i patchwork (set.seed(1964), 20 000 prób po 24 obserwacje).Co widać. W panelu A wynik 28.95 ppm odciąga średnią od skupiska, a mediana i estymator Hubera zostają w środku. W panelu B błąd średniej rośnie najszybciej.
Na co uważać. Panel B to symulacja z symetrycznym zanieczyszczeniem; błędy w jedną stronę dodatkowo obciążają każdy estymator. Błąd Monte Carlo wynosi około ±2%.
Podpis do pracy:
Gdzie spotkasz Hubera w swojej pracy
- Regresja odporna. Funkcja
MASS::rlm()domyślnie używa funkcji Hubera z k = 1.345 – zob. estymator M. - Błędy „kanapkowe”. Odporne błędy standardowe HC, estymator MLR w modelach SEM (Huber–White) i błędy w GEE mają tę samą budowę: wariancja liczona bez zakładania, że model rozkładu jest prawdziwy.
- Pojęcia, którymi opisujesz odporność. Funkcję wpływu i punkt załamania wprowadził Frank Hampel, który w 1968 r. przyjechał do Zurychu i prowadził z Huberem wspólne seminaria (Buja i Künsch, 2008).
Spory, mity i trudne strony
- „Szwajcarska ostrożność”? Zapytany, czy idea zapłacenia z góry niewielkiej ceny jako ubezpieczenia od katastrofy nie jest typowo szwajcarska, Huber odpowiedział, że pomysł ubezpieczenia pochodzi od Franka Anscombe’a (Buja i Künsch, 2008).
- Teoria z 1964 r. Krytykowano ją za założenie symetrycznych zanieczyszczeń i „sklejane” rozkłady najmniej korzystne. Huber odpowiadał, że rozkłady te bywały bliższe prawdziwym danym niż normalny, a pełniejszym rozwiązaniem nazywał swoje późniejsze odporne przedziały ufności dla skończonych prób. Przyznał też, że nie był pewien, czy teoria z 1964 r. jest „tym właściwym”, ale nadała odporności powagę (Buja i Künsch, 2008).
- Odporność to nie usuwanie danych. Wynik 28.95 nadal liczy się z małą wagą; czy to błąd, rozstrzyga wiedza o pomiarze.
Estymator Hubera w R
Kod liczy ręcznie estymator Hubera (iteracyjnie ważona średnia ze skalą MAD) dla danych MASS::chem, porównuje go z funkcją MASS::huber(), oblicza sprawność przy rozkładzie normalnym, symuluje próby z rozkładu zanieczyszczonego i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Ziarno: set.seed(1964); udział zanieczyszczeń, ich odchylenie standardowe (3) i liczebność próby (24, jak w danych) ustaliliśmy ręcznie.
1. Estymator Hubera na danych i w symulacji: rysunek 2
Kod R rysunku 2
# Estymator Hubera położenia liczony ręcznie (IRLS) na danych MASS::chem oraz „cena ubezpieczenia” przy zanieczyszczonym rozkładzie normalnym
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(MASS)})
kol <- c("średnia" = "#D55E00", "mediana" = "#009E73", "Huber" = "#0072B2")   # Okabe–Ito
lin <- c("średnia" = "dotted", "mediana" = "dashed", "Huber" = "solid")
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

# Estymator Hubera: minimalizuje sumę ρ((x − μ)/s), gdzie ρ jest kwadratowa do ±k, a dalej liniowa.
# Iteracyjnie ważona średnia: waga w = min(1, k/|u|), u = (x − μ)/s; skala s = MAD (stała w trakcie iteracji).
huber_irls <- function(x, k = 1.345, tol = 1e-10, maks = 200) {
  s <- mad(x); mu <- median(x); sciezka <- mu
  for (i in seq_len(maks)) {
    w <- pmin(1, k / abs((x - mu) / s))
    mu_nowe <- sum(w * x) / sum(w)
    sciezka <- c(sciezka, mu_nowe)
    if (abs(mu_nowe - mu) < tol) break
    mu <- mu_nowe
  }
  list(mu = mu_nowe, s = s, w = pmin(1, k / abs((x - mu_nowe) / s)), sciezka = sciezka)
}

# 1. Dane: 24 oznaczenia miedzi w mące pełnoziarnistej (ppm), MASS::chem
data(chem, package = "MASS")
x <- chem
sort(x)
h <- huber_irls(x)
round(c(srednia = mean(x), mediana = median(x), Huber = h$mu, MAD = h$s), 3)
round(head(h$sciezka, 6), 4)          # kolejne kroki IRLS od mediany
length(h$sciezka) - 1                 # liczba iteracji
round(c(MASS_huber = MASS::huber(x, k = 1.345)$mu), 4)   # kontrola: ta sama wartość z pakietu MASS
wagi <- data.frame(x = x, waga = round(h$w, 3))
wagi[order(wagi$waga)[1:4], ]         # najmniejsze wagi
sum(h$w == 1)                         # ile oznaczeń ma pełną wagę
round(c(srednia_bez_28.95 = mean(x[x < 20]), Huber_bez_28.95 = huber_irls(x[x < 20])$mu), 3)

# 2. Sprawność przy rozkładzie normalnym: 1 / (n·Var) estymatora Hubera z k = 1.345 (asymptotycznie, skala znana)
k <- 1.345
E_psi2 <- integrate(function(z) pmin(pmax(z, -k), k)^2 * dnorm(z), -Inf, Inf)$value
E_psi_prim <- 2 * pnorm(k) - 1
round(c(sprawnosc_Huber = E_psi_prim^2 / E_psi2, sprawnosc_mediany = 2 / pi), 3)

# 3. Symulacja: próby po n = 24 z rozkładu (1 − ε)·N(0, 1) + ε·N(0, 3²); prawdziwe położenie = 0
set.seed(1964)
n <- 24; R <- 20000
eps <- c(0, 0.01, 0.02, 0.05, 0.10, 0.15, 0.20, 0.25)
huber_kolumny <- function(m, k = 1.345, iter = 50) {   # IRLS jednocześnie dla wszystkich prób (kolumn)
  mu <- apply(m, 2, median); s <- apply(m, 2, mad)
  for (i in 1:iter) {
    u <- sweep(sweep(m, 2, mu), 2, s, "/")
    w <- k / abs(u); w[w > 1] <- 1        # pmin() gubi wymiary macierzy
    mu <- colSums(w * m) / colSums(w)
  }
  mu
}
wyniki <- do.call(rbind, lapply(eps, function(e) {
  zanieczysz <- matrix(runif(n * R) < e, n, R)
  m <- matrix(rnorm(n * R), n, R) * ifelse(zanieczysz, 3, 1)
  est <- cbind("średnia" = colMeans(m), "mediana" = apply(m, 2, median), "Huber" = huber_kolumny(m))
  data.frame(eps = e, estymator = colnames(est), nMSE = n * colMeans(est^2))
}))
tab <- reshape(wyniki, idvar = "eps", timevar = "estymator", direction = "wide")
names(tab) <- c("eps", "srednia", "mediana", "Huber"); rownames(tab) <- NULL
round(tab, 3)

# Rysunek: A – 24 oznaczenia miedzi i trzy estymatory położenia; B – n·MSE w funkcji udziału zanieczyszczeń
est_chem <- data.frame(estymator = factor(names(kol), levels = names(kol)), wartosc = c(mean(x), median(x), h$mu))
pkt <- data.frame(x = x, waga = h$w, typ = ifelse(h$w < 1, "waga < 1", "waga = 1"))
pkt$y <- ave(pkt$x, round(pkt$x, 1), FUN = seq_along) * 0.12
pA <- ggplot(pkt, aes(x, y)) +
  geom_vline(data = est_chem, aes(xintercept = wartosc, colour = estymator, linetype = estymator), linewidth = 0.9) +
  geom_point(aes(shape = typ, size = waga), colour = "grey25", fill = "grey80") +
  geom_text(data = subset(pkt, waga < 0.5), aes(label = sprintf("%.2f ppm\nwaga %.2f", x, waga)), vjust = -0.7, size = 3.2, lineheight = 0.9) +
  geom_label(data = est_chem, aes(x = wartosc, y = c(0.88, 0.76, 0.64), label = sprintf("%s %.3f", estymator, wartosc), colour = estymator),
             hjust = 0, nudge_x = 0.01, size = 3.2, linewidth = 0, fill = "white", show.legend = FALSE) +
  scale_x_log10(breaks = c(2, 3, 4, 5, 7, 10, 20, 30), limits = c(2, 40)) +
  scale_y_continuous(limits = c(0, 0.95), breaks = NULL) +
  scale_shape_manual(values = c("waga = 1" = 21, "waga < 1" = 24), name = NULL) +
  scale_size_continuous(range = c(1.8, 3.4), guide = "none") +
  scale_colour_manual(values = kol, guide = "none") + scale_linetype_manual(values = lin, guide = "none") +
  labs(title = "A. Miedź w mące: 24 oznaczenia (MASS::chem)", x = "Zawartość miedzi (ppm, skala logarytmiczna)", y = NULL) +
  motyw
wyniki$estymator <- factor(wyniki$estymator, levels = names(kol))
pB <- ggplot(wyniki, aes(eps, nMSE, colour = estymator, linetype = estymator, shape = estymator)) +
  geom_hline(yintercept = 1, colour = "grey60") +
  geom_line(linewidth = 0.9) + geom_point(size = 2.4) +
  scale_colour_manual(values = kol, name = NULL) + scale_linetype_manual(values = lin, name = NULL) +
  scale_shape_manual(values = c("średnia" = 15, "mediana" = 17, "Huber" = 16), name = NULL) +
  scale_x_continuous(labels = function(v) paste0(v * 100, "%")) +
  labs(title = "B. Rozkład normalny z domieszką błędów (n = 24)", x = "Udział obserwacji z N(0, 3²)", y = "n · błąd średniokwadratowy") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.15, 1)) & theme(legend.position = "bottom")
p2
Wynik w R
 [1]  2.20  2.20  2.40  2.40  2.50  2.70  2.80  2.90  3.03  3.03  3.10  3.37
[13]  3.40  3.40  3.40  3.50  3.60  3.70  3.70  3.70  3.70  3.77  5.28 28.95
srednia mediana   Huber     MAD
  4.280   3.385   3.216   0.526
[1] 3.3850 3.2473 3.2226 3.2176 3.2165 3.2163
[1] 15
MASS_huber
    3.2163
       x  waga
17 28.95 0.028
13  5.28 0.343
12  2.20 0.697
20  2.20 0.697
[1] 17
srednia_bez_28.95   Huber_bez_28.95
            3.208             3.182
  sprawnosc_Huber sprawnosc_mediany
            0.950             0.637
   eps srednia mediana Huber
1 0.00   0.990   1.479 1.051
2 0.01   1.071   1.513 1.082
3 0.02   1.135   1.521 1.088
4 0.05   1.394   1.581 1.177
5 0.10   1.786   1.724 1.329
6 0.15   2.224   1.871 1.509
7 0.20   2.565   1.987 1.663
8 0.25   3.012   2.194 1.925
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Peter J. Huber (ur. 1934) – lata według Buji i Künscha (2008) oraz dat publikacji
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1934, 1958, 1961, 1963, 1964, 1967, 1970, 1972, 1974, 1978, 1981, 1988, 1992, 1999),
  opis = c("urodził się\nw Wohlen", "dyplom z matematyki\n(ETH Zurych)", "doktorat z matematyki (ETH);\nstaż w Berkeley", "Cornell\n(wizyta)",
           "estymatory M;\nETH Zurych", "błędy „kanapkowe”\n(ML poza modelem)", "„rok odporności”\nw Princeton (1970/71)", "wykłady\nWalda",
           "panel o tabliczkach\nWenus (AAAS)", "Harvard", "książka\nRobust Statistics", "MIT; nagroda\nHumboldta", "Bayreuth", "emerytura"),
  rodzaj = c("życie", "praca", "praca", "praca", "publikacja", "publikacja", "praca", "wyróżnienie", "praca", "praca", "publikacja",
             "praca", "praca", "praca"),
  poziom = c(0.5, -1.5, 1.3, -0.5, 0.5, -1.5, 1.3, 0.5, -0.5, 0.5, -1.5, 1.3, -0.5, 0.5),   # wysokość etykiety
  wyrownanie = c(0.3, 0.7, 0.8, 0.5, 0.6, 0.3, 0.2, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.7))
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1929, 2004), breaks = seq(1930, 2000, by = 10)) +
  scale_y_continuous(limits = c(-2.4, 2.2)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (mediana i MAD – median(), mad(), całkowanie – integrate() z pakietu stats; kontrola – huber() z pakietu MASS; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim jest Peter J. Huber?
Statystykiem urodzonym w 1934 r. w Wohlen w Szwajcarii, twórcą estymatorów M i jednym z ojców statystyki odpornej. Doktoryzował się z matematyki czystej na ETH Zurych (1961), a potem pracował na ETH, Harvardzie, w MIT i w Bayreuth, gdzie w 1999 r. przeszedł na emeryturę (Buja i Künsch, 2008).
Jak działa estymator Hubera?
To średnia ważona, w której wyniki bliskie środka danych mają wagę 1, a wyniki odległe o więcej niż k odporne odchylenia (zwykle k = 1.345, skala MAD) dostają wagę k/|u|. Wagi i wynik liczy się na zmianę, aż przestaną się zmieniać. Na danych o miedzi w mące daje 3.216 ppm, gdy średnia wynosi 4.280.
Skąd się wzięły błędy standardowe Hubera–White’a?
Z pracy Hubera z 1967 r., który pokazał, że estymatory największej wiarygodności i estymatory M mają rozkład asymptotycznie normalny także wtedy, gdy prawdziwy rozkład nie należy do zakładanego modelu (Huber, 1967). Odpowiedni wzór wariancji nazywa się dziś kanapkowym; korzystają z niego błędy HC, MLR w SEM i GEE.
Dlaczego Huber przeszedł z topologii do statystyki?
Pod koniec 1960 r. ETH szukał statystyka i profesorowie Saxer i Stiefel zaproponowali to Huberowi. Uznał, że statystyka matematyczna nie jest daleko od analizy funkcjonalnej, i mimo sprzeciwu promotora wyjechał w 1961 r. na staż do Berkeley (Buja i Künsch, 2008).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Buja, A., & Künsch, H. R. (2008). A conversation with Peter Huber. Statistical Science, 23(1), 120–135. https://doi.org/10.1214/07-sts251 ● Otwarty dostęp
- Huber, P. J. (1964). Robust estimation of a location parameter. The Annals of Mathematical Statistics, 35(1), 73–101. https://doi.org/10.1214/aoms/1177703732 ● Otwarty dostęp
- Huber, P. J. (1967). The behavior of maximum likelihood estimates under nonstandard conditions. In L. M. Le Cam & J. Neyman (Eds.), Proceedings of the Fifth Berkeley Symposium on Mathematical Statistics and Probability (Vol. 1, pp. 221–233). University of California Press. https://projecteuclid.org/euclid.bsmsp/1200512988
- Huber, P. J. (1981). Robust statistics. Wiley. https://doi.org/10.1002/0471725250
Cytowania BibTeX
@article{buja2008conversation, author={Buja, Andreas and Künsch, Hans R.}, title={{A conversation with Peter Huber}}, journal={Statistical Science}, year={2008}, volume={23}, number={1}, pages={120--135}, doi={10.1214/07-sts251}}@article{huber1964robust, author={Huber, Peter J.}, title={{Robust estimation of a location parameter}}, journal={The Annals of Mathematical Statistics}, year={1964}, volume={35}, number={1}, pages={73--101}, doi={10.1214/aoms/1177703732}}@inproceedings{huber1967behavior, author={Huber, Peter J.}, title={{The behavior of maximum likelihood estimates under nonstandard conditions}}, booktitle={Proceedings of the Fifth Berkeley Symposium on Mathematical Statistics and Probability}, year={1967}, volume={1}, pages={221--233}, publisher={University of California Press}, url={https://projecteuclid.org/euclid.bsmsp/1200512988}}@book{huber1981robust, author={Huber, Peter J.}, title={{Robust statistics}}, year={1981}, publisher={Wiley}, doi={10.1002/0471725250}}