Kim byli Erich L. Lehmann i Joseph L. Hodges?
Erich Leo Lehmann (1917–2009) urodził się 20 listopada 1917 r. w Strasburgu. W 1933 r., gdy w Niemczech władzę przejęli naziści, jego rodzina wyjechała do Szwajcarii. Lehmann spędził pięć lat w Zurychu i dwa lata na studiach matematycznych w Trinity College w Cambridge, a pod koniec 1940 r. przyjechał do Nowego Jorku. Za radą Richarda Couranta wybrał Uniwersytet Kalifornijski i 1 stycznia 1941 r. dotarł do Berkeley. W czasie wojny, za radą przewodniczącego wydziału matematyki Griffitha Evansa, przeszedł na statystykę. Doktorat obronił w czerwcu 1946 r. pod opieką Jerzego Neymana. W Berkeley został do końca życia: od 1955 r. jako profesor statystyki, od 1988 r. na emeryturze. Zmarł 12 września 2009 r. w Berkeley (Rojo, 2011).
Joseph Lawson Hodges Jr. (1922–2000) urodził się 10 kwietnia 1922 r. w Shreveport w Luizjanie. Na Uniwersytet Kalifornijski wstąpił w wieku 16 lat, w 1942 r. uzyskał licencjat z matematyki i – podobnie jak Lehmann – z powodu wojny przeszedł na statystykę. Doktorat u Neymana zrobił w 1949 r. i w tym samym roku zaczął uczyć w Berkeley, gdzie pracował aż do emerytury w 1991 r. W latach 1961–1964 redagował „The Annals of Mathematical Statistics”. Zmarł nagle na zawał serca 1 marca 2000 r. (Bickel i Lehmann, b.d.).
Latem 1944 r. obaj trafili do grupy analizy operacyjnej 20. Armii Powietrznej na Guamie. Lehmann służył tam od sierpnia 1944 do sierpnia 1945 r. Już wcześniej, jako doktoranci, dzielili w Berkeley pokój z Charlesem Steinem i Evelyn Fix (Rojo, 2011). Później napisali razem wiele artykułów i dwa podręczniki.
Najważniejsze pomysły
- Efektywność testów rangowych (1956). Hodges i Lehmann (1956) pokazali, że asymptotyczna efektywność Pitmana testu Wilcoxona dla dwóch prób względem testu t nigdy nie spada poniżej 0.864 – niezależnie od rozkładu (szerzej w haśle efektywność estymatora).
- Estymator Hodgesa–Lehmanna (1963). Hodges i Lehmann (1963) odwrócili test w estymator: z testu rangowego wyprowadzili punktową ocenę położenia lub przesunięcia, odporną na grube błędy. Dla jednej próby jest to mediana średnich Walsha, dla dwóch – mediana różnic par (estymator Hodgesa–Lehmanna). Jego efektywność względem średniej równa się efektywności Pitmana odpowiedniego testu rangowego względem testu t.
- Teoria testowania. Książka Lehmanna Testing Statistical Hypotheses (1959; wydania z 1986 i 2005 r.) uporządkowała teorię testów Neymana–Pearsona. Jej pierwsze wydanie przełożono m.in. na polski (1968). Z Henrym Scheffém wprowadził pojęcie zupełności statystyki (1950), napisał też podręczniki o estymacji punktowej i metodach rangowych (Rojo, 2011).
- Estymacja gęstości i nadefektywność. Hodges w raporcie technicznym z Evelyn Fix (1951, opublikowanym dopiero w 1989 r.) zapoczątkował nieparametryczną estymację gęstości – dziedzinę, do której należy m.in. estymator jądrowy gęstości. Odkrył też zjawisko nadefektywności, ważne dla teorii asymptotycznej estymatorów największej wiarygodności (Bickel i Lehmann, b.d.).
Ciekawostka
Lehmann wcale nie zamierzał zostać matematykiem. W autobiograficznych Reminiscences of a Statistician (2008) wspominał – jak przytacza Rojo (2011) – że jego pasją była literatura niemiecka, a marzeniem zostać pisarzem, kimś na miarę Thomasa Manna czy Gottfrieda Kellera. Rojo przypuszcza, że ta pasja pchnęła go do pisania książek.
Także do statystyki trafił okrężną drogą. Pierwsze zajęcia go rozczarowały: statystyce brakowało piękna teorii liczb, a metody wydawały mu się doraźne. Postanowił wrócić do matematyki i logik Alfred Tarski przyjął go już na swojego studenta. Wtedy Neyman zaproponował mu posadę wykładowcy – i Lehmann, który bardzo chciał należeć do jakiejś wspólnoty, został (Rojo, 2011). Hodges z kolei, według wspomnienia Bickela i Lehmanna, mierzył sześć stóp i cztery cale (ponad 190 cm), uwielbiał limeryki i ciekawe definicje ze słownika oksfordzkiego, a rozwlekłych mówców na zebraniach senatu uczelni ucinał wnioskiem o zamknięcie dyskusji.
Przykład na historycznych danych
Zbiór newcomb z pakietu MASS to – według pliku pomocy – trzecia seria 66 pomiarów czasu przejścia światła, które Simon Newcomb zapisał w 1882 r. (zob. hasło Benford i Newcomb); za prawdziwą przyjmuje się dziś wartość 33.02. Dwa pomiary wyraźnie odstają: −44 i −2.
Estymator Hodgesa–Lehmanna liczymy wprost z definicji: z 66 pomiarów powstaje 2211 średnich Walsha, a ich mediana to 27.50. Średnia arytmetyczna wynosi 26.21, 95% CI [23.57, 28.85], mediana 27.00, a przedział dla estymatora HL z wilcox.test(conf.int = TRUE) to [26.00, 28.50] – ponad dwa razy węższy niż przedział z testu t. Funkcja wilcox.test() szuka go numerycznie i zwraca 27.49996.
Bez dwóch obserwacji odstających średnia rośnie do 27.75, a HL zostaje równy 27.50. Gdy najniższy pomiar zastępować wartościami od −60 do 60, średnia zmienia się o 1.82, mediana o 0.50, a HL wcale. Wszystkie trzy leżą jednak 5.5–6.8 jednostki poniżej 33.02: odporność nie chroni przed błędem systematycznym.
Na rysunku
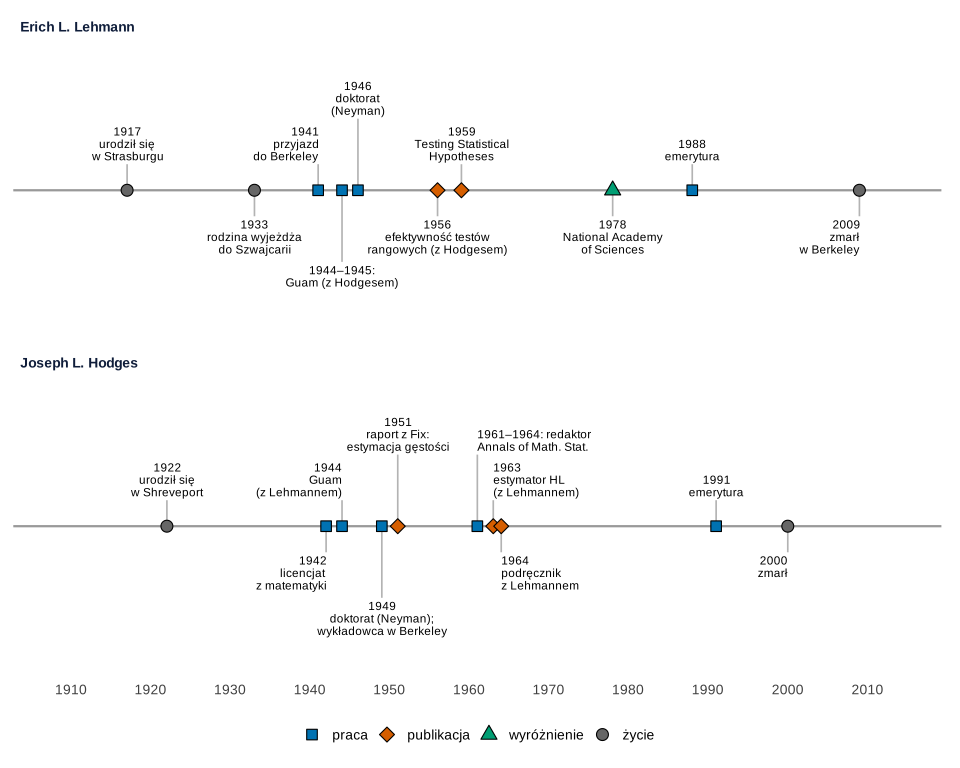
Co widać. Obaj przyszli do statystyki z matematyki w czasie wojny i obaj byli doktorantami Neymana.
Na co uważać. Oś pokazuje tylko wybrane zdarzenia.
Podpis do pracy:
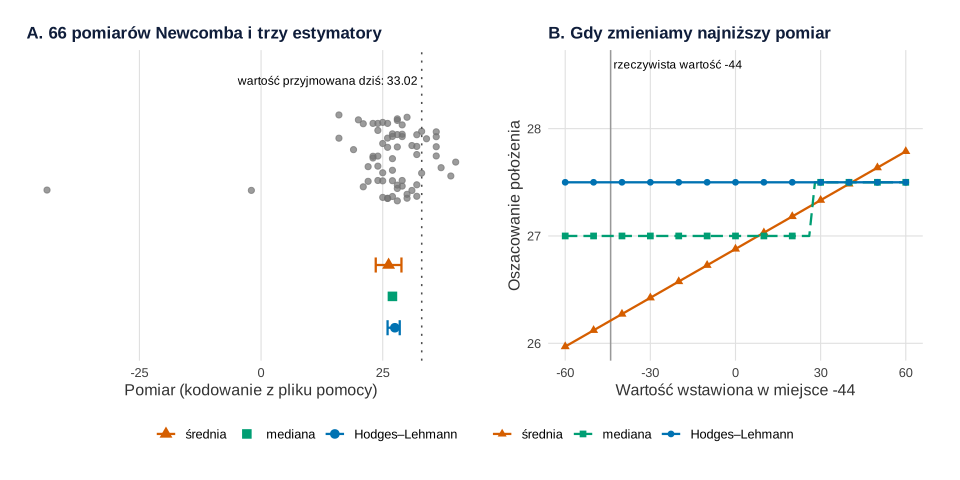
MASS::newcomb. Obliczenia i rysunek: R, pakiety ggplot2 i patchwork (losowanie – set.seed(913) – służy tylko rozrzuceniu punktów w pionie).Co widać. W panelu A dwa odstające pomiary ciągną średnią w lewo i poszerzają jej przedział. W panelu B przesuwanie jednego pomiaru o 120 jednostek przesuwa średnią, prawie nie rusza mediany i w ogóle nie zmienia HL.
Na co uważać. Płaska linia HL wynika częściowo z tego, że pomiary są liczbami całkowitymi i wiele średnich Walsha ma tę samą wartość – nie znaczy to, że estymator HL jest całkowicie niewrażliwy na dane.
Podpis do pracy:
Gdzie spotkasz Hodgesa i Lehmanna w swojej pracy
Zawsze, gdy używasz testów rangowych:
- obok p z testu Wilcoxona albo testu Manna–Whitneya podaj estymator HL z przedziałem ufności – to miara efektu w tych samych jednostkach co dane; więcej we wpisie Test Manna–Whitneya w obrazkach;
- HL to nie mediana ani różnica median, lecz mediana średnich Walsha lub różnic par;
- gdy wybierasz między testem t a testem rangowym, przypomnij sobie granicę 0.864: przy danych normalnych tracisz niewiele, przy grubych ogonach możesz dużo zyskać (zob. testy nieparametryczne);
- przy wartościach odstających porównaj HL ze średnią ucinaną, zamiast usuwać obserwacje.
Spory, mity i trudne strony
- „To śmieci”. Pierwsza praca Lehmanna, o klasach zupełnych testów (1947), nie zachwyciła Neymana – w opublikowanej w 1986 r. rozmowie z Morrisem DeGrootem Lehmann wspominał, że promotor uznał ją za bezwartościową i odradzał publikację. Praca ukazała się mimo to, a Abraham Wald uznał w niej źródło pojęcia klasy zupełnej (Rojo, 2011).
- Fisher czy Neyman? Lehmann wielokrotnie wracał do sporu Fishera z Neymanem i Pearsonem; uważał, że mimo różnic filozoficznych w praktyce oba podejścia do testowania się uzupełniają (Lehmann, 1993); szerzej w haśle o wartości p.
Estymator Hodgesa–Lehmanna w R
Kod wczytuje pomiary Newcomba, liczy średnie Walsha i estymator HL z definicji, porównuje go ze średnią i medianą (z przedziałami ufności), sprawdza wpływ dwóch odstających pomiarów, liczy krzywą wrażliwości i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Jedyne losowanie (set.seed(913)) rozrzuca punkty w pionie na rysunku i nie wpływa na wyniki.
1. Estymator HL na pomiarach Newcomba: rysunek 2
Kod R rysunku 2
# Hodges i Lehmann: estymator HL (mediana średnich Walsha) na pomiarach Newcomba (MASS::newcomb)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c("średnia" = "#D55E00", "mediana" = "#009E73", "Hodges–Lehmann" = "#0072B2")   # Okabe–Ito
ksz <- c("średnia" = 17, "mediana" = 15, "Hodges–Lehmann" = 16)
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(newcomb, package = "MASS")
# 66 pomiarów czasu przejścia światła z serii Newcomba z 1882 r.; wartość / 1000 + 24.8 = czas w milionowych częściach sekundy
x <- newcomb; n <- length(x)
prawda <- 33.02                                      # wartość uznawana dziś za prawdziwą (plik pomocy)
c(n = n, min = min(x), max = max(x), ponizej_15 = sum(x < 15))
sort(x)[1:4]

# 1. Średnie Walsha: (x_i + x_j) / 2 dla wszystkich par i <= j; estymator HL to ich mediana
walsh <- outer(x, x, "+") / 2
walsh <- walsh[upper.tri(walsh, diag = TRUE)]
HL <- median(walsh)
c(liczba_srednich_Walsha = length(walsh), n_razy_n_plus_1_przez_2 = n * (n + 1) / 2)

# 2. Trzy estymatory położenia i ich przedziały ufności
t_ci <- t.test(x)$conf.int
w <- wilcox.test(x, conf.int = TRUE, exact = FALSE)           # remisy – przybliżenie normalne
wyniki <- data.frame(
  estymator = c("średnia", "mediana", "Hodges–Lehmann"),
  wartosc = c(mean(x), median(x), HL),
  dolna = c(t_ci[1], NA, w$conf.int[1]), gorna = c(t_ci[2], NA, w$conf.int[2]))
wyniki$blad_wzgl_prawdy <- wyniki$wartosc - prawda
print(wyniki, digits = 4, row.names = FALSE)
c(HL_z_wilcox_test = unname(w$estimate))

# 3. Co się dzieje bez dwóch wartości odstających (-44 i -2)?
y <- x[x > 0]
round(c(n = length(y), srednia = mean(y), mediana = median(y),
        HL = median((outer(y, y, "+") / 2)[upper.tri(diag(length(y)), diag = TRUE)])), 3)

# 4. Krzywa wrażliwości: najbardziej odstający pomiar (-44) zastępujemy wartością v
hl <- function(z) { s <- outer(z, z, "+") / 2; median(s[upper.tri(s, diag = TRUE)]) }
i_min <- which.min(x)
wrazliwosc <- do.call(rbind, lapply(seq(-60, 60, by = 2), function(v) {
  z <- x; z[i_min] <- v
  data.frame(v = v, estymator = c("średnia", "mediana", "Hodges–Lehmann"),
             wartosc = c(mean(z), median(z), hl(z)))
}))
zakres <- aggregate(wartosc ~ estymator, wrazliwosc, function(e) diff(range(e)))
names(zakres)[2] <- "zmiana_przy_v_od_-60_do_60"; print(zakres, digits = 3, row.names = FALSE)

# Rysunek: A – pomiary i trzy estymatory z przedziałami; B – krzywa wrażliwości
wyniki$estymator <- factor(wyniki$estymator, levels = c("średnia", "mediana", "Hodges–Lehmann"))
wrazliwosc$estymator <- factor(wrazliwosc$estymator, levels = levels(wyniki$estymator))
set.seed(913)                                          # tylko rozrzut punktów w pionie (jitter)
punkty <- data.frame(x = x, y = runif(n, -0.35, 0.35))
pA <- ggplot() +
  geom_point(data = punkty, aes(x, y), colour = "grey45", alpha = 0.7, size = 1.8) +
  geom_vline(xintercept = prawda, colour = "grey30", linetype = "dotted") +
  annotate("text", x = prawda - 0.8, y = 0.62, hjust = 1, size = 3.2, label = "wartość przyjmowana dziś: 33.02") +
  geom_errorbar(data = wyniki[!is.na(wyniki$dolna), ], aes(xmin = dolna, xmax = gorna, y = -0.6 - 0.25 * as.numeric(estymator),
                 colour = estymator), width = 0.12, linewidth = 0.8, orientation = "y") +
  geom_point(data = wyniki, aes(wartosc, -0.6 - 0.25 * as.numeric(estymator), colour = estymator, shape = estymator), size = 3) +
  scale_colour_manual(values = kol, breaks = names(kol), name = NULL) +
  scale_shape_manual(values = ksz, breaks = names(ksz), name = NULL) +
  scale_y_continuous(breaks = NULL, limits = c(-1.5, 0.75)) +
  labs(title = "A. 66 pomiarów Newcomba i trzy estymatory", x = "Pomiar (kodowanie z pliku pomocy)", y = NULL) +
  motyw
pB <- ggplot(wrazliwosc, aes(v, wartosc, colour = estymator, linetype = estymator, shape = estymator)) +
  geom_vline(xintercept = -44, colour = "grey60") +
  geom_line(linewidth = 0.8) + geom_point(data = wrazliwosc[wrazliwosc$v %% 10 == 0, ], size = 2) +
  annotate("text", x = -43, y = 28.6, hjust = 0, size = 3.1, label = "rzeczywista wartość -44") +
  scale_colour_manual(values = kol, breaks = names(kol), name = NULL) +
  scale_linetype_manual(values = c("średnia" = "solid", "mediana" = "42", "Hodges–Lehmann" = "solid"), guide = "none") +
  scale_shape_manual(values = ksz, breaks = names(ksz), name = NULL) +
  labs(title = "B. Gdy zmieniamy najniższy pomiar", x = "Wartość wstawiona w miejsce -44", y = "Oszacowanie położenia") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.2, 1), guides = "collect") & theme(legend.position = "bottom")
p2
Wynik w R
         n        min        max ponizej_15
        66        -44         40          2
[1] -44  -2  16  16
 liczba_srednich_Walsha n_razy_n_plus_1_przez_2
                   2211                    2211
      estymator wartosc dolna gorna blad_wzgl_prawdy
        średnia   26.21 23.57 28.85           -6.808
        mediana   27.00    NA    NA           -6.020
 Hodges–Lehmann   27.50 26.00 28.50           -5.520
HL_z_wilcox_test
        27.49996
      n srednia mediana      HL
  64.00   27.75   27.50   27.50
      estymator zmiana_przy_v_od_-60_do_60
 Hodges–Lehmann                       0.00
        mediana                       0.50
        średnia                       1.82
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Erich L. Lehmann (1917–2009) i Joseph L. Hodges (1922–2000) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1917, 1933, 1941, 1944, 1946, 1956, 1959, 1978, 1988, 2009,
          1922, 1942, 1944, 1949, 1951, 1961, 1963, 1964, 1991, 2000),
  osoba = c(rep("Erich L. Lehmann", 10), rep("Joseph L. Hodges", 10)),
  opis = c("urodził się\nw Strasburgu", "rodzina wyjeżdża\ndo Szwajcarii", "przyjazd\ndo Berkeley",
           "1944–1945:\nGuam (z Hodgesem)", "doktorat\n(Neyman)", "efektywność testów\nrangowych (z Hodgesem)",
           "Testing Statistical\nHypotheses", "National Academy\nof Sciences", "emerytura", "zmarł\nw Berkeley",
           "urodził się\nw Shreveport", "licencjat\nz matematyki", "Guam\n(z Lehmannem)", "doktorat (Neyman);\nwykładowca w Berkeley",
           "raport z Fix:\nestymacja gęstości", "1961–1964: redaktor\nAnnals of Math. Stat.", "estymator HL\n(z Lehmannem)",
           "podręcznik\nz Lehmannem", "emerytura", "zmarł"),
  rodzaj = c("życie", "życie", "praca", "praca", "praca", "publikacja", "publikacja", "wyróżnienie", "praca", "życie",
             "życie", "praca", "praca", "praca", "publikacja", "praca", "publikacja", "publikacja", "praca", "życie"),
  poziom = c(0.4, -0.4, 0.4, -1.1, 1.1, -0.4, 0.4, -0.4, 0.4, -0.4,
             0.4, -0.4, 0.4, -1.1, 1.1, 1.1, 0.4, -0.4, 0.4, -0.4),      # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.5, 0.5, 1, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 1,
                 0.5, 1, 1, 0.5, 0.5, 0, 0, 0, 0.5, 1))                  # rozsunięcie bliskich etykiet
zdarzenia$etykieta <- ifelse(grepl("^\\d{4}–", zdarzenia$opis), zdarzenia$opis, paste0(zdarzenia$rok, "\n", zdarzenia$opis))
zdarzenia$osoba <- factor(zdarzenia$osoba, levels = c("Erich L. Lehmann", "Joseph L. Hodges"))
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  facet_wrap(~ osoba, ncol = 1) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1908, 2014), breaks = seq(1910, 2010, by = 10)) +
  scale_y_continuous(limits = c(-2.1, 2.1)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        strip.text = element_text(face = "bold", hjust = 0), legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (estymator HL i przedziały – funkcje outer(), median(), t.test() i wilcox.test() z pakietów base i stats; dane – pakiet MASS; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim byli Erich L. Lehmann i Joseph L. Hodges?
Statystykami z Uniwersytetu Kalifornijskiego w Berkeley i doktorantami Jerzego Neymana. Lehmann (1917–2009) urodził się w Strasburgu, studiował w Zurychu i Cambridge, a do Berkeley przyjechał w 1941 r. Hodges (1922–2000) pochodził z Luizjany i całe życie zawodowe spędził w Berkeley. W latach 1944–1945 obaj pracowali jako analitycy operacyjni lotnictwa USA na Guamie.
Jak policzyć estymator Hodgesa–Lehmanna dla jednej próby?
Policz średnie wszystkich par obserwacji, łącznie z każdą obserwacją wziętą z samą sobą (średnie Walsha), i weź ich medianę. Dla 66 pomiarów Newcomba to 2211 średnich, a ich mediana wynosi 27.50. W R tę samą wartość i przedział ufności zwraca wilcox.test(x, conf.int = TRUE).
Co oznacza liczba 0.864 w pracy Hodgesa i Lehmanna?
To dolna granica asymptotycznej efektywności Pitmana testu Wilcoxona względem testu t, wykazana przez Hodgesa i Lehmanna w 1956 r. Niezależnie od rozkładu test rangowy potrzebuje w dużych próbach najwyżej około 16% więcej obserwacji niż test t, by osiągnąć tę samą moc, a przy rozkładach o grubych ogonach często potrzebuje ich mniej.
Czy Erich Lehmann chciał zostać statystykiem?
Nie od początku. Jak wspominał w autobiografii z 2008 r., marzył o karierze pisarza, a jego pasją była literatura niemiecka. Studiował matematykę, do statystyki przeszedł w czasie wojny za radą przełożonego i rozważał nawet powrót do matematyki, zanim Neyman zaproponował mu posadę wykładowcy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Test Manna–Whitneya w obrazkach
Rangi, wszystkie pary i P(X > Y), równe mediany a istotny wynik, mała próba i estymator Hodgesa–Lehmanna – pięć symulacji z kodem R.
Czytaj →PoradnikTesty nieparametryczne krok po kroku
Kiedy test rangowy ma sens, Mann–Whitney, Wilcoxon, Kruskal–Wallis z testem Dunna i Friedman na jednym badaniu – z wielkością efektu i opisem APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bickel, P., & Lehmann, E. (b.d.). In memory of Joe Hodges. Department of Statistics, University of California, Berkeley. Pobrano 20 listopada 2026 z https://statistics.berkeley.edu/about/memoriam/memory-joe-hodges ● Otwarty dostęp
- Hodges, J. L., & Lehmann, E. L. (1956). The efficiency of some nonparametric competitors of the t-test. The Annals of Mathematical Statistics, 27(2), 324–335. https://doi.org/10.1214/aoms/1177728261 ● Otwarty dostęp
- Hodges, J. L., & Lehmann, E. L. (1963). Estimates of location based on rank tests. The Annals of Mathematical Statistics, 34(2), 598–611. https://doi.org/10.1214/aoms/1177704172 ● Otwarty dostęp
- Lehmann, E. L. (1993). The Fisher, Neyman-Pearson theories of testing hypotheses: One theory or two? Journal of the American Statistical Association, 88(424), 1242–1249. https://doi.org/10.1080/01621459.1993.10476404
- Rojo, J. (2011). Erich Leo Lehmann—A glimpse into his life and work. The Annals of Statistics, 39(5), 2244–2265. https://doi.org/10.1214/11-aos927 ● Otwarty dostęp
Cytowania BibTeX
@misc{bickelhodgesmemory, author={Bickel, Peter and Lehmann, Erich}, title={{In memory of Joe Hodges}}, howpublished={Department of Statistics, University of California, Berkeley}, publisher={University of California, Berkeley, Department of Statistics}, url={https://statistics.berkeley.edu/about/memoriam/memory-joe-hodges}}@article{hodges1956efficiency, author={Hodges, J. L. and Lehmann, E. L.}, title={{The efficiency of some nonparametric competitors of the t-test}}, journal={The Annals of Mathematical Statistics}, year={1956}, volume={27}, number={2}, pages={324--335}, doi={10.1214/aoms/1177728261}}@article{hodges1963estimates, author={Hodges, J. L. and Lehmann, E. L.}, title={{Estimates of location based on rank tests}}, journal={The Annals of Mathematical Statistics}, year={1963}, volume={34}, number={2}, pages={598--611}, doi={10.1214/aoms/1177704172}}@article{lehmann1993fisher, author={Lehmann, E. L.}, title={{The Fisher, Neyman-Pearson theories of testing hypotheses: One theory or two?}}, journal={Journal of the American Statistical Association}, year={1993}, volume={88}, number={424}, pages={1242--1249}, doi={10.1080/01621459.1993.10476404}}@article{rojo2011erich, author={Rojo, Javier}, title={{Erich Leo Lehmann—A glimpse into his life and work}}, journal={The Annals of Statistics}, year={2011}, volume={39}, number={5}, pages={2244--2265}, doi={10.1214/11-aos927}}