Kim byli Simon Newcomb i Frank Benford?
Prawo pierwszej cyfry ma dwóch odkrywców. Pierwszy opisał je Simon Newcomb (1835–1909), astronom i matematyk, w dwustronicowej notatce z 1881 r. Drugi, Frank Benford, fizyk z laboratorium badawczego General Electric, doszedł do tego samego wzoru 57 lat później – najwyraźniej nie znając pracy Newcomba (Hill, 1998).
Newcomb urodził się 12 marca 1835 r. w Wallace w Nowej Szkocji. W styczniu 1857 r. zaczął pracę jako rachmistrz w biurze rocznika astronomicznego Nautical Almanac w Cambridge (Massachusetts), a równolegle studiował na Harvardzie. W 1861 r. został profesorem matematyki w marynarce wojennej USA i pracował w Naval Observatory w Waszyngtonie. Od 1877 r. kierował biurem Nautical Almanac, od 1884 r. był też profesorem matematyki i astronomii na Uniwersytecie Johnsa Hopkinsa. W 1897 r. przeszedł w stan spoczynku, a zmarł 11 lipca 1909 r. w Waszyngtonie (Campbell, 1924).
O Benfordzie cytowane źródła mówią niewiele: był fizykiem w General Electric i w 1938 r. opublikował w Proceedings of the American Philosophical Society artykuł „The law of anomalous numbers” (Benford, 1938; Hill, 1998). Dlatego nie podajemy tu jego dat życia.
Najważniejsze pomysły
- Newcomb (1881): mantysy są równomierne. Newcomb traktował liczby spotykane w przyrodzie jak ilorazy wielkości i doszedł do wniosku, że wszystkie mantysy ich logarytmów są jednakowo prawdopodobne. Z tego wynika prawdopodobieństwo pierwszej cyfry d równe log10(1 + 1/d) – dla jedynki 0.3010, dla dziewiątki 0.0458. Podał też tablicę dla drugiej cyfry i zauważył, że od trzeciej cyfry różnice są już niewielkie (Newcomb, 1881).
- Benford (1938): sprawdzenie na danych. Według Hilla (1998) przez kilka lat zbierał liczby z jak najróżniejszych dziedzin i opublikował tabelę 20 229 obserwacji z bardzo różnych zbiorów: od powierzchni dorzeczy, przez statystyki baseballowe, po masy atomowe pierwiastków. Uznał, że prawo liczb anomalnych to ogólne prawo probabilistyczne o szerokim zastosowaniu (Benford, 1938).
- Newcomb poza prawem cyfr. Przez całe życie interesował się rachunkiem prawdopodobieństwa i metodą najmniejszych kwadratów, rozwiniętą wcześniej przez Gaussa. W 1886 r. opublikował w American Journal of Mathematics ogólną teorię łączenia obserwacji w najlepszy wynik (Campbell, 1924).
Ciekawostka
Obaj odkrywcy zaczęli od tej samej obserwacji: zniszczonych tablic logarytmów. Newcomb otworzył swoją notatkę uwagą, że każdy, kto często korzysta z takich tablic, widzi, o ile szybciej zużywają się pierwsze strony niż ostatnie. Skoro najczęściej wyszukuje się liczby zaczynające się od 1, to takie liczby muszą być w praktyce najczęstsze (Newcomb, 1881). Newcomb znał tablice od podszewki – karierę zaczynał jako rachmistrz rocznika astronomicznego (Campbell, 1924).
Benford w 1938 r. wyszedł od tego samego spostrzeżenia (Benford, 1938), ale to jego nazwisko przylgnęło do prawa. Hill (1998) tłumaczy to tym, że notatka Newcomba przeszła bez echa, a artykuł Benforda zwrócił uwagę – po części szczęśliwym trafem, bo wydrukowano go obok pracy z fizyki, która wkrótce stała się słynna. Oddając sprawiedliwość obu autorom, w tym haśle mówimy o prawie Newcomba–Benforda.
Przykład na prawdziwych danych
Najpierw sprawdziliśmy samego Newcomba. Jego tablicę z 1881 r. – prawdopodobieństwa pierwszej i drugiej cyfry z dokładnością do czterech miejsc – wpisaliśmy ręcznie do kodu i porównaliśmy z wartościami ze wzoru. Wszystkie 19 liczb zgadza się co do czwartego miejsca po przecinku; np. druga cyfra 0 ma prawdopodobieństwo 0.1197, a druga cyfra 9 – 0.0850.
Potem wzięliśmy dane w duchu Benforda: masę ciała (w kg) i masę mózgu (w g) 62 gatunków ssaków lądowych ze zbioru mammals pakietu MASS, razem 124 liczby. Rozciągają się od 0.005 do 6654, czyli na 6.1 rzędu wielkości – tak jak dane, w których prawo zwykle działa. Jedynka zaczyna 43 liczby (34.7%; według prawa oczekiwano 37.3 liczby, czyli 30.1%), a cyfry 7, 8 i 9 – po 3 liczby. Test chi-kwadrat zgodności nie wykazał odstępstwa od rozkładu Benforda, χ²(8) = 10.59, p = .226. Mantysy logarytmów, które według Newcomba powinny być rozłożone równomiernie, mają średnią 0.456, a 50.8% z nich jest mniejszych niż 0.5.
Na rysunku
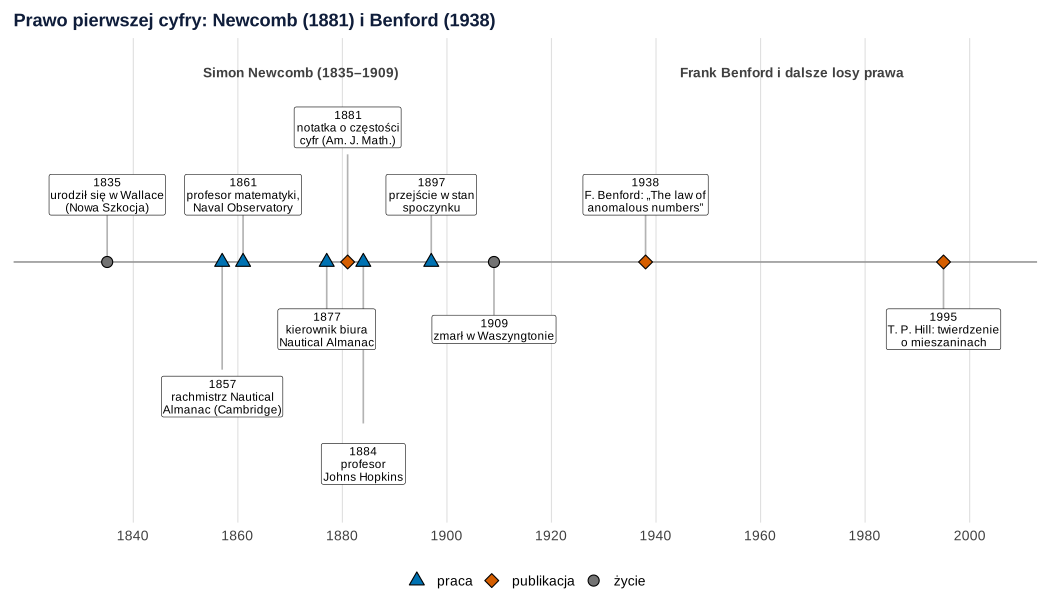
Co widać. Notatka o cyfrach to drobny epizod w długiej karierze astronoma. Między nią a artykułem Benforda mija 57 lat, a matematyczne wyjaśnienie, dlaczego prawo pasuje do tak różnych danych, przychodzi dopiero w 1995 r.
Na co uważać. Pas Benforda ma tylko jedno zdarzenie z jego życia, bo cytowane źródła nie podają dat jego urodzin, śmierci ani zatrudnienia.
Podpis do pracy:
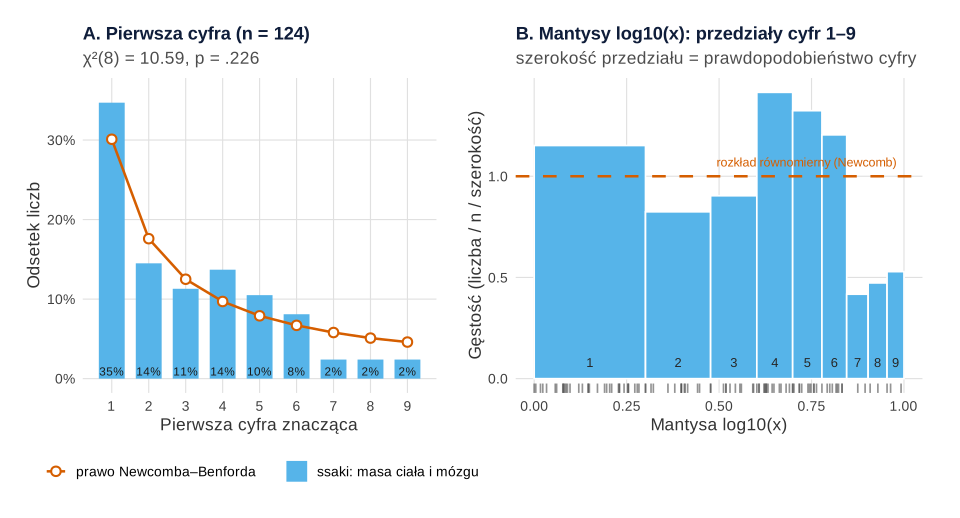
mammals z pakietu MASS; obliczenia i rysunek: R, pakiety ggplot2 i patchwork.Co widać. W panelu A słupki maleją od jedynki do dziewiątki podobnie jak linia prawa, choć z wyraźnymi wahaniami (np. czwórek jest więcej niż trójek). Panel B pokazuje pomysł Newcomba: oś mantys dzielimy na przedziały od log10 d do log10(d + 1). Przedział jedynki zajmuje 30% osi, dziewiątki – niecałe 5%. Przy równomiernych mantysach każdy słupek sięga poziomu 1.
Na co uważać. Przy 124 liczbach przypadkowe wahania są duże: po 3 liczby na cyfry 7–9 to za mało, by coś o nich orzekać. Wynik nieistotny nie dowodzi zgodności z prawem – mówi tylko, że test przy tej liczebności nie wykrył odstępstwa. Masy ciała i mózgu są ze sobą powiązane, więc 124 liczby nie są w pełni niezależne.
Podpis do pracy:
Gdzie spotkasz Newcomba i Benforda w swojej pracy
- Gdy sprawdzasz, czy kwoty lub liczebności wyglądają naturalnie – definicję, warunki stosowania i przykład z kilkoma zbiorami danych podaje hasło prawo Benforda, a zastosowanie w kontroli faktur wpis Prawo Benforda w audycie.
- Gdy porównujesz liczebności obserwowane z oczekiwanymi – to zwykły test chi-kwadrat z rozkładem odniesienia innym niż równomierny; statystyka ma rozkład chi-kwadrat z 8 stopniami swobody.
- Gdy dane obejmują kilka rzędów wielkości i analizujesz je po transformacji logarytmicznej: mantysa logarytmu to dokładnie to, na co patrzył Newcomb. Zmienne o szerokim rozkładzie lognormalnym zwykle dobrze spełniają prawo, a liczby z wąskiego zakresu, np. z rozkładu jednostajnego od 1000 do 9999 – nie.
Spory, mity i trudne strony
- Czyje to prawo? Newcomb był pierwszy o 57 lat, ale jego notatka została zapomniana (Hill, 1998). Nazwa „prawo Benforda” utrwaliła się jednak w literaturze.
- Dlaczego to w ogóle działa? Rozumowanie Newcomba było heurystyczne, a Benford pokazał zgodność empirycznie. Hill (1995) udowodnił twierdzenie graniczne: jeśli dane są próbami z wielu losowo wybranych rozkładów, cyfry połączonej próby zbiegają do rozkładu logarytmicznego. To tłumaczy, czemu dobrze pasują zbiory mieszane, jak tabela Benforda (Hill, 1998).
- Nie każde dane. Wiele zbiorów prawa nie spełnia, np. numery telefonów z jednego regionu czy liczby z wąskiego zakresu (Hill, 1998). Odstępstwo nie jest więc dowodem fałszerstwa, a jedynie sygnałem do sprawdzenia.
Prawo Newcomba–Benforda w R
Kod rysuje oś czasu (rysunek 1), odtwarza tablicę Newcomba z 1881 r. ze wzoru i porównuje ją z wartościami wpisanymi z artykułu, a potem liczy pierwsze cyfry mas ciała i mózgu ssaków ze zbioru mammals (pakiet MASS), wykonuje test chi-kwadrat zgodności z rozkładem Benforda i rysuje rozkład cyfr oraz mantys logarytmów (rysunek 2). Rysunki na stronie powstały z tych samych obiektów p_os i p_metoda, którym podmieniono tylko krój i tło na motyw serwisu; dane, geometrie i skale są identyczne.
Oś czasu, tablica Newcomba i pierwsze cyfry: rysunki 1 i 2
Kod R rysunków 1 i 2
# Simon Newcomb i Frank Benford: oś czasu, tablica Newcomba z 1881 r. i pierwsze cyfry w danych o ssakach
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c(niebieski = "#0072B2", cynober = "#D55E00", pomaranczowy = "#E69F00", zielony = "#009E73", szary = "grey45",
        blekit = "#56B4E9")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

# 1. Oś czasu (lata według: Campbell 1924, Newcomb 1881, Benford 1938, Hill 1995 i 1998)
zdarzenia <- data.frame(
  rok = c(1835, 1857, 1861, 1877, 1881, 1884, 1897, 1909, 1938, 1995),
  opis = c("urodził się w Wallace\n(Nowa Szkocja)", "rachmistrz Nautical\nAlmanac (Cambridge)", "profesor matematyki,\nNaval Observatory",
           "kierownik biura\nNautical Almanac", "notatka o częstości\ncyfr (Am. J. Math.)", "profesor\nJohns Hopkins",
           "przejście w stan\nspoczynku", "zmarł w Waszyngtonie", "F. Benford: „The law of\nanomalous numbers”",
           "T. P. Hill: twierdzenie\no mieszaninach"),
  osoba = c(rep("Simon Newcomb", 8), "Frank Benford", "później"),
  rodzaj = c("życie", "praca", "praca", "praca", "publikacja", "praca", "praca", "życie", "publikacja", "publikacja"))
zdarzenia$y <- c(1.1, -2.2, 1.1, -1.1, 2.2, -3.3, 1.1, -1.1, 1.1, -1.1)   # wysokość etykiet, żeby się nie nakładały
p_os <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_segment(aes(xend = rok, yend = y * 0.8), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.5) +
  geom_label(aes(y = y, label = paste0(rok, "\n", opis)), size = 3.1, lineheight = 0.9, linewidth = 0.2) +
  annotate("text", x = c(1872, 1966), y = 3.1, label = c("Simon Newcomb (1835–1909)", "Frank Benford i dalsze losy prawa"),
           fontface = "bold", size = 3.6, colour = "grey25") +
  scale_shape_manual(values = c("życie" = 21, "praca" = 24, "publikacja" = 23), name = NULL) +
  scale_fill_manual(values = c("życie" = oi[["szary"]], "praca" = oi[["niebieski"]], "publikacja" = oi[["cynober"]]), name = NULL) +
  scale_x_continuous(breaks = seq(1840, 2000, 20), limits = c(1826, 2004)) + scale_y_continuous(limits = c(-3.9, 3.3)) +
  labs(title = "Prawo pierwszej cyfry: Newcomb (1881) i Benford (1938)", x = NULL, y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())

# 2. Tablica Newcomba (1881, s. 40): prawdopodobieństwa pierwszej i drugiej cyfry, wpisane ręcznie z artykułu
newcomb_1 <- c(0.3010, 0.1761, 0.1249, 0.0969, 0.0792, 0.0669, 0.0580, 0.0512, 0.0458)           # cyfry 1–9
newcomb_2 <- c(0.1197, 0.1139, 0.1088, 0.1043, 0.1003, 0.0967, 0.0934, 0.0904, 0.0876, 0.0850)   # cyfry 0–9
# Te same wartości ze wzoru: mantysy logarytmów są rozłożone równomiernie
p1 <- log10(1 + 1 / (1:9))
p2 <- sapply(0:9, function(k) sum(log10(1 + 1 / (10 * (1:9) + k))))
tablica <- data.frame(cyfra = 0:9, pierwsza_wzor = c(NA, round(p1, 4)), pierwsza_Newcomb = c(NA, newcomb_1),
                      druga_wzor = round(p2, 4), druga_Newcomb = newcomb_2)
print(tablica, row.names = FALSE)
c(zgodne_pierwsza = all(round(p1, 4) == newcomb_1), zgodne_druga = all(round(p2, 4) == newcomb_2))

# 3. Pierwsze cyfry w prawdziwych danych: masa ciała (kg) i masa mózgu (g) 62 gatunków ssaków lądowych
data(mammals, package = "MASS")
x <- c(mammals$body, mammals$brain)
pierwsza <- function(v) floor(v / 10^floor(log10(v)))   # pierwsza cyfra znacząca (v > 0)
d <- factor(pierwsza(x), levels = 1:9)
c(n = length(x), min = min(x), max = max(x), rzedy_wielkosci = round(log10(max(x) / min(x)), 1))
obs <- as.vector(table(d))
cyfry <- data.frame(cyfra = 1:9, liczba = obs, odsetek = round(obs / length(x), 3), Benford = round(p1, 3),
                    oczekiwana = round(length(x) * p1, 1))
print(cyfry, row.names = FALSE)
test <- chisq.test(obs, p = p1)
c(chi2 = round(unname(test$statistic), 2), df = unname(test$parameter), p = round(test$p.value, 3))
# Pogląd Newcomba: mantysa log10(x) (część ułamkowa) powinna być rozłożona równomiernie na [0, 1)
mantysa <- log10(x) %% 1
c(mantysa_srednia = round(mean(mantysa), 3), mantysa_ponizej_0.5 = round(mean(mantysa < 0.5), 3))

# Rysunek 2A: odsetek pierwszych cyfr vs prawo Benforda
cyfry$etykieta <- paste0(round(100 * cyfry$odsetek), "%")
pA <- ggplot(cyfry, aes(cyfra)) +
  geom_col(aes(y = odsetek, fill = "ssaki: masa ciała i mózgu"), width = 0.7) +
  geom_line(aes(y = Benford, colour = "prawo Newcomba–Benforda"), linewidth = 0.9) +
  geom_point(aes(y = Benford, colour = "prawo Newcomba–Benforda"), shape = 21, fill = "white", size = 2.6, stroke = 1.1) +
  geom_text(aes(y = 0.004, label = etykieta), vjust = 0, size = 3.1, colour = "grey10") +
  scale_fill_manual(values = oi[["blekit"]], name = NULL) + scale_colour_manual(values = oi[["cynober"]], name = NULL) +
  scale_x_continuous(breaks = 1:9) +
  scale_y_continuous(labels = function(v) paste0(100 * v, "%"), limits = c(0, 0.36)) +
  labs(title = sprintf("A. Pierwsza cyfra (n = %d)", length(x)),
       subtitle = sprintf("χ²(%d) = %.2f, p = %s", unname(test$parameter), unname(test$statistic),
                          sub("^0", "", sprintf("%.3f", test$p.value))),
       x = "Pierwsza cyfra znacząca", y = "Odsetek liczb") +
  motyw + theme(legend.position = "bottom", legend.box = "vertical")
# Rysunek 2B: mantysy log10(x) – przedziały odpowiadające cyfrom 1–9; gęstość 1 = prawo Benforda
granice <- log10(1:10)
hist_m <- data.frame(cyfra = 1:9, od = head(granice, -1), do = tail(granice, -1), liczba = obs)
hist_m$gestosc <- hist_m$liczba / (length(x) * (hist_m$do - hist_m$od))
pB <- ggplot(hist_m) +
  geom_rect(aes(xmin = od, xmax = do, ymin = 0, ymax = gestosc), fill = oi[["blekit"]], colour = "white") +
  geom_hline(yintercept = 1, colour = oi[["cynober"]], linewidth = 0.9, linetype = "dashed") +
  geom_rug(data = data.frame(m = mantysa), aes(x = m), colour = "grey30", alpha = 0.6, length = unit(0.03, "npc")) +
  geom_text(aes(x = (od + do) / 2, y = 0.08, label = cyfra), size = 3.4, colour = "grey15") +
  annotate("text", x = 0.98, y = 1.07, hjust = 1, size = 3.3, colour = oi[["cynober"]], label = "rozkład równomierny (Newcomb)") +
  scale_x_continuous(breaks = seq(0, 1, 0.25)) +
  labs(title = "B. Mantysy log10(x): przedziały cyfr 1–9",
       subtitle = "szerokość przedziału = prawdopodobieństwo cyfry",
       x = "Mantysa log10(x)", y = "Gęstość (liczba / n / szerokość)") +
  motyw
p_metoda <- pA + pB + plot_layout(widths = c(1, 1.15))
p_os
p_metoda
Wynik w R
 cyfra pierwsza_wzor pierwsza_Newcomb druga_wzor druga_Newcomb
     0            NA               NA     0.1197        0.1197
     1        0.3010           0.3010     0.1139        0.1139
     2        0.1761           0.1761     0.1088        0.1088
     3        0.1249           0.1249     0.1043        0.1043
     4        0.0969           0.0969     0.1003        0.1003
     5        0.0792           0.0792     0.0967        0.0967
     6        0.0669           0.0669     0.0934        0.0934
     7        0.0580           0.0580     0.0904        0.0904
     8        0.0512           0.0512     0.0876        0.0876
     9        0.0458           0.0458     0.0850        0.0850
zgodne_pierwsza    zgodne_druga
           TRUE            TRUE
              n             min             max rzedy_wielkosci
        124.000           0.005        6654.000           6.100
 cyfra liczba odsetek Benford oczekiwana
     1     43   0.347   0.301       37.3
     2     18   0.145   0.176       21.8
     3     14   0.113   0.125       15.5
     4     17   0.137   0.097       12.0
     5     13   0.105   0.079        9.8
     6     10   0.081   0.067        8.3
     7      3   0.024   0.058        7.2
     8      3   0.024   0.051        6.3
     9      3   0.024   0.046        5.7
  chi2     df      p
10.590  8.000  0.226
    mantysa_srednia mantysa_ponizej_0.5
              0.456               0.508
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (test – funkcja chisq.test() z pakietu stats; dane – pakiet MASS; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kto pierwszy odkrył prawo Benforda?
Simon Newcomb, astronom i matematyk, w dwustronicowej notatce w American Journal of Mathematics z 1881 r. Frank Benford doszedł do tego samego prawa 57 lat później, najwyraźniej nie znając pracy Newcomba, ale sprawdził je na ponad 20 tysiącach liczb i to jego nazwisko przylgnęło do prawa.
Kim był Frank Benford?
Fizykiem z laboratorium badawczego General Electric, autorem artykułu „The law of anomalous numbers” w Proceedings of the American Philosophical Society (1938). Zebrał w nim 20 229 obserwacji z bardzo różnych dziedzin i pokazał, że ich pierwsze cyfry układają się według rozkładu logarytmicznego.
Kim był Simon Newcomb?
Amerykańskim astronomem i matematykiem (1835–1909) urodzonym w Nowej Szkocji. Zaczynał jako rachmistrz rocznika astronomicznego Nautical Almanac, potem był profesorem matematyki w Naval Observatory, kierownikiem biura Nautical Almanac i profesorem Uniwersytetu Johnsa Hopkinsa.
Co mają tablice logarytmów do prawa Benforda?
Zarówno Newcomb, jak i Benford wyszli od spostrzeżenia, że pierwsze strony tablic logarytmów zużywają się szybciej niż ostatnie. Skoro najczęściej sprawdza się liczby zaczynające się od małych cyfr, takie liczby muszą być w praktyce najczęstsze.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Prawo Benforda w audycie
Pierwsza i dwie pierwsze cyfry faktur, χ² i MAD, wpływ liczebności, kwoty z limitów i sito audytora – sześć rysunków z kodem R.
Czytaj →PoradnikTest chi-kwadrat krok po kroku
Test zgodności i niezależności na jednym badaniu: odsetki, liczebności oczekiwane, reszty, V Craméra, test Fishera i gotowy opis APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Benford, F. (1938). The law of anomalous numbers. Proceedings of the American Philosophical Society, 78(4), 551–572. https://www.jstor.org/stable/984802
- Campbell, W. W. (1924). Biographical memoir of Simon Newcomb, 1835–1909. Memoirs of the National Academy of Sciences, 17, 1–18. https://www.nasonline.org/wp-content/uploads/2024/06/newcomb-simon.pdf
- Hill, T. P. (1995). A statistical derivation of the significant-digit law. Statistical Science, 10(4), 354–363. https://doi.org/10.1214/ss/1177009869 ● Otwarty dostęp
- Hill, T. P. (1998). The first digit phenomenon. American Scientist, 86(4), 358–363. https://doi.org/10.1511/1998.31.358
- Newcomb, S. (1881). Note on the frequency of use of the different digits in natural numbers. American Journal of Mathematics, 4(1), 39–40. https://doi.org/10.2307/2369148
Cytowania BibTeX
@article{benford1938law, author={Benford, Frank}, title={{The law of anomalous numbers}}, journal={Proceedings of the American Philosophical Society}, year={1938}, volume={78}, number={4}, pages={551--572}, url={https://www.jstor.org/stable/984802}}@article{campbell1924newcomb, author={Campbell, William Wallace}, title={{Biographical memoir of Simon Newcomb, 1835–1909}}, journal={Memoirs of the National Academy of Sciences}, year={1924}, volume={17}, pages={1--18}, url={https://www.nasonline.org/wp-content/uploads/2024/06/newcomb-simon.pdf}}@article{hill1995statistical, author={Hill, Theodore P.}, title={{A statistical derivation of the significant-digit law}}, journal={Statistical Science}, year={1995}, volume={10}, number={4}, pages={354--363}, doi={10.1214/ss/1177009869}}@article{hill1998first, author={Hill, Theodore P.}, title={{The first digit phenomenon}}, journal={American Scientist}, year={1998}, volume={86}, number={4}, pages={358--363}, doi={10.1511/1998.31.358}}@article{newcomb1881note, author={Newcomb, Simon}, title={{Note on the frequency of use of the different digits in natural numbers}}, journal={American Journal of Mathematics}, year={1881}, volume={4}, number={1}, pages={39--40}, doi={10.2307/2369148}}