Kim byli Henry B. Mann i D. Ransom Whitney?
Henry Berthold Mann (1905–2000) urodził się 27 października 1905 r. w Wiedniu. Doktorat z algebraicznej teorii liczb obronił w 1935 r. na Uniwersytecie Wiedeńskim (promotor: Philipp Furtwängler), a w 1938 r. wyemigrował do Stanów Zjednoczonych. W 1942 r. dostał stypendium Carnegie na naukę statystyki na Columbii i pracował tam z Abrahamem Waldem. Od połowy lat 40. pracował w Ohio State University, potem w Wisconsin i Arizonie. Zmarł 1 lutego 2000 r. w Tucson (Ohio State University Department of Mathematics, b.d.).
Donald Ransom Whitney ukończył Oberlin College (1936) i magisterium z matematyki w Princeton, a w latach 1942–1946 służył w marynarce wojennej USA (Whitney i in., 1999; Willke, 2008). W 1946 r. przyszedł na studia doktoranckie do Ohio State; jego promotorem został Mann. Od 1948 r. uczył matematyki w Ohio State i prowadził uczelniane Laboratorium Statystyczne, a w latach 1974–1979 był pierwszym kierownikiem Wydziału Statystyki. Na emeryturę przeszedł w 1982 r., zmarł 16 sierpnia 2007 r. w wieku 92 lat (Willke, 2008).
Najważniejsze pomysły
- Statystyka U (1947). W „The Annals of Mathematical Statistics” Mann i Whitney (1947) zaproponowali statystykę U opartą na względnych rangach dwóch prób do testowania hipotezy, że obie zmienne mają ten sam rozkład – dziś test Manna–Whitneya. Rozkład U przy hipotezie zerowej wyznaczyli z zależności rekurencyjnej, podali tablice prawdopodobieństw dla prób do 8 obserwacji w każdej grupie i zauważyli, że przy tej liczebności rozkład jest już prawie normalny.
- Test na trend (1945). Wcześniej Mann (1945) zaproponował nieparametryczne testy hipotezy o braku trendu w ciągu obserwacji – to źródło nazwy testu Manna–Kendalla.
- Teoria liczb. Mann był przede wszystkim matematykiem czystym. W 1941 r. udowodnił hipotezę Schnirelmanna–Landaua o gęstości sumy zbiorów liczb naturalnych (twierdzenie „α + β”), za co w 1946 r. otrzymał Nagrodę Cole’a z teorii liczb (Ohio State University Department of Mathematics, b.d.).
- Planowanie eksperymentów. Z Waldem pisał m.in. o teście chi-kwadrat, a zainteresowanie analizą wariancji doprowadziło go do książki Analysis and Design of Experiments (1949).
Whitney napisał rozprawę o mocy testów nieparametrycznych – sam przyznał po latach, że nie podbiła świata (Whitney i in., 1999). Trwalszym dziełem okazało się doradztwo: według Willkego (2008) pomógł setkom badaczy i wypromował ponad stu magistrów.
Ciekawostka
Whitney trafił do statystyki przez przypadek. Jak opisał w historii statystyki w Ohio State (Whitney i in., 1999), przyjechał tam w 1946 r. z nadzieją, że będzie się kształcił u matematyka stosowanego J. L. Synge’a. Synge jednak w ciągu roku odszedł z uczelni i Whitney został bez opiekuna. Statystyka go pociągała, a Mann – jak pisze – chętnie prowadził każdego, kto interesował się jego pracą.
Whitney wspomina też Manna jako spokojnego, życzliwego człowieka, którego pasjami były znaczki i pływanie. Najbardziej cenił znaczki rosyjskie sprzed I wojny światowej – piękną kolekcję kolonii brytyjskich sprzedał, żeby kupić jeden rosyjski znaczek. Latem samotnie przepływał jezioro Mendota w Wisconsin; gdy ze względów bezpieczeństwa miała mu towarzyszyć łódź, rozwiązał to po swojemu – holował przez jezioro żonę siedzącą w małej łódce.
Przykład na danych z pakietu R
Zbiór PlantGrowth z pakietu datasets to – według pliku pomocy – wyniki eksperymentu porównującego plony (sucha masa roślin) w grupie kontrolnej i w dwóch warunkach eksperymentalnych, po 10 roślin; źródłem jest podręcznik Dobson (1983). Porównujemy dwa warunki: trt1 (Me = 4.55) i trt2 (Me = 5.44). Remisów nie ma.
Z 10 × 10 = 100 par „roślina z trt1, roślina z trt2” tylko w 16 cięższa jest roślina z trt1, więc U = 16 (prawdopodobieństwo przewagi 16/100 = .16). To samo wychodzi z sumy rang. Rozkład U przy hipotezie zerowej dostajemy bez tablic: wypisujemy wszystkie 184 756 podziałów 20 rang na dwie grupy po 10 i dla każdego liczymy U. Średnia (50) i wariancja (175) zgadzają się ze wzorami. Wynik równie skrajny jak w danych daje 1650 podziałów, czyli dokładne p = .0089 – to samo, co zwraca wilcox.test().
Przybliżenie rozkładem normalnym daje z = −2.57 i p = .0102, a z poprawką na ciągłość p = .0113. W dalekim ogonie różnice rosną: prawdopodobieństwo U ≤ 5 przybliżenie zawyża 3.7 razy, a U = 0 – prawie 17 razy.
Na rysunku
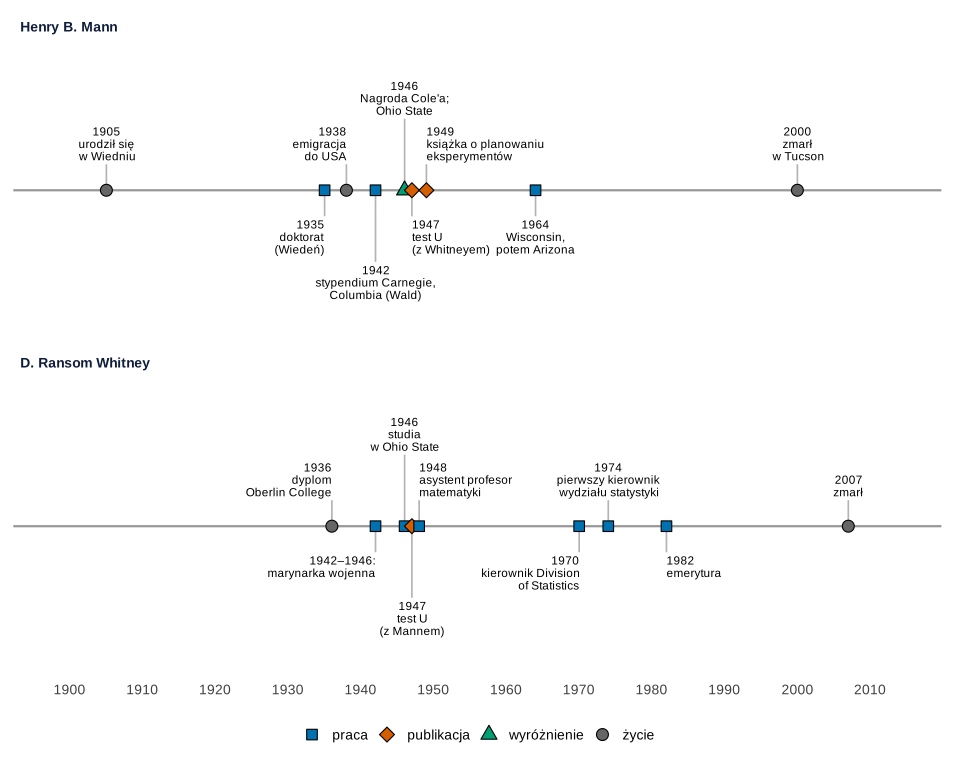
Co widać. Drogi obu autorów przecinają się w Ohio State tuż po wojnie; test U powstaje, gdy Whitney jest jeszcze doktorantem.
Na co uważać. Źródła różnią się w szczegółach: Whitney i in. (1999) podają dla Manna lata 1945 i 1962/63, a strona wydziału matematyki – 1946 i 1964; na osi są te drugie. Daty urodzenia Whitneya źródła nie podają.
Podpis do pracy:
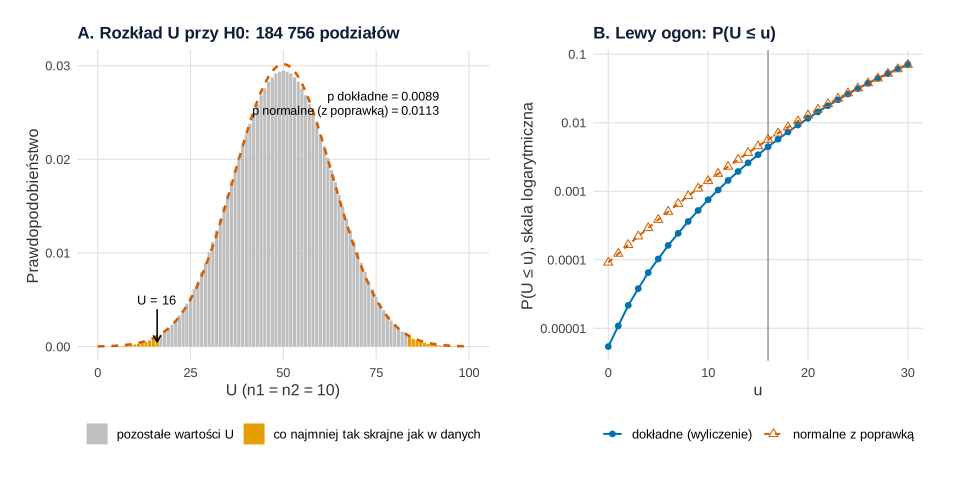
datasets::PlantGrowth, warunki trt1 i trt2. Obliczenia i rysunek: R, pakiety ggplot2 i patchwork (pełne wyliczenie, bez losowania).Co widać. W panelu A krzywa normalna prawie idealnie obrysowuje słupki – to ta „prawie normalność”, o której Mann i Whitney (1947) pisali już przy 8 obserwacjach w grupie. Pomarańczowe słupki po obu stronach to wyniki co najmniej tak skrajne jak U = 16; ich łączne prawdopodobieństwo to dokładne p. Panel B w skali logarytmicznej pokazuje, że daleko w ogonie przybliżenie odkleja się od wartości dokładnych.
Na co uważać. Rozkład dokładny jest „schodkowy”, a przy remisach zależy od tego, które wyniki są równe – wtedy wylicza się podziały rang średnich, a nie korzysta z tablic.
Podpis do pracy:
Gdzie spotkasz Manna i Whitneya w swojej pracy
Zawsze, gdy porównujesz dwie niezależne grupy na zmiennej porządkowej albo skośnej. Na co zwracać uwagę:
- przy małych próbach bez remisów podawaj dokładne p; przybliżenie normalne jest bezpieczne w środku rozkładu, gorzej w dalekim ogonie (rysunek 2);
- obok U i p podaj prawdopodobieństwo przewagi albo korelację rangowo-dwuseryjną, a jako miarę różnicy położenia – estymator Hodgesa–Lehmanna; więcej we wpisie Test Manna–Whitneya w obrazkach;
- gdy grupy różnią się rozproszeniem, rozważ test Brunnera–Munzela; przy trzech i więcej grupach naturalnym rozszerzeniem jest test Kruskala–Wallisa.
Spory, mity i trudne strony
- Kto był pierwszy? Mann i Whitney (1947) sami piszą, że równoważny test zaproponował Frank Wilcoxon w 1945 r., podając jednak tylko kilka punktów rozkładu statystyki. Wilcoxon (1947) z kolei odnotował ich tablice dla 3–8 obserwacji w grupie. Stąd nazwa „test sumy rang Wilcoxona” – to ten sam test, a U i suma rang różnią się o stałą. Nie myl go z testem Wilcoxona dla par.
- „Test median”. Alternatywa z pracy z 1947 r. to stochastyczna przewaga jednej zmiennej, nie różnica median (szerzej w haśle o teście).
- Rok doktoratu Whitneya. Willke (2008) podaje 1946, strona wydziału matematyki – 1949, a Whitney pisał, że na studia przyjechał w 1946 r.; roku nie podajemy.
Dokładny rozkład U Manna–Whitneya w R
Kod wczytuje dane PlantGrowth, liczy U z par i z rang, wypisuje wszystkie podziały 20 rang na grupy po 10, porównuje dokładne p z przybliżeniem normalnym i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje.
1. Pełne wyliczenie rozkładu U: rysunek 2
Kod R rysunku 2
# Mann i Whitney: dokładny rozkład U przez pełne wyliczenie vs przybliżenie normalne (datasets::PlantGrowth)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(dokladny = "#0072B2", normalny = "#D55E00", ogon = "#E69F00", tlo = "grey75")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(PlantGrowth, package = "datasets")
# weight – sucha masa roślin; group – kontrola (ctrl) i dwa warunki (trt1, trt2), po 10 roślin
x <- PlantGrowth$weight[PlantGrowth$group == "trt1"]
y <- PlantGrowth$weight[PlantGrowth$group == "trt2"]
n1 <- length(x); n2 <- length(y); N <- n1 + n2
rbind(trt1 = summary(x), trt2 = summary(y))
c(remisy = anyDuplicated(c(x, y)) > 0)

# 1. Statystyka U: liczba par (trt1, trt2), w których roślina z trt1 jest cięższa
U_pary <- sum(outer(x, y, ">")) + 0.5 * sum(outer(x, y, "=="))
r <- rank(c(x, y))
U_rangi <- sum(r[1:n1]) - n1 * (n1 + 1) / 2          # to samo z sumy rang
c(U_pary = U_pary, U_rangi = U_rangi, liczba_par = n1 * n2)

# 2. Pełne wyliczenie: przy H0 każdy podział 20 rang na grupy 10 + 10 jest równie prawdopodobny
podzialy <- combn(N, n1)                              # 184 756 kolumn
U_wszystkie <- colSums(matrix(r[podzialy], nrow = n1)) - n1 * (n1 + 1) / 2
c(liczba_podzialow = ncol(podzialy), choose_20_10 = choose(N, n1))
rozklad <- as.data.frame(table(U = U_wszystkie), stringsAsFactors = FALSE)
rozklad$U <- as.numeric(rozklad$U); rozklad$p <- rozklad$Freq / ncol(podzialy)
c(srednia_U = mean(U_wszystkie), wariancja_U = mean((U_wszystkie - mean(U_wszystkie))^2),
  wzor_srednia = n1 * n2 / 2, wzor_wariancja = n1 * n2 * (N + 1) / 12)
# zgodność z rozkładem wbudowanym w R (dwilcox)
c(max_roznica_z_dwilcox = max(abs(rozklad$p - dwilcox(rozklad$U, n1, n2))))

# 3. Wartość p: dokładna (z wyliczenia) i z przybliżenia normalnego
mu <- n1 * n2 / 2; sigma <- sqrt(n1 * n2 * (N + 1) / 12)
p_dokladne <- mean(abs(U_wszystkie - mu) >= abs(U_rangi - mu))
p_normalne <- 2 * pnorm(-abs(U_rangi - mu) / sigma)
p_normalne_cc <- 2 * pnorm(-(abs(U_rangi - mu) - 0.5) / sigma)      # z poprawką na ciągłość
c(uklady_tak_skrajne = sum(abs(U_wszystkie - mu) >= abs(U_rangi - mu)))
round(c(p_dokladne = p_dokladne, p_normalne = p_normalne, p_normalne_cc = p_normalne_cc,
        p_wilcox_test = wilcox.test(x, y)$p.value), 5)
round(c(z = (U_rangi - mu) / sigma, PS = U_rangi / (n1 * n2)), 3)

# 4. Ogon rozkładu: P(U <= u) dokładne vs normalne z poprawką, dla u = 0, ..., 30
ogon <- data.frame(u = 0:30)
ogon$dokladne <- sapply(ogon$u, function(u) mean(U_wszystkie <= u))
ogon$normalne_cc <- pnorm((ogon$u + 0.5 - mu) / sigma)
ogon$iloraz <- ogon$normalne_cc / ogon$dokladne
round(ogon[ogon$u %in% c(0, 5, 10, 16, 20, 25, 30), ], 6)

# Rysunek: A – dokładny rozkład U z krzywą normalną; B – ogon w skali logarytmicznej
rozklad$ogon <- abs(rozklad$U - mu) >= abs(U_rangi - mu)
krzywa <- data.frame(U = seq(0, n1 * n2, by = 0.25)); krzywa$p <- dnorm(krzywa$U, mu, sigma)
pA <- ggplot(rozklad, aes(U, p)) +
  geom_col(aes(fill = ogon), width = 0.85) +
  geom_line(data = krzywa, aes(U, p), colour = kol[["normalny"]], linewidth = 0.9, linetype = "22") +
  annotate("segment", x = U_rangi, xend = U_rangi, y = 0.004, yend = 0.0005, arrow = arrow(length = unit(2, "mm"))) +
  annotate("text", x = U_rangi, y = 0.0045, vjust = 0, size = 3.4, label = sprintf("U = %g", U_rangi)) +
  annotate("text", x = 92, y = 0.026, hjust = 1, size = 3.3, lineheight = 0.95,
           label = sprintf("p dokładne = %.4f\np normalne (z poprawką) = %.4f", p_dokladne, p_normalne_cc)) +
  scale_fill_manual(values = c(`FALSE` = kol[["tlo"]], `TRUE` = kol[["ogon"]]),
                    labels = c("pozostałe wartości U", "co najmniej tak skrajne jak w danych"), name = NULL) +
  labs(title = "A. Rozkład U przy H0: 184 756 podziałów", x = "U (n1 = n2 = 10)", y = "Prawdopodobieństwo") +
  motyw
ogon_dl <- rbind(data.frame(u = ogon$u, p = ogon$dokladne, metoda = "dokładne (wyliczenie)"),
                 data.frame(u = ogon$u, p = ogon$normalne_cc, metoda = "normalne z poprawką"))
pB <- ggplot(ogon_dl, aes(u, p, colour = metoda, shape = metoda, linetype = metoda)) +
  geom_vline(xintercept = U_rangi, colour = "grey60") +
  geom_line(linewidth = 0.7) + geom_point(size = 2) +
  scale_y_log10(breaks = 10^(-6:0), labels = c("0.000001", "0.00001", "0.0001", "0.001", "0.01", "0.1", "1")) +
  scale_colour_manual(values = c(kol[["dokladny"]], kol[["normalny"]]), name = NULL) +
  scale_shape_manual(values = c(16, 2), name = NULL) +
  scale_linetype_manual(values = c("solid", "22"), name = NULL) +
  labs(title = "B. Lewy ogon: P(U ≤ u)", x = "u", y = "P(U ≤ u), skala logarytmiczna") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.25, 1))
p2
Wynik w R
     Min. 1st Qu. Median  Mean 3rd Qu. Max.
trt1 3.59  4.2075  4.550 4.661   4.870 6.03
trt2 4.92  5.2675  5.435 5.526   5.735 6.31
remisy
 FALSE
    U_pary    U_rangi liczba_par
        16         16        100
liczba_podzialow     choose_20_10
          184756           184756
     srednia_U    wariancja_U   wzor_srednia wzor_wariancja
            50            175             50            175
max_roznica_z_dwilcox
                    0
uklady_tak_skrajne
              1650
   p_dokladne    p_normalne p_normalne_cc p_wilcox_test
      0.00893       0.01017       0.01133       0.00893
    z    PS
-2.57  0.16
    u dokladne normalne_cc    iloraz
1   0 0.000005    0.000091 16.874855
6   5 0.000103    0.000384  3.736636
11 10 0.000752    0.001414  1.878977
17 16 0.004465    0.005665  1.268624
21 20 0.011615    0.012874  1.108367
26 25 0.031506    0.032011  1.016017
31 30 0.071570    0.070233  0.981311
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Henry B. Mann (1905–2000) i D. Ransom Whitney (zm. 2007) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1905, 1935, 1938, 1942, 1946, 1947, 1949, 1964, 2000,
          1936, 1942, 1946, 1947, 1948, 1970, 1974, 1982, 2007),
  osoba = c(rep("Henry B. Mann", 9), rep("D. Ransom Whitney", 9)),
  opis = c("urodził się\nw Wiedniu", "doktorat\n(Wiedeń)", "emigracja\ndo USA", "stypendium Carnegie,\nColumbia (Wald)",
           "Nagroda Cole'a;\nOhio State", "test U\n(z Whitneyem)", "książka o planowaniu\neksperymentów",
           "Wisconsin,\npotem Arizona", "zmarł\nw Tucson",
           "dyplom\nOberlin College", "1942–1946:\nmarynarka wojenna", "studia\nw Ohio State", "test U\n(z Mannem)",
           "asystent profesor\nmatematyki", "kierownik Division\nof Statistics", "pierwszy kierownik\nwydziału statystyki",
           "emerytura", "zmarł"),
  rodzaj = c("życie", "praca", "życie", "praca", "wyróżnienie", "publikacja", "publikacja", "praca", "życie",
             "życie", "praca", "praca", "publikacja", "praca", "praca", "praca", "praca", "życie"),
  poziom = c(0.4, -0.4, 0.4, -1.1, 1.1, -0.4, 0.4, -0.4, 0.4,
             0.4, -0.4, 1.1, -1.1, 0.4, -0.4, 0.4, -0.4, 0.4),     # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.5, 1, 1, 0.5, 0.5, 0, 0, 0.5, 0.5,
                 1, 1, 0.5, 0.5, 0, 1, 0.5, 0, 0.5))               # rozsunięcie bliskich etykiet
zdarzenia$etykieta <- ifelse(zdarzenia$rok == 1942 & zdarzenia$osoba == "D. Ransom Whitney",
                             zdarzenia$opis, paste0(zdarzenia$rok, "\n", zdarzenia$opis))
zdarzenia$osoba <- factor(zdarzenia$osoba, levels = c("Henry B. Mann", "D. Ransom Whitney"))
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  facet_wrap(~ osoba, ncol = 1) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1898, 2014), breaks = seq(1900, 2010, by = 10)) +
  scale_y_continuous(limits = c(-2.1, 2.1)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        strip.text = element_text(face = "bold", hjust = 0), legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pełne wyliczenie – funkcja combn() z pakietu utils, rozkład i test – dwilcox() i wilcox.test() z pakietu stats; dane – pakiet datasets; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim byli Henry B. Mann i D. Ransom Whitney?
Matematykami z Ohio State University. Mann (1905–2000) urodził się w Wiedniu, doktoryzował się z teorii liczb, w 1938 r. wyemigrował do USA i po pracy z Waldem na Columbii trafił do Ohio State. Whitney był jego doktorantem; później kierował uczelnianym Laboratorium Statystycznym i był pierwszym kierownikiem Wydziału Statystyki (1974–1979). Zmarł w 2007 r. w wieku 92 lat.
Kto był pierwszy: Wilcoxon czy Mann i Whitney?
Wilcoxon – w 1945 r. W pracy z 1947 r. Mann i Whitney sami piszą, że Wilcoxon zaproponował równoważny test, ale podał tylko kilka punktów rozkładu statystyki. Oni wyznaczyli rozkład U z zależności rekurencyjnej, policzyli tablice dla prób do 8 obserwacji w grupie i udowodnili asymptotyczną normalność.
Kiedy w teście Manna–Whitneya liczyć dokładne p zamiast przybliżenia normalnego?
Przy małych próbach, zwłaszcza gdy wynik leży daleko w ogonie. W przykładzie z dwiema grupami po 10 obserwacji dokładne p = .0089, a przybliżenie normalne z poprawką na ciągłość daje .0113; dla skrajnych wartości U przybliżenie zawyża prawdopodobieństwo nawet kilkanaście razy.
Czym zajmował się Henry Mann poza statystyką?
Przede wszystkim teorią liczb i algebrą. W 1941 r. udowodnił hipotezę Schnirelmanna–Landaua o gęstości sumy zbiorów (twierdzenie α + β), za co w 1946 r. dostał Nagrodę Cole’a z teorii liczb. Napisał też książkę o planowaniu eksperymentów (1949) i zaproponował nieparametryczny test na trend (1945).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Test Manna–Whitneya w obrazkach
Rangi, wszystkie pary i P(X > Y), równe mediany a istotny wynik, mała próba i estymator Hodgesa–Lehmanna – pięć symulacji z kodem R.
Czytaj →PoradnikTesty odporne: Welch, Yuen, Brunner–Munzel
Co porównuje każdy test, miary efektu z CI, Brunner–Munzel liczony ręcznie w R i symulacja błędu I rodzaju przy nierównych grupach – ze wzorem opisu APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Mann, H. B. (1945). Nonparametric tests against trend. Econometrica, 13(3), 245–259. https://doi.org/10.2307/1907187
- Mann, H. B., & Whitney, D. R. (1947). On a test of whether one of two random variables is stochastically larger than the other. The Annals of Mathematical Statistics, 18(1), 50–60. https://doi.org/10.1214/aoms/1177730491 ● Otwarty dostęp
- Ohio State University Department of Mathematics. (b.d.). Henry Berthold Mann. Pobrano 19 listopada 2026 z https://math.osu.edu/about-us/history/henry-berthold-mann ● Otwarty dostęp
- Whitney, D. R., Rustagi, J., Santner, T., & Nagaraja, H. N. (1999). A short history of statistical science at The Ohio State University. The Ohio State University, Department of Statistics. https://stat.osu.edu/short-history-statistical-science-ohio-state-university-authored-d.-ransom-whitney-jagdish-rustagi ● Otwarty dostęp: pełny tekst
- Wilcoxon, F. (1947). Probability tables for individual comparisons by ranking methods. Biometrics, 3(3), 119–122. https://doi.org/10.2307/3001946
- Willke, T. (2008). In memoriam – Ransom Whitney. Department of Statistics Newsletter (The Ohio State University). https://stat.osu.edu/sites/stat.osu.edu/files/2008-statistics-newsletter.pdf ● Otwarty dostęp
Cytowania BibTeX
@article{mann1945nonparametric, author={Mann, Henry B.}, title={{Nonparametric tests against trend}}, journal={Econometrica}, year={1945}, volume={13}, number={3}, pages={245--259}, doi={10.2307/1907187}}@article{mann1947test, author={Mann, H. B. and Whitney, D. R.}, title={{On a test of whether one of two random variables is stochastically larger than the other}}, journal={The Annals of Mathematical Statistics}, year={1947}, volume={18}, number={1}, pages={50--60}, doi={10.1214/aoms/1177730491}}@misc{osundmannhenry, author={{Ohio State University Department of Mathematics}}, title={{Henry Berthold Mann}}, url={https://math.osu.edu/about-us/history/henry-berthold-mann}}@techreport{whitney1999short, author={Whitney, D. Ransom and Rustagi, Jagdish and Santner, Thomas and Nagaraja, H. N.}, title={{A short history of statistical science at The Ohio State University}}, year={1999}, institution={The Ohio State University, Department of Statistics}, url={https://stat.osu.edu/short-history-statistical-science-ohio-state-university-authored-d.-ransom-whitney-jagdish-rustagi}}@article{wilcoxon1947probability, author={Wilcoxon, Frank}, title={{Probability tables for individual comparisons by ranking methods}}, journal={Biometrics}, year={1947}, volume={3}, number={3}, pages={119--122}, doi={10.2307/3001946}}@misc{willke2008whitney, author={Willke, Tom}, title={{In memoriam – Ransom Whitney}}, howpublished={Department of Statistics Newsletter (The Ohio State University)}, year={2008}, volume={16}, pages={8}, publisher={The Ohio State University, College of Mathematical and Physical Sciences}, url={https://stat.osu.edu/sites/stat.osu.edu/files/2008-statistics-newsletter.pdf}}