Co to jest test Manna–Kendalla?
Test Manna–Kendalla (ang. Mann–Kendall trend test) to nieparametryczny test monotonicznego trendu w szeregu czasowym. Hipoteza zerowa mówi, że kolejne obserwacje są niezależne i pochodzą z tego samego rozkładu. Alternatywa: wartości z czasem systematycznie rosną albo maleją, niekoniecznie liniowo. Test wywodzi się z pracy Manna (1945) o nieparametrycznych testach przeciwko trendowi i jest w istocie tau Kendalla między wartościami a czasem.
Jak liczyć
Dla każdej pary pomiarów (i < j) zapisz znak różnicy xj − xi: +1, gdy późniejsza wartość jest większa, −1, gdy mniejsza. Suma znaków to statystyka S. Bez wiązań jej wariancja wynosi n(n − 1)(2n + 5)/18, a z = (S − 1)/√Var(S) dla S > 0 (z poprawką na ciągłość) porównuje się z rozkładem normalnym. Tau to S podzielone przez liczbę par. Wielkość trendu opisuje nachylenie Sena, czyli mediana nachyleń wszystkich par punktów – ten sam pomysł co estymator Theila–Sena z czasem jako predyktorem.
Przykład
W 30 rocznikach (1995–2024, dane symulowane) średni wynik testu sprawności w szkole wynosił M = 20.89. Test dał S = 221, Var(S) = 3141.67, z = 3.93, p < .001, tau = .51. Funkcja cor.test(rok, y, method = "kendall") zwraca to samo tau i dokładne p < .001. Nachylenie Sena wyniosło 0.078 punktu na rok (regresja MNK: 0.081). Te same S, z, tau i nachylenie dają trend::mk.test() i trend::sens.slope(). Autokorelacja reszt po usunięciu trendu przy opóźnieniu 1: −.10.
Na rysunku
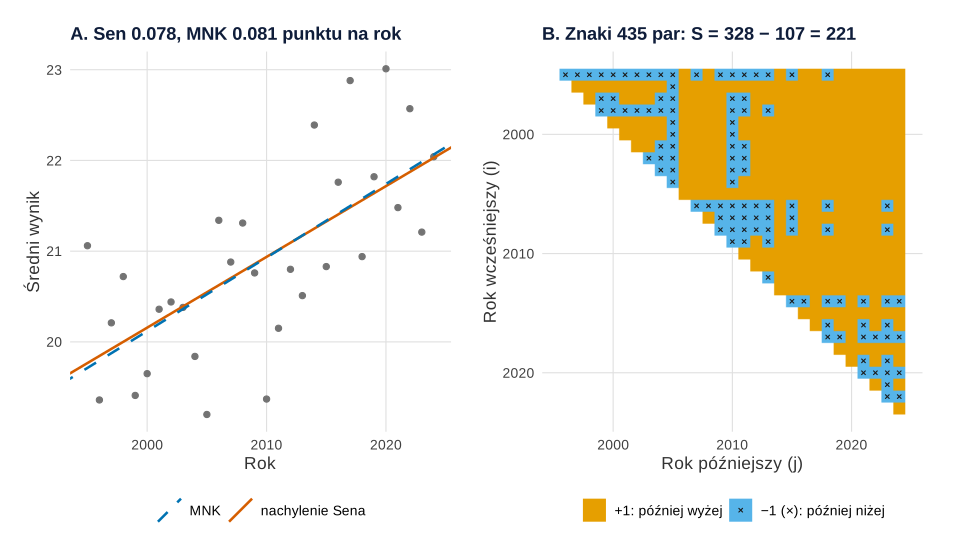
set.seed(6300)).Co widać. W panelu A proste Sena (0.078 punktu na rok) i MNK (0.081) niemal się pokrywają, bo w danych nie ma wartości odstających. Panel B pokazuje, skąd bierze się S: każde pole to para lat, pomarańczowe, gdy późniejszy wynik jest wyższy, niebieskie z krzyżykiem, gdy niższy. Z 435 par 328 to „plusy”, a 107 „minusy”, więc S = 221. Minusy skupiają się przy przekątnej – w parach bliskich lat szum przeważa nad słabym trendem.
Na co uważać. Mapa pokazuje tylko znaki, nie wielkość zmian (od tego jest nachylenie Sena), ani zależności między kolejnymi latami (rysunek 2). Sen i MNK przy wartościach odstających porównuje hasło estymator Theila–Sena.
Podpis do pracy:
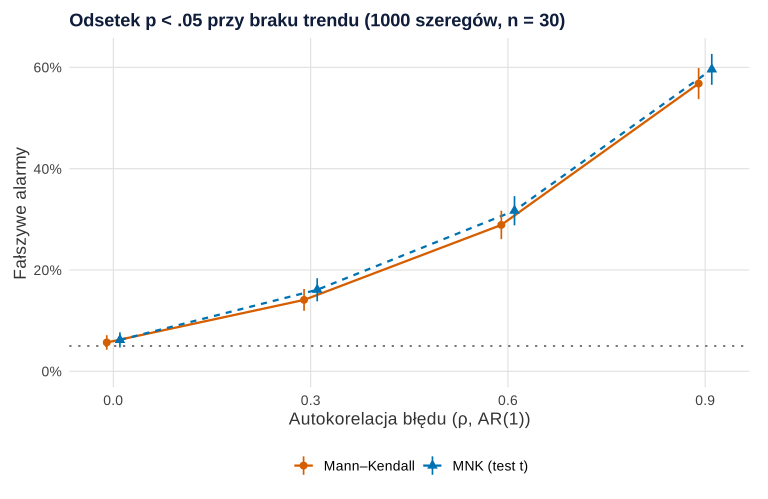
set.seed(6301)).Co widać. Żaden z 4000 szeregów nie ma trendu. Przy niezależnych obserwacjach (ρ = 0) test Manna–Kendalla daje p < .05 w 5.7% szeregów (błąd MC 0.7 punktu procentowego), przy ρ = .3 w 14.1%, przy ρ = .6 w 28.9%, a przy ρ = .9 w 56.8%. Test t dla nachylenia MNK zawodzi podobnie (16.1%, 31.7%, 59.6%). Test nieparametryczny chroni przed nienormalnością, ale nie przed zależnością obserwacji.
Na co uważać. Symulacja dotyczy tylko n = 30 i błędu AR(1). Nie pokazuje poprawek – ich koszt (osłabienie istniejącego trendu przy usuwaniu autokorelacji) opisali Yue i in. (2002).
Podpis do pracy:
Ziarna (niezmieniane): rysunek 1 – set.seed(6300) jak w przykładzie, rysunek 2 – set.seed(6301). Ręcznie ustalono poziomy autokorelacji (0, .3, .6, .9) i 1000 powtórzeń na scenariusz. Rysunki na stronie to te same obiekty p1 i p2 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Szereg z trendem, prosta Sena i MNK oraz znaki wszystkich 435 par (30 lat, dane symulowane)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(dane = "grey45", sen = "#D55E00", mnk = "#0072B2", plus = "#E69F00", minus = "#56B4E9")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
set.seed(6300)                                      # te same dane co w przykładzie
rok <- 1995:2024
n <- length(rok)
y <- round(20 + 0.08 * (rok - 1995) + rnorm(n, sd = 0.9), 2)
pary <- subset(expand.grid(i = 1:n, j = 1:n), i < j)
pary$znak <- sign(y[pary$j] - y[pary$i])            # +1: późniejszy wynik wyższy
pary$nachyl <- (y[pary$j] - y[pary$i]) / (rok[pary$j] - rok[pary$i])
sen <- median(pary$nachyl); b_sen0 <- median(y - sen * rok)   # prosta Sena (wyraz wolny: mediana)
mnk <- coef(lm(y ~ rok))
c(pary = nrow(pary), plusy = sum(pary$znak > 0), minusy = sum(pary$znak < 0), S = sum(pary$znak))
round(c(sen = sen, mnk = unname(mnk[2])), 4)
proste <- data.frame(nazwa = c("nachylenie Sena", "MNK"), a = c(b_sen0, mnk[1]), b = c(sen, mnk[2]))
pa <- ggplot(data.frame(rok, y), aes(rok, y)) + geom_point(colour = kol[["dane"]], size = 1.8) +
  geom_abline(data = proste, aes(intercept = a, slope = b, colour = nazwa, linetype = nazwa), linewidth = 0.9) +
  scale_colour_manual(values = c(MNK = kol[["mnk"]], `nachylenie Sena` = kol[["sen"]])) +
  scale_linetype_manual(values = c(MNK = "dashed", `nachylenie Sena` = "solid")) +
  labs(title = sprintf("A. Sen %.3f, MNK %.3f punktu na rok", sen, mnk[2]),
       x = "Rok", y = "Średni wynik", colour = NULL, linetype = NULL)
pb <- ggplot(pary, aes(rok[j], rok[i], fill = factor(znak, levels = c(1, -1)))) +
  geom_raster() +
  geom_point(data = subset(pary, znak < 0), shape = 4, size = 0.9, colour = "grey10") +   # × = para „w dół”
  scale_fill_manual(values = c(`1` = kol[["plus"]], `-1` = kol[["minus"]]),
                    labels = c("+1: później wyżej", "−1 (×): później niżej")) +
  scale_y_reverse() + coord_equal() +
  labs(title = sprintf("B. Znaki %d par: S = %d − %d = %d",
                       nrow(pary), sum(pary$znak > 0), sum(pary$znak < 0), sum(pary$znak)),
       x = "Rok późniejszy (j)", y = "Rok wcześniejszy (i)", fill = NULL)
p1 <- (pa + pb + plot_layout(widths = c(1, 1))) & motyw
p1
Wynik w R
  pary  plusy minusy      S
   435    328    107    221
   sen    mnk
0.0780 0.0811
Kod R rysunku 2 (symulacja)
# Rysunek 2. Fałszywe alarmy testu Manna–Kendalla i testu t dla nachylenia MNK przy autokorelacji, bez trendu
suppressPackageStartupMessages({library(ggplot2)})
kol <- c(`Mann–Kendall` = "#D55E00", `MNK (test t)` = "#0072B2")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
set.seed(6301)
n <- 30; R <- 1000; rho <- c(0, 0.3, 0.6, 0.9)        # 30 lat, 1000 szeregów na scenariusz
p_mk <- function(y) {                                 # dwustronne p Manna–Kendalla (bez wiązań)
  S <- sum(sign(outer(y, y, "-"))[lower.tri(diag(n))])
  z <- (S - sign(S)) / sqrt(n * (n - 1) * (2 * n + 5) / 18)
  2 * pnorm(-abs(z))
}
t0 <- Sys.time()
wyn <- do.call(rbind, lapply(rho, function(r) {
  p <- replicate(R, {
    y <- if (r == 0) rnorm(n) else as.numeric(arima.sim(list(ar = r), n = n))   # brak trendu
    c(p_mk(y), summary(lm(y ~ seq_len(n)))$coefficients[2, 4])
  })
  data.frame(rho = r, test = c("Mann–Kendall", "MNK (test t)"), odsetek = rowMeans(p < .05))
}))
wyn$blad_MC <- sqrt(wyn$odsetek * (1 - wyn$odsetek) / R)
print(transform(wyn, odsetek = round(odsetek, 3), blad_MC = round(blad_MC, 3)), row.names = FALSE)
cat("czas < 1 min:", as.numeric(difftime(Sys.time(), t0, units = "secs")) < 60, "\n")
p2 <- ggplot(wyn, aes(rho, odsetek, colour = test, shape = test, linetype = test)) +
  geom_hline(yintercept = 0.05, colour = "grey40", linetype = "dotted") +
  geom_line(linewidth = 0.8, position = position_dodge(width = 0.04)) +
  geom_pointrange(aes(ymin = odsetek - 1.96 * blad_MC, ymax = odsetek + 1.96 * blad_MC), size = 0.5,
                  position = position_dodge(width = 0.04), linetype = "solid") +
  scale_colour_manual(values = kol) + scale_x_continuous(breaks = rho) +
  scale_y_continuous(labels = function(v) paste0(round(100 * v), "%"), limits = c(0, NA)) +
  labs(title = "Odsetek p < .05 przy braku trendu (1000 szeregów, n = 30)",
       x = "Autokorelacja błędu (ρ, AR(1))", y = "Fałszywe alarmy", colour = NULL, shape = NULL, linetype = NULL) +
  motyw
p2
Wynik w R
 rho         test odsetek blad_MC
 0.0 Mann–Kendall   0.057   0.007
 0.0 MNK (test t)   0.062   0.008
 0.3 Mann–Kendall   0.141   0.011
 0.3 MNK (test t)   0.161   0.012
 0.6 Mann–Kendall   0.289   0.014
 0.6 MNK (test t)   0.317   0.015
 0.9 Mann–Kendall   0.568   0.016
 0.9 MNK (test t)   0.596   0.016
czas < 1 min: TRUE
Jak opisać w pracy
Na co uważać
- Autokorelacja. Yue i in. (2002) pokazali w symulacjach, że korelacja szeregowa zmienia wariancję statystyki testu, a usuwanie dodatniej autokorelacji (tzw. prewhitening) osłabia też istniejący trend. Zalecili najpierw usunąć trend, a dopiero potem szacować autokorelację.
- Sezonowość. Przy danych miesięcznych z sezonowością stosuje się sezonowy test Kendalla. Hirsch i in. (1982) opisali go jako test odporny na sezonowość i braki danych, ale nie dokładny przy korelacji szeregowej.
- Trend a skok. Jednorazowa zmiana poziomu też daje duże S. Gdy podejrzewasz jeden moment zmiany, sprawdź go testem Pettitta.
- Wiązania zmniejszają wariancję S, więc trzeba ją skorygować.
Szerszy warsztat analizy szeregów pokazuje wpis Szeregi czasowe i ARIMA w praktyce.
Test Manna–Kendalla w R
Kod liczy statystykę S, jej wariancję i z ręcznie, porównuje wynik z cor.test(method = "kendall") i wyznacza nachylenie Sena, a potem sprawdza wynik funkcjami Kendall::MannKendall(), trend::mk.test() i trend::sens.slope(). Liczby w tekście pochodzą z tego kodu.
Statystyka S, z, tau i nachylenie Sena
R
set.seed(6300)
rok <- 1995:2024                                    # 30 lat obserwacji
n <- length(rok)
y <- round(20 + 0.08 * (rok - 1995) + rnorm(n, sd = 0.9), 2)   # średni wynik roczny, słaby trend
S <- 0
for (i in 1:(n - 1)) for (j in (i + 1):n) S <- S + sign(y[j] - y[i])
varS <- n * (n - 1) * (2 * n + 5) / 18              # wariancja S bez wiązań
z <- (S - sign(S)) / sqrt(varS)                     # z poprawką na ciągłość
round(c(n = n, wiazania = sum(duplicated(y)), S = S, varS = varS, z = z, M = mean(y),
        tau = S / (n * (n - 1) / 2)), 3)
signif(2 * pnorm(-abs(z)), 3)                       # dwustronne p z przybliżenia normalnego
cor.test(rok, y, method = "kendall")                # to samo tau; p dokładne (n < 50, brak wiązań)
nachyl <- outer(y, y, "-") / outer(rok, rok, "-")   # nachylenie Sena: mediana nachyleń par
round(c(sen = median(nachyl[lower.tri(nachyl)]), mnk = unname(coef(lm(y ~ rok))[2])), 4)
round(acf(resid(lm(y ~ rok)), plot = FALSE)$acf[2], 3)  # autokorelacja reszt (opóźnienie 1)
round(2 / factorial(4:5), 3)                         # najmniejsze dwustronne p przy n = 4 i n = 5
Kendall::MannKendall(y)                              # kontrola: tau i p z pakietu Kendall
trend::mk.test(y)                                    # kontrola: S, varS, z, tau i p z pakietu trend
trend::sens.slope(y)                                 # nachylenie Sena z 95% CI
Wynik w R
       n wiazania        S     varS        z        M      tau
  30.000    0.000  221.000 3141.667    3.925   20.889    0.508
[1] 8.67e-05

	Kendall's rank correlation tau

data:  rok and y
T = 328, p-value = 4.178e-05
alternative hypothesis: true tau is not equal to 0
sample estimates:
     tau
0.508046

   sen    mnk
0.0780 0.0811
[1] -0.103
[1] 0.083 0.017
tau = 0.508, 2-sided pvalue =8.6665e-05

	Mann-Kendall trend test

data:  y
z = 3.925, n = 30, p-value = 8.672e-05
alternative hypothesis: true S is not equal to 0
sample estimates:
          S        varS         tau
 221.000000 3141.666667    0.508046


	Sen's slope

data:  y
z = 3.925, n = 30, p-value = 8.672e-05
alternative hypothesis: true z is not equal to 0
95 percent confidence interval:
 0.0415000 0.1192857
sample estimates:
Sen's slope
      0.078
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety Kendall i trend; rysunki 1 i 2 – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- Kendall (wersja 2.2.2): McLeod, A. I. (2025). Kendall: Kendall rank correlation and Mann-Kendall trend test (R package version 2.2.2) [Computer software]. https://doi.org/10.32614/CRAN.package.Kendall
- trend (wersja 1.1.10): Pohlert, T. (2026). trend: Non-parametric trend tests and change-point detection (R package version 1.1.10) [Computer software]. https://doi.org/10.32614/CRAN.package.trend
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym test Manna–Kendalla różni się od regresji liniowej z czasem?
Regresja testuje nachylenie prostej i zakłada normalne reszty. Test Manna–Kendalla sprawdza tylko, czy późniejsze wartości są systematycznie większe lub mniejsze, więc wykrywa każdy trend monotoniczny i słabiej reaguje na wartości odstające.
Od ilu pomiarów test Manna–Kendalla może dać p < .05?
Przy czterech pomiarach nawet idealnie rosnący szereg daje dwustronne p = 2/24 ≈ .083, więc potrzeba co najmniej pięciu (p ≈ .017). W krótkich szeregach moc testu jest jednak niska.
Jak policzyć test Manna–Kendalla w R bez dodatkowych pakietów?
Użyj cor.test(czas, y, method = "kendall"): tau i p to wynik testu Manna–Kendalla. Nachylenie Sena policz jako medianę nachyleń wszystkich par punktów, np. funkcją outer().
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hirsch, R. M., Slack, J. R., & Smith, R. A. (1982). Techniques of trend analysis for monthly water quality data. Water Resources Research, 18(1), 107–121. https://doi.org/10.1029/wr018i001p00107
- Mann, H. B. (1945). Nonparametric tests against trend. Econometrica, 13(3), 245–259. https://doi.org/10.2307/1907187
- Yue, S., Pilon, P., Phinney, B., & Cavadias, G. (2002). The influence of autocorrelation on the ability to detect trend in hydrological series. Hydrological Processes, 16(9), 1807–1829. https://doi.org/10.1002/hyp.1095 ● Otwarty dostęp
Cytowania BibTeX
@article{hirsch1982techniques, author={Hirsch, Robert M. and Slack, James R. and Smith, Richard A.}, title={{Techniques of trend analysis for monthly water quality data}}, journal={Water Resources Research}, year={1982}, volume={18}, number={1}, pages={107--121}, doi={10.1029/wr018i001p00107}}@article{mann1945nonparametric, author={Mann, Henry B.}, title={{Nonparametric tests against trend}}, journal={Econometrica}, year={1945}, volume={13}, number={3}, pages={245--259}, doi={10.2307/1907187}}@article{yue2002influence, author={Yue, Sheng and Pilon, Paul and Phinney, Bob and Cavadias, George}, title={{The influence of autocorrelation on the ability to detect trend in hydrological series}}, journal={Hydrological Processes}, year={2002}, volume={16}, number={9}, pages={1807--1829}, doi={10.1002/hyp.1095}}