Co to jest test Pettitta?
Test Pettitta (ang. Pettitt’s change-point test) to nieparametryczny test jednego punktu zmiany w szeregu czasowym. Sprawdza, czy od pewnego nieznanego z góry momentu obserwacje mają inne położenie (np. wyższą medianę) niż wcześniej. Hipoteza zerowa mówi, że zmiany nie było. Pettitt (1979) zaproponował nieparametryczne techniki dla problemu punktu zmiany, podał dokładne i przybliżone wyniki dla hipotezy braku zmiany i porównał je z metodami opartymi na sumach skumulowanych.
Jak liczyć
Dla każdego możliwego podziału szeregu po obserwacji t liczy się Ut – sumę znaków różnic xi − xj dla wszystkich par z i ≤ t < j. To przekształcona statystyka testu Manna–Whitneya dla dwóch fragmentów szeregu: Ut = 2W − t(n − t). Statystyka testu to K = max |Ut|, a t, w którym występuje maksimum, jest oszacowanym punktem zmiany. Często stosowane przybliżenie to p ≈ 2·exp(−6K²/(n³ + n²)); w krótkich szeregach warto policzyć też p z testu permutacyjnego.
Przykład
W 40 miesiącach danych symulowanych poziom wskaźnika podniesiono po 24. miesiącu. Test wskazał punkt zmiany po 23. miesiącu, K = 208. Średnia przed nim wynosiła 49.69, a po nim 54.66. Przybliżone p = .038, a p permutacyjne z 5000 losowań = .018. Funkcja trend::pettitt.test() daje te same K, punkt zmiany i przybliżone p. Oszacowany moment różni się o jeden miesiąc od prawdziwego – to typowa niepewność położenia punktu zmiany.
Na rysunku
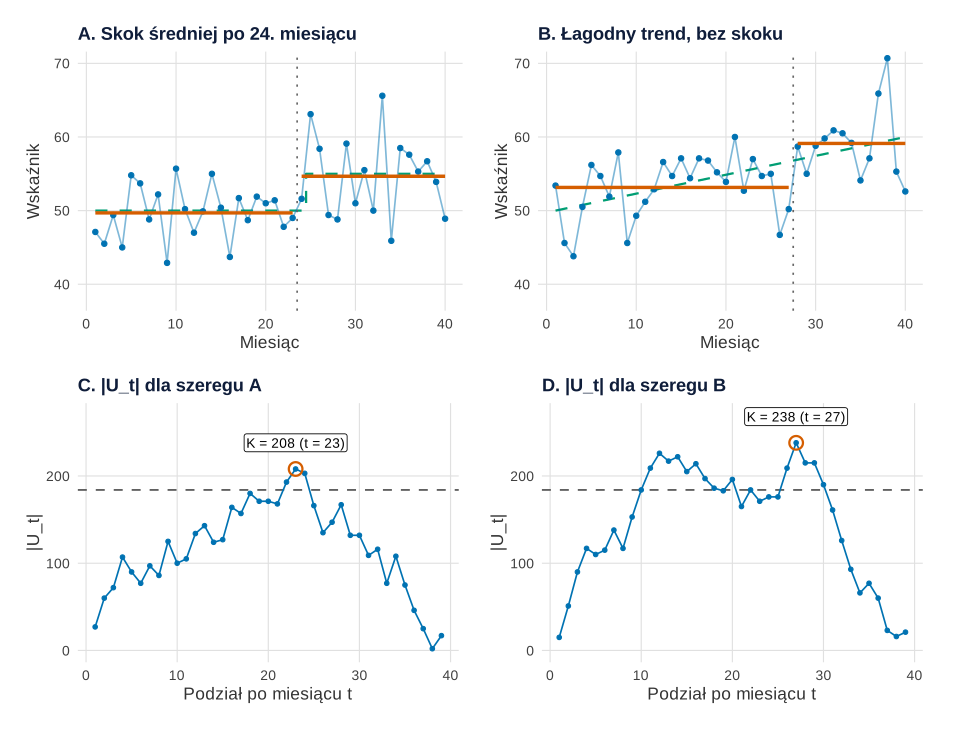
set.seed(6310)).Co widać. Panel A to dane z przykładu. Statystyka |Ut| (C) rośnie, dopóki kolejne podziały oddzielają „niskie” miesiące od „wysokich”, i spada, gdy podział przechodzi przez wysokie wartości. Szczyt K = 208 przypada po 23. miesiącu, ponad wartością krytyczną 184 z permutacji; p permutacyjne = .018. Panel B pokazuje pułapkę „trend udaje skok”: szereg bez żadnego skoku, ze stałym wzrostem o 10 punktów w 40 miesięcy. Test i tak „znajduje” punkt zmiany po 27. miesiącu, z jeszcze większym K = 238 i przybliżonym p = .011, a średnie po obu stronach (53.15 i 59.12) wyglądają jak skok. Różnicę zdradza kształt krzywej: przy skoku |Ut| ma ostry szczyt, przy trendzie – szeroki płaskowyż wysokich wartości przez kilkanaście kolejnych podziałów.
Na co uważać. Test nie mówi, czy zmiana była nagła – ten sam wynik daje trend, dlatego zawsze narysuj szereg i porównaj go z testem Manna–Kendalla. Próg 184 pochodzi z permutacji szeregu A; bez wiązań rozkład K przy braku zmiany zależy tylko od n, więc dla szeregu B obowiązuje w przybliżeniu ten sam próg (szereg A ma 3 powtórzone wartości). Wykres nie pokazuje niepewności położenia punktu: sąsiednie podziały mają niewiele niższe |Ut|. Jak działa sam rozkład permutacyjny, opisuje hasło test permutacyjny.
Podpis do pracy:
Kod rysunku ma jedno ziarno (set.seed(6310), to samo co w przykładzie, niezmieniane): najpierw odtwarza dane i 5000 permutacji z przykładu, potem losuje szereg z trendem. Wielkość trendu (10 punktów w 40 miesięcy) ustawiono ręcznie po próbie z 5 punktami, przy której test nie był istotny – tak, żeby pułapka była widoczna. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Skok średniej i łagodny trend: szereg i |U_t| Pettitta (40 miesięcy, dane symulowane)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(dane = "#0072B2", srednie = "#D55E00", prog = "#555555", prawda = "#009E73")   # Okabe–Ito + szary
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
set.seed(6310)                                      # te same dane i permutacje co w przykładzie
n <- 40
x <- round(c(rnorm(24, mean = 50, sd = 4), rnorm(16, mean = 55, sd = 4)), 1)  # skok po 24. miesiącu
pettitt_U <- function(x) {
  n <- length(x)
  sapply(1:(n - 1), function(t) sum(sign(outer(x[1:t], x[(t + 1):n], "-"))))
}
U <- pettitt_U(x); K <- max(abs(U)); tau <- which.max(abs(U))
perm <- replicate(5000, max(abs(pettitt_U(sample(x)))))       # rozkład K przy braku zmiany
prog95 <- unname(quantile(perm, 0.95))                         # wartość krytyczna z permutacji
x2 <- round(50 + 10 * (0:(n - 1)) / (n - 1) + rnorm(n, sd = 4), 1)  # łagodny trend o 10 punktów, bez skoku
U2 <- pettitt_U(x2); K2 <- max(abs(U2)); tau2 <- which.max(abs(U2))
p_przybl <- function(K) min(1, 2 * exp(-6 * K^2 / (n^3 + n^2)))
round(rbind(skok = c(K = K, punkt = tau, p_przybl = p_przybl(K), p_perm = mean(perm >= K)),
            trend = c(K = K2, punkt = tau2, p_przybl = p_przybl(K2), p_perm = NA)), 4)
round(c(prog95_perm = prog95, M_przed_trend = mean(x2[1:tau2]), M_po_trend = mean(x2[(tau2 + 1):n])), 2)
panel_szereg <- function(v, t0, tytul, prawda) {
  sr <- data.frame(x0 = c(1, t0 + 1), x1 = c(t0, n), m = c(mean(v[1:t0]), mean(v[(t0 + 1):n])))
  ggplot(data.frame(t = 1:n, v = v), aes(t, v)) +
    geom_line(data = prawda, aes(t, m), colour = kol[["prawda"]], linetype = "dashed", linewidth = 0.8) +
    geom_vline(xintercept = t0 + 0.5, colour = "grey40", linetype = "dotted") +
    geom_line(colour = kol[["dane"]], alpha = 0.5) + geom_point(colour = kol[["dane"]], size = 1.5) +
    geom_segment(data = sr, aes(x = x0, xend = x1, y = m, yend = m), colour = kol[["srednie"]], linewidth = 1.2) +
    coord_cartesian(ylim = c(38, 70)) + labs(title = tytul, x = "Miesiąc", y = "Wskaźnik")
}
panel_U <- function(u, KK, t0, tytul) {
  ggplot(data.frame(t = 1:(n - 1), u = abs(u)), aes(t, u)) +
    geom_hline(yintercept = prog95, colour = kol[["prog"]], linetype = "dashed") +
    geom_line(colour = kol[["dane"]]) + geom_point(colour = kol[["dane"]], size = 1.2) +
    annotate("point", x = t0, y = KK, shape = 21, size = 4, stroke = 1.2, colour = kol[["srednie"]]) +
    annotate("label", x = t0, y = KK + 30, size = 3.6, fill = "white",
             label = sprintf("K = %d (t = %d)", KK, t0)) +
    coord_cartesian(ylim = c(0, 270)) + labs(title = tytul, x = "Podział po miesiącu t", y = "|U_t|")
}
p1 <- (panel_szereg(x, tau, "A. Skok średniej po 24. miesiącu",
                    data.frame(t = c(1, 24.5, 24.5, n), m = c(50, 50, 55, 55))) +
       panel_szereg(x2, tau2, "B. Łagodny trend, bez skoku",
                    data.frame(t = c(1, n), m = c(50, 60)))) /
      (panel_U(U, K, tau, "C. |U_t| dla szeregu A") + panel_U(U2, K2, tau2, "D. |U_t| dla szeregu B")) & motyw
p1
Wynik w R
        K punkt p_przybl p_perm
skok  208    23   0.0382 0.0178
trend 238    27   0.0112     NA
  prog95_perm M_przed_trend    M_po_trend
       184.00         53.15         59.12
Jak opisać w pracy
Na co uważać
- Trend udaje skok. Stopniowy wzrost też daje duże K. Test nie odróżni trendu od jednorazowej zmiany – porównaj wynik z testem Manna–Kendalla i wykresem.
- Znany moment. Jeśli datę zmiany znasz z góry, np. wprowadzenie programu, nie szukaj jej testem. Zastosuj przerwany szereg czasowy; zmianę nachylenia opisuje regresja segmentowa.
- Autokorelacja. Dodatnio skorelowane obserwacje tworzą długie odcinki powyżej i poniżej średniej, co sprzyja fałszywym wykryciom.
- Wybór metody. Reeves i in. (2007) porównali wiele metod wykrywania nieudokumentowanych punktów zmiany w danych klimatycznych i pokazali, że najlepsza zależy od założeń o trendzie i okresowości.
Do bieżącego monitorowania procesu lepiej nadaje się karta CUSUM.
Test Pettitta w R
Kod liczy Ut dla wszystkich podziałów szeregu, statystykę K, przybliżone i permutacyjne p oraz sprawdza związek z W Manna–Whitneya i wynik funkcji trend::pettitt.test(). Liczby w tekście pochodzą z tego kodu.
Statystyka K, punkt zmiany i dwie wartości p
R
set.seed(6310)
n <- 40                                             # 40 kolejnych miesięcy
x <- round(c(rnorm(24, mean = 50, sd = 4), rnorm(16, mean = 55, sd = 4)), 1)  # skok po 24. miesiącu
pettitt_U <- function(x) {
  n <- length(x)
  sapply(1:(n - 1), function(t) sum(sign(outer(x[1:t], x[(t + 1):n], "-"))))
}
U <- pettitt_U(x)
K <- max(abs(U)); tau <- which.max(abs(U))          # statystyka K i punkt zmiany
p_przybl <- min(1, 2 * exp(-6 * K^2 / (n^3 + n^2))) # przybliżone p
p_perm <- mean(replicate(5000, max(abs(pettitt_U(sample(x))))) >= K)  # p permutacyjne
round(c(K = K, punkt = tau, U_tau = U[tau], p_przybl = p_przybl, p_perm = p_perm), 4)
round(c(przed = mean(x[1:tau]), po = mean(x[(tau + 1):n])), 2)
W <- wilcox.test(x[1:tau], x[(tau + 1):n], exact = FALSE)$statistic   # W Manna–Whitneya dla podziału w tau
c(W = unname(W), U_z_W = unname(2 * W - tau * (n - tau)))           # U_tau = 2W − t(n − t)
trend::pettitt.test(x)                              # kontrola: U* = K, punkt zmiany i przybliżone p z pakietu trend
Wynik w R
        K     punkt     U_tau  p_przybl    p_perm
 208.0000   23.0000 -208.0000    0.0382    0.0178
przed    po
49.69 54.66
     W  U_z_W
  91.5 -208.0

	Pettitt's test for single change-point detection

data:  x
U* = 208, p-value = 0.03824
alternative hypothesis: two.sided
sample estimates:
probable change point at time K
                             23
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet trend; rysunek 1 – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- trend (wersja 1.1.10): Pohlert, T. (2026). trend: Non-parametric trend tests and change-point detection (R package version 1.1.10) [Computer software]. https://doi.org/10.32614/CRAN.package.trend
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym test Pettitta różni się od testu Chowa?
Test Chowa sprawdza zmianę współczynników regresji w punkcie wskazanym z góry. Test Pettitta sam szuka nieznanego punktu zmiany i opiera się na rangach, więc nie wymaga normalności reszt.
Czy test Pettitta wykryje zmianę wariancji?
Zwykle nie. Statystyka opiera się na znakach różnic między obserwacjami przed i po podziale, więc reaguje na przesunięcie położenia. Wzrost samego rozrzutu przy tej samej medianie daje małe K.
Jak policzyć test Pettitta w R bez pakietu trend?
Policz U_t dla każdego podziału jako sum(sign(outer(x[1:t], x[(t+1):n], "-"))), weź K = max|U_t|, a p wyznacz ze wzoru przybliżonego albo permutacyjnie funkcją sample().
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Pettitt, A. N. (1979). A non-parametric approach to the change-point problem. Applied Statistics, 28(2), 126–135. https://doi.org/10.2307/2346729
- Reeves, J., Chen, J., Wang, X. L., Lund, R., & Lu, Q. Q. (2007). A review and comparison of changepoint detection techniques for climate data. Journal of Applied Meteorology and Climatology, 46(6), 900–915. https://doi.org/10.1175/jam2493.1
Cytowania BibTeX
@article{pettitt1979nonparametric, author={Pettitt, A. N.}, title={{A non-parametric approach to the change-point problem}}, journal={Applied Statistics}, year={1979}, volume={28}, number={2}, pages={126--135}, doi={10.2307/2346729}}@article{reeves2007review, author={Reeves, Jaxk and Chen, Jien and Wang, Xiaolan L. and Lund, Robert and Lu, Qi Qi}, title={{A review and comparison of changepoint detection techniques for climate data}}, journal={Journal of Applied Meteorology and Climatology}, year={2007}, volume={46}, number={6}, pages={900--915}, doi={10.1175/jam2493.1}}