Co to jest test Chowa?
Test Chowa (ang. Chow test) sprawdza, czy ten sam model regresji – stała i wszystkie nachylenia – obowiązuje w dwóch grupach albo w dwóch okresach rozdzielonych znanym z góry punktem, np. reformą. Wywodzi się z pracy Chowa (1960) o testach równości zbiorów współczynników w dwóch regresjach liniowych. W ekonometrii nazywa się go testem zmiany strukturalnej.
Jak działa test
Dopasowuje się model wspólny dla wszystkich obserwacji (suma kwadratów reszt Sc) i osobne modele dla obu części (S1, S2). Statystyka to F = [(Sc − S1 − S2) / k] / [(S1 + S2) / (n1 + n2 − 2k)], gdzie k to liczba parametrów jednego modelu razem ze stałą. Przy H₀ (współczynniki równe) ma ona rozkład F z k i n1 + n2 − 2k stopniami swobody. Ten sam wynik daje porównanie modelu wspólnego z modelem, w którym każdy współczynnik wchodzi w interakcję ze zmienną zero-jedynkową grupy.
Przykład
W danych symulowanych 120 uczniów (60 przed reformą programu i 60 po niej) wynik testu przewidujemy z liczby godzin nauki. Test Chowa daje F(2, 116) = 23.62, p < .001: zależność różni się przed reformą i po niej. Model z interakcją pokazuje, na czym polega różnica: po reformie stała jest wyższa o 6.29 punktu, a nachylenie o 0.76 punktu na godzinę.
Na rysunku
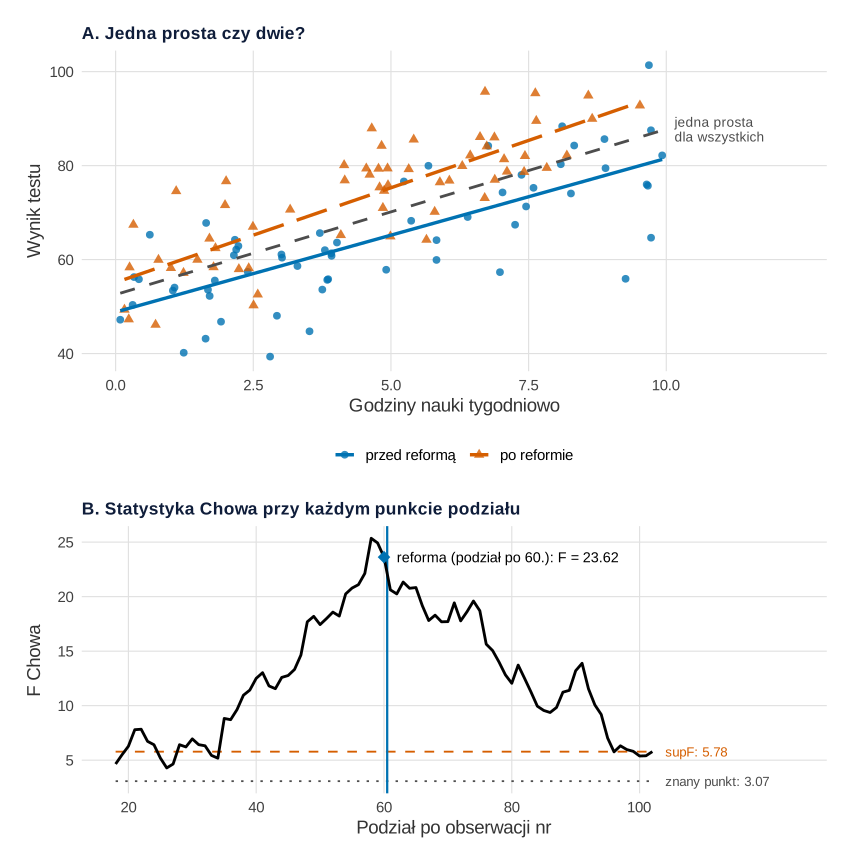
set.seed(596)).Co widać. To te same 120 uczniów co w przykładzie niżej. W panelu A prosta po reformie ma stałą 55.13 i nachylenie 4.03, a przed reformą 48.83 i 3.27. Wspólna prosta (52.55 i 3.52) leży pomiędzy nimi i nie pasuje dobrze do żadnej z grup. Test Chowa mierzy, o ile suma kwadratów reszt spada, gdy jedną prostą zastąpimy dwiema. Panel B liczy tę samą statystykę dla każdego możliwego miejsca podziału. Przy rzeczywistej reformie (po 60. obserwacji) F = 23.62, a najwyższe F = 25.35 wypada po 58. obserwacji.
Na co uważać. Gdy szukamy miejsca podziału z największym F, zwykły próg F(2, 116) = 3.07 przestaje obowiązywać. Właściwy próg dla największej z wielu statystyk (supF, Andrews, 1993) wynosi tu 5.78. Przy prawdziwej zmianie oba progi są daleko przekroczone, ale przy słabej zmianie ta różnica rozstrzyga o wyniku. Krzywa nie wskazuje też dokładnie punktu zmiany: szczyt wypada dwie obserwacje przed reformą. Wykres nie pokazuje, czy reszty mają równą wariancję w obu okresach. Porównanie dwóch prostych w grupach jako moderację omawia wpis moderacja – wizualizacja.
Podpis do pracy:
Kod losuje te same dane co przykład niżej, z tym samym ziarnem set.seed(596), ustalonym raz. Zakres podziałów (od 15% do 85% próby) to domyślne przycięcie stosowane przy teście supF. Rysunek na stronie różni się od wyniku kodu tylko motywem serwisu.
Kod R rysunku 1
# Rysunek 1. Jedna prosta vs dwie proste przed reformą i po niej (A) i statystyka Chowa dla każdego możliwego punktu podziału (B)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c(przed = "#0072B2", po = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

set.seed(596)                                      # te same dane co w przykładzie niżej
n1 <- 60; n2 <- 60; k <- 2
godz <- runif(n1 + n2, 0, 10)
po <- rep(0:1, c(n1, n2))                          # obserwacje 1–60 przed reformą, 61–120 po niej
wynik <- 50 + 3 * godz + po * (5 + 1.0 * godz) + rnorm(n1 + n2, sd = 8)
d <- data.frame(godz, wynik, okres = factor(po, 0:1, c("przed reformą", "po reformie")))
rss <- function(m) sum(resid(m)^2)

# Statystyka Chowa dla podziału po obserwacji m (od 15% do 85% próby)
chow_F <- function(m) {
  S_c <- rss(lm(wynik ~ godz))
  S_u <- rss(lm(wynik[1:m] ~ godz[1:m])) + rss(lm(wynik[-(1:m)] ~ godz[-(1:m)]))
  ((S_c - S_u) / k) / (S_u / (n1 + n2 - 2 * k))
}
podzial <- 18:102
Fm <- sapply(podzial, chow_F)
kryt_znany <- qf(0.95, k, n1 + n2 - 2 * k)         # próg, gdy punkt podziału znany z góry
kryt_sup <- strucchange::boundary(strucchange::Fstats(wynik ~ godz, from = 18, to = 102))[1] / k  # próg supF (Andrews)
round(c(F_w_60 = Fm[podzial == 60], podzial_max = podzial[which.max(Fm)], F_max = max(Fm),
        kryt_znany = kryt_znany, kryt_supF = kryt_sup), 2)
round(rbind(przed = coef(lm(wynik ~ godz, subset = po == 0)), po = coef(lm(wynik ~ godz, subset = po == 1)),
            wspolny = coef(lm(wynik ~ godz))), 2)

pA <- ggplot(d, aes(godz, wynik)) +
  geom_point(aes(colour = okres, shape = okres), size = 2.3, alpha = 0.8) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = "grey30", linetype = "dashed", linewidth = 1) +
  geom_smooth(aes(colour = okres, linetype = okres), method = "lm", formula = y ~ x, se = FALSE, linewidth = 1.2) +
  annotate("text", x = 10.15, y = predict(lm(wynik ~ godz), data.frame(godz = 10)), label = "jedna prosta\ndla wszystkich",
           hjust = 0, size = 3.6, colour = "grey30", lineheight = 0.9) +
  scale_x_continuous(breaks = seq(0, 10, 2.5), limits = c(0, 12.3)) +
  scale_colour_manual(values = unname(kol), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash"), name = NULL) +
  labs(title = "A. Jedna prosta czy dwie?", x = "Godziny nauki tygodniowo", y = "Wynik testu") + motyw

pB <- ggplot(data.frame(m = podzial, F = Fm), aes(m, F)) +
  annotate("segment", x = 18, xend = 102, y = kryt_znany, yend = kryt_znany, linetype = "dotted", colour = "grey30") +
  annotate("segment", x = 18, xend = 102, y = kryt_sup, yend = kryt_sup, linetype = "dashed", colour = kol[["po"]]) +
  annotate("text", x = 104, y = c(kryt_znany, kryt_sup), hjust = 0, size = 3.5,
           label = c(sprintf("znany punkt: %.2f", kryt_znany), sprintf("supF: %.2f", kryt_sup)),
           colour = c("grey30", kol[["po"]])) +
  scale_x_continuous(breaks = seq(20, 100, 20), limits = c(18, 124)) +
  geom_vline(xintercept = 60.5, colour = kol[["przed"]], linewidth = 0.8) +
  geom_line(linewidth = 1) +
  annotate("point", x = 60, y = Fm[podzial == 60], size = 4, shape = 18, colour = kol[["przed"]]) +
  annotate("text", x = 62, y = Fm[podzial == 60], hjust = 0, size = 3.8,
           label = sprintf("reforma (podział po 60.): F = %.2f", Fm[podzial == 60])) +
  labs(title = "B. Statystyka Chowa przy każdym punkcie podziału", x = "Podział po obserwacji nr", y = "F Chowa") + motyw

p1 <- pA / pB + plot_layout(heights = c(1.2, 1))
p1
Wynik w R
     F_w_60 podzial_max       F_max  kryt_znany   kryt_supF
      23.62       58.00       25.35        3.07        5.78
        (Intercept) godz
przed         48.83 3.27
po            55.13 4.03
wspolny       52.55 3.52
Jak opisać w pracy
Na co uważać
- Punkt podziału musi być znany przed analizą. Wybranie go po obejrzeniu danych i testowanie w tym samym miejscu zawyża błąd I rodzaju. Gdy punkt jest nieznany, stosuje się testy Andrewsa (1993), których rozkład różni się od rozkładu przy znanym punkcie, albo regresję segmentową.
- Test zakłada równą wariancję składnika losowego w obu częściach. Jayatissa (1977) wskazuje, że przy różnych wariancjach i małych próbach jego wynik bywa mylący (zob. heterogeniczność wariancji).
- Istotny wynik nie mówi, czy zmieniła się stała, czy nachylenie. Rozdziel to, jak we wpisie Jak porównać regresje w dwóch grupach.
- W szeregach czasowych reszty bywają autokorelowane, a zmianę po interwencji lepiej modelować jako przerwany szereg czasowy.
Test Chowa w R
Kod liczy statystykę Chowa z sum kwadratów reszt modelu wspólnego i dwóch modeli osobnych, sprawdza ją porównaniem modeli funkcją anova(), powtarza test funkcją sctest() z pakietu strucchange (ten sam wynik: F = 23.62, p < .001) i pokazuje współczynniki modelu z interakcją.
Test Chowa przed reformą i po niej
R
# Test Chowa: czy ta sama regresja obowiązuje przed reformą i po niej? (dane symulowane)
set.seed(596)
n1 <- 60; n2 <- 60; k <- 2                         # k = liczba parametrów (stała i nachylenie)
godz <- runif(n1 + n2, 0, 10)                      # godziny nauki tygodniowo
po <- rep(0:1, c(n1, n2))                          # 0 = przed reformą, 1 = po reformie
wynik <- 50 + 3 * godz + po * (5 + 1.0 * godz) + rnorm(n1 + n2, sd = 8)
rss <- function(m) sum(resid(m)^2)
S_c <- rss(lm(wynik ~ godz))                       # model wspólny
S_1 <- rss(lm(wynik ~ godz, subset = po == 0))     # osobno przed reformą
S_2 <- rss(lm(wynik ~ godz, subset = po == 1))     # osobno po reformie
F <- ((S_c - (S_1 + S_2)) / k) / ((S_1 + S_2) / (n1 + n2 - 2 * k))
round(c(F = F, df1 = k, df2 = n1 + n2 - 2 * k,
        p = pf(F, k, n1 + n2 - 2 * k, lower.tail = FALSE)), 4)
# To samo: model wspólny vs model z pełną interakcją z grupą
anova(lm(wynik ~ godz), lm(wynik ~ godz * po))
round(coef(lm(wynik ~ godz * po)), 2)
# To samo funkcją sctest() z pakietu strucchange
strucchange::sctest(wynik ~ godz, type = "Chow", point = n1)
Wynik w R
       F      df1      df2        p
 23.6246   2.0000 116.0000   0.0000
Analysis of Variance Table

Model 1: wynik ~ godz
Model 2: wynik ~ godz * po
  Res.Df     RSS Df Sum of Sq      F    Pr(>F)
1    118 10376.6
2    116  7373.3  2    3003.3 23.625 2.473e-09 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
(Intercept)        godz          po     godz:po
      48.83        3.27        6.29        0.76

	Chow test

data:  wynik ~ godz
F = 23.625, p-value = 2.473e-09
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet strucchange). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- strucchange (wersja 1.6.0): Zeileis, A., Leisch, F., Hornik, K., & Kleiber, C. (2002). strucchange: An R package for testing for structural change in linear regression models. Journal of Statistical Software, 7(2), 1–38. https://doi.org/10.18637/jss.v007.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym test Chowa różni się od testu interakcji?
Test Chowa sprawdza łącznie wszystkie współczynniki: stałą i każde nachylenie. Test pojedynczej interakcji dotyczy tylko jednego nachylenia. Test Chowa to łączny test F wszystkich składników z udziałem zmiennej grupującej.
Czy test Chowa działa dla więcej niż dwóch grup?
Tak. Model wspólny porównuje się z osobnymi modelami dla każdej z g grup; stopnie swobody wynoszą wtedy k(g − 1) oraz n − gk. To samo daje model ze wszystkimi interakcjami z czynnikiem grupującym.
Co zrobić, gdy nie wiadomo, kiedy nastąpiła zmiana?
Klasyczny test Chowa wymaga punktu znanego z góry. Przy nieznanym punkcie stosuje się testy zmiany strukturalnej z nieznanym punktem (Andrews, 1993) albo regresję segmentową, która szacuje położenie załamania.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Andrews, D. W. K. (1993). Tests for parameter instability and structural change with unknown change point. Econometrica, 61(4), 821–856. https://doi.org/10.2307/2951764
- Chow, G. C. (1960). Tests of equality between sets of coefficients in two linear regressions. Econometrica, 28(3), 591. https://doi.org/10.2307/1910133
- Jayatissa, W. A. (1977). Tests of equality between sets of coefficients in two linear regressions when disturbance variances are unequal. Econometrica, 45(5), 1291. https://doi.org/10.2307/1914075
Cytowania BibTeX
@article{andrews1993tests, author={Andrews, Donald W. K.}, title={{Tests for parameter instability and structural change with unknown change point}}, journal={Econometrica}, year={1993}, volume={61}, number={4}, pages={821--856}, doi={10.2307/2951764}}@article{chow1960tests, author={Chow, Gregory C.}, title={{Tests of equality between sets of coefficients in two linear regressions}}, journal={Econometrica}, year={1960}, volume={28}, number={3}, pages={591}, doi={10.2307/1910133}}@article{jayatissa1977tests, author={Jayatissa, W. A.}, title={{Tests of equality between sets of coefficients in two linear regressions when disturbance variances are unequal}}, journal={Econometrica}, year={1977}, volume={45}, number={5}, pages={1291}, doi={10.2307/1914075}}