Dlaczego dwie osobne regresje nie wystarczą
Typowy rozdział wyników wygląda tak: regresja w grupie kobiet, regresja w grupie mężczyzn, a potem wniosek „wsparcie społeczne przewiduje satysfakcję z życia tylko u kobiet, bo tylko tam współczynnik jest istotny”. To rozumowanie nie zawiera żadnego testu różnicy między grupami. Gelman i Stern (2006) pokazują, że różnica między wynikiem „istotnym” i „nieistotnym” sama zwykle nie jest istotna statystycznie. Nieuwenhuis i in. (2011) przejrzeli 513 artykułów z czołowych czasopism neuronaukowych. Poprawną procedurę porównania dwóch efektów zastosowano w 78 z nich, a błędną, opartą na dwóch osobnych testach, w 79.
Pytanie „czy związek jest inny w dwóch grupach” to pytanie o moderację, w której moderatorem jest grupa. Odpowiada na nie interakcja grupa × predyktor w jednym modelu na całej próbie.
Przykład: wsparcie, stres i satysfakcja z życia
W badaniu 200 dorosłych (130 kobiet, 70 mężczyzn; dane symulowane) satysfakcję z życia (5–35) przewidywano stresem (0–40) i wsparciem społecznym (1–7). Predyktory wycentrowano na średniej całej próby (stres: M = 19.32, wsparcie: M = 4.87).
Krok 1 – osobne regresje. U kobiet wsparcie wiązało się z wyższą satysfakcją, b = 1.09, 95% CI [0.46, 1.72], p < .001. U mężczyzn związek był słabszy i nieistotny, b = 0.30, 95% CI [−0.86, 1.46], p = .604. Stres obniżał satysfakcję w obu grupach (b = −0.24 i −0.21). Na tym etapie wolno tylko opisać wyniki w grupach. Wniosku o różnicy jeszcze nie ma.
Krok 2 – jeden model z interakcjami. Do modelu na całej próbie wchodzą grupa, oba predyktory i ich iloczyny z grupą (satysfakcja ~ grupa * (stres_c + wsparcie_c)). Współczynnik interakcji to różnica nachyleń między grupami:
- wsparcie: różnica −0.78, 95% CI [−2.06, 0.49], t(194) = −1.21, p = .227;
- stres: różnica 0.04, 95% CI [−0.14, 0.21], p = .686.
Przedział ufności dla różnicy nachyleń wsparcia jest szeroki. Obejmuje i brak różnicy, i nachylenie u mężczyzn o dwa punkty mniejsze. Dane nie rozstrzygają więc, czy wsparcie działa inaczej u kobiet i mężczyzn (rysunek 1). Wniosek „tylko u kobiet” byłby nieuprawniony.
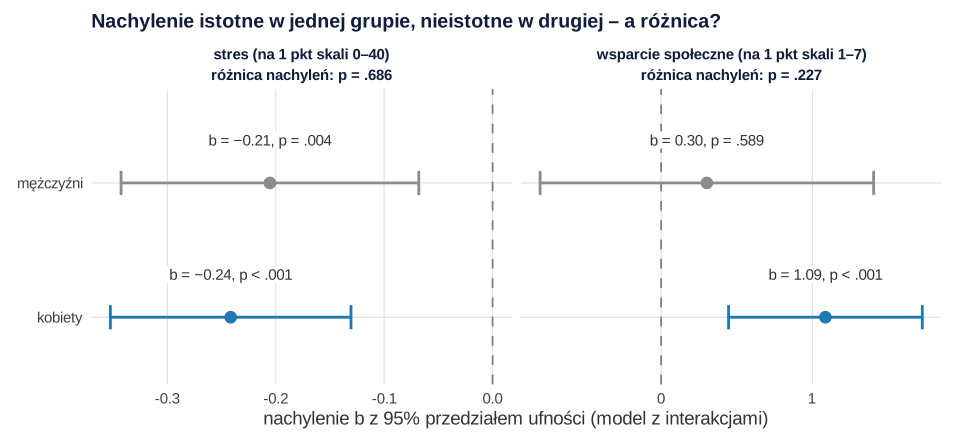
Krok 3 – nachylenia w grupach. Po teście interakcji możesz podać nachylenie w każdej grupie z przedziałem ufności, np. funkcją emtrends() z pakietu emmeans. To odpowiednik prostych nachyleń z poradnika analiza moderacji krok po kroku, gdzie omawiamy też moderator ciągły i przedział Johnsona–Neymana.
Test z dla dwóch współczynników i test Chowa
Jeśli masz tylko wyniki dwóch osobnych regresji, np. z dwóch artykułów, różnicę współczynników sprawdzisz testem z: z = (b1 − b2) / √(SE1² + SE2²). Paternoster i in. (1998) pokazują, że to jest poprawny wzór, a popularna wersja z innym błędem standardowym zbyt łatwo odrzuca hipotezę zerową. W przykładzie z = 1.19, p = .236, czyli prawie tyle samo co w modelu z interakcją. Test z dopuszcza różną wariancję reszt w grupach.
Test Chowa sprawdza naraz, czy różni się cały model: stała i wszystkie nachylenia. To porównanie modelu wspólnego z modelem z pełnymi interakcjami. W przykładzie dał F(3, 194) = 6.34, p < .001, ale wynik ten wynika głównie z różnicy poziomu. Przy przeciętnym stresie i wsparciu mężczyźni mieli satysfakcję niższą o 2.57 punktu, 95% CI [−3.80, −1.34]. Sam test obu nachyleń był nieistotny, F(2, 194) = 0.82, p = .444. Dlatego zawsze sprawdzaj osobno różnicę poziomu i różnicę nachyleń.
Na co uważać
- Porównuj b, a nie β ani R². W przykładzie R² wynosiło .188 u kobiet i .112 u mężczyzn, choć nachylenie stresu było prawie identyczne. Oba wskaźniki zależą od rozrzutu zmiennych w grupie. Więcej we wpisie współczynniki standaryzowane czy niestandaryzowane.
- Sprawdź wariancję reszt w grupach. Tutaj odchylenia standardowe reszt były podobne (4.09 i 4.33). Gdy wyraźnie się różnią, a grupy są nierówne, użyj odpornych błędów standardowych HC3. W przykładzie dały dla interakcji wsparcia p = .213.
- Zaplanuj liczebność. Brookes i in. (2004) pokazali, że badanie z mocą 80% dla efektu głównego ma tylko 29% mocy do wykrycia interakcji tej samej wielkości. Do takiej samej mocy potrzeba około czterech razy większej próby. Nieistotna interakcja w małej próbie to zwykle wynik nierozstrzygający (zob. analiza podgrup).
- Przy skalach latentnych sprawdź pomiar. Porównanie ścieżek w SEM ma sens dopiero przy równoważnym pomiarze w grupach; procedurę opisujemy w poradniku inwariancja pomiaru krok po kroku.
Gdy porównujesz same korelacje, a nie nachylenia, użyj testu opisanego we wpisie jak porównać dwie korelacje. Interakcje zmiennej kategorialnej z ciągłą w klasycznym ujęciu opisują Aiken i West (1991). W modelu z interakcjami grupę koduje się zmienną 0/1 (dummy coding), a predyktory ilościowe warto wycentrować, żeby współczynnik grupy opisywał różnicę przy przeciętnych wartościach predyktorów.
Jak to opisać w pracy
Wybór testu dla innych porównań grup ułatwia przewodnik po testach statystycznych. Jeśli promotor oczekuje osobnych regresji w grupach, możemy pomóc Ci uzasadnić model z interakcją w ramach analiz i konsultacji dla studentów.
Porównanie regresji w dwóch grupach w R
Kod odtwarza wszystkie liczby z tekstu i rysunku: osobne regresje w grupach, test z dla różnicy współczynników, model z interakcjami, test łączny (Chowa), test samych nachyleń, nachylenia w grupach z emmeans i błędy standardowe HC3.
Osobne modele, model z interakcjami i test Chowa
R
# B191 – porównanie regresji w dwóch grupach: osobne modele a jeden model z interakcją
# Dane symulowane: 200 osób dorosłych (130 kobiet, 70 mężczyzn); satysfakcja z życia (5–35),
# stres (0–40) i wsparcie społeczne (1–7).
suppressPackageStartupMessages({library(emmeans); library(sandwich); library(lmtest)})
set.seed(9)
nk <- 130; nm <- 70
grupa <- factor(rep(c("kobiety", "mężczyźni"), c(nk, nm)), levels = c("kobiety", "mężczyźni"))
stres <- round(pmin(40, pmax(0, rnorm(nk + nm, 20, 7))))
wsparcie <- round(pmin(7, pmax(1, rnorm(nk + nm, 4.8, 1.1))), 1)
b_wsp <- ifelse(grupa == "kobiety", 1.0, 0.6)
sat <- 22 - 0.25 * stres + b_wsp * wsparcie + rnorm(nk + nm, 0, 4.2)
dane <- data.frame(grupa, stres, wsparcie, satysfakcja = round(pmin(35, pmax(5, sat))))
# predyktory wycentrowane na średniej całej próby: współczynnik grupy = różnica przy przeciętnym stresie i wsparciu
dane$stres_c <- dane$stres - mean(dane$stres)
dane$wsparcie_c <- dane$wsparcie - mean(dane$wsparcie)
round(c(M_stres = mean(dane$stres), M_wsparcie = mean(dane$wsparcie)), 2)
table(dane$grupa)

# 1. Dwie osobne regresje – tak NIE testujemy różnicy, ale tak zwykle zaczyna się błąd
m_k <- lm(satysfakcja ~ stres_c + wsparcie_c, data = subset(dane, grupa == "kobiety"))
m_m <- lm(satysfakcja ~ stres_c + wsparcie_c, data = subset(dane, grupa == "mężczyźni"))
round(cbind(summary(m_k)$coefficients, confint(m_k)), 4)
round(cbind(summary(m_m)$coefficients, confint(m_m)), 4)
round(c(R2_kobiety = summary(m_k)$r.squared, R2_mezczyzni = summary(m_m)$r.squared,
        SD_reszt_k = sigma(m_k), SD_reszt_m = sigma(m_m)), 3)

# 2. Test z dla różnicy dwóch współczynników z osobnych modeli (Paternoster i in., 1998)
b1 <- coef(m_k)["wsparcie_c"]; b2 <- coef(m_m)["wsparcie_c"]
se1 <- sqrt(vcov(m_k)["wsparcie_c", "wsparcie_c"]); se2 <- sqrt(vcov(m_m)["wsparcie_c", "wsparcie_c"])
z <- (b1 - b2) / sqrt(se1^2 + se2^2)
round(c(roznica = unname(b1 - b2), z = unname(z), p = 2 * pnorm(-abs(unname(z)))), 3)

# 3. Jeden model z interakcjami: grupa × każdy predyktor
m_pelny <- lm(satysfakcja ~ grupa * (stres_c + wsparcie_c), data = dane)
round(cbind(summary(m_pelny)$coefficients, confint(m_pelny)), 3)

# 4. Test łączny (test Chowa): czy cały model – stała i oba nachylenia – różni się między grupami?
m_wspolny <- lm(satysfakcja ~ stres_c + wsparcie_c, data = dane)
anova(m_wspolny, m_pelny)
# ... i czy różnią się same nachylenia (stała może się różnić)?
m_stala <- lm(satysfakcja ~ grupa + stres_c + wsparcie_c, data = dane)
anova(m_stala, m_pelny)

# 5. Nachylenia w każdej grupie z 95% CI i ich różnica (emmeans)
tr <- emtrends(m_pelny, ~ grupa, var = "wsparcie_c")
summary(tr, infer = TRUE)
pairs(tr, infer = TRUE)
summary(emtrends(m_pelny, ~ grupa, var = "stres_c"), infer = TRUE)

# 6. Różna wariancja reszt w grupach? Błędy standardowe HC3 dla interakcji
round(coeftest(m_pelny, vcov = vcovHC(m_pelny, type = "HC3"))[5:6, ], 3)
Wynik w R
   M_stres M_wsparcie
     19.32       4.87

  kobiety mężczyźni
      130        70
            Estimate Std. Error t value Pr(>|t|)   2.5 %  97.5 %
(Intercept)  22.3925     0.3594 62.3103    0e+00 21.6814 23.1036
stres_c      -0.2416     0.0551 -4.3834    0e+00 -0.3507 -0.1325
wsparcie_c    1.0866     0.3181  3.4156    9e-04  0.4571  1.7161
            Estimate Std. Error t value Pr(>|t|)   2.5 %  97.5 %
(Intercept)  19.8247     0.5215 38.0181   0.0000 18.7839 20.8656
stres_c      -0.2054     0.0722 -2.8428   0.0059 -0.3496 -0.0612
wsparcie_c    0.3025     0.5803  0.5213   0.6039 -0.8557  1.4607
  R2_kobiety R2_mezczyzni   SD_reszt_k   SD_reszt_m
       0.188        0.112        4.086        4.328
roznica       z       p
  0.784   1.185   0.236
                          Estimate Std. Error t value Pr(>|t|)  2.5 % 97.5 %
(Intercept)                 22.393      0.367  61.036    0.000 21.669 23.116
grupamężczyźni              -2.568      0.622  -4.127    0.000 -3.795 -1.341
stres_c                     -0.242      0.056  -4.294    0.000 -0.353 -0.131
wsparcie_c                   1.087      0.325   3.346    0.001  0.446  1.727
grupamężczyźni:stres_c       0.036      0.090   0.405    0.686 -0.140  0.213
grupamężczyźni:wsparcie_c   -0.784      0.647  -1.213    0.227 -2.059  0.491
Analysis of Variance Table

Model 1: satysfakcja ~ stres_c + wsparcie_c
Model 2: satysfakcja ~ grupa * (stres_c + wsparcie_c)
  Res.Df    RSS Df Sum of Sq    F    Pr(>F)
1    197 3706.5
2    194 3375.6  3    330.95 6.34 0.0004017 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Analysis of Variance Table

Model 1: satysfakcja ~ grupa + stres_c + wsparcie_c
Model 2: satysfakcja ~ grupa * (stres_c + wsparcie_c)
  Res.Df    RSS Df Sum of Sq      F Pr(>F)
1    196 3403.9
2    194 3375.6  2    28.395 0.8159 0.4437
 grupa     wsparcie_c.trend    SE  df lower.CL upper.CL t.ratio p.value
 kobiety              1.087 0.325 194    0.446     1.73   3.346  0.0010
 mężczyźni            0.302 0.559 194   -0.800     1.41   0.541  0.5892

Confidence level used: 0.95
 contrast            estimate    SE  df lower.CL upper.CL t.ratio p.value
 kobiety - mężczyźni    0.784 0.647 194   -0.491     2.06   1.213  0.2268

Confidence level used: 0.95
 grupa     stres_c.trend     SE  df lower.CL upper.CL t.ratio p.value
 kobiety          -0.242 0.0563 194   -0.353  -0.1306  -4.294 <0.0001
 mężczyźni        -0.205 0.0696 194   -0.343  -0.0681  -2.950  0.0036

Confidence level used: 0.95
                          Estimate Std. Error t value Pr(>|t|)
grupamężczyźni:stres_c       0.036      0.090   0.401    0.689
grupamężczyźni:wsparcie_c   -0.784      0.627  -1.250    0.213
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm() i anova() z pakietu stats); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czy mogę porównać R² z regresji policzonych osobno w dwóch grupach?
Nie jako dowód, że związek jest inny. R² zależy od rozrzutu predyktorów i wyniku w każdej grupie. W przykładzie z tego wpisu wynosiło .188 u kobiet i .112 u mężczyzn, choć nachylenie stresu było w obu grupach prawie takie samo (−0.24 i −0.21). Różnice związków sprawdzaj testem interakcji grupa × predyktor.
Co to jest test Chowa i kiedy go użyć?
To test F, który sprawdza naraz, czy w dwóch grupach różnią się wszystkie współczynniki regresji: stała i nachylenia. Odpowiada porównaniu modelu wspólnego z modelem z pełnymi interakcjami z grupą. Bywa istotny tylko z powodu różnicy poziomu, dlatego różnicę samych nachyleń sprawdź osobnym testem.
Ile osób potrzeba, żeby wykryć różnicę nachyleń między grupami?
Zwykle kilka razy więcej niż do wykrycia samego związku. Brookes i in. (2004) pokazali, że badanie z mocą 80% dla efektu głównego ma tylko 29% mocy dla interakcji tej samej wielkości, a do takiej samej mocy potrzeba mniej więcej czterokrotnie większej próby.
Powiązane hasła
Przeczytaj też
Analiza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikJak porównać dwie korelacje?
Test z Fishera dla dwóch grup, test Williamsa dla korelacji z tej samej próby, przedział ufności różnicy i gotowy opis wyniku z kodem R.
Czytaj →PoradnikWspółczynniki standaryzowane czy niestandaryzowane?
Co mówi b, a co β, dlaczego β zależy od zakresu danych i proporcji grup, kiedy podać który współczynnik i jak opisać je w pracy – z przykładem w R.
Czytaj →Masz dwie regresje i nie wiesz, jak je porównać?
Zbudujemy model z interakcją, sprawdzimy różnice nachyleń i wyjaśnimy wynik tak, żebyś umiał(a) go opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. Sage.
- Brookes, S. T., Whitely, E., Egger, M., Davey Smith, G., Mulheran, P. A., & Peters, T. J. (2004). Subgroup analyses in randomized trials: Risks of subgroup-specific analyses; power and sample size for the interaction test. Journal of Clinical Epidemiology, 57(3), 229–236. https://doi.org/10.1016/j.jclinepi.2003.08.009
- Gelman, A., & Stern, H. (2006). The difference between “significant” and “not significant” is not itself statistically significant. The American Statistician, 60(4), 328–331. https://doi.org/10.1198/000313006x152649
- Nieuwenhuis, S., Forstmann, B. U., & Wagenmakers, E.-J. (2011). Erroneous analyses of interactions in neuroscience: A problem of significance. Nature Neuroscience, 14(9), 1105–1107. https://doi.org/10.1038/nn.2886
- Paternoster, R., Brame, R., Mazerolle, P., & Piquero, A. (1998). Using the correct statistical test for the equality of regression coefficients. Criminology, 36(4), 859–866. https://doi.org/10.1111/j.1745-9125.1998.tb01268.x
Cytowania BibTeX
@book{aiken1991multiple, author={Aiken, Leona S. and West, Stephen G.}, title={{Multiple regression: Testing and interpreting interactions}}, year={1991}, publisher={Sage}}@article{brookes2004subgroup, author={Brookes, Sara T. and Whitely, Elise and Egger, Matthias and Davey Smith, George and Mulheran, Paul A. and Peters, Tim J.}, title={{Subgroup analyses in randomized trials: Risks of subgroup-specific analyses; power and sample size for the interaction test}}, journal={Journal of Clinical Epidemiology}, year={2004}, volume={57}, number={3}, pages={229--236}, doi={10.1016/j.jclinepi.2003.08.009}}@article{gelman2006difference, author={Gelman, Andrew and Stern, Hal}, title={{The difference between “significant” and “not significant” is not itself statistically significant}}, journal={The American Statistician}, year={2006}, volume={60}, number={4}, pages={328--331}, doi={10.1198/000313006x152649}}@article{nieuwenhuis2011erroneous, author={Nieuwenhuis, Sander and Forstmann, Birte U. and Wagenmakers, Eric-Jan}, title={{Erroneous analyses of interactions in neuroscience: A problem of significance}}, journal={Nature Neuroscience}, year={2011}, volume={14}, number={9}, pages={1105--1107}, doi={10.1038/nn.2886}}@article{paternoster1998using, author={Paternoster, Raymond and Brame, Robert and Mazerolle, Paul and Piquero, Alex}, title={{Using the correct statistical test for the equality of regression coefficients}}, journal={Criminology}, year={1998}, volume={36}, number={4}, pages={859--866}, doi={10.1111/j.1745-9125.1998.tb01268.x}}