Kim jest David Donoho?
David L. Donoho to statystyk ze Stanford University, autor – w dużej części wspólnie z Iainem Johnstone’em – metod odszumiania sygnałów przez progowanie współczynników falkowych, jeden z twórców compressed sensing i autor głośnego eseju o historii i przyszłości nauki o danych. Pracę licencjacką pisał u Johna Tukeya, a doktorat u Petera Hubera (Leong, 2004).
Licencjat ze statystyki uzyskał w Princeton w 1978 r. (MacArthur Foundation, 1991). Potem pracował w laboratoriach firmy Western Geophysical w Houston nad przetwarzaniem sygnałów do poszukiwań ropy naftowej. Model liniowy miał tam tysiące niewiadomych, a dane były pełne obserwacji odstających. Donoho pokazał geofizykom regresję odporną i obraz podłoża od razu stał się wyraźniejszy. Z tej pracy wyrósł jego pierwszy artykuł – o ślepej dekonwolucji, czyli wyostrzaniu sygnału rozmytego w nieznany sposób (Leong, 2004).
Doktorat ze statystyki obronił w Harvardzie w 1984 r. (MacArthur Foundation, 1991). Zajmował się odpornością w wielu wymiarach: pokazał estymatory, które nie załamują się nawet wtedy, gdy 49% danych jest całkowicie zepsutych. Po stypendium w instytucie matematycznym MSRI w Berkeley, gdzie poznał Johnstone’a, pierwszą posadę akademicką dostał na wydziale statystyki Uniwersytetu Kalifornijskiego w Berkeley (Leong, 2004). W 1991 r. otrzymał stypendium Fundacji MacArthura (MacArthur Foundation, 1991), a w 2018 r. – Nagrodę Gaussa za matematyczną, statystyczną i obliczeniową analizę problemów przetwarzania sygnałów (International Mathematical Union, 2018).
Najważniejsze pomysły
- Odszumianie falkowe (1994). Sygnał rozkłada się na współczynniki falkowe, małe – zwykle sam szum – zeruje się lub ściąga ku zeru, a z pozostałych odtwarza sygnał. Donoho i Johnstone (1994) udowodnili, że takie progowanie oparte wyłącznie na danych traci względem idealnej „wyroczni”, która wie, które współczynniki zachować, najwyżej czynnik rzędu 2 log n – i że żadna metoda nie daje lepszej gwarancji.
- Rzadkość (sparsity). Lekcja z sejsmiki: odbicia w ziemi są zerowe przez większość czasu, a ta rzadkość pozwala rozwiązywać układy z większą liczbą niewiadomych niż równań. Do tego paradoksu Donoho wracał przez całą karierę (Leong, 2004).
- Compressed sensing (2006). Jeśli obraz lub sygnał ma rzadką reprezentację w znanej bazie (np. falkowej), do jego wiernego odtworzenia wystarcza znacznie mniej pomiarów liniowych niż pikseli, a rekonstrukcja sprowadza się do programowania liniowego (Donoho, 2006).
- Nauka o danych (2017). W eseju 50 Years of Data Science, opartym na wykładzie z 2015 r. na stulecie urodzin Tukeya, przypomniał, że Tukey już ponad pół wieku temu wzywał do poszerzenia statystyki o analizę danych, i zaproponował naukę, która empirycznie bada samą praktykę analizy danych (Donoho, 2017).
- Badania powtarzalne. Od sejsmologa Jona Claerbouta przejął zasadę publikowania danych i programów razem z artykułem (Leong, 2004).
Ciekawostka
Do statystyki trafił przez pracę dorywczą. Na pierwszym roku w Princeton szukał zajęcia, przy którym nauczy się programować, a biuro pośrednictwa skierowało go do wydziału statystyki – do analizy danych o zużyciu energii w domach. Wkrótce spędzał noce w sali komputerowej nazwanej imieniem Sama Wilksa, wśród dalekopisów i napędów taśmowych; użytkownicy urządzali tam czasem podwieczorek o trzeciej nad ranem. Programowanie na kartach perforowanych porównywał do sportów ekstremalnych (Leong, 2004).
W tej sali zbudował pakiet statystyczny ISP z narzędziami eksploracyjnej analizy danych Tukeya; Tukey, promotor jego pracy licencjackiej, zaproponował wcześniej funkcję wag „biweight”, którą Donoho zaprogramował w ISP. Jako student oglądał też film o systemie PRIM-9, którym Jerome Friedman i Tukey obracali w trzech wymiarach dziewięciowymiarowe dane z fizyki cząstek – wydział pokazywał go, by przyciągnąć studentów (Leong, 2004).
Przykład: odszumianie progowaniem falkowym
Dane są symulowane (set.seed(1994)): sygnał schodkowy z dziesięcioma skokami w dobranych przez nas miejscach, przeskalowany tak, by jego odchylenie standardowe było 7 razy większe niż szumu, plus szum normalny o σ = 1, razem n = 1024 = 2¹⁰ punktów. Transformatę Haara – najprostszą falkę: sumy i różnice sąsiednich par dzielone przez √2 – piszemy ręcznie w kilkunastu liniach. Daje ona 1023 współczynniki szczegółów na 10 poziomach i jest odwracalna.
Szum szacujemy z najdrobniejszego poziomu jako medianę wartości bezwzględnych podzieloną przez 0.6745: σ̂ = 0.968 (prawda: 1). Próg uniwersalny σ̂√(2 ln n) wynosi 3.603. Progowanie twarde zeruje współczynniki poniżej progu i zostawia resztę; zostaje 65 z 1023. Średni kwadrat błędu względem prawdziwego sygnału spada z 0.995 dla surowych danych do 0.100. Progowanie miękkie, które dodatkowo ściąga każdy współczynnik o próg, daje tu 0.871, bo zaniża duże skoki. Dla porównania liniowa średnia ruchoma o szerokości 3 daje 0.697, a szersze okna są coraz gorsze (0.828 dla 5 i 4.520 dla 33 punktów), bo rozmywają skoki.
Na rysunku
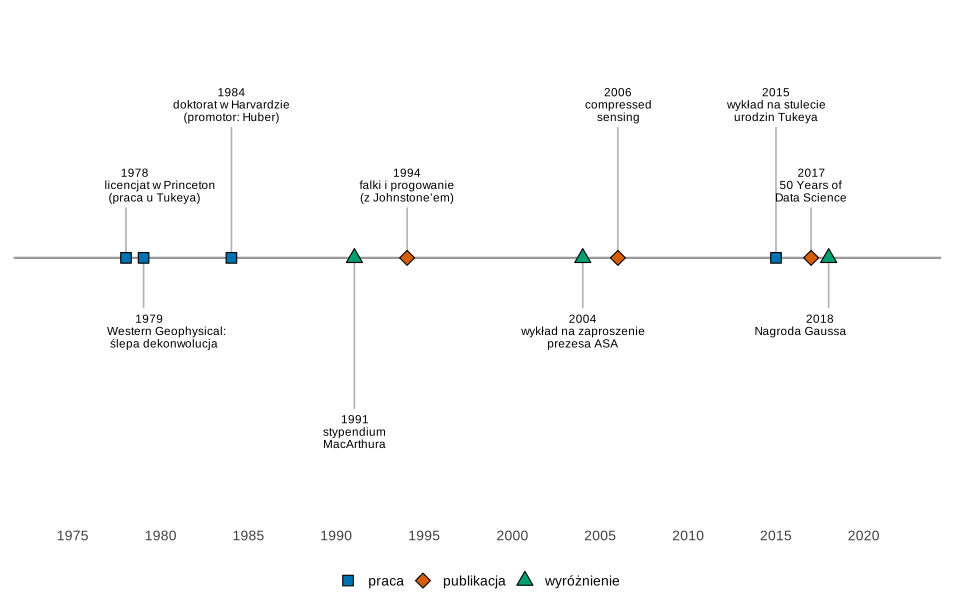
Co widać. Od statystyki odpornej przez falki do compressed sensing i nauki o danych.
Na co uważać. Oś pokazuje tylko zdarzenia z datą w cytowanych źródłach; przejście z Berkeley do Stanfordu nie ma tam daty, więc go nie zaznaczono.
Podpis do pracy:
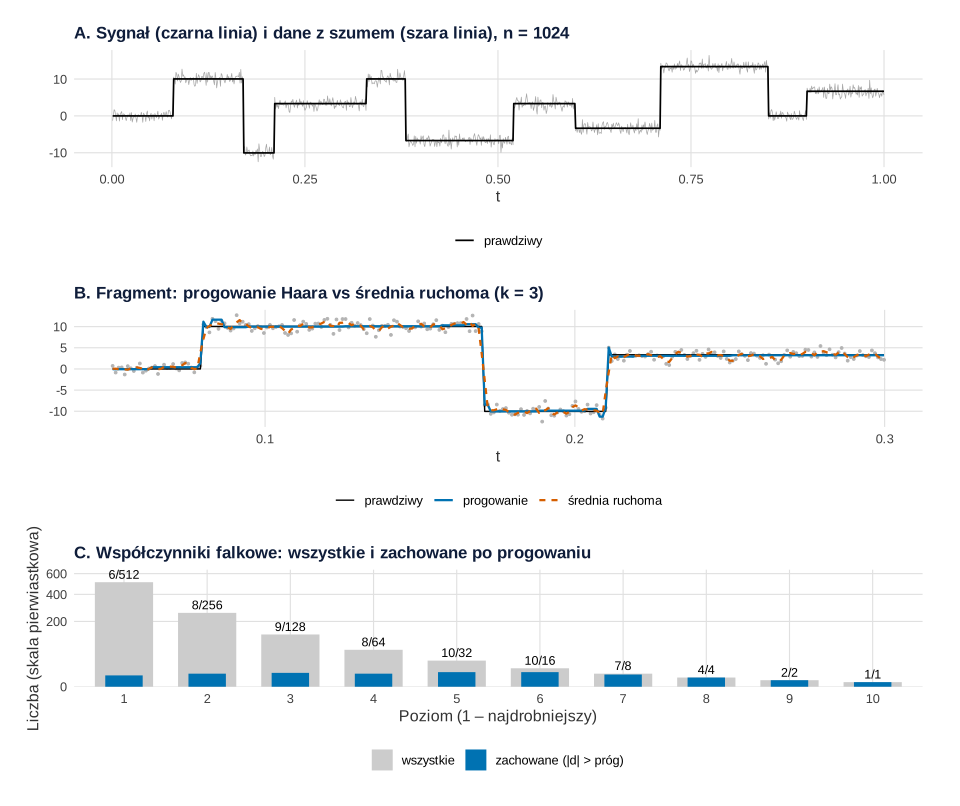
set.seed(1994), n = 1024, σ = 1). Obliczenia i rysunek: R, pakiety ggplot2 i patchwork.Co widać. Na najdrobniejszych poziomach, gdzie jest najwięcej współczynników, prawie wszystko to szum – zostaje 6 z 512. Na grubych poziomach zostaje niemal wszystko. Odtworzony sygnał trzyma ostre skoki, których średnia ruchoma nie odda: wygładza szum tylko kosztem rozmycia krawędzi.
Na co uważać. Falka Haara pasuje do sygnałów schodkowych; gładki sygnał odtworzyłaby „schodkami” i lepsza byłaby wtedy gładsza falka. Przy łagodnie zmieniającym się sygnale wygładzanie liniowe radzi sobie znacznie lepiej.
Podpis do pracy:
Gdzie spotkasz Donoho w swojej pracy
- Wygładzanie i szeregi czasowe. Gdy wygładzasz zaszumiony szereg czasowy albo sygnał fizjologiczny, falki z progowaniem są alternatywą dla średnich ruchomych i LOESS, szczególnie przy nagłych skokach.
- Rzadkość i regularyzacja. Myśl, że z wielu współczynników tylko nieliczne są duże, stoi też za lasso; progowanie miękkie z przykładu to dokładnie ta operacja, którą lasso wykonuje na pojedynczym współczynniku przy ortogonalnych predyktorach.
- Odporność. Jego początki to estymatory M i odporność na zanieczyszczenie danych – tradycja Hubera i Tukeya.
- Dyskusje o nauce o danych. Esej z 2017 r. jest często cytowanym głosem w sporze, czym data science różni się od statystyki – obok tekstów Williama Clevelanda i Leo Breimana.
Spory, mity i trudne strony
- Czy data science to po prostu statystyka? Donoho (2017) nie stawia znaku równości: obecne programy nauki o danych uważa za nadzbiór statystyki i uczenia maszynowego, uzupełniony o technologie „skalowania”, motywowany raczej komercyjnie niż intelektualnie. Prawdziwej rewolucji spodziewa się w naukowym badaniu samej analizy danych.
- „Nie daj się połknąć komputerowi”. Na początku kariery w Berkeley radzono mu, by porzucił programowanie i publikował teorię. Przekaz był jasny: zajmij się statystyką teoretyczną. Donoho podkreśla jednak, że praca w przemyśle dała mu drugi zestaw zainteresowań i sprawiła, że ma „dwie kariery”: w statystyce oraz w matematyce stosowanej i teorii informacji (Leong, 2004).
Progowanie falkowe w R
Kod symuluje sygnał schodkowy z szumem, liczy ręcznie transformatę Haara i jej odwrotność, szacuje szum, stosuje próg uniwersalny (progowanie twarde i miękkie), porównuje błąd ze średnimi ruchomymi i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Ziarno: set.seed(1994).
1. Odszumianie progowaniem współczynników Haara: rysunek 2
Kod R rysunku 2
# Odszumianie sygnału przez progowanie współczynników falkowych (transformata Haara ręcznie)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c("prawdziwy" = "black", "progowanie" = "#0072B2", "średnia ruchoma" = "#D55E00")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")

# Dane symulowane: sygnał schodkowy (wysokości i miejsca skoków dobrane przez nas) + szum N(0, 1)
n <- 1024; t <- (1:n) / n
skoki <- c(0.08, 0.17, 0.21, 0.33, 0.38, 0.52, 0.60, 0.71, 0.85, 0.90)
wys <- c(3, -6, 4, 2, -5, 3, -2, 5, -4, 2)   # zmiany poziomu w kolejnych skokach
f <- sapply(t, function(u) sum(wys[u >= skoki]))
f <- 7 * f / sd(f)                       # stosunek sygnału do szumu: sd(f) / sd(szumu) = 7
set.seed(1994)
y <- f + rnorm(n)

# Transformata Haara: na każdym poziomie sumy i różnice sąsiednich par dzielone przez √2
haar <- function(x) {
  szczegoly <- list(); s <- x
  while (length(s) > 1) {
    a <- s[c(TRUE, FALSE)]; b <- s[c(FALSE, TRUE)]
    szczegoly[[length(szczegoly) + 1]] <- (a - b) / sqrt(2)
    s <- (a + b) / sqrt(2)
  }
  list(s = s, d = szczegoly)             # d[[1]] – najdrobniejszy poziom (512 współczynników)
}
odwrotna <- function(w) {
  s <- w$s
  for (j in rev(seq_along(w$d))) {
    x <- numeric(2 * length(s))
    x[c(TRUE, FALSE)] <- (s + w$d[[j]]) / sqrt(2)
    x[c(FALSE, TRUE)] <- (s - w$d[[j]]) / sqrt(2)
    s <- x
  }
  s
}
w <- haar(y)
all.equal(odwrotna(w), y)                # transformata jest odwracalna

# Szum szacujemy z najdrobniejszego poziomu (MAD / 0.6745), próg uniwersalny = sigma · √(2 ln n)
sigma <- median(abs(w$d[[1]])) / 0.6745
lambda <- sigma * sqrt(2 * log(n))
round(c(sigma = sigma, prog = lambda), 3)
progowanie <- function(w, lambda, typ) {
  w$d <- lapply(w$d, function(d) if (typ == "twarde") d * (abs(d) > lambda) else sign(d) * pmax(abs(d) - lambda, 0))
  w
}
f_twarde <- odwrotna(progowanie(w, lambda, "twarde"))
f_miekkie <- odwrotna(progowanie(w, lambda, "miękkie"))
c(wspolczynniki = n - 1, zostaje = sum(abs(unlist(w$d)) > lambda))

# Dla porównania – liniowy wygładzacz: średnia ruchoma o szerokości k (końce szeregu bez zmian)
srednia_ruchoma <- function(x, k) {
  g <- stats::filter(x, rep(1 / k, k), sides = 2)
  ifelse(is.na(g), x, g)
}
mse <- function(g) mean((g - f)^2)
szer <- c(3, 5, 9, 17, 33)
round(c(surowe = mse(y), twarde = mse(f_twarde), miekkie = mse(f_miekkie),
        setNames(sapply(szer, function(k) mse(srednia_ruchoma(y, k))), paste0("ruchoma_", szer))), 3)

# Rysunek: A – sygnał i dane; B – fragment 0.05–0.30: progowanie twarde vs najlepsza z badanych średnich ruchomych;
# C – współczynniki falkowe i próg
k_naj <- szer[which.min(sapply(szer, function(k) mse(srednia_ruchoma(y, k))))]
k_naj
d <- data.frame(t, f, y, prog = f_twarde, ruch = srednia_ruchoma(y, k_naj))
pA <- ggplot(d, aes(t)) + geom_line(aes(y = y), linewidth = 0.25, colour = "grey65") +
  geom_line(aes(y = f, colour = "prawdziwy"), linewidth = 0.6) +
  scale_colour_manual(values = kol, name = NULL) +
  labs(title = "A. Sygnał (czarna linia) i dane z szumem (szara linia), n = 1024", x = "t", y = NULL) + motyw
fragment <- d[d$t >= 0.05 & d$t <= 0.30, ]
dB <- rbind(data.frame(t = fragment$t, g = fragment$prog, metoda = "progowanie"),
            data.frame(t = fragment$t, g = fragment$ruch, metoda = "średnia ruchoma"))
pB <- ggplot(fragment, aes(t)) + geom_point(aes(y = y), size = 0.6, colour = "grey70") +
  geom_line(aes(y = f, colour = "prawdziwy", linetype = "prawdziwy"), linewidth = 0.5) +
  geom_line(data = dB, aes(y = g, colour = metoda, linetype = metoda), linewidth = 0.8) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("prawdziwy" = "solid", "progowanie" = "solid", "średnia ruchoma" = "22"), name = NULL) +
  labs(title = paste0("B. Fragment: progowanie Haara vs średnia ruchoma (k = ", k_naj, ")"), x = "t", y = NULL) + motyw
poziomy <- data.frame(poziom = factor(seq_along(w$d)), wszystkie = lengths(w$d),
                      zachowane = sapply(w$d, function(x) sum(abs(x) > lambda)))
poziomy
pC <- ggplot(poziomy, aes(poziom)) +
  geom_col(aes(y = wszystkie, fill = "wszystkie"), width = 0.7) +
  geom_col(aes(y = zachowane, fill = "zachowane (|d| > próg)"), width = 0.45) +
  geom_text(aes(y = wszystkie, label = paste0(zachowane, "/", wszystkie)), vjust = -0.4, size = 3.3) +
  scale_fill_manual(values = c("wszystkie" = "grey80", "zachowane (|d| > próg)" = "#0072B2"), name = NULL) +
  scale_y_sqrt(expand = expansion(mult = c(0, 0.12))) +
  labs(title = "C. Współczynniki falkowe: wszystkie i zachowane po progowaniu", x = "Poziom (1 – najdrobniejszy)",
       y = "Liczba (skala pierwiastkowa)") +
  motyw
p2 <- (pA / pB / pC) + plot_layout(heights = c(1, 1, 1))
p2
Wynik w R
[1] TRUE
sigma  prog
0.968 3.603
wspolczynniki       zostaje
         1023            65
    surowe     twarde    miekkie  ruchoma_3  ruchoma_5  ruchoma_9 ruchoma_17
     0.995      0.100      0.871      0.697      0.828      1.311      2.326
ruchoma_33
     4.520
[1] 3
   poziom wszystkie zachowane
1       1       512         6
2       2       256         8
3       3       128         9
4       4        64         8
5       5        32        10
6       6        16        10
7       7         8         7
8       8         4         4
9       9         2         2
10     10         1         1
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: David L. Donoho – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1978, 1979, 1984, 1991, 1994, 2004, 2006, 2015, 2017, 2018),
  opis = c("licencjat w Princeton\n(praca u Tukeya)", "Western Geophysical:\nślepa dekonwolucja", "doktorat w Harvardzie\n(promotor: Huber)",
           "stypendium\nMacArthura", "falki i progowanie\n(z Johnstone’em)", "wykład na zaproszenie\nprezesa ASA",
           "compressed\nsensing", "wykład na stulecie\nurodzin Tukeya", "50 Years of\nData Science", "Nagroda Gaussa"),
  rodzaj = c("praca", "praca", "praca", "wyróżnienie", "publikacja", "wyróżnienie", "publikacja", "praca", "publikacja",
             "wyróżnienie"),
  poziom = c(0.5, -0.5, 1.3, -1.5, 0.5, -0.5, 1.3, 1.3, 0.5, -0.5),   # wysokość etykiety
  wyrownanie = c(0.2, 0.3, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.8))
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1974, 2022), breaks = seq(1975, 2020, by = 5)) +
  scale_y_continuous(limits = c(-2.4, 2.2)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie – rnorm(), średnia ruchoma – filter() z pakietu stats; transformata Haara napisana w kodzie; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim jest David Donoho?
Amerykańskim statystykiem ze Stanford University. Licencjat zrobił w Princeton w 1978 r. (pracę pisał u Johna Tukeya), doktorat w Harvardzie w 1984 r. u Petera Hubera, a pierwszą posadę akademicką dostał w Berkeley. Zajmuje się statystyką odporną, falkami, rzadkimi reprezentacjami sygnałów i compressed sensing; w 2018 r. otrzymał Nagrodę Gaussa.
Na czym polega odszumianie falkowe Donoho i Johnstone’a?
Sygnał rozkłada się na współczynniki falkowe, zeruje (progowanie twarde) albo ściąga ku zeru (progowanie miękkie) te mniejsze od progu, a z pozostałych odtwarza sygnał. Donoho i Johnstone (1994) pokazali, że taka metoda oparta tylko na danych jest bliska idealnej wyroczni, która wie, które współczynniki zachować.
Co to jest próg uniwersalny?
Próg σ√(2 ln n), gdzie σ to odchylenie standardowe szumu, a n liczba punktów. Szum zwykle szacuje się z najdrobniejszego poziomu współczynników jako medianę wartości bezwzględnych podzieloną przez 0.6745. W przykładzie z n = 1024 i σ̂ = 0.968 próg wyniósł 3.603 i zostawił 65 z 1023 współczynników.
Co Donoho napisał o data science?
W eseju „50 Years of Data Science” (2017), opartym na wykładzie z okazji stulecia urodzin Tukeya, przypomniał, że Tukey już w latach 60. wzywał do poszerzenia statystyki o analizę danych. Obecne programy data science uznał za nadzbiór statystyki i uczenia maszynowego motywowany głównie komercyjnie i zaproponował naukę badającą empirycznie samą praktykę analizy danych.
Powiązane hasła
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Donoho, D. (2017). 50 years of data science. Journal of Computational and Graphical Statistics, 26(4), 745–766. https://doi.org/10.1080/10618600.2017.1384734 ● Otwarty dostęp
- Donoho, D. L. (2006). Compressed sensing. IEEE Transactions on Information Theory, 52(4), 1289–1306. https://doi.org/10.1109/tit.2006.871582
- Donoho, D. L., & Johnstone, I. M. (1994). Ideal spatial adaptation by wavelet shrinkage. Biometrika, 81(3), 425–455. https://doi.org/10.1093/biomet/81.3.425
- International Mathematical Union. (2018). Carl Friedrich Gauss Prize 2018. IMU Awards. https://www.mathunion.org/imu-awards/carl-friedrich-gauss-prize/carl-friedrich-gauss-prize-2018 ● Otwarty dostęp
- Leong, Y. K. (2004). David Donoho: Sparse data, beautiful mine. Imprints: Newsletter of the Institute for Mathematical Sciences, National University of Singapore, 11–16. https://www.ocf.berkeley.edu/~lekheng/interviews/DavidDonoho.pdf ● Otwarty dostęp
- MacArthur Foundation. (1991). David Donoho: Class of 1991. MacArthur Fellows Program. https://www.macfound.org/fellows/class-of-1991/david-donoho ● Otwarty dostęp
Cytowania BibTeX
@article{donoho2017years, author={Donoho, David}, title={{50 years of data science}}, journal={Journal of Computational and Graphical Statistics}, year={2017}, volume={26}, number={4}, pages={745--766}, doi={10.1080/10618600.2017.1384734}}@article{donoho2006compressed, author={Donoho, David L.}, title={{Compressed sensing}}, journal={IEEE Transactions on Information Theory}, year={2006}, volume={52}, number={4}, pages={1289--1306}, doi={10.1109/tit.2006.871582}}@article{donoho1994ideal, author={Donoho, David L. and Johnstone, Iain M.}, title={{Ideal spatial adaptation by wavelet shrinkage}}, journal={Biometrika}, year={1994}, volume={81}, number={3}, pages={425--455}, doi={10.1093/biomet/81.3.425}}@misc{imu2018gauss, author={{International Mathematical Union}}, title={{Carl Friedrich Gauss Prize 2018}}, howpublished={IMU Awards}, year={2018}, publisher={International Mathematical Union}, url={https://www.mathunion.org/imu-awards/carl-friedrich-gauss-prize/carl-friedrich-gauss-prize-2018}}@article{leong2004donoho, author={Leong, Y. K.}, title={{David Donoho: Sparse data, beautiful mine}}, journal={Imprints: Newsletter of the Institute for Mathematical Sciences, National University of Singapore}, year={2004}, number={5}, pages={11--16}, publisher={Institute for Mathematical Sciences, National University of Singapore}, url={https://www.ocf.berkeley.edu/~lekheng/interviews/DavidDonoho.pdf}}@misc{macarthur1991donoho, author={{MacArthur Foundation}}, title={{David Donoho: Class of 1991}}, howpublished={MacArthur Fellows Program}, year={1991}, publisher={John D. and Catherine T. MacArthur Foundation}, url={https://www.macfound.org/fellows/class-of-1991/david-donoho}}