Kim był Leo Breiman?
Leo Breiman urodził się 27 stycznia 1928 r. w Nowym Jorku; gdy miał pięć lat, rodzina przeniosła się do Kalifornii. Fizykę skończył w Caltech (1949), magisterium z matematyki uzyskał na Uniwersytecie Columbia (1950), a doktorat z matematyki w Berkeley (1954) (Olshen, 2001). Potem uczył rachunku prawdopodobieństwa na UCLA i napisał podręcznik Probability Theory (1968) (Cutler, 2010).
Mimo stałej posady zrezygnował z pracy na UCLA i przez 13 lat był niezależnym konsultantem (Olshen, 2001). W 1980 r. przeszedł na Wydział Statystyki w Berkeley, gdzie założył uczelniane centrum obliczeń statystycznych. Na emeryturę przeszedł w 1993 r., ale nadal prowadził badania i doktorantów – z tego okresu pochodzą bagging i lasy losowe. Był członkiem Narodowej Akademii Nauk USA i Amerykańskiej Akademii Sztuk i Nauk. Zmarł 5 lipca 2005 r. w swoim domu w Berkeley, po długiej chorobie nowotworowej (UC Berkeley, 2005).
Najważniejsze pomysły
- Drzewa CART (1984). Z Jerome’em Friedmanem, Richardem Olshenem i Charlesem Stone’em napisał monografię Classification and Regression Trees (Breiman i in., 1984). Pomysł drzewa klasyfikacyjnego przyszedł mu do głowy przy zadaniu konsultingowym – rozpoznawaniu typów okrętów z profili radarowych; do przycinania drzew Breiman i Stone wprowadzili walidację krzyżową (Cutler, 2010). Więcej w haśle drzewo decyzyjne (CART).
- ACE (1985). Z Friedmanem opracował algorytm naprzemiennych warunkowych wartości oczekiwanych, który szuka przekształceń zmiennej zależnej i predyktorów dających najlepiej dopasowany model addytywny (Cutler, 2010).
- Bagging (1996). Nazwa to skrót od bootstrap aggregating: ten sam model dopasowuje się do wielu prób bootstrapowych, a prognozy uśrednia (w klasyfikacji – głosuje). Metoda stabilizuje procedury niestabilne, takie jak drzewa; około 37% obserwacji nie trafia do danej próby i może posłużyć do oceny błędu „poza workiem” (OOB) (Cutler, 2010).
- Lasy losowe (2001). W artykule „Random forests” Breiman (2001) dodał do baggingu losowanie zmiennych przy każdym podziale. Błąd lasu zależy od siły pojedynczych drzew i korelacji między nimi, a obserwacje OOB pozwalają mierzyć błąd i ważność zmiennych. Kod w Fortranie rozwijał z Adele Cutler (Cutler, 2010); to on jest podstawą pakietu R randomForest.
- „Dwie kultury” (2001). W „Statistical Science” Breiman (2001) opisał modelowanie danych i modelowanie algorytmiczne i przekonywał, że statystyka zbyt wyłącznie polega na pierwszym (szerzej w sekcji o sporach).
Ciekawostka
Breiman zrezygnował ze stałego etatu na UCLA po siedmiu latach pracy. Jak podaje uczelniane wspomnienie (UC Berkeley, 2005), przez pół roku żył z wypłaconych oszczędności emerytalnych i pisał podręcznik rachunku prawdopodobieństwa, a później zarabiał jako konsultant – prognozował m.in. ruch na autostradach Los Angeles, zatory w sądach i stężenie ozonu na następny dzień. Sam tłumaczył, że zmęczyła go teoria i chciał czegoś bardziej ekscytującego (Cutler, 2010).
Na urlopie naukowym pracował dla UNESCO w Liberii jako statystyk edukacyjny: miał policzyć dzieci w szkołach. Zorganizował 20 zespołów, które przemierzały kraj pieszo, odwiedzały wioski i liczyły dzieci (UC Berkeley, 2005). Był też przewodniczącym rady szkolnej w Santa Monica, zaprojektował własny dom i zajmował się rzeźbą (Olshen, 2001).
Przykład na danych z pakietu R
Zbiór ozone z pakietu gclus to – według pliku pomocy – dane o ozonie omawiane przez Breimana i Friedmana w artykule o algorytmie ACE (1985): 330 dni z 1976 r., pomiary z okolic Upland na wschód od Los Angeles. Przewidujemy stężenie ozonu z ośmiu zmiennych meteorologicznych (m.in. temperatury, wysokości i temperatury podstawy inwersji, wilgotności, widzialności, wiatru).
Pełne drzewo CART ma 26 liści, po przycięciu 9 (pierwszy podział: temperatura). Bagging (przy podziale wszystkie 8 zmiennych) i las losowy (2 losowe zmienne) mają po 500 drzew. Błąd OOB pojedynczego drzewa z próby bootstrapowej wynosi 29.88 w baggingu i 27.62 w lesie, po 10 drzewach – około 20.5, a po 500 drzewach – 17.58 i 16.25.
Uczciwe porównanie daje dopiero ta sama 10-krotna walidacja krzyżowa dla wszystkich modeli. Średni błąd średniokwadratowy wynosi: przycięte drzewo 21.70 (pierwiastek 4.66; 66.2% wariancji), regresja liniowa 20.58 (4.54; 67.9%), bagging 17.66 (4.20; 72.5%), las losowy 16.06 (4.01; 75.0%). Las był lepszy od drzewa we wszystkich 10 częściach.
Na rysunku
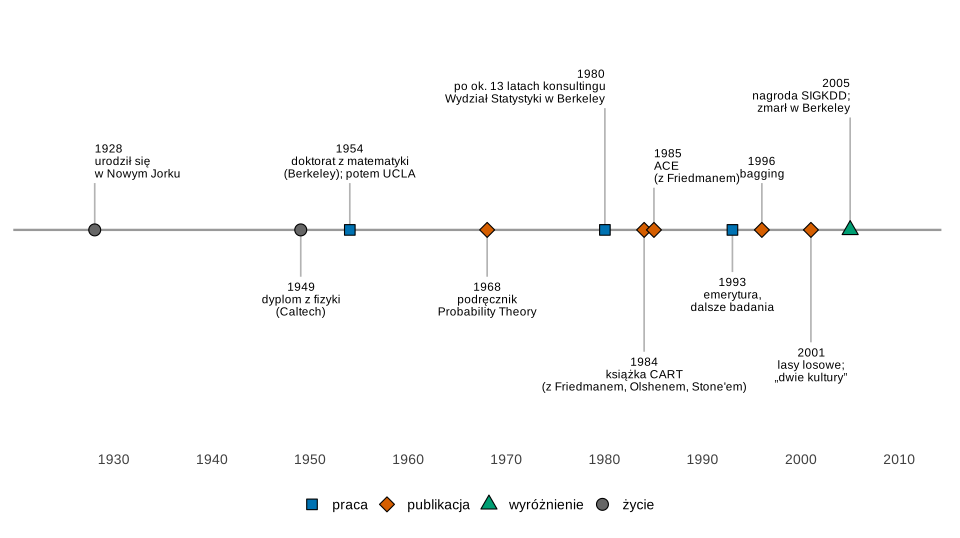
Co widać. Najważniejsze prace statystyczne Breiman ogłosił po pięćdziesiątce, a bagging i lasy losowe – już po przejściu na emeryturę.
Na co uważać. Źródła nie podają roku odejścia z UCLA ani roku wyboru do akademii, więc tych zdarzeń nie zaznaczamy; „13 lat konsultingu” to relacja z wywiadu (Olshen, 2001). Nagrodę SIGKDD za innowacje w eksploracji danych Breiman otrzymał pod koniec czerwca 2005 r., na kilka dni przed śmiercią (UC Berkeley, 2005).
Podpis do pracy:
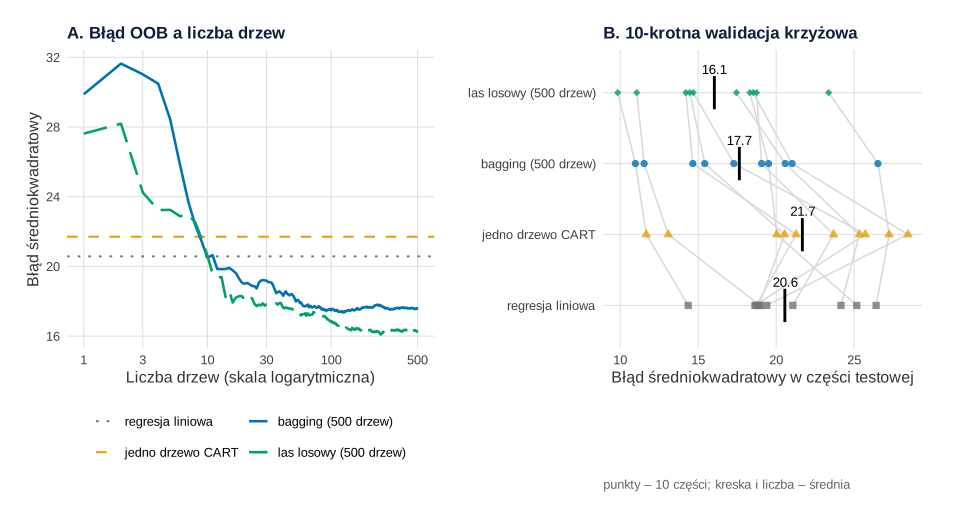
gclus::ozone, 330 dni 1976 r.). Obliczenia i rysunek: R (rpart, randomForest, ggplot2, patchwork); ziarna 927 i 9270.Co widać. Panel A pokazuje sedno baggingu: pojedyncze drzewo z próby bootstrapowej jest słabe (błąd około 28–30), ale uśrednienie kilkunastu takich drzew wystarcza, by pobić starannie przycięte drzewo i regresję liniową. Dalsze drzewa dają coraz mniej, ale ich przybywanie nie prowadzi do przeuczenia. Las losowy, dzięki losowaniu zmiennych, schodzi niżej niż bagging. Panel B potwierdza to na częściach testowych.
Na co uważać. Poziome linie w panelu A pochodzą z walidacji krzyżowej, a krzywe – z obserwacji OOB; to dwa różne, choć zbliżone sposoby szacowania błędu. Rozrzut między częściami (od około 10 do 28) przewyższa różnice między modelami – stąd wspólny podział.
Podpis do pracy:
Gdzie spotkasz Breimana w swojej pracy
Wszędzie tam, gdzie celem jest trafna prognoza. Na co zwracać uwagę:
- pojedyncze drzewo CART jest czytelne, ale niestabilne – mała zmiana danych potrafi przebudować podziały; las losowy płaci za stabilność utratą prostej reguły (szerzej we wpisie Drzewa decyzyjne i lasy losowe);
- błąd OOB jest wygodny, ale porównując las z innymi modelami, oceniaj wszystkie tą samą metodą, np. walidacją krzyżową na wspólnym podziale;
- do interpretacji lasu służą ważność permutacyjna i wykresy częściowej zależności; konkurencyjnym zespołem drzew jest gradient boosting, a w badaniach przyczynowych – lasy przyczynowe;
- bagging stoi na bootstrapie Bradleya Efrona, a pokrewne metody regularyzacji (lasso) i podręcznik uczenia statystycznego opisuje hasło o Robercie Tibshiranim i Trevorze Hastiem.
Spory, mity i trudne strony
- „Dwie kultury”. Breiman (2001) twierdził, że przywiązanie do modeli danych prowadzi do nieistotnej teorii i wątpliwych wniosków, a modelowanie algorytmiczne bywa dokładniejsze i bardziej pouczające także na małych zbiorach. Artykuł ukazał się z komentarzami innych statystyków i odpowiedzią autora; według Cutler (2010) to jedna z jego najczęściej czytanych prac.
- Czarna skrzynka. Zarzut, że las losowy niczego nie wyjaśnia, Breiman traktował poważnie: ważność zmiennych i bliskość obserwacji opisał w samej pracy o lasach (Breiman, 2001), a z Cutler budował narzędzia do ich wizualizacji (Cutler, 2010).
- Statystyk bez kursu statystyki. Według Cutler (2010) Breiman nie miał formalnego wykształcenia statystycznego – przyszedł z rachunku prawdopodobieństwa i z praktyki konsultingowej.
Drzewo, bagging i las losowy w R
Kod wczytuje dane o ozonie, dopasowuje i przycina drzewo CART, buduje bagging i las losowy, porównuje cztery modele tą samą 10-krotną walidacją krzyżową i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Ziarna (927 i 9270) ustalono raz, przed obliczeniami.
1. Drzewo, bagging i las losowy: rysunek 2
Kod R rysunku 2
# Leo Breiman: jedno drzewo CART vs bagging vs las losowy na danych o ozonie (gclus::ozone)
suppressPackageStartupMessages({library(rpart); library(randomForest); library(ggplot2); library(patchwork)})
kol <- c(drzewo = "#E69F00", bagging = "#0072B2", las = "#009E73", liniowa = "grey45")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(ozone, package = "gclus")
# 330 dni 1976 r. (Upland, na wschód od Los Angeles); Ozone – stężenie ozonu, 8 zmiennych meteorologicznych
dim(ozone)
round(sapply(ozone, function(x) c(srednia = mean(x), sd = sd(x))), 1)
p <- ncol(ozone) - 1                                   # liczba predyktorów

# 1. Jedno drzewo CART: pełne drzewo, potem przycięcie według walidacji krzyżowej (reguła minimum xerror)
set.seed(927)
pelne <- rpart(Ozone ~ ., data = ozone, control = rpart.control(cp = 0.001, xval = 10))
cp_min <- pelne$cptable[which.min(pelne$cptable[, "xerror"]), "CP"]
drzewo <- prune(pelne, cp = cp_min)
c(liscie_pelne = sum(pelne$frame$var == "<leaf>"), liscie_przyciete = sum(drzewo$frame$var == "<leaf>"))
drzewo$frame$var[1]                                    # zmienna pierwszego podziału

# 2. Bagging (mtry = p: każdy podział widzi wszystkie zmienne) i las losowy (mtry = p/3), po 500 drzew
set.seed(927)
bag <- randomForest(Ozone ~ ., data = ozone, mtry = p, ntree = 500)
set.seed(927)
las <- randomForest(Ozone ~ ., data = ozone, ntree = 500)
c(mtry_bagging = bag$mtry, mtry_las = las$mtry)
# błąd OOB (obserwacje spoza próby bootstrapowej danego drzewa) po 1, 10, 50, 100 i 500 drzewach
round(rbind(bagging = bag$mse[c(1, 10, 50, 100, 500)], las = las$mse[c(1, 10, 50, 100, 500)]), 2)

# 3. Uczciwe porównanie: ta sama 10-krotna walidacja krzyżowa dla czterech modeli
set.seed(9270)
fold <- sample(rep(1:10, length.out = nrow(ozone)))
cv <- do.call(rbind, lapply(1:10, function(k) {
  ucz <- ozone[fold != k, ]; test <- ozone[fold == k, ]
  pe <- rpart(Ozone ~ ., data = ucz, control = rpart.control(cp = 0.001, xval = 10))
  dr <- prune(pe, cp = pe$cptable[which.min(pe$cptable[, "xerror"]), "CP"])
  prog <- list(liniowa = predict(lm(Ozone ~ ., data = ucz), test),
               drzewo = predict(dr, test),
               bagging = predict(randomForest(Ozone ~ ., data = ucz, mtry = p, ntree = 500), test),
               las = predict(randomForest(Ozone ~ ., data = ucz, ntree = 500), test))
  data.frame(fold = k, model = names(prog), mse = sapply(prog, function(y) mean((test$Ozone - y)^2)))
}))
wynik_cv <- aggregate(mse ~ model, data = cv, FUN = mean)
wynik_cv$rmse <- sqrt(wynik_cv$mse)
wynik_cv$r2 <- 1 - wynik_cv$mse / var(ozone$Ozone)
wynik_cv <- wynik_cv[order(wynik_cv$mse, decreasing = TRUE), ]
print(transform(wynik_cv, mse = round(mse, 2), rmse = round(rmse, 2), r2 = round(r2, 3)), row.names = FALSE)
# w ilu z 10 części las ma mniejszy błąd niż jedno drzewo
c(las_lepszy_od_drzewa = sum(cv$mse[cv$model == "las"] < cv$mse[cv$model == "drzewo"]))

# Rysunek: A – błąd OOB a liczba drzew; B – błąd z walidacji krzyżowej w 10 częściach
oob <- rbind(data.frame(drzewa = 1:500, mse = bag$mse, model = "bagging"),
             data.frame(drzewa = 1:500, mse = las$mse, model = "las"))
poziomy <- c("liniowa", "drzewo", "bagging", "las")
etyk <- c(liniowa = "regresja liniowa", drzewo = "jedno drzewo CART", bagging = "bagging (500 drzew)",
          las = "las losowy (500 drzew)")
odn <- data.frame(model = c("drzewo", "liniowa"), mse = wynik_cv$mse[match(c("drzewo", "liniowa"), wynik_cv$model)])
pA <- ggplot(oob, aes(drzewa, mse, colour = model, linetype = model)) +
  geom_hline(data = odn, aes(yintercept = mse, colour = model, linetype = model), linewidth = 0.7) +
  geom_line(linewidth = 0.9) +
  scale_x_log10(breaks = c(1, 3, 10, 30, 100, 500)) +
  scale_colour_manual(values = kol, labels = etyk, breaks = poziomy, name = NULL) +
  scale_linetype_manual(values = c(liniowa = "dotted", drzewo = "dashed", bagging = "solid", las = "longdash"),
                        labels = etyk, breaks = poziomy, name = NULL) +
  labs(title = "A. Błąd OOB a liczba drzew", x = "Liczba drzew (skala logarytmiczna)",
       y = "Błąd średniokwadratowy") +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  motyw
cv$model <- factor(cv$model, levels = poziomy, labels = etyk[poziomy])
cv <- cv[order(cv$fold, cv$model), ]                  # linie łączą wyniki tej samej części
sr <- aggregate(mse ~ model, data = cv, FUN = mean)
pB <- ggplot(cv, aes(mse, model)) +
  geom_path(aes(group = fold), colour = "grey85") +
  geom_point(aes(shape = model, colour = model), size = 2.2, alpha = 0.8) +
  geom_point(data = sr, shape = 124, size = 9, colour = "black") +
  geom_text(data = sr, aes(label = sprintf("%.1f", mse)), nudge_y = 0.33, size = 3.5) +
  scale_colour_manual(values = setNames(kol[poziomy], etyk[poziomy]), guide = "none") +
  scale_shape_manual(values = c(15, 17, 16, 18), guide = "none") +
  labs(title = "B. 10-krotna walidacja krzyżowa", x = "Błąd średniokwadratowy w części testowej",
       y = NULL, caption = "punkty – 10 części; kreska i liczba – średnia") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.15, 1))
p2
Wynik w R
[1] 330   9
        Ozone Temp  InvHt Pres   Vis    Hgt  Hum InvTmp Wind
srednia  11.8 61.8 2572.9 17.4 124.5 5750.5 58.1   61.0  4.8
sd        8.0 14.5 1803.9 35.7  79.4  105.7 19.9   13.8  2.1
    liscie_pelne liscie_przyciete
              26                9
[1] "Temp"
mtry_bagging     mtry_las
           8            2
         [,1]  [,2]  [,3]  [,4]  [,5]
bagging 29.88 20.50 18.26 17.48 17.58
las     27.62 20.61 17.53 16.85 16.25
   model   mse rmse    r2
  drzewo 21.70 4.66 0.662
 liniowa 20.58 4.54 0.679
 bagging 17.66 4.20 0.725
     las 16.06 4.01 0.750
las_lepszy_od_drzewa
                  10
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Leo Breiman (1928–2005) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1928, 1949, 1954, 1968, 1980, 1984, 1985, 1993, 1996, 2001, 2005),
  opis = c("urodził się\nw Nowym Jorku", "dyplom z fizyki\n(Caltech)", "doktorat z matematyki\n(Berkeley); potem UCLA",
           "podręcznik\nProbability Theory", "po ok. 13 latach konsultingu\nWydział Statystyki w Berkeley",
           "książka CART\n(z Friedmanem, Olshenem, Stone'em)", "ACE\n(z Friedmanem)", "emerytura,\ndalsze badania",
           "bagging", "lasy losowe;\n„dwie kultury”", "nagroda SIGKDD;\nzmarł w Berkeley"),
  rodzaj = c("życie", "życie", "praca", "publikacja", "praca", "publikacja", "publikacja", "praca",
             "publikacja", "publikacja", "wyróżnienie"),
  poziom = c(0.5, -0.5, 0.5, -0.5, 1.3, -1.3, 0.45, -0.45, 0.5, -1.2, 1.2),   # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0, 0.5, 0.5, 0.5, 1, 0.5, 0, 0.5, 0.5, 0.5, 1))           # rozsunięcie bliskich etykiet
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1924, 2010), breaks = seq(1930, 2010, by = 10)) +
  scale_y_continuous(limits = c(-2.1, 2.1)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (drzewo – funkcje rpart() i prune() z pakietu rpart; bagging i las – randomForest() z pakietu randomForest; regresja liniowa – lm() z pakietu stats; dane – pakiet gclus; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- rpart (wersja 4.1.24): Therneau, T., & Atkinson, B. (2025). rpart: Recursive partitioning and regression trees [R package]. https://doi.org/10.32614/CRAN.package.rpart
- randomForest (wersja 4.7-1.2): Liaw, A., & Wiener, M. (2002). Classification and regression by randomForest. R News, 2(3), 18–22. https://CRAN.R-project.org/doc/Rnews/
- gclus (wersja 1.3.3): Hurley, C. (2025). gclus: Clustering graphics [R package]. https://doi.org/10.32614/CRAN.package.gclus
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Leo Breiman?
Amerykańskim probabilistą i statystykiem (1928–2005). Studiował fizykę w Caltech i matematykę w Columbii, doktorat zrobił w Berkeley (1954). Uczył rachunku prawdopodobieństwa na UCLA, potem przez kilkanaście lat był niezależnym konsultantem, a w 1980 r. przeszedł na Wydział Statystyki w Berkeley. Jest współautorem drzew CART i twórcą baggingu oraz lasów losowych.
Czym bagging różni się od lasu losowego Breimana?
W obu metodach każde drzewo uczy się na innej próbie bootstrapowej, a prognozy się uśrednia. W baggingu każde drzewo przy każdym podziale wybiera spośród wszystkich zmiennych, więc drzewa są do siebie podobne. W lesie losowym przy każdym podziale losuje się tylko część zmiennych, co zmniejsza korelację między drzewami i zwykle obniża błąd. W przykładzie z danymi o ozonie błąd z walidacji krzyżowej spadł z 17.66 (bagging) do 16.06 (las).
O co chodzi w artykule Breimana o dwóch kulturach modelowania?
W artykule z 2001 r. Breiman przeciwstawił dwie postawy: modelowanie danych, w którym zakłada się konkretny stochastyczny model ich powstawania, i modelowanie algorytmiczne, w którym mechanizm danych traktuje się jako nieznany, a ocenia się trafność prognoz. Uważał, że statystycy zbyt wyłącznie przywiązali się do pierwszej postawy, i namawiał do szerszego zestawu narzędzi. Artykuł ukazał się z komentarzami innych statystyków i odpowiedzią autora.
Czy las losowy zawsze jest lepszy od jednego drzewa decyzyjnego?
Zwykle prognozuje dokładniej, ale traci czytelność pojedynczego drzewa. Na danych o ozonie z 1976 r. las losowy miał mniejszy błąd od przyciętego drzewa CART we wszystkich 10 częściach walidacji krzyżowej (średnio 16.06 wobec 21.70), a samo drzewo przegrało nawet ze zwykłą regresją liniową (20.58). Gdy celem jest prosta reguła do opisania w pracy, drzewo bywa nadal lepszym wyborem.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Breiman, L. (2001). Random forests. Machine Learning, 45(1), 5–32. https://doi.org/10.1023/a:1010933404324 ● Otwarty dostęp: pełny tekst
- Breiman, L. (2001). Statistical modeling: The two cultures (with comments and a rejoinder by the author). Statistical Science, 16(3), 199–231. https://doi.org/10.1214/ss/1009213726
- Breiman, L., Friedman, J. H., Olshen, R. A., & Stone, C. J. (1984). Classification and regression trees. Wadsworth International Group.
- Cutler, A. (2010). Remembering Leo Breiman. The Annals of Applied Statistics, 4(4), 1621–1633. https://doi.org/10.1214/10-aoas427 ● Otwarty dostęp
- Olshen, R. (2001). A conversation with Leo Breiman. Statistical Science, 16(2), 184–198. https://doi.org/10.1214/ss/1009213290 ● Otwarty dostęp
- UC Berkeley. (2005). Leo Breiman, professor emeritus of statistics, has died at 77. UC Berkeley News. https://newsarchive.berkeley.edu/news/media/releases/2005/07/07_breiman.shtml ● Otwarty dostęp
Cytowania BibTeX
@article{breiman2001random, author={Breiman, Leo}, title={{Random forests}}, journal={Machine Learning}, year={2001}, volume={45}, number={1}, pages={5--32}, doi={10.1023/a:1010933404324}}@article{breiman2001statistical, author={Breiman, Leo}, title={{Statistical modeling: The two cultures (with comments and a rejoinder by the author)}}, journal={Statistical Science}, year={2001}, volume={16}, number={3}, pages={199--231}, doi={10.1214/ss/1009213726}}@book{breiman1984classification, author={Breiman, Leo and Friedman, Jerome H. and Olshen, Richard A. and Stone, Charles J.}, title={{Classification and regression trees}}, year={1984}, publisher={Wadsworth International Group}}@article{cutler2010remembering, author={Cutler, Adele}, title={{Remembering Leo Breiman}}, journal={The Annals of Applied Statistics}, year={2010}, volume={4}, number={4}, pages={1621--1633}, doi={10.1214/10-aoas427}}@article{olshen2001conversation, author={Olshen, Richard}, title={{A conversation with Leo Breiman}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={184--198}, doi={10.1214/ss/1009213290}}@misc{ucberkeley2005breiman, author={{UC Berkeley}}, title={{Leo Breiman, professor emeritus of statistics, has died at 77}}, howpublished={UC Berkeley News}, year={2005}, publisher={University of California, Berkeley}, url={https://newsarchive.berkeley.edu/news/media/releases/2005/07/07_breiman.shtml}}