Kim są Robert Tibshirani i Trevor Hastie?
Robert Tibshirani studiował matematykę i informatykę na Uniwersytecie Waterloo; statystykę odkrył na czwartym roku i w 1979 r. uzyskał dyplom ze statystyki i informatyki. W 1980 r. zrobił magisterium ze statystyki na Uniwersytecie Torontońskim, w 1981 r. zaczął studia doktoranckie w Stanford, a w 1984 r. obronił doktorat pod kierunkiem Bradleya Efrona. W latach 1985–1998 uczył na Uniwersytecie Torontońskim, a w 1998 r. wrócił do Stanford, przyciągnięty – jak mówi – siłą tamtejszej statystyki i szkoły medycznej (Oliver, 2018).
Trevor Hastie urodził się w 1953 r. w Republice Południowej Afryki. Statystykę skończył na Rhodes University (1976), od 1977 r. pracował w południowoafrykańskiej Medical Research Council, a magisterium zrobił na Uniwersytecie Kapsztadzkim. W 1980 r. zaczął doktorat w Stanford i obronił go w 1984 r. Po roku w RPA przeszedł w 1986 r. do grupy badań statystycznych AT&T Bell Laboratories, a w 1994 r. wrócił do Stanford jako profesor statystyki i biostatystyki (Statistics Views, 2016).
Najważniejsze pomysły
- Uogólnione modele addytywne (1986, 1990). Hastie i Tibshirani (1986) zastąpili liniową kombinację predyktorów w modelach opartych na wiarygodności – takich jak regresja logistyczna czy model przeżycia – sumą gładkich funkcji, szacowanych wygładzaczem w iteracyjnym algorytmie local scoring. Metoda miała ujawniać nieliniowe efekty predyktorów bez „detektywistycznej” pracy statystyka. Rozwinęli ją w monografii Generalized Additive Models (Hastie i Tibshirani, 1990).
- Lasso (1996). Tibshirani (1996) zaproponował estymację, która minimalizuje sumę kwadratów reszt przy ograniczeniu sumy wartości bezwzględnych współczynników. Ograniczenie ustawia część współczynników dokładnie na zero, więc model jest zarazem ściągnięty i łatwy do odczytania; w symulacjach lasso łączyło zalety doboru podzbioru zmiennych i regresji grzbietowej. Sam Tibshirani zalicza lasso do prac, z których jest najbardziej dumny (Oliver, 2018).
- Uczenie statystyczne. Z Jerome’em Friedmanem napisali podręcznik The Elements of Statistical Learning (Hastie i in., 2009) – według Tibshiraniego ich pracę o największym wpływie (Oliver, 2018).
- Oprogramowanie. Hastie jest autorem pakietu R gam, opartego – jak podaje opis pakietu – na rozdziale o modelach addytywnych w Statistical Models in S i na książce z 1990 r. Lasso i elastic net liczy się zwykle pakietem glmnet tych samych autorów z Friedmanem.
Ciekawostka
Najbardziej znany podręcznik obu autorów można legalnie przeczytać za darmo: na stronie Trevora Hastiego autorzy udostępniają PDF drugiego wydania The Elements of Statistical Learning (poprawiony 12. dodruk ze stycznia 2017 r.), choć książka jest w sprzedaży jako tom serii Springer Series in Statistics (Hastie i in., 2009).
Ich współpraca zaczęła się jeszcze na studiach. Hastie opowiadał, że w 1983 r. jako doktoranci założyli w Stanford bezpłatną poradnię statystyczną, a Tibshiraniego wymienia na pierwszym miejscu wśród osób, które na niego wpłynęły. Do statystyki trafił – jak mówi – trochę przypadkiem, a gdyby nie ona, mógłby zostać hydraulikiem, bo uwielbia instalacje przy remontach domu (Statistics Views, 2016). Tibshirani z kolei przyznał, że mógł zostać lekarzem (Oliver, 2018).
Przykład na danych z pakietu R
Zbiór kyphosis z pakietu gam – według pliku pomocy „klasyczny przykład dla GAM” z książki Hastiego i Tibshiraniego (1990) – opisuje 81 dzieci po operacji kręgosłupa (laminektomii). U 17 po operacji stwierdzono kifozę (skrzywienie). Predyktory to wiek w miesiącach (1–206), liczba operowanych kręgów i numer pierwszego operowanego kręgu (1–18).
W zwykłej regresji logistycznej wyraźny jest tylko numer pierwszego kręgu (b = −0.21, p = .002): im niżej zaczyna się operacja, tym mniejsze ryzyko. Wiek ma p = .090. Model GAM z gładkimi funkcjami wieku i numeru kręgu (po 4 stopnie swobody) zmniejsza dewiancję z 61.38 do 46.19 kosztem 6 stopni swobody: χ²(6) = 15.19, p = .019; AIC spada z 69.38 do 66.19. Testy nieliniowości dla każdej funkcji osobno są słabsze (χ²(3) = 6.21, p = .102 dla wieku i χ²(3) = 6.02, p = .111 dla kręgu).
Zmienia się też opis wieku. Dla dziecka z 4 operowanymi kręgami i początkiem na 13. kręgu regresja logistyczna przewiduje ryzyko rosnące stale od .04 (1 miesiąc) do .30 (206 miesięcy). GAM daje krzywą z garbem: .01 przy 1 miesiącu, .39 przy 100 miesiącach i znów .02 przy 206 miesiącach.
Na rysunku
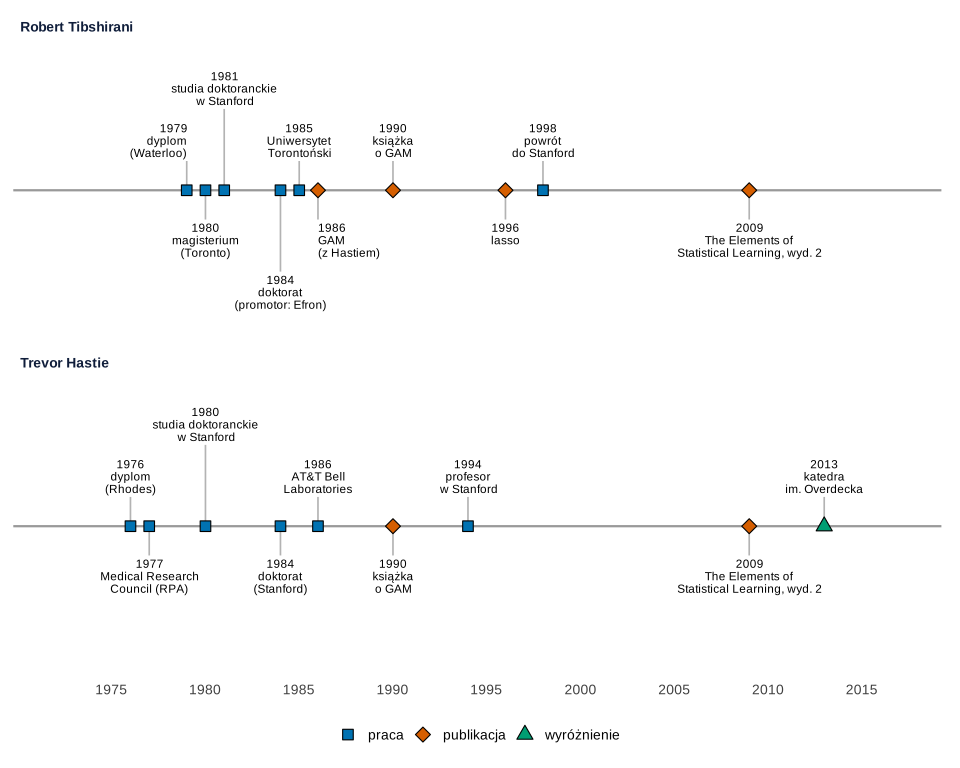
Co widać. Drogi obu autorów biegną równolegle: doktoraty w Stanford w tym samym roku, wspólna praca o GAM w 1986 r., potem rozejście (Toronto i Bell Labs) i ponowne spotkanie w Stanford w latach 90.
Na co uważać. Daty pochodzą z wywiadów, a nie z urzędowych życiorysów; roku urodzenia Tibshiraniego żadne z cytowanych źródeł nie podaje, więc go nie zaznaczamy. Na osi jest drugie wydanie The Elements of Statistical Learning (2009), które cytujemy.
Podpis do pracy:
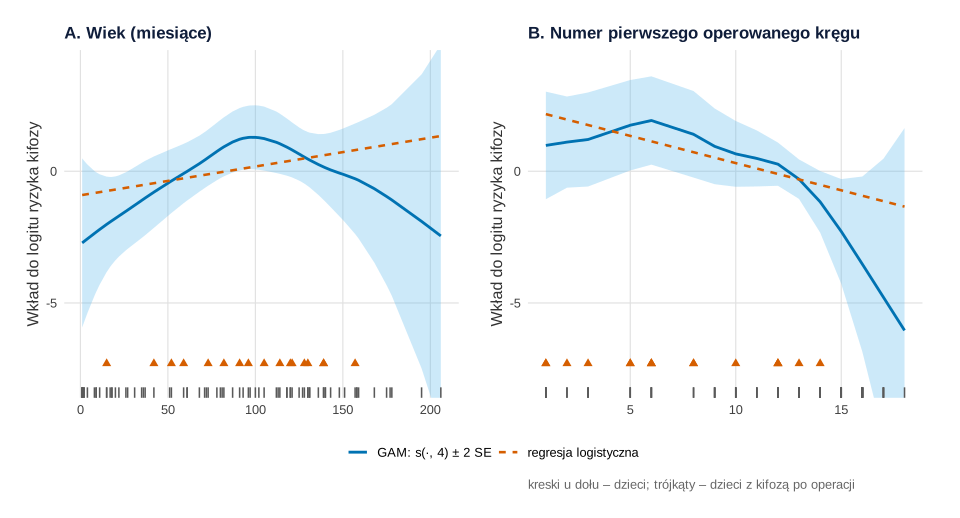
gam::kyphosis (81 dzieci). Obliczenia i rysunek: R, pakiety gam, ggplot2 i patchwork (bez losowania).Co widać. Każdy panel to „wkład” jednej zmiennej do logitu ryzyka przy pozostałych ustalonych. Prosta z regresji logistycznej musi być monotoniczna, a krzywa GAM pokazuje, że ryzyko jest największe u dzieci w wieku około 8 lat, a dla numeru kręgu długo się nie zmienia i spada dopiero przy operacjach zaczynanych nisko na kręgosłupie.
Na co uważać. Przypadków kifozy jest tylko 17 (trójkąty), więc pasma ufności na krańcach są bardzo szerokie, a nieliniowość każdej funkcji osobno nie jest istotna. Kształt krzywej to hipoteza do sprawdzenia.
Podpis do pracy:
Gdzie spotkasz Tibshiraniego i Hastiego w swojej pracy
Przy każdym modelu, w którym zmiennych jest dużo albo zależności nie są liniowe. Na co zwracać uwagę:
- gdy predyktorów jest wiele, a obserwacji mało, sięgnij po lasso lub elastic net i dobierz siłę kary walidacją krzyżową; dobór zmiennych lasso nie jest dowodem ich ważności;
- gdy podejrzewasz krzywoliniowość, GAM jest elastyczniejszą alternatywą dla wielomianów i pokrewnych wygładzaczy LOESS; porównuj modele dewiancją i AIC, pamiętając o ryzyku przeuczenia;
- GAM rozszerza uogólnione modele liniowe Neldera i Wedderburna, a metody zespołowe z ich podręcznika – lasy losowe i bagging – opisuje hasło o Leo Breimanie.
Spory, mity i trudne strony
- Wnioskowanie po selekcji. Lasso wybiera zmienne na podstawie tych samych danych, na których potem liczymy błędy standardowe; zwykłe p i przedziały ufności dla wybranych zmiennych są wtedy zbyt optymistyczne. Tibshirani w ostatnich latach zajmuje się właśnie wnioskowaniem po selekcji modelu, które daje poprawne wartości p i przedziały ufności (Oliver, 2018).
- Jeden GAM czy wiele? Nazwa GAM obejmuje dziś różne metody estymacji. Pakiet gam Hastiego realizuje podejście z książki z 1990 r. (backfitting), a inne pakiety, np. mgcv, dobierają gładkość automatycznie; wyniki, w tym wartości p, mogą się różnić. W pracy podaj pakiet i sposób wyboru stopni swobody.
- „Uczenie maszynowe to nie statystyka”. Podręcznik Hastiego, Tibshiraniego i Friedmana (Hastie i in., 2009) przeczy temu podziałowi: metody predykcyjne opisuje językiem statystyki, z obciążeniem, wariancją i walidacją.
Model GAM w R
Kod wczytuje dane kyphosis, dopasowuje regresję logistyczną i model GAM z pakietu gam, porównuje je dewiancją, AIC i testem ilorazu wiarygodności, liczy przewidywane ryzyko dla kilku wartości wieku i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje.
1. GAM vs regresja logistyczna: rysunek 2
Kod R rysunku 2
# Hastie i Tibshirani: uogólniony model addytywny (GAM) vs regresja logistyczna na danych kyphosis (pakiet gam)
suppressPackageStartupMessages({library(gam); library(ggplot2); library(patchwork)})
kol <- c(gam = "#0072B2", liniowy = "#D55E00", pasmo = "#56B4E9")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(kyphosis, package = "gam")
# 81 dzieci po operacji kręgosłupa; Kyphosis – czy po operacji wystąpiła kifoza (absent/present);
# Age – wiek w miesiącach, Number – liczba kręgów objętych operacją, Start – numer pierwszego operowanego kręgu
dim(kyphosis)
table(kyphosis$Kyphosis)
sapply(kyphosis[, c("Age", "Number", "Start")], range)

# 1. Regresja logistyczna: liniowy wpływ każdej zmiennej na logit
m_lin <- glm(Kyphosis ~ Age + Number + Start, family = binomial, data = kyphosis)
round(summary(m_lin)$coefficients, 4)

# 2. GAM: gładkie funkcje wieku i miejsca operacji (splajny wygładzające, 4 stopnie swobody), Number liniowo
m_gam <- gam(Kyphosis ~ s(Age, 4) + Number + s(Start, 4), family = binomial, data = kyphosis)
summary(m_gam)$anova                                   # test nieliniowości każdej gładkiej funkcji

# 3. Porównanie: dewiancja, AIC i test ilorazu wiarygodności (przybliżony – stopnie swobody GAM są efektywne)
porown <- data.frame(model = c("logistyczny liniowy", "GAM"),
                     dewiancja = c(deviance(m_lin), deviance(m_gam)),
                     df_reszt = c(df.residual(m_lin), df.residual(m_gam)),
                     AIC = c(AIC(m_lin), AIC(m_gam)))
print(transform(porown, dewiancja = round(dewiancja, 2), df_reszt = round(df_reszt, 1), AIC = round(AIC, 2)),
      row.names = FALSE)
anova(m_lin, m_gam, test = "Chisq")

# 4. Przewidywane ryzyko kifozy w funkcji wieku (Number i Start na medianach)
siatka <- data.frame(Age = c(1, 24, 60, 100, 150, 206), Number = median(kyphosis$Number),
                     Start = median(kyphosis$Start))
siatka$p_gam <- predict(m_gam, siatka, type = "response")
siatka$p_lin <- predict(m_lin, siatka, type = "response")
round(siatka, 3)

# Rysunek: funkcje cząstkowe (wkład do logitu) dla Age i Start – GAM z pasmem ±2 SE vs prosta z modelu liniowego
# (wartości w punktach danych – dla nowych danych pakiet gam nie liczy błędów standardowych)
tg <- predict(m_gam, type = "terms", se.fit = TRUE)
tl <- predict(m_lin, type = "terms")
czastkowa <- function(zm) {
  k <- grep(zm, colnames(tg$fit))
  out <- data.frame(x = kyphosis[[zm]], zmienna = zm, gam = tg$fit[, k], se = tg$se.fit[, k], liniowy = tl[, zm])
  out[order(out$x), ]
}
d <- rbind(czastkowa("Age"), czastkowa("Start"))
rugi <- rbind(data.frame(x = kyphosis$Age, zmienna = "Age", kifoza = kyphosis$Kyphosis),
              data.frame(x = kyphosis$Start, zmienna = "Start", kifoza = kyphosis$Kyphosis))
tytuly <- c(Age = "A. Wiek (miesiące)", Start = "B. Numer pierwszego operowanego kręgu")
rysuj <- function(zm) {
  ggplot(d[d$zmienna == zm, ], aes(x)) +
    geom_ribbon(aes(ymin = gam - 2 * se, ymax = gam + 2 * se), fill = kol[["pasmo"]], alpha = 0.3) +
    geom_line(aes(y = gam, colour = "GAM: s(·, 4) ± 2 SE", linetype = "GAM: s(·, 4) ± 2 SE"), linewidth = 1) +
    geom_line(aes(y = liniowy, colour = "regresja logistyczna", linetype = "regresja logistyczna"), linewidth = 0.9) +
    geom_rug(data = rugi[rugi$zmienna == zm, ], aes(x = x), sides = "b",
             colour = "grey35", length = unit(0.03, "npc")) +
    geom_point(data = rugi[rugi$zmienna == zm & rugi$kifoza == "present", ], aes(x = x, y = -7.3),
               shape = 17, size = 2, colour = kol[["liniowy"]], inherit.aes = FALSE) +
    coord_cartesian(ylim = c(-8, 4)) +
    scale_colour_manual(values = c(kol[["gam"]], kol[["liniowy"]]), name = NULL) +
    scale_linetype_manual(values = c("solid", "22"), name = NULL) +
    labs(title = tytuly[[zm]], x = NULL, y = "Wkład do logitu ryzyka kifozy",
         caption = if (zm == "Start") "kreski u dołu – dzieci; trójkąty – dzieci z kifozą po operacji" else NULL) +
    motyw
}
p2 <- (rysuj("Age") + rysuj("Start")) + plot_layout(guides = "collect") &
  theme(legend.position = "bottom")
p2
Wynik w R
[1] 81  4

 absent present
     64      17
     Age Number Start
[1,]   1      2     1
[2,] 206     10    18
            Estimate Std. Error z value Pr(>|z|)
(Intercept)  -2.0369     1.4496 -1.4052   0.1600
Age           0.0109     0.0064  1.6956   0.0900
Number        0.4106     0.2249  1.8260   0.0678
Start        -0.2065     0.0677 -3.0504   0.0023
Anova for Nonparametric Effects
            Npar Df Npar Chisq P(Chi)
(Intercept)
s(Age, 4)         3     6.2111 0.1018
Number
s(Start, 4)       3     6.0217 0.1106
               model dewiancja df_reszt   AIC
 logistyczny liniowy     61.38       77 69.38
                 GAM     46.19       71 66.19
Analysis of Deviance Table

Model 1: Kyphosis ~ Age + Number + Start
Model 2: Kyphosis ~ s(Age, 4) + Number + s(Start, 4)
  Resid. Df Resid. Dev     Df Deviance Pr(>Chi)
1        77     61.380
2        71     46.193 6.0001   15.187  0.01885 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
  Age Number Start p_gam p_lin
1   1      4    13 0.011 0.044
2  24      4    13 0.034 0.056
3  60      4    13 0.144 0.081
4 100      4    13 0.390 0.121
5 150      4    13 0.136 0.192
6 206      4    13 0.015 0.304
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Robert Tibshirani i Trevor Hastie (ur. 1953) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1979, 1980, 1981, 1984, 1985, 1986, 1990, 1996, 1998, 2009,
          1976, 1977, 1980, 1984, 1986, 1990, 1994, 2009, 2013),
  osoba = c(rep("Robert Tibshirani", 10), rep("Trevor Hastie", 9)),
  opis = c("dyplom\n(Waterloo)", "magisterium\n(Toronto)", "studia doktoranckie\nw Stanford", "doktorat\n(promotor: Efron)",
           "Uniwersytet\nTorontoński", "GAM\n(z Hastiem)", "książka\no GAM", "lasso", "powrót\ndo Stanford",
           "The Elements of\nStatistical Learning, wyd. 2",
           "dyplom\n(Rhodes)", "Medical Research\nCouncil (RPA)", "studia doktoranckie\nw Stanford", "doktorat\n(Stanford)",
           "AT&T Bell\nLaboratories", "książka\no GAM", "profesor\nw Stanford", "The Elements of\nStatistical Learning, wyd. 2",
           "katedra\nim. Overdecka"),
  rodzaj = c("praca", "praca", "praca", "praca", "praca", "publikacja", "publikacja", "publikacja", "praca", "publikacja",
             "praca", "praca", "praca", "praca", "praca", "publikacja", "praca", "publikacja", "wyróżnienie"),
  poziom = c(0.45, -0.45, 1.25, -1.25, 0.45, -0.45, 0.45, -0.45, 0.45, -0.45,
             0.45, -0.45, 1.25, -0.45, 0.45, -0.45, 0.45, -0.45, 0.45),    # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(1, 0.5, 0.5, 0.5, 0.5, 0, 0.5, 0.5, 0.5, 0.5,
                 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5))          # rozsunięcie bliskich etykiet
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
zdarzenia$osoba <- factor(zdarzenia$osoba, levels = c("Robert Tibshirani", "Trevor Hastie"))
ksztalty <- c("praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  facet_wrap(~ osoba, ncol = 1) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1972, 2017), breaks = seq(1975, 2015, by = 5)) +
  scale_y_continuous(limits = c(-2.1, 2.1)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        strip.text = element_text(face = "bold", hjust = 0), legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (GAM – funkcja gam() z pakietu gam; regresja logistyczna i test ilorazu wiarygodności – glm() i anova() z pakietu stats; dane – pakiet gam; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- gam (wersja 1.22-7): Hastie, T. (2025). gam: Generalized additive models [R package]. https://doi.org/10.32614/CRAN.package.gam
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim są Robert Tibshirani i Trevor Hastie?
To statystycy z Uniwersytetu Stanforda. Tibshirani studiował w Waterloo i Toronto, doktorat zrobił w Stanford w 1984 r. u Bradleya Efrona, w latach 1985–1998 uczył na Uniwersytecie Torontońskim. Hastie (ur. 1953 w RPA) studiował na Rhodes University i w Kapsztadzie, doktorat zrobił w Stanford w 1984 r., potem pracował w AT&T Bell Laboratories, a od 1994 r. jest profesorem w Stanford.
Kiedy zamiast regresji logistycznej użyć modelu GAM?
Gdy podejrzewasz, że wpływ predyktora ciągłego na logit nie jest liniowy, np. ryzyko rośnie, a potem spada. GAM zastępuje prostą gładką funkcją i pozwala to sprawdzić. W danych o kifozie po operacji kręgosłupa GAM obniżył dewiancję z 61.38 do 46.19 kosztem około 6 stopni swobody (p = .019), a przewidywane ryzyko w funkcji wieku miało szczyt około 100. miesiąca życia zamiast stałego wzrostu.
Czy książka The Elements of Statistical Learning jest dostępna za darmo?
Tak – na stronie Trevora Hastiego można pobrać PDF drugiego wydania (poprawiony 12. dodruk ze stycznia 2017 r.) udostępniony przez autorów. Wydanie drukowane ukazało się w 2009 r. w serii Springer Series in Statistics.
Kto wymyślił lasso i do czego ono służy?
Robert Tibshirani w artykule z 1996 r. w „Journal of the Royal Statistical Society, Series B”. Lasso minimalizuje sumę kwadratów reszt przy ograniczeniu sumy wartości bezwzględnych współczynników; część z nich spada wtedy dokładnie do zera, więc metoda jednocześnie ściąga oszacowania i wybiera zmienne.
Powiązane hasła
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hastie, T. J., & Tibshirani, R. J. (1990). Generalized additive models. Chapman and Hall.
- Hastie, T., & Tibshirani, R. (1986). Generalized additive models. Statistical Science, 1(3), 297–310. https://doi.org/10.1214/ss/1177013604 ● Otwarty dostęp
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7 ● Otwarty dostęp: pełny tekst
- Oliver, A. (2018). “I want to help scientists understand things better”: An interview with Robert Tibshirani. Statistics Views. https://www.statisticsviews.com/article/i-want-to-help-scientists-understand-things-better-an-interview-with-robert-tibshirani/ ● Otwarty dostęp
- Statistics Views. (2016). “It’s just serendipity that I ended up in statistics”: An interview with Trevor Hastie. https://www.statisticsviews.com/article/its-just-serendipity-that-i-ended-up-in-statistics-an-interview-with-trevor-hastie/ ● Otwarty dostęp
- Tibshirani, R. (1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267–288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
Cytowania BibTeX
@book{hastie1990generalized, author={Hastie, Trevor J. and Tibshirani, Robert J.}, title={{Generalized additive models}}, year={1990}, publisher={Chapman and Hall}}@article{hastie1986generalized, author={Hastie, Trevor and Tibshirani, Robert}, title={{Generalized additive models}}, journal={Statistical Science}, year={1986}, volume={1}, number={3}, pages={297--310}, doi={10.1214/ss/1177013604}}@book{hastie2009elements, author={Hastie, Trevor and Tibshirani, Robert and Friedman, Jerome}, title={{The elements of statistical learning: Data mining, inference, and prediction}}, year={2009}, edition={2nd}, publisher={Springer}, doi={10.1007/978-0-387-84858-7}}@misc{oliver2018tibshirani, author={Oliver, Alison}, title={{“I want to help scientists understand things better”: An interview with Robert Tibshirani}}, howpublished={Statistics Views}, year={2018}, publisher={Wiley}, url={https://www.statisticsviews.com/article/i-want-to-help-scientists-understand-things-better-an-interview-with-robert-tibshirani/}}@misc{statisticsviews2016hastie, author={{Statistics Views}}, title={{“It’s just serendipity that I ended up in statistics”: An interview with Trevor Hastie}}, howpublished={Statistics Views}, year={2016}, publisher={Wiley}, url={https://www.statisticsviews.com/article/its-just-serendipity-that-i-ended-up-in-statistics-an-interview-with-trevor-hastie/}}@article{tibshirani1996regression, author={Tibshirani, Robert}, title={{Regression shrinkage and selection via the lasso}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1996}, volume={58}, number={1}, pages={267--288}, doi={10.1111/j.2517-6161.1996.tb02080.x}}