Co to jest elastic net?
Elastic net (ang. elastic net, czasem „sieć elastyczna”) to regresja z karą łączącą karę lasso (suma wartości bezwzględnych współczynników) i karę grzbietową (suma ich kwadratów). Każdą z kar osobno omawia hasło regresja grzbietowa i LASSO. W parametryzacji pakietu glmnet minimalizuje się średnią kwadratów reszt plus λ·[(1 − α)/2·Σβ² + α·Σ|β|]: α = 1 to lasso, α = 0 – regresja grzbietowa, wartości pośrednie dają elastic net. Zou i Hastie (2005), którzy zaproponowali metodę, pokazali, że często przewyższa lasso przy podobnie oszczędnym modelu, że silnie skorelowane predyktory wchodzą do niego lub wypadają razem (efekt grupowania) i że sprawdza się, gdy predyktorów jest dużo więcej niż obserwacji. Friedman, Hastie i Tibshirani (2010) opisali algorytm stosowany w glmnet także dla regresji logistycznej i wielomianowej.
Kiedy wybrać elastic net
Lasso z grupy silnie skorelowanych zmiennych zwykle wybiera jedną lub kilka, a pozostałe zeruje. Regresja grzbietowa zachowuje wszystkie. Elastic net to kompromis, przydatny przy współliniowości i przy wielu predyktorach. Oba parametry, λ i α, dobiera się walidacją krzyżową, aby ograniczyć przeuczenie.
Przykład
W symulowanych danych 50 osób i 100 predyktorów wynik zależał tylko od pięciu silnie skorelowanych zmiennych (r ≈ .90). Przy tych samych podziałach 10-krotnej walidacji lasso zachowało 3 predyktory, elastic net (α = 0.5) – 4, a regresja grzbietowa wszystkie 100; każdy predyktor wybrany przez lasso i elastic net należał do właściwej piątki. Na 1000 nowych obserwacjach średni błąd kwadratowy wyniósł 5.15 dla lasso, 5.32 dla elastic net i 7.33 dla regresji grzbietowej. Elastic net zachował więcej zmiennych z grupy, ale prognozował nieco gorzej niż lasso – przewaga nie jest regułą.
Na rysunku
Efekt grupowania widać na ścieżkach współczynników (dane i podziały walidacji z przykładu). Ścieżki regresji grzbietowej i lasso przy słabiej skorelowanych predyktorach pokazuje hasło regresja grzbietowa i LASSO.
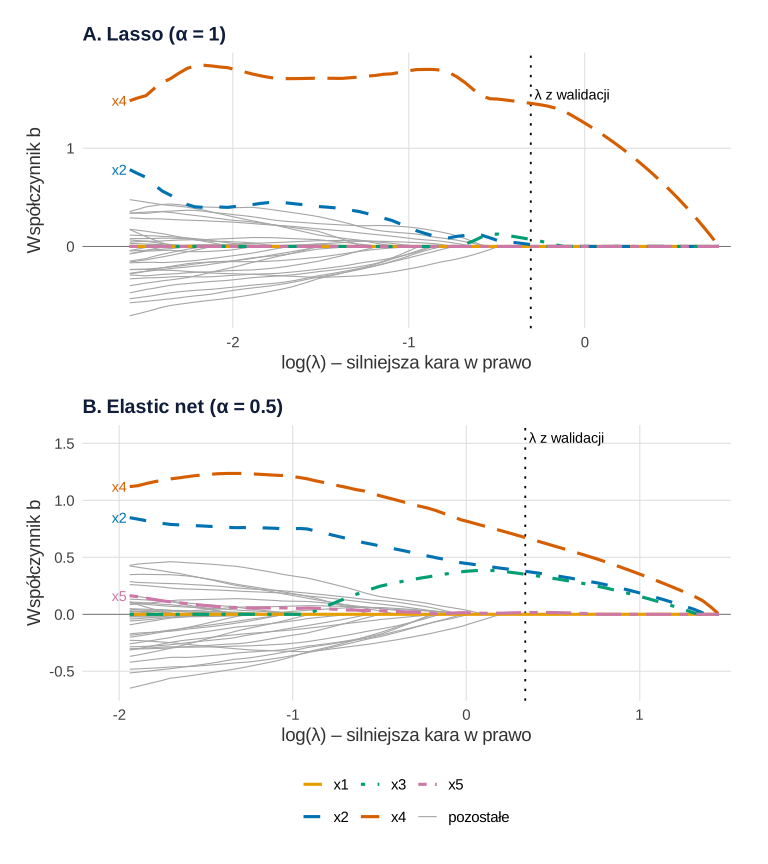
Co widać. Patrz od prawej, od najsilniejszej kary. Lasso (A) wpuszcza najpierw tylko x4 (przy log λ = 0.72), a x2 i x3 dopiero przy −0.26 i −0.17, tuż obok λ z walidacji. Przy tej wartości prawie cały efekt grupy przypada na x4: b = 1.458, podczas gdy x2 i x3 mają 0.019 i 0.071. Elastic net (B) wpuszcza x4, x2 i x3 niemal jednocześnie (log λ od 1.32 do 1.41) i dzieli między nie efekt: 0.673, 0.377 i 0.351, a x5 dostaje 0.015. W obu modelach przy λ z walidacji nie ma żadnego z 95 zbędnych predyktorów – szare linie pojawiają się dopiero przy słabszej karze.
Na co uważać. W modelu generującym dane wszystkie pięć zmiennych x1–x5 miało ten sam współczynnik 0.5, a żaden model go nie odtworzył – kara celowo obciąża oszacowania. To, że lasso wybrało akurat x4, wynika z tej jednej próby; w innej mogłaby to być x1. Rysunek nie pokazuje jakości przewidywania – tu elastic net prognozował nieco gorzej (przykład wyżej). Oś zawiera λ do 10 razy mniejszej niż z walidacji; przy jeszcze słabszej karze do modelu wchodzi coraz więcej szumu.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tego akapitu. Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam, a dane i podziały walidacji losuje tak samo jak przykład (set.seed(685); ziarno z przykładu, niezmieniane – dlatego kod losuje też próbę testową, choć jej nie używa). Ręcznie ustawiono tylko zakres osi poziomej (do λ 10 razy mniejszej niż z walidacji). Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się krój czcionki i siatka.
Kod R rysunku 1
# Rysunek 1. Ścieżki współczynników lasso i elastic net przy grupie silnie skorelowanych predyktorów
suppressPackageStartupMessages(library(glmnet))
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito dla pięciu predyktorów z grupy x1–x5, do tego różne rodzaje linii; reszta szara
kol <- c(x1 = "#E69F00", x2 = "#0072B2", x3 = "#009E73", x4 = "#D55E00", x5 = "#CC79A7",
         "pozostałe" = "grey65")
lin <- c(x1 = "solid", x2 = "dashed", x3 = "dotdash", x4 = "longdash", x5 = "twodash",
         "pozostałe" = "solid")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))

# Te same dane symulowane co w przykładzie: n = 50, 100 predyktorów, wpływa tylko grupa x1–x5 (r ok. .90)
set.seed(685)
n <- 50; p <- 100
z <- rnorm(n)
X <- matrix(rnorm(n * p), n, p)
X[, 1:5] <- 0.95 * z + sqrt(1 - 0.95^2) * X[, 1:5]
colnames(X) <- paste0("x", 1:p)
beta <- c(rep(0.5, 5), rep(0, p - 5))
y <- drop(X %*% beta) + rnorm(n, sd = 2)
Xt <- matrix(rnorm(1000 * p), 1000, p)          # próba testowa – losowana tylko po to, by ziarno
zt <- rnorm(1000); Xt[, 1:5] <- 0.95 * zt + sqrt(1 - 0.95^2) * Xt[, 1:5]   # dało te same podziały
yt <- drop(Xt %*% beta) + rnorm(1000, sd = 2)
foldid <- sample(rep(1:10, length.out = n))     # te same podziały walidacji co w przykładzie

cv_l  <- cv.glmnet(X, y, alpha = 1,   foldid = foldid)   # lasso
cv_en <- cv.glmnet(X, y, alpha = 0.5, foldid = foldid)   # elastic net

# Ścieżka: współczynniki predyktorów dla siatki λ od najsilniejszej kary do λ 10 razy mniejszej niż
# z walidacji (dalej wchodzi coraz więcej szumu); zmienne, które w tym zakresie nie weszły, pomijamy
sciezka <- function(cv) {
  lam <- cv$glmnet.fit$lambda; k <- lam >= cv$lambda.min / 10
  B <- as.matrix(cv$glmnet.fit$beta)[, k]
  B <- B[rownames(B) %in% names(kol) | rowSums(B != 0) > 0, ]
  d <- data.frame(zmienna = rep(rownames(B), ncol(B)),
                  log_lambda = rep(log(lam[k]), each = nrow(B)), b = as.vector(B))
  d$grupa <- factor(ifelse(d$zmienna %in% names(kol), d$zmienna, "pozostałe"), names(kol))
  d
}
dl <- sciezka(cv_l); den <- sciezka(cv_en)

# Liczby do opisu: λ z walidacji, liczba predyktorów i ile z grupy x1–x5 jest w modelu przy lambda.min
podsum <- function(cv) {
  b <- coef(cv, s = "lambda.min")[-1]
  c(log_lambda_min = round(log(cv$lambda.min), 2), niezerowe = sum(b != 0), z_grupy = sum(b[1:5] != 0))
}
rbind(lasso = podsum(cv_l), elastic_net = podsum(cv_en))
# log λ, przy którym każdy z x1–x5 wchodzi do modelu (-Inf: nie wchodzi w zakresie rysunku)
wejscie <- function(d) sapply(paste0("x", 1:5), function(v)
  round(max(c(-Inf, d$log_lambda[d$zmienna == v & d$b != 0])), 2))
rbind(lasso = wejscie(dl), elastic_net = wejscie(den))
# współczynniki x1–x5 przy lambda.min
wsp <- rbind(lasso = coef(cv_l, s = "lambda.min")[2:6], elastic_net = coef(cv_en, s = "lambda.min")[2:6])
colnames(wsp) <- paste0("x", 1:5)
round(wsp, 3)
# ile zbędnych predyktorów (spoza x1–x5) jest w modelu przy lambda.min
c(lasso = sum(coef(cv_l, s = "lambda.min")[-(1:6)] != 0),
  elastic_net = sum(coef(cv_en, s = "lambda.min")[-(1:6)] != 0))

rysuj <- function(d, cv, tytul) {
  etyk <- d[d$log_lambda == min(d$log_lambda) & d$grupa != "pozostałe" & abs(d$b) > 0.1, ]   # bez etykiet przy zerze
  ggplot(d, aes(log_lambda, b, group = zmienna, colour = grupa, linetype = grupa)) +
    geom_hline(yintercept = 0, colour = "grey40", linewidth = 0.3) +
    geom_vline(xintercept = log(cv$lambda.min), linetype = "dotted", colour = "black") +
    geom_line(data = d[d$grupa == "pozostałe", ], linewidth = 0.4) +
    geom_line(data = d[d$grupa != "pozostałe", ], linewidth = 1.1) +
    geom_text(data = etyk, aes(label = zmienna), hjust = 1.2, size = 3.8, show.legend = FALSE) +
    annotate("text", x = log(cv$lambda.min), y = 1.55, label = "λ z walidacji", hjust = -0.05, size = 3.8) +
    scale_colour_manual(values = kol, breaks = names(kol), name = NULL) +
    scale_linetype_manual(values = lin, breaks = names(kol), name = NULL) +
    scale_x_continuous(expand = expansion(mult = c(0.08, 0.02))) +
    labs(title = tytul, x = "log(λ) – silniejsza kara w prawo", y = "Współczynnik b") + motyw
}
p1 <- (rysuj(dl, cv_l, "A. Lasso (α = 1)") / rysuj(den, cv_en, "B. Elastic net (α = 0.5)")) +
  plot_layout(guides = "collect") & theme(legend.position = "bottom")
p1   # zapis: ggsave("elastic-net-sciezki.svg", p1, width = 8, height = 9)
Wynik w R
            log_lambda_min niezerowe z_grupy
lasso                -0.31         3       3
elastic_net           0.34         4       4
              x1    x2    x3   x4   x5
lasso       -Inf -0.26 -0.17 0.72 -Inf
elastic_net -Inf  1.36  1.32 1.41 0.76
            x1    x2    x3    x4    x5
lasso        0 0.019 0.071 1.458 0.000
elastic_net  0 0.377 0.351 0.673 0.015
      lasso elastic_net
          0           0
Jak opisać w pracy
Na co uważać
- Standaryzacja. Kara zależy od skali zmiennych; glmnet domyślnie standaryzuje predyktory i zwraca współczynniki w skali oryginalnej.
- Te same podziały dla każdego α. Funkcja
cv.glmnet()dobiera tylko λ; α porównuj przy wspólnym argumenciefoldid. - Bez klasycznych wartości p. Współczynniki są ściągnięte do zera, a wybór zmiennych zależy od danych, więc zwykłe przedziały ufności tu nie obowiązują.
- Wybór zmiennych to nie przyczynowość. Zerowy współczynnik nie dowodzi braku związku (zob. ile predyktorów w regresji).
Elastic net w R
Kod symuluje dane z grupą skorelowanych predyktorów, dopasowuje glmnet::cv.glmnet() dla α = 1 (lasso), 0.5 (elastic net) i 0 (regresja grzbietowa) przy tych samych podziałach walidacji i porównuje liczbę wybranych zmiennych oraz błąd w próbie testowej. Liczby w tekście pochodzą z tego kodu.
Lasso, elastic net i regresja grzbietowa przy skorelowanych predyktorach
R
set.seed(685)                                   # dane symulowane: n = 50, 100 predyktorów
n <- 50; p <- 100
z <- rnorm(n)                                   # wspólny czynnik pierwszych 5 predyktorów (r ok. .9)
X <- matrix(rnorm(n * p), n, p)
X[, 1:5] <- 0.95 * z + sqrt(1 - 0.95^2) * X[, 1:5]
colnames(X) <- paste0("x", 1:p)
beta <- c(rep(0.5, 5), rep(0, p - 5))           # wpływa tylko grupa x1–x5
y <- drop(X %*% beta) + rnorm(n, sd = 2)
Xt <- matrix(rnorm(1000 * p), 1000, p)          # próba testowa z tego samego modelu
zt <- rnorm(1000); Xt[, 1:5] <- 0.95 * zt + sqrt(1 - 0.95^2) * Xt[, 1:5]
yt <- drop(Xt %*% beta) + rnorm(1000, sd = 2)
suppressPackageStartupMessages(library(glmnet))
foldid <- sample(rep(1:10, length.out = n))     # te same podziały CV dla każdego alfa
wyniki <- t(sapply(c(lasso = 1, elastic_net = 0.5, grzbietowa = 0), function(a) {
  cv <- cv.glmnet(X, y, alpha = a, foldid = foldid)
  b  <- coef(cv, s = "lambda.min")[-1]
  c(alpha = a, lambda_min = cv$lambda.min, niezerowe = sum(b != 0),
    z_grupy_x1_x5 = sum(b[1:5] != 0), MSE_CV = min(cv$cvm),
    MSE_test = mean((yt - predict(cv, Xt, s = "lambda.min"))^2))
}))
print(round(wyniki, 3))
cv_en <- cv.glmnet(X, y, alpha = 0.5, foldid = foldid)
print(round(coef(cv_en, s = "lambda.min")[2:8, 1], 3))   # wyraz wolny pominięty, x1–x7
Wynik w R
            alpha lambda_min niezerowe z_grupy_x1_x5 MSE_CV MSE_test
lasso         1.0      0.736         3             3  4.963    5.146
elastic_net   0.5      1.405         4             4  5.225    5.315
grzbietowa    0.0     21.455       100             5  6.693    7.334
   x1    x2    x3    x4    x5    x6    x7
0.000 0.377 0.351 0.673 0.015 0.000 0.000
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet glmnet 5.0). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- glmnet (wersja 5.0): Friedman, J., Hastie, T., & Tibshirani, R. (2010). Regularization paths for generalized linear models via coordinate descent. Journal of Statistical Software, 33(1), 1–22. https://doi.org/10.18637/jss.v033.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jak wybrać parametr alfa w elastic net?
Sprawdź kilka wartości, np. 0, 0.25, 0.5, 0.75 i 1, każdą z walidacją krzyżową przy tych samych podziałach danych (argument foldid w cv.glmnet), i wybierz tę z najmniejszym błędem. Funkcja cv.glmnet sama dobiera tylko lambda.
Kiedy elastic net zamiast lasso?
Gdy predyktory tworzą grupy silnie skorelowanych zmiennych albo gdy jest ich więcej niż obserwacji. Zou i Hastie (2005) pokazali, że lasso radzi sobie wtedy słabo z doborem zmiennych, a elastic net ma efekt grupowania.
Czy elastic net nadaje się do wyniku binarnego?
Tak. W glmnet wystarczy family = "binomial" – kara elastic net działa wtedy w regresji logistycznej. Do oceny modelu użyj np. AUC lub dewiancji z walidacji krzyżowej zamiast MSE.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Friedman, J., Hastie, T., & Tibshirani, R. (2010). Regularization paths for generalized linear models via coordinate descent. Journal of Statistical Software, 33(1), 1–22. https://doi.org/10.18637/jss.v033.i01 ● Otwarty dostęp
- Zou, H., & Hastie, T. (2005). Regularization and variable selection via the elastic net. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 67(2), 301–320. https://doi.org/10.1111/j.1467-9868.2005.00503.x ● Otwarty dostęp
Cytowania BibTeX
@article{friedman2010regularization, author={Friedman, Jerome and Hastie, Trevor and Tibshirani, Robert}, title={{Regularization paths for generalized linear models via coordinate descent}}, journal={Journal of Statistical Software}, year={2010}, volume={33}, number={1}, pages={1--22}, doi={10.18637/jss.v033.i01}}@article{zou2005regularization, author={Zou, Hui and Hastie, Trevor}, title={{Regularization and variable selection via the elastic net}}, journal={Journal of the Royal Statistical Society: Series B (Statistical Methodology)}, year={2005}, volume={67}, number={2}, pages={301--320}, doi={10.1111/j.1467-9868.2005.00503.x}}